TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Vercel 在 11 月 7 日把 DeepSeek Ultrafast 放進 AI Gateway,宣稱每秒逾 1,000 token。它並非 DeepSeek 新模型,而是 Fireworks 加速端點跑 10 月 17 日版的 V4.1 Flash 1017:價格是官方尖峰價 8 倍,頁面實測中位數 890 tps 與宣稱分屬不同口徑,同頁還有四分之一價格的 Baseten Fast 變體一樣破千。
用 AI 摘要這篇文章:
11 月 7 日,Vercel 在 AI Gateway 上架了 DeepSeek V4.1 Flash 1017 Ultrafast,官方宣稱它每秒可以產生超過 1,000 個 token(token 是模型計算文字的基本單位,一個中文字或一個英文單字會被拆成不同數量)。結論先講:這不是 DeepSeek 的新模型,而是 Fireworks 用加速端點跑 10 月 17 日更新版的 DeepSeek V4.1 Flash 1017;它的價格是 DeepSeek 官方尖峰價的整整 8 倍,宣稱速度與頁面上的實測中位數分屬兩種口徑,而且 Vercel 同一個閘道還掛著價格只有四分之一、實測中位數同樣破千的 Fast 變體。要不要多付這 8 倍,取決於你的工作有多少時間真的花在等模型吐字。
DeepSeek Ultrafast 這個名字容易讓人以為 DeepSeek 又發了新模型。查 DeepSeek 官方 API 文件,模型清單裡從頭到尾沒有 Ultrafast 這個名稱,付費頁也只有 deepseek-flash 與 deepseek-v4-pro 兩個模型名,其中 deepseek-flash 目前由 10 月 17 日更新的 DeepSeek-V4.1-Flash-1017 提供。Ultrafast 出現在另外兩家的文件裡。
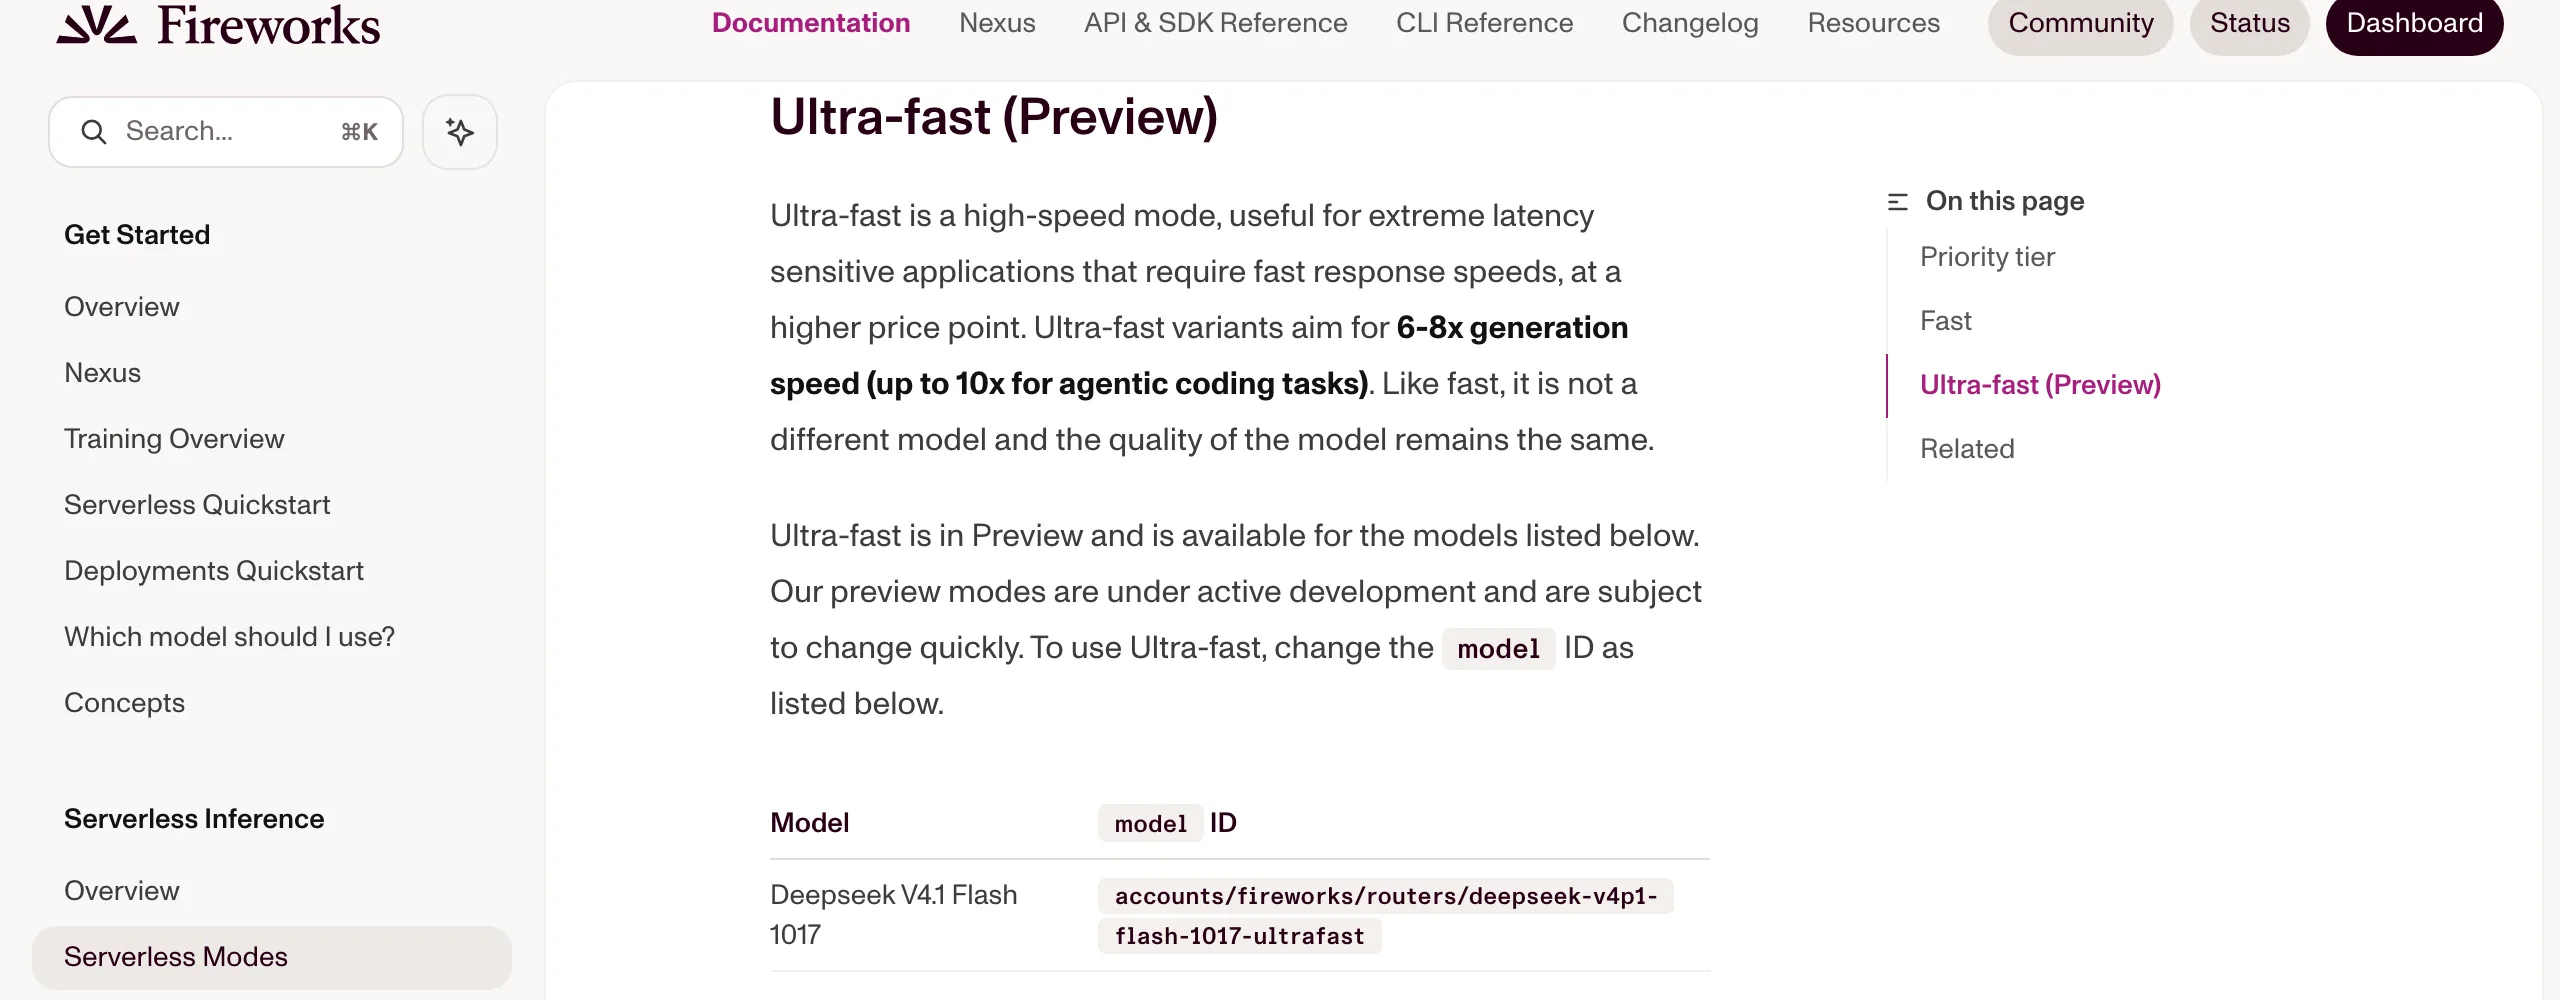
Fireworks 是提供推論服務的公司,它在文件裡把 Ultra-fast 列為 serverless 的四種模式之一(Standard、Priority、Fast、Ultra-fast),定位是給「對延遲極度敏感」的工作使用,目標是 6 到 8 倍的生成速度,代理式程式任務最高 10 倍。文件同時寫明兩件關鍵的事:它與 Fast 一樣「不是不同的模型,品質維持相同」,只是價格更高;以及 Ultra-fast 還在預覽階段,「快速變動」是官方自己給的提醒。整份文件列出來的支援型號只有一個:DeepSeek V4.1 Flash 1017。
Vercel 做的是把這個端點接進 AI Gateway。changelog 條目寫得直接:這個模型「透過 Fireworks 的加速 serverless 端點」提供,模型代號 deepseek/deepseek-v4.1-flash-1017-ultrafast,公開預覽、沒有等候名單也沒有連線時長限制。模型頁列出的能力包含文字與圖片輸入、可設定的推理強度、工具呼叫、結構化輸出與自動前綴快取;隱私方面頁面註明,使用這個供應商就同意其條款,且「受 DeepSeek 的條款與隱私政策規範」,對資料治理有要求的團隊,這行字值得先讀。還有個小細節:changelog 發布日是 11 月 7 日,Vercel 供應商表上 Fireworks 這一列的上架日期則標 11 月 6 日,官方管道之間差一天不算罕見,引用時以 changelog 為準即可。所以名稱開頭的 deepseek 說的是模型出處,速度與價格條件則分別由 Fireworks 與 Vercel 的頁面定義,三家公司各賣各的東西。
被加速的模型本體,是 DeepSeek 在 10 月 17 日把 V4.1 Flash 升級成的 1017 版,官方形容是「更強的 benchmark 表現、更快的任務完成、更短的輸出」,網頁、App 與 API 同步更新。官方對照表裡,新版在 DeepSWE v1.1 拿 77.0 分是該列最高(前版 74.2,測試框架為 Mini-SWE-V2),Terminal-Bench 4.0 從 31.2 進步到 42.3(以 Claude Code 框架測),HLE 不用工具的成績是 42.6。換個執行框架分數就會不同,這兩個框架條件都是官方自己標註的。值得注意的是,DeepSeek 描述的「更快」有一部分來自輸出變短與任務路徑變快,那是模型層的改進;Ultrafast 加的是每個 token 的產生速度,屬於端點層。兩層分開看,才不會把 10 月就已經拿到的進步,誤以為是 8 倍價錢買來的。這個模型前後的定位與定價策略,可以對照我們當時的DeepSeek V4.1-Flash 發布追蹤。
模型權重以 MIT 授權放在 Hugging Face 上,任何推論服務商都可以自己架一套。這也是為什麼 Vercel 標準版 1017 的模型頁能列出 24 家供應商,從 DeepSeek 第一方到 DeepInfra、Together AI、Baseten 都在同頁競價。Ultrafast 頁的供應商欄位則只有 Fireworks 一家,沒有第二家可以備援切換。
「每秒逾 1,000 token」是 Vercel 的宣稱,出現在 changelog 與官方 X 貼文(11 月 7 日 17:25 UTC),原文用詞是 upwards of 與 over,沒有附提示長度、輸出長度或尖峰條件。
更早的數字來自 Fireworks。它在 10 月 21 日的 X 貼文寫「1,521+ tok/s」,還示範 11 秒生成一個俄羅斯方塊遊戲、比 Claude Opus 5.5 快 7 倍,當時要加入等候名單才能用。這是廠商自己的展示,同樣沒有附測量條件。
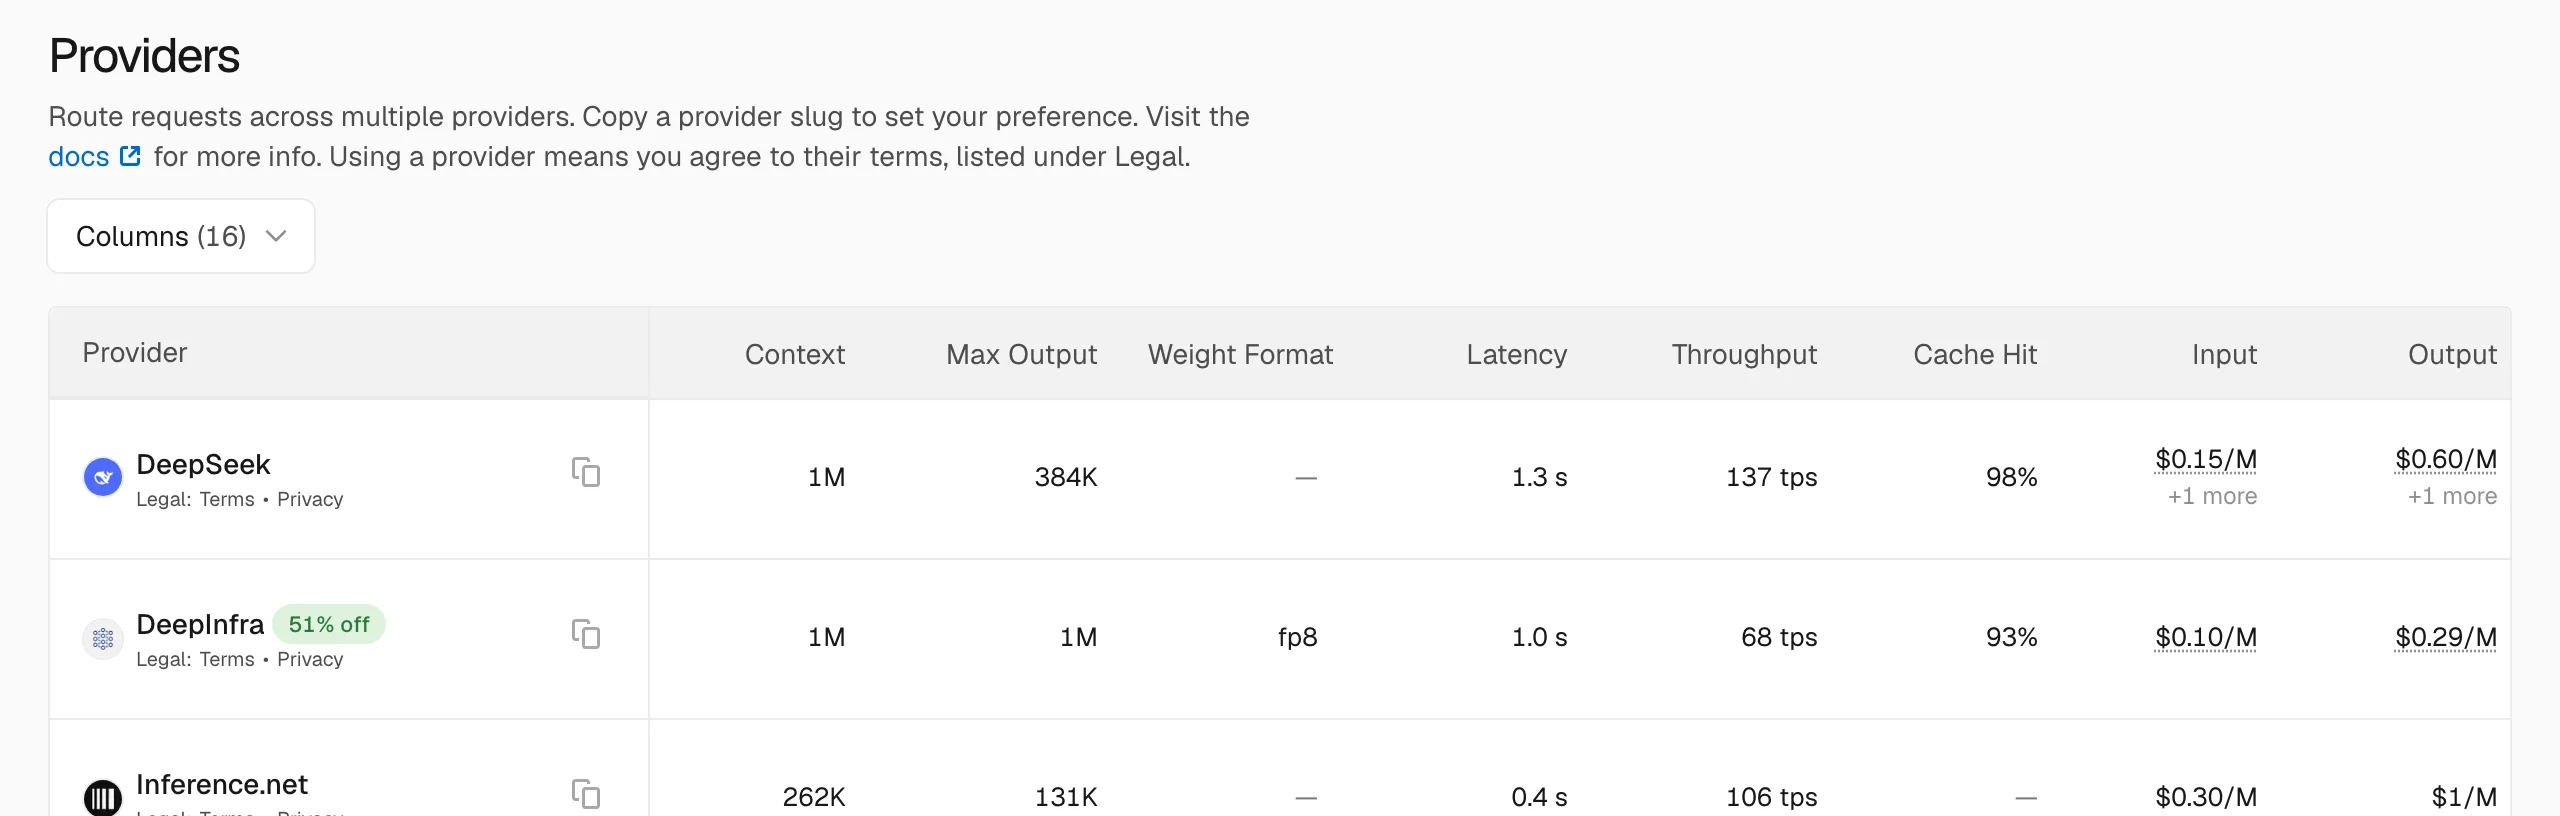
第三組數字最值得看:Vercel 模型頁的供應商表會標示 AI Gateway 實際流量的 P50 中位數。2026 年 11 月 11 日查詢時,Ultrafast 頁顯示每秒 890 個 token、首字延遲 0.7 秒;同一時間,標準版 1017 頁的 Fireworks 列是每秒 238 個 token、1.8 秒;DeepSeek 第一方列是每秒 137 個 token、1.3 秒。890 大約是 238 的 3.7 倍,低於 Fireworks 自己寫的 6 到 8 倍目標帶。這裡必須誠實標註口徑:兩個 P50 來自不同頁面的不同流量混合(請求長度、快取命中率都不同),只能當方向參考,不能據此宣稱 Fireworks 沒達標。而且這些是即時數字,每天查都會漂移。
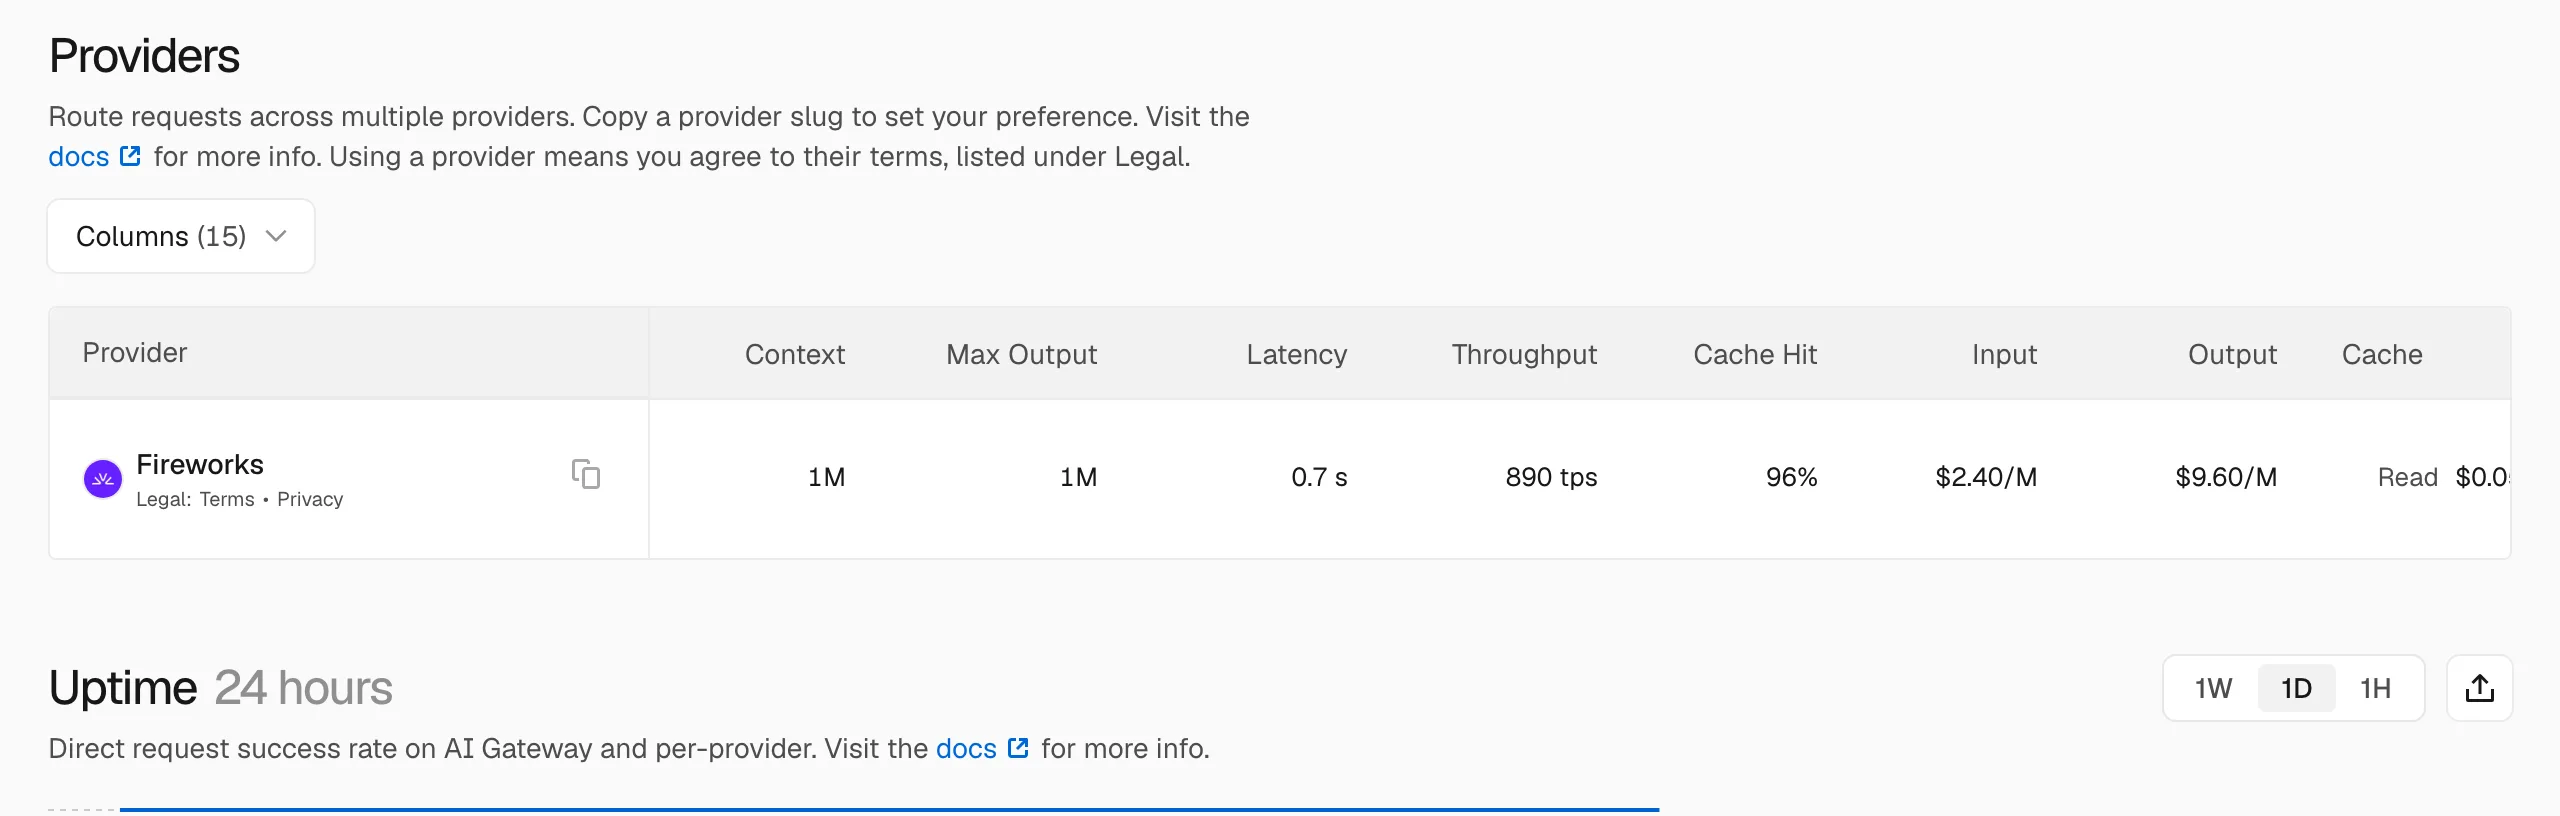
首字延遲是另一個容易被「每秒幾千 token」蓋掉的數字。送出請求到第一個字出現,Ultrafast 是 0.7 秒、標準版 Fireworks 是 1.8 秒、DeepSeek 第一方是 1.3 秒。輸出越短,首字延遲在總等待裡的佔比越高:聊天式的一兩百 token 回應,加速版感受到的縮短幅度,主要就來自這一秒上下的差別;輸出上千 token 的程式碼生成,每秒產量才會變成主角。看你自己的工作落在哪一端,再決定要盯哪個數字。
宣稱值、展示值、實測中位數,三組數字互相不能驗證。真正能回答「我會拿到多快」的,只有用你自己的提示去測。
依 Vercel 模型頁與 Fireworks 定價頁,Ultrafast 的輸入價是每百萬 token 2.40 美元、輸出 9.60 美元、快取命中輸入 0.048 美元。對照之下:
| 服務(每百萬 token) | 輸入(未命中快取) | 輸入(命中快取) | 輸出 |
|---|---|---|---|
| DeepSeek 官方 API,尖峰 | 0.30 美元 | 0.006 美元 | 1.20 美元 |
| DeepSeek 官方 API,離峰 | 0.15 美元 | 0.003 美元 | 0.60 美元 |
| Fireworks 標準版 1017 | 0.30 美元 | 0.006 美元 | 1.20 美元 |
| Fireworks Ultra-fast(預覽) | 2.40 美元 | 0.048 美元 | 9.60 美元 |
| Vercel 頁 Baseten Fast 變體 | 0.60 美元 | 未列 | 2.40 美元 |
三個倍數值得記:Ultrafast 對 DeepSeek 官方尖峰價與 Fireworks 標準版都是整整 8 倍(輸入輸出都是);對離峰價是 16 倍;連快取命中的輸入價都是 8 倍。DeepSeek 的尖峰時段定義在 UTC 週一到週五的 01:00 至 04:00 與 06:00 至 10:00,換算成台北時間是平日 09:00 至 12:00 與 14:00 至 18:00,中國公共假日除外,其餘時間都是離峰價。Vercel 在 changelog 裡聲明 AI Gateway 反映供應商價格、不加價,也不對推論收平台費(包含自帶金鑰的請求),所以這組 2.40 與 9.60 就是 Fireworks 牌價,中間沒有 Vercel 的加成。
還有兩筆帳容易漏。Vercel 文件說推理 token 通常計入輸出用量,而 DeepSeek 官方 API 的這個模型預設開思考模式(會產生推理 token),所以開著推理跑 Ultrafast,實際帳單會比只看答案長度的估算更高。快取的路徑也一樣墊貴:查詢當天模型頁顯示這個端點的快取命中率是 96%,但命中後的輸入單價是 0.048 美元,與標準版的 0.006 美元相比同樣是 8 倍,代理式工作負載靠前綴快取省下來的錢,在加速版上等比例縮水。免費層方面,Vercel 模型頁寫未付款過的免費用戶每 30 天有 5 美元額度,以輸出價 9.60 美元計,大約對應 52 萬個輸出 token 的上限,實際能跑多少要看輸入與推理佔比。
Vercel 把 Baseten 供應的 deepseek-v4.1-flash-1017-fast 也掛在同一個模型頁系統裡。2026 年 11 月 11 日快照,這個變體的 P50 是每秒 1,011 個 token、首字 0.6 秒,輸入 0.60 美元、輸出 2.40 美元,正好是 Ultrafast 的四分之一價。也就是說,在查詢當下,「中位數破千」這件事在 Vercel 自己的頁面上不是 Ultrafast 獨有,而且便宜的那個反而更快。前提同樣要講清楚:兩個變體的流量條件不同,中位數不能直接互比,但作為「付 8 倍之前先測什麼」的訊號,這一列已經足夠醒目。
再往標準版頁看,24 家供應商裡本來就有每秒 200 到 300 token 量級的選項:Together AI 268 走標準牌價,Boundless 298 甚至再低一點(輸入 0.24、輸出 0.96 美元),DeepInfra 的特價更壓到輸入 0.10 美元。從「夠用的速度」到「最快那一檔」,Vercel 這一頁其實已經把光譜鋪滿了。規格面還有一處差異要留意:Fast 變體的最大輸出是 262K,Ultrafast 是 1M,會一次生成整套檔案的長輸出工作流,先確認上限夠用再切換。
價格之外,Fireworks 的 rate limits 文件給了第二個代價。文件明寫「Ultra-fast(預覽)的速率限制低於標準模型」,並且把 DeepSeek V4.1 Flash 1017 Ultra-fast 放在 Medium 層級:生成量的基本上限是每分鐘 43.2 萬個 token。基礎版的 DeepSeek V4.1 Flash 在 Small 層級,同一個上限是每分鐘 216 萬。換句話說,就算在最高花費層級的帳號上,加速版的生成量上限大約只剩標準版的五分之一。換算成具體感受:每分鐘 43.2 萬個 token 等於這個模型在全帳號合計每秒 7,200 個 token,若每條回應都用滿 890 的中位數速度,同時跑滿速串流的大約只有 8 條;標準版的上限換算後約每秒 3.6 萬個 token,同樣條件下能撐 150 條。Fireworks 的限流是自適應的(會隨用量調整、逐模型獨立計算),上面的數字是 Tier 3 以上的花費層級才拿得到的 ceiling,一般帳號只會更低。對高併發的正式服務來說,這可能比 8 倍價格更早成為瓶頸。
穩定度的部分,兩邊都還沒有承諾。Ultra-fast 仍在預覽,Fireworks 提醒預覽模式會快速變動,文件裡也查不到服務水準承諾(Fireworks 的 SLA 只出現在另一項 Reserved Throughput 產品);品質方面,Fireworks 只有一句「品質維持相同」,Vercel 與 Fireworks 都沒有公布加速版與標準版並排的品質對比資料。這句廠商說法可以引用,但採用前最好用自己的驗收標準跑一輪對照。
把數字換算成決策語言。用 11 月 11 日的兩個中位數做假設算例(不是實測):輸出 2,000 個 token,標準版 Fireworks 約要 8.4 秒,Ultrafast 約 2.2 秒,省下約 6.2 秒。成本端,輸入 1 萬個未命中快取的 token 加輸出 2 千個 token,標準版約 0.0054 美元,Ultrafast 約 0.0432 美元,單次差約 0.038 美元。換算下來,每省下一小時的生成等待,約要多付 22 美元。輸出縮到 200 個 token 的短回應又是另一種樣貌:把首字延遲算進去,標準版約 2.6 秒、加速版約 0.9 秒,縮短約 2.9 倍,低於長輸出的 3.5 倍左右,因為短回應的等待主要卡在首字,而首字 0.7 對 1.8 秒的差距(約 2.6 倍)本來就小於生成速度的差距。這些數字會隨你的輸入輸出比例、快取命中率與推理佔比變動,但它給了一個誠實的座標:如果那幾秒後面真的有一個人(或一個 agent 迴圈)在等,22 美元一小時可能是划算的;如果是批次任務在背景跑,這 22 美元就只是純粹多付的錢。
所以適合的場景很清楚:互動式的程式碼編輯、需要快速反覆迭代的代理流程、原型開發,這些工作的人機迴圈裡等待佔大宗。不適合的也一樣清楚:成本優先的批次任務、高併發的正式服務、需要穩定承諾的生產環境。決定之前,拿同一組真實提示在標準版、Fast 與 Ultrafast 三條路各跑一輪,記下首字延遲、輸出速度、整份回應完成時間與任務是否通過,再回頭看那 22 美元買到多少秒。
呼叫方式與 AI Gateway 上其他模型相同:把模型代號換成 deepseek/deepseek-v4.1-flash-1017-ultrafast,用 AI SDK 的 streamText 或 generateText,或走 OpenAI Chat Completions、Responses、Anthropic Messages 相容格式改基礎網址即可。要給程式碼代理用的話,changelog 提供一條設定指令:npx vercel ai-gateway setup,裝完最新版 Vercel CLI 執行後,就能在 Claude Code、Codex、Cursor 裡選這個模型。規格細節要以實際使用的服務商文件為準,例如 Vercel 頁標的最大輸出是 1M,DeepSeek 官方文件寫的是 384K,各家的上限本來就不同。
最後是回查。Vercel 三個模型頁(ultrafast、標準 1017、1017-fast)與 Fireworks 定價頁上的速度中位數與供應商名單都會漂移,頁面數字都以 2026 年 11 月 11 日快照為準。「每秒逾 1,000」是 Vercel 的說法,「1,521+」是 Fireworks 的展示,「890」是查詢當天的頁面中位數,三個都不是 DeepSeek 官方規格表裡的數字。多付 8 倍之前,先看看自己螢幕前到底等了幾秒;如果你對這個閘道的整體流量樣貌有興趣,可以接著讀Vercel 十月 AI 流量報告的拆解,至於想把同一個模型搬回自己顯卡上跑的路線,我們先前也整理過Strata 跑 DeepSeek V4.1 Flash 的硬體帳。