TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Vercel 於 10 月 30 日為 Public Beta 的 Daemons 新增服務綁定與 HTTP 存活檢查,背景工作可呼叫同次部署的私有服務,卡住的程序連續三次檢查失敗後由平台重啟。官方文件另載明綁定釘住啟動時的部署、存活失敗走 SIGKILL 不吃寬限期,Hobby 每月 420 GB-小時記憶體額度約只夠 2 GiB 常駐九天。
用 AI 摘要這篇文章:
10 月 30 日,Vercel 給半個月前才進入 Public Beta 的 Daemons 補上兩件裝備:背景工作可以透過服務綁定呼叫同一次部署裡的私有服務,也可以掛 HTTP 存活檢查,讓平台抓出「還在執行卻已經卡住」的程序強制重啟。兩條 changelog 分別由 Gal Schlezinger 與 Nik Sidnev 署名,頁面日期都是 30 Oct 2026;官方開發者帳號的公告推文發在台北時間 23 時 49 分,執行長 Guillermo Rauch 八分鐘後補一句「Vercelnetes or V8S for short」,把那個影子的出處自己點破了。
這句玩笑其實是最快的入門指引。打開官方文件,vercel.json 裡的新欄位叫 livenessProbe,底下是 httpGet 的 port 與 path,旁邊站著 initialDelaySeconds、periodSeconds、timeoutSeconds、failureThreshold;連「HTTP 200 到 399 算成功、其餘算失敗」的定義,都跟 Kubernetes 探針文件相同。碰過 Kubernetes 的人幾乎不必重學詞彙,真正要重學的是語意:兩個原語進到 Vercel 之後被平台改寫了兩處,而且都改在出事時才看得到的位置,一處是服務綁定釘死在啟動它的那次部署,另一處是存活檢查失敗的後果是不吃寬限期的立即強制終止。
下面先拆這兩項能力各做了什麼,再回頭看這兩處改寫為什麼值得在意。
| 面向 | Kubernetes | Vercel Daemons |
|---|---|---|
| 探針由誰發話 | 節點上的 kubelet 對容器發話 | 從執行個體內部發出 |
| 探測方式 | exec、HTTP、TCP、gRPC 四種 | 僅 HTTP GET |
| 服務尋址 | Service 名稱跨版本穩定 | 綁定釘住啟動時的那次部署 |
| 存活失敗的終止 | kubelet 殺掉容器並重啟 | 立即 SIGKILL,不遵循寬限期 |
欄位名同形不代表行為同義。Kubernetes 的探針由節點上的 kubelet 發話,等於叢集代替你問容器;Vercel 的檢查從執行個體內部發出,等於程序自己回報。這個方向差異的後面兩節會展開:它讓 daemon 掛了健康端點也不會得到對外網址,也讓換版時的服務尋址走向跟 Service 抽象剛好相反的設計。
Daemons 是 Vercel 在 10 月 15 日開放 Public Beta 的常駐程式(daemon)功能:用 Dockerfile 或 Containerfile 打包映像檔,平台在指定區域維持你設定的執行個體(instance,同一份程式的一份運行副本)數量,程序(process)持續從佇列或工作流引擎拉工作來做,沒有對外入口。beta 公告列的典型成員是佇列消費者、Temporal 或 Cadence 這類工作流 worker、自架的 CI runner。
這類程式經常需要回頭呼叫自己專案裡的其他服務,例如拉到一筆工作後,向私有 API 要資料。順帶一提生命週期的兩個端點:建置時映像檔會推到 Vercel Container Registry,存放庫名稱是 daemon.加 daemon 名稱;執行個體的 stdout 與 stderr 會轉送到專案的日誌頁,觀察不需要另外接管。10 月 30 日之前,這段連線要自己張羅:地址放哪、認證怎麼帶、要不要把服務開到公網。服務綁定把這三件事收走:在 daemon 設定裡宣告目標服務與接收地址的環境變數名稱,平台把服務網址放進變數,內部路由、認證與 TLS 加密連線都由 Vercel 處理,目標服務可以完全不對外公開。
[services.api]
root = "api/"
entrypoint = "main:app"

[daemons.worker]
root = "worker/"
entrypoint = "Dockerfile"
instances = { iad1 = 1 }

[[daemons.worker.bindings]]
type = "service"
service = "api"
format = "url"
env = "API_URL"
worker 端讀 API_URL,用一般的 fetch 呼叫,不必把主機名稱寫死在程式裡。
方向是單行的。changelog 明講:daemon 可以綁服務,服務不能反過來綁 daemon;limits 頁再補一條,daemon 也不能當服務綁定或 rewrite 的目標。背景工作仍然是純粹的消費者,要對外收請求的程式,平台指向 Services 或 Functions。內部可達也不等於應用層授權:訂單服務願意接 worker 的呼叫,跟這個 worker 能改哪些欄位,是兩件事,後者由後端自己的規則決定。
綁定的語意裡藏著一條容易被略過的規則:每個執行個體的綁定,指向啟動它的那次部署。新的部署升為正式版、或團隊復原到舊版時,平台會換掉相應的背景程式並停止前一版,但在舊個體停止之前,它呼叫的一直是舊部署裡的服務。
跟 Kubernetes 的 Service 抽象對照,差異是刻意設計的:Service 的名稱跨版本穩定,Pod 換代後照著名字就拿到新後端;Vercel 的綁定剛好反向,讓工作中的背景程式對後端的依賴整組跟著舊部署走。好處是舊工作不會突然連到新後端吃下不相容的介面,代價是換版瞬間新舊兩代 worker 連的是兩個版本的後端,佇列訊息的格式相容與跨版本資料遷移,都還是應用程式自己的責任。官方文件給的方向很一致:把工作設計成可以中途被殺掉再跑一次。
另外要記得容器映像檔、指令與環境變數都屬於部署的一部分,改這些內容要走一次新的正式部署,不能指望線上的執行個體熱更新。可以不部署就動的只有執行個體數量,而且從 dashboard 或 CLI 蓋過去的數量設定會跨部署留存,直到清除為止。
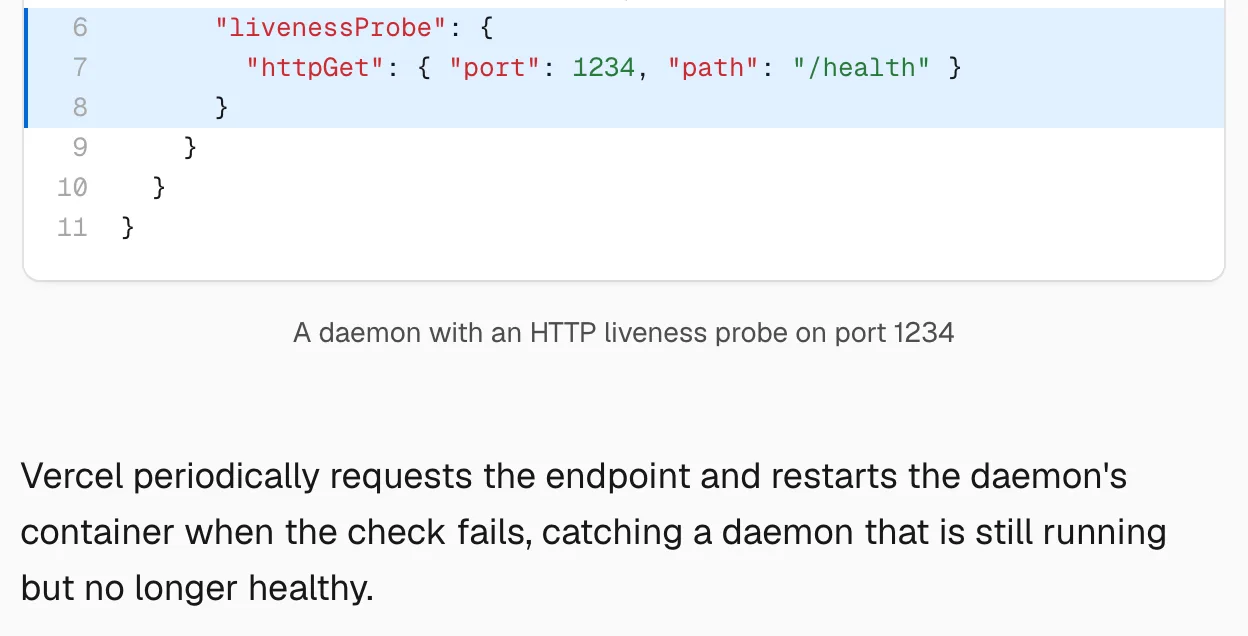
預設行為下,Vercel 只在程序退出或崩潰時重啟。程序掛死在連線上、繞不出去的迴圈裡,這種活著卻不動的狀態,退出訊號永遠等不到。livenessProbe 補的就是這一塊:平台定期對執行個體發 HTTP GET,連續失敗到門檻就重啟容器。
{
  "daemons": {
    "worker": {
      "root": "worker/",
      "entrypoint": "Dockerfile",
      "instances": { "iad1": 1 },
      "livenessProbe": {
        "httpGet": { "port": 1234, "path": "/health" },
        "initialDelaySeconds": 5
      }
    }
  }
}
判定規則逐條列在文件裡。200 到 399 都算成功,重導向不跟隨,但 3xx 本身也算成功,所以健康端點不能只是一個轉去登入頁的 redirect;連線錯誤、逾時、任何其他狀態碼算失敗。一次成功就把累積失敗歸零,連續 failureThreshold 次失敗才觸發重啟。預設值是每 10 秒查一次、逾時 1 秒、連續 3 次失敗觸發;官方的時間線範例是:容器啟動 5 秒後首次檢查通過,之後每 10 秒一次,假設程式在約 605 秒時卡死,605、615、625 秒三次都失敗,容器約在 625 秒被終止。
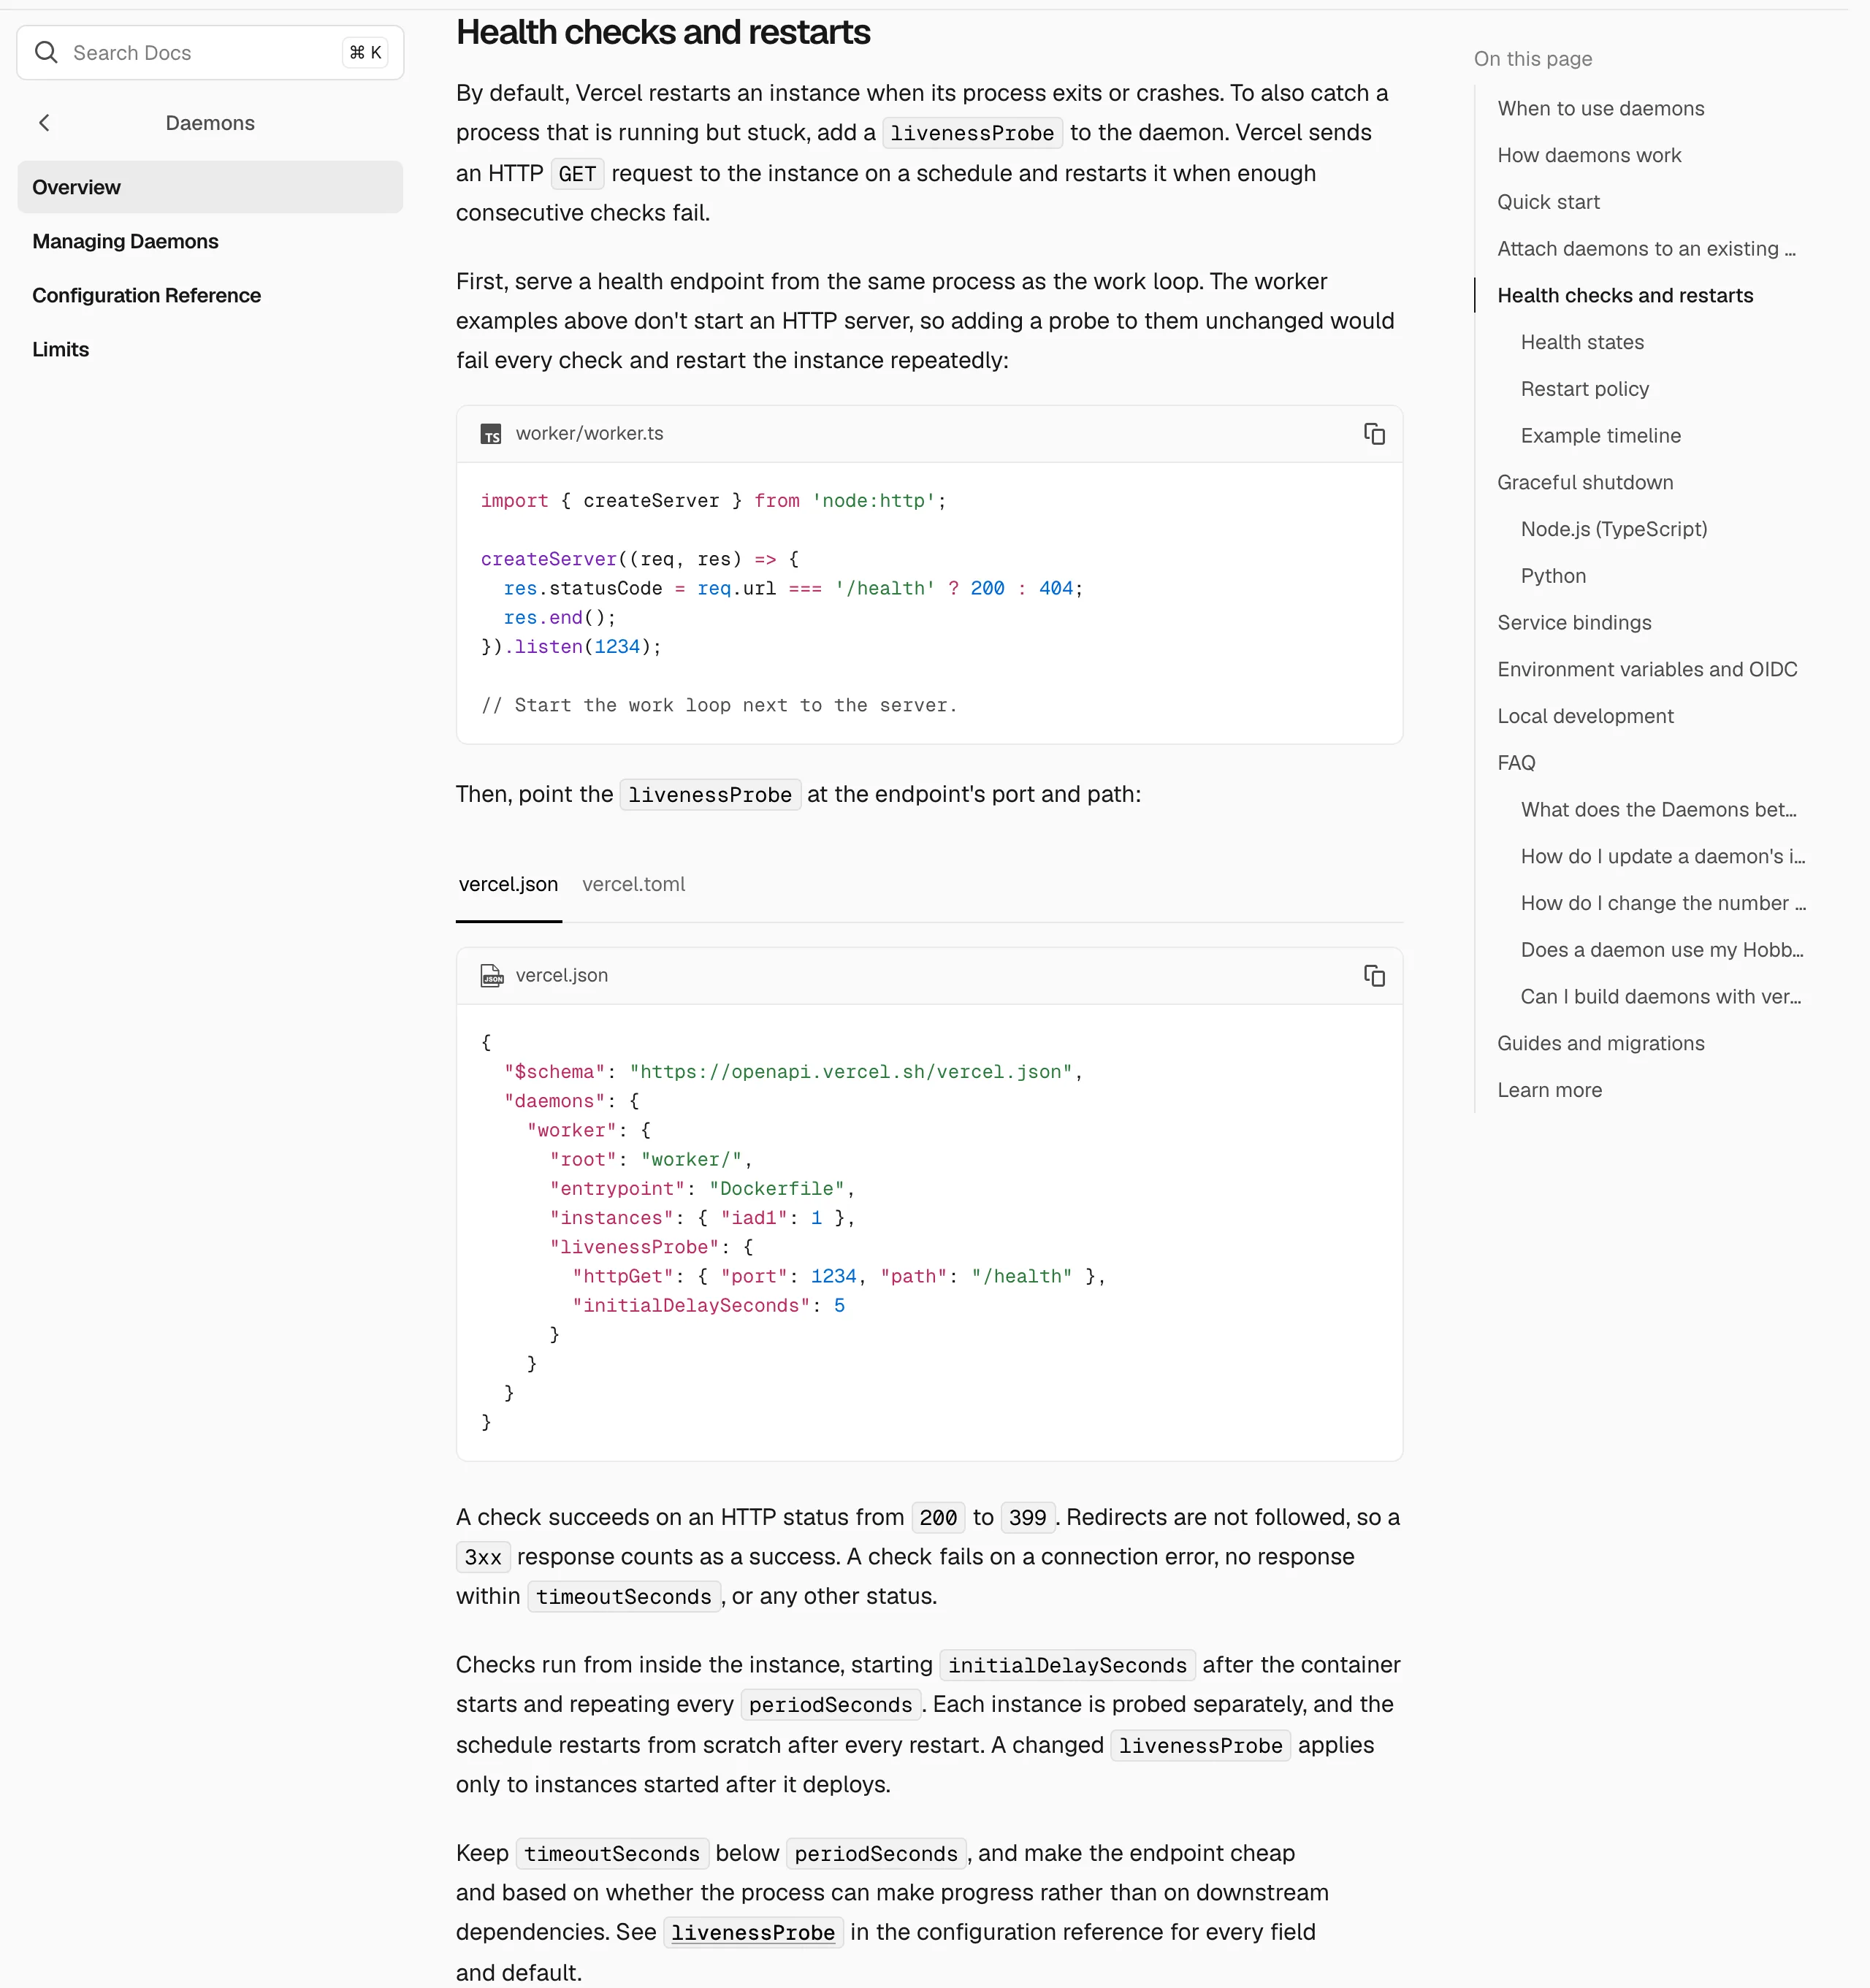
時程還有兩條規則:每個執行個體分開探測,時程在每次重啟後從頭算;改過的 livenessProbe 只套用在它部署之後啟動的執行個體,線上舊個體照舊規則跑。
兩個工程細節比數字更值得記。檢查從執行個體內部發出,這代表 daemon 不會因為掛了健康端點就拿到對外網址,流量政策一寸不讓;同時健康端點必須由工作迴圈同一個程序提供,文件特別警告,只加 livenessProbe 設定卻沒有真的起 HTTP 端點,每次檢查都會失敗,反而掉進反覆重啟。端點本身要輕,而且反映的是「這個程序還能不能前進」,不是下游依賴的總體檢查:資料庫短暫變慢就把所有 worker 同時判死,對資料庫沒有幫助。
還有就是別對它期待太多。檢查結果只分 pending、passing、failing 三種狀態,它證明程序依設定能繼續,不證明工作已經交付。報告產了沒、資料寫進去了沒,要看任務自己的完成紀錄。
平台停止一個 daemon 有兩條路,走的訊號不一樣。正常替換,推出新版、調降執行個體數、移除 daemon,平台送 SIGTERM,預設等 30 秒讓程序停止接新工作、清完手上的資源,這段寬限期可以用 terminationGracePeriodSeconds 調成 0 到 3600 秒。存活檢查失敗觸發的重啟則是立即 SIGKILL,文件明寫不遵循寬限期。
這個差別直接決定程式怎麼寫:把保存進度寫在 SIGTERM 處理器裡的程式,健康失敗時那段程式碼根本沒有機會執行。進度保存要放在平常的路徑上,而不是收尾的路徑上。
重啟本身也有節流。退避從 1 秒起算、每次翻倍、上限 5 分鐘;單次運行滿 5 分鐘就重置退避;如果 10 分鐘內每次都活不過 5 分鐘,平台不再重啟同一個執行個體,直接換一個新的。這套機制擋的是無止盡的快速崩潰循環,擋不了程式本身的缺陷。配套要求寫在文件裡:工作要冪等,同一筆工作跑兩次不該產生兩份不同的結果;佇列訊息要在處理完成後才確認,太早確認,失敗後就少了重試的機會,晚點確認,就要能辨認重複送來的同一筆工作。
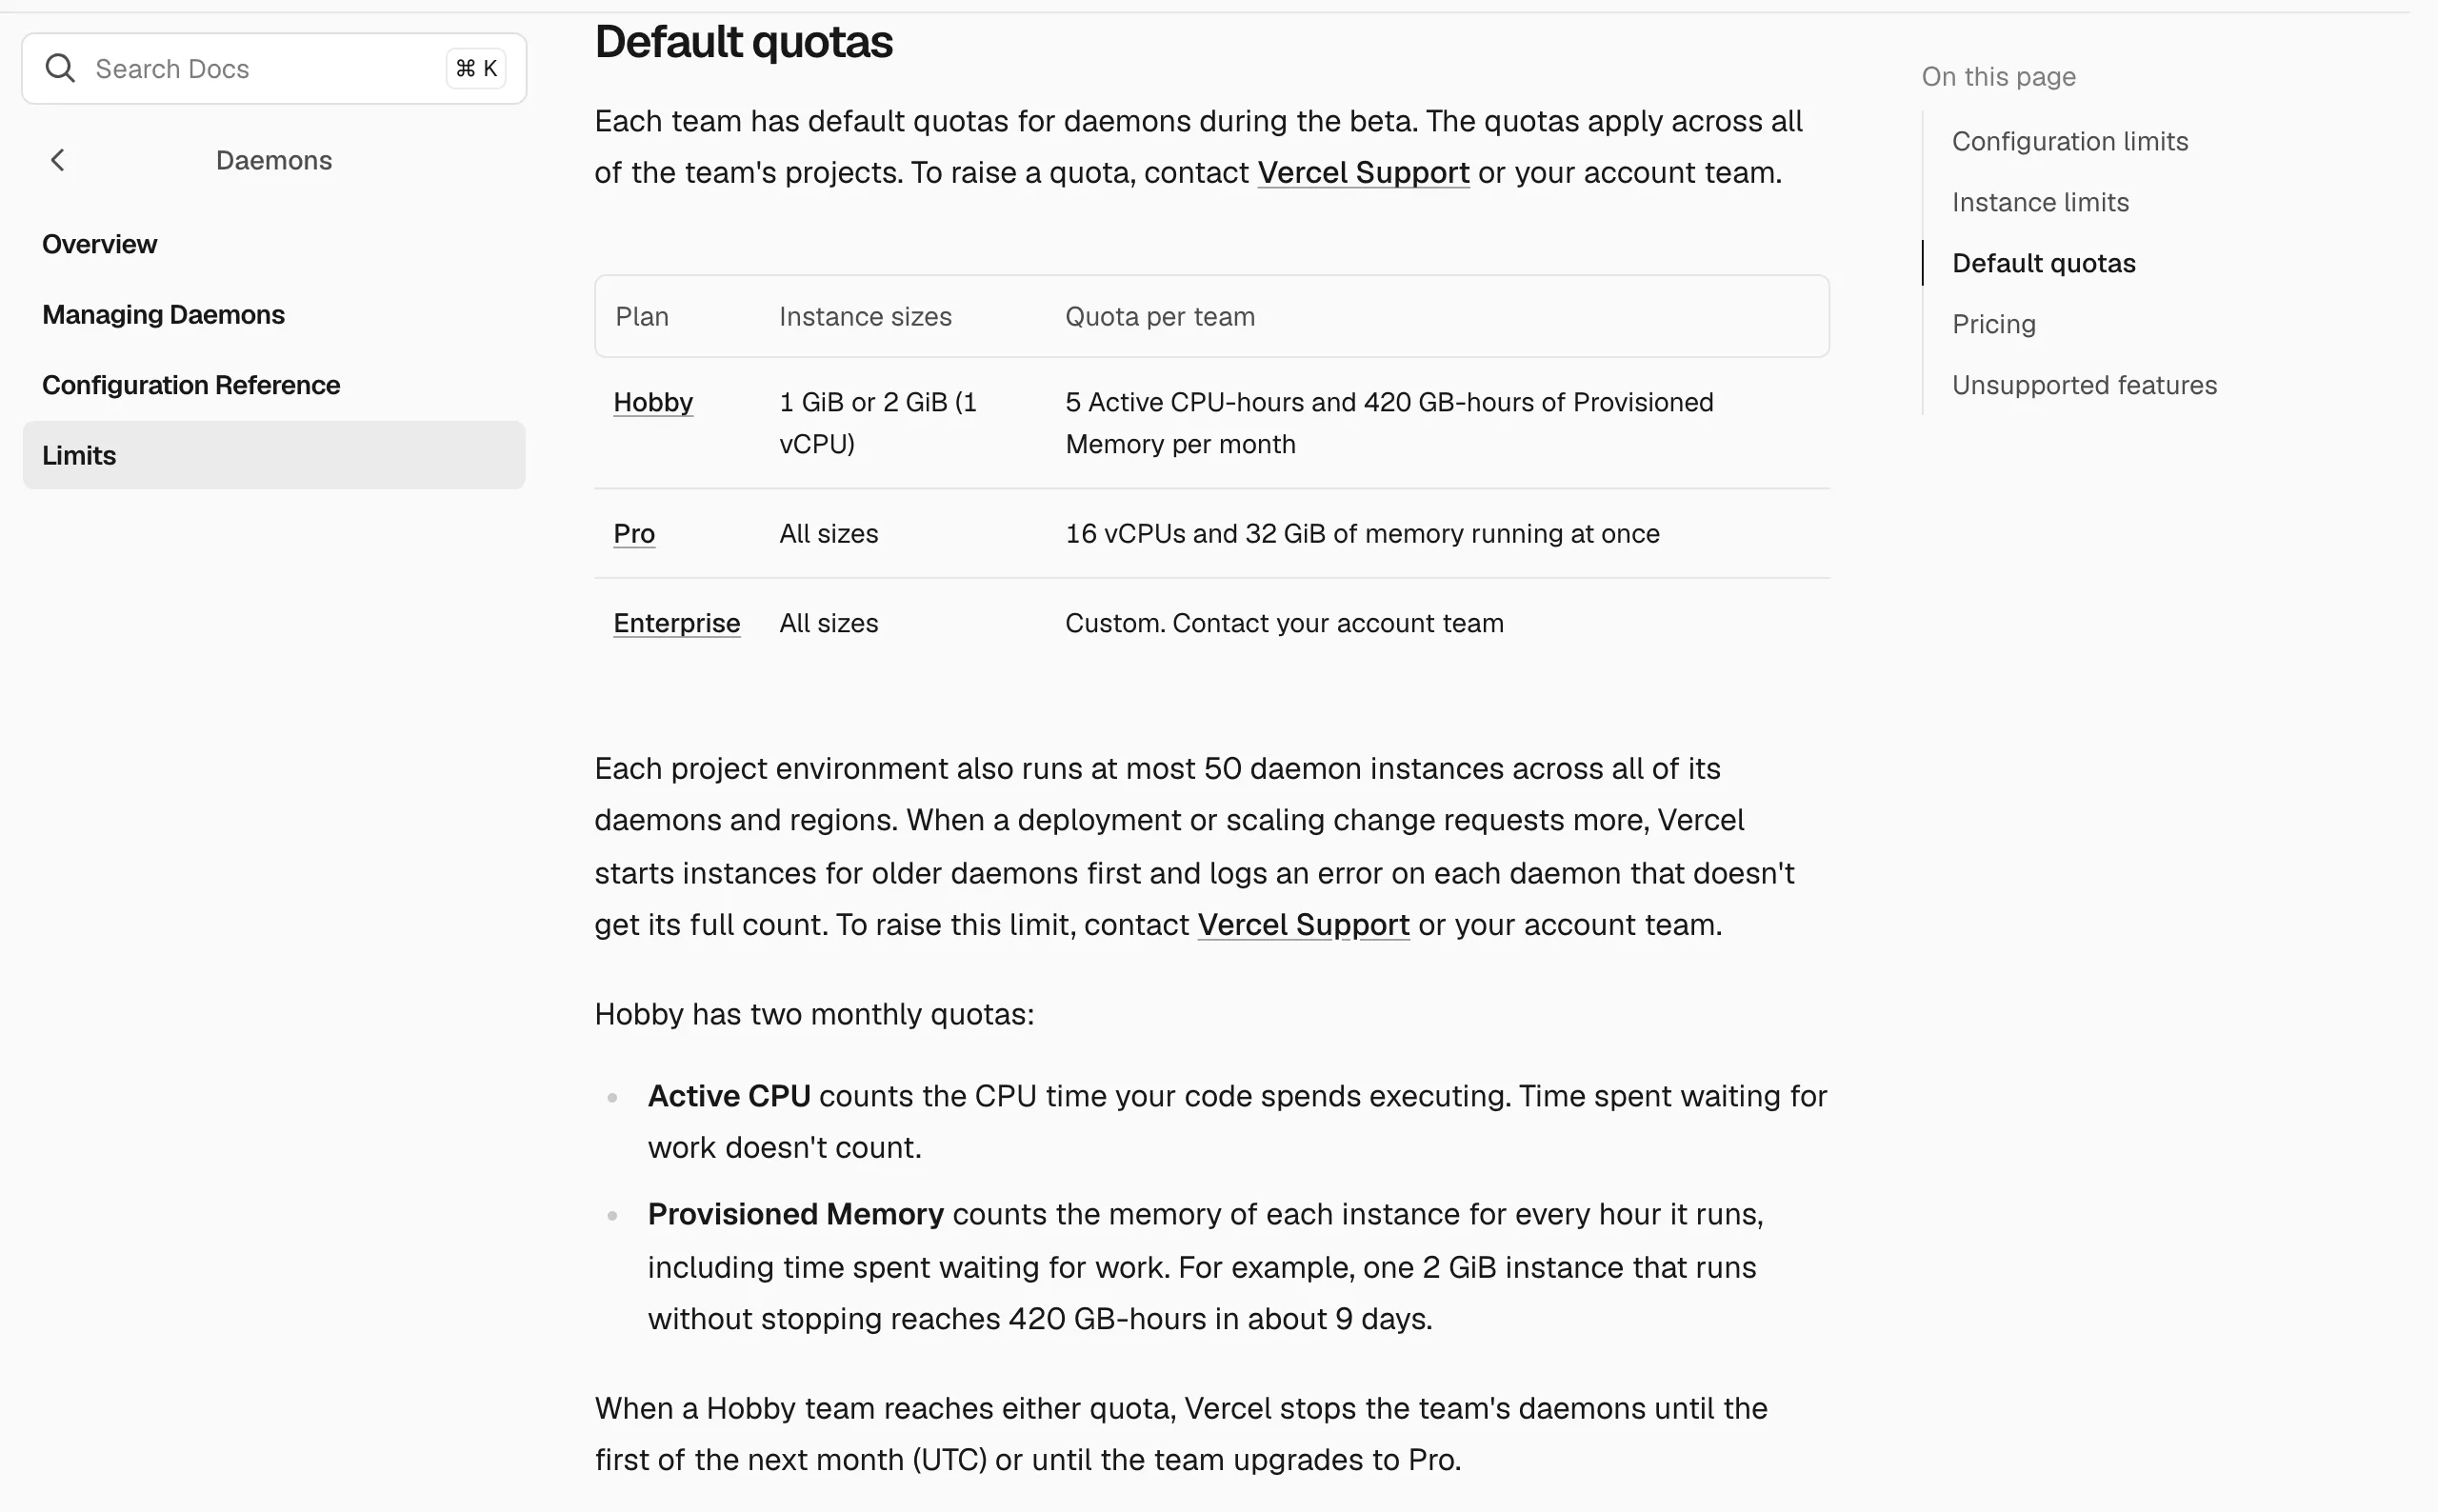
各方案都吃得到 beta,但額度結構值得單獨看,因為它決定誰真的用得起常駐。Hobby 每月內含 5 個 Active CPU 小時與 420 GB-小時的配置記憶體。Active CPU 只在程式碼執行時計,長時間空等工作不計;文件還提醒,HTTPS 的加解密運算也算 CPU,看起來在等的程式未必真的零消耗。記憶體是另一本帳:執行個體每活一小時就計一小時,跟忙不忙無關。
官方給的換算例子:一個 2 GiB 的執行個體不停跑,大約 9 天就把 420 GB-小時用完。用完之後,整個團隊的 daemons 停到下一個 UTC 月初,或者升級到 Pro。換句話說,Hobby 拿得到這個功能,但拿不到一整月的常駐,記憶體額度約只夠三分之一個月。
| 方案 | 可用尺寸 | 每月內含 | 超出後 |
|---|---|---|---|
| Hobby | 1 或 2 GiB(1 vCPU) | 5 Active CPU 小時+420 GB-小時 | 不計費,額度用罄即停到下個 UTC 月初 |
| Pro | 1 到 8 GiB | 定價頁未單列內含額度 | CPU 每小時 0.128 美元起、記憶體每 GB-小時 0.0212 美元起 |
| Enterprise | 全部尺寸 | 另議 | 另議 |
Pro 與 Enterprise 依 Active CPU 與配置記憶體兩軸計費。拿定價頁費率換算,一個 2 GiB 執行個體跑滿整月約 1,440 GB-小時,以每 GB-小時 0.0212 美元計,光記憶體一項約 31 美元,閒置不等於免費。規模上限畫在同一份文件裡:每個 daemon 每區域最多 100 個執行個體、每個專案最多 100 個 daemons、每個專案環境最多 50 個執行個體,超量時平台先滿足較舊的 daemon,吃不滿的會在日誌記錯誤。
limits 頁的不支援清單替 beta 階段畫出圍欄:只在正式環境跑,沒有 preview 部署;沒有自動縮放,執行個體數量手動設;沒有持久本機儲存,狀態要放資料庫或 Blob 這類服務;不收外部 HTTP 或 TCP 流量;vercel dev 不會執行 daemon,設定檔裡有 daemons 時它印警告然後跑其餘部分,本機測試要用 Docker 自己起容器;執行環境只有 Linux amd64 一種架構;專案的根目錄若設在子資料夾,目前還不能加 daemons。試驗流程跟一般網站的 preview 部署完全是兩回事,這大概是最容易踩到的營運差異。
至於這跟 AI 的關係,Vercel 自己的文件給了定位:Agent Frameworks 頁把 Daemons 列為代理(AI agent)基礎服務的一員,與 Functions、AI Gateway、Sandbox、Passport 並列,角色是持續從佇列或工作流引擎拉工作的背景 worker。代理跑長任務需要有人承接等待與重試,常駐程序就是那個承接層。同一條產品線上,AI Gateway 十月底才把模型選擇收進 Virtual Models 的共用名稱,市集憑證也剛換到短效身分;Daemons 補上綁定與存活檢查後,這套給代理用的地基又厚了一層。代理的工作負載若已經長到要排隊等設備,裝置租約是另一種正在出現的解法。
適合現在就接上的,是已經在 Vercel 正式環境跑佇列消費者或工作流 worker、而且後端本來就要自己張羅認證與地址的團隊:綁定收走的正是那塊最容易出錯的膠水,存活檢查補上崩潰之外的另一種死亡形式。想在 Hobby 上試水溫,先想清楚記憶體額度只夠九天,把它當評估環境而不是長期常駐。還沒把工作冪等做好的程式碼,先補那件事再掛探針,否則存活檢查只是把缺陷用更高的頻率重播。
未定案的部分也該列清楚:preview 部署、自動縮放、持久儲存都不在 beta 支援範圍,官方沒有給時間表;定價頁的 daemon 費率掛著 beta 字樣,數字可能隨階段調整。Public Beta 從 10 月 15 日到月底已經兩批更新,間隔不到三週,之後要引用任何數字,先回官方文件與定價頁看當下的值。