TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

DeepSeek Harness 團隊開源 dsh-superagent 研究原型並發表超級代理設計長文,Bloomberg 與 Polymarket 把它說成衝著 Claude Code 而來;文章全文沒有出現 Claude,29.5 降到 15.7 分鐘是模擬寫程式的排程實驗,文件預設以 danger-full-access 執行且明言不是安全邊界。
用 AI 摘要這篇文章:
11 月 1 日晚間,DeepSeek Harness 團隊在 X 發布長文〈Exploring Super-agent Design: Towards a More Autonomous Agent System〉,前一天晚間,團隊已在 GitHub 放出研究原型 dsh-superagent-prototype。消息傳開的過程裡,「衝著 Claude Code 來」成了定調:Bloomberg 的貼文寫它 “seeks to challenge Anthropic’s popular Claude Code”,Polymarket 說它 “designed to rival Anthropic’s Claude Code”,幾個小時後 Cointelegraph 照樣複誦。
把原始文件攤開會看到另一個故事。那篇全文四萬五千多字元的文章裡,Claude 出現 0 次,Codex 0 次,OpenAI 0 次;Anthropic 只出現 2 次,而且都在同一節,引用的是 Anthropic 今年 4 月談託管代理(Managed Agents)的文章,用意是把兩邊鎖定的場景差異講清楚。至於在 X 上瘋傳的「完成時間從 29.5 分鐘降到 15.7 分鐘」,出自文章第七節的實驗,而那個實驗的寫程式環節是模擬的,作者自己標明結果「僅供參考」。
重點有三:這個原型和文章實際上給了什麼、15.7 分鐘那組數字能推到哪、以及文件裡寫給動手安裝的人看的但書。
先看時間順序。GitHub 儲存庫在 10 月 31 日晚間 8 點 05 分(台北時間)出現唯一一筆 commit,署名 DeepSeek Harness Team,授權 MIT。Hugging Face 研究主管 Leandro von Werra 在 11 月 1 日凌晨 4 點 51 分轉貼,用的是 README 裡的說法。Bloomberg 的貼文在中午 12 點 50 分發出,Polymarket 在晚間 7 點 11 分,而 DeepSeek 自己的文章到晚間 7 點 37 分才上線。
| 時間(台北) | 事件 | 重點 |
|---|---|---|
| 10/31 20:05 | GitHub 出現唯一 commit | MIT 授權,單一 commit,無貢獻者名單 |
| 11/1 04:51 | von Werra 轉貼 | 引 README 語句「用最少的人類注意力,換最多的價值」 |
| 11/1 12:50 | Bloomberg 貼文 | “seeks to challenge Anthropic’s popular Claude Code” |
| 11/1 19:11 | Polymarket 貼文 | “designed to rival Anthropic’s Claude Code” |
| 11/1 19:37 | DeepSeek Harness 發文 | 全文無 Claude,實驗章節自帶但書 |
| 11/1 21:31 | Cointelegraph 貼文 | 沿用「aiming to rival」框架 |
換句話說,「與 Claude Code 較勁」的框架在 DeepSeek 發文前就已經定調,Bloomberg 早了大約 7 小時,Polymarket 早了 26 分鐘。DeepSeek 的文章不但沒有跟進這個框架,連對手的名字都沒提。這則長文發出後倒是真的引爆:11 月 2 日上午讀取時,瀏覽超過 109 萬次、8,700 多個讚、9,300 多次書籤收藏,DeepSeek Harness 帳號的追蹤數來到 4.8 萬上下。
文章裡唯一與 Anthropic 有關的段落,是引用〈Scaling Managed Agents: Decoupling the brain from the hands〉(2026 年 4 月 8 日發布)。作者的用法是肯定而非挑釁:Anthropic 那篇文章談「把大腦與雙手分開」的託管服務,harness 保持無狀態、session 紀錄放在外部、執行環境經統一介面按需接上,環境放在按需建立的沙盒與客戶的 VPC 裡;DeepSeek 團隊說自己採取同一種思路,差別在要先把人每天在用的個人機器接上來。兩篇放在一起讀,關係更接近引用同一路線的先行者,稱不上隔空叫陣。
X 上這篇長文標註為機器翻譯,原文是中文;下面引用的英文句都出自 X 上的英文版。
流傳最廣的數字來自文章第七節〈Preliminary Experiments〉。它在 X 上的傳播鏈很好追:有人把兩個百分位數摘成一句「p95 completion time dropped from 29.5 to 15.7 min」,一句話轉發比原文傳得快。實驗設計是這樣:模擬一個群組聊天加 GitHub CI 的訊息流,每次約 300 則訊息,其中約 20 則是真正的工作請求,其餘是閒聊、追加、取消與 CI 通知;四種設計各跑 5 次,量測從工作請求到結果訊息的完成時間。訊息間隔與工作時長縮為四分之一,模型呼叫時間沒有縮。
關鍵但書在這句:「Coding work was simulated by a tool that simply consumes time」(寫程式的工作是用一個只會消耗時間的工具模擬的)。作者接著寫明,這個實驗量的是系統的排程與協調,個別任務的執行能力並不在量測範圍內;第七節開頭也聲明實驗使用合成工作量與簡化環境,結果 “indicative only”(僅供參考)。
四種設計的結果:
| 設計 | 完成時間 p50/p95(分鐘) | 每次快取讀取量(百萬 token) |
|---|---|---|
| Super-agent | 12.4/15.7 | 23.2 |
| Super-agent(去掉 pass-through) | 12.6/15.5 | 31.8 |
| 單一 session+subagent 工具(中性提示詞) | 20.4/29.5 | 6.1 |
| 單一 session+subagent 工具(委派優先提示詞) | 13.8/29.0 | 10.8 |
p50 是一半任務會落在的時間,p95 是 95% 任務完成的時間上限。X 上流傳的「29.5 降到 15.7」,就是把中性提示詞那組的 p95 拿來對 Super-agent 的 p95,換算降幅約 47%;若看 p50,是 20.4 對 12.4,約 39%。數字本身沒有造假,但對照組不是 Claude Code 或任何競品,是「單一 session 加 subagent 工具」這個基本款設計。
實驗裡有兩個細節比總分更能說明問題。中性提示詞下,模型 5 次執行裡一次都沒有呼叫 subagent,所有工作擠在主 session 裡做,新訊息不斷打斷它,p95 才會被拉到 29.5 分鐘;換上要求優先委派的提示詞後,5 次裡有 4 次委派,p50 降到 13.8 分鐘,已經很接近 Super-agent 的 12.4,但 p95 仍是 29.0,因為有一次模型判斷工作「很小」就自己做了,拉出長尾。作者的結論也寫得誠實:單一 session 的設計要靠提示詞工程和模型的臨場判斷來決定要不要委派,兩層架構是把這個問題搬到系統層解決。
快的代價是 token。Super-agent 維持多個獨立 session,每次執行的快取讀取量是對照組的約 2.1 到 3.8 倍(23.2 對 10.8 與 6.1)。文章的說法是 “trading tokens for shorter and more stable completion times”(用 token 換更短更穩定的完成時間);去掉 pass-through 機制的版本完成時間差不多,但 Router 要多做約 30% 的決策,快取讀取量再增 37%。快取讀取量不等於費用,文章沒有給任何金額。
同一節還有個容易被略過的批次化實驗:把需要決策的事件到達率從每分鐘約 1 次拉到約 40 次,Router 的平均批次大小從 1.0 升到 2.8,每個請求的耗時只從 2.5 秒升到 3.9 秒,換算每個決策的攤銷推理時間反而從 6.4 秒降到 1.6 秒。事件成群進來時,這一層靠自動合併堆積的事件來提高有效吞吐。
放下數字,這篇文章的核心主張其實是:現在的 coding agent 以單一 session 當基本工作單位,多工的瓶頸卡在人。作者的經驗談是「一個人通常只能同時盯 3 到 5 個進行中的 session」,這句沒有引用研究,是團隊自己的觀察,讀者可以拿自己的經驗對照。
文章把兩種現成做法的取捨講得很清楚。把所有事件都導進同一個 session,連續性最好、context 最全,但單一迴圈一次只能走一步,吞吐量有天花板,不同任務的中間細節還會混在一起互相干擾;反過來讓每個事件各開一個新 session,並行能力最大,但任務之間沒有共享的全域 context,各自回話也讓人混亂。兩層架構就是在這條光譜上找切分點:Router 層是一個長壽的 session,負責所有人機互動與全域協調,看得到全貌;Worker 層是互相隔離的執行 session,負責並行把任務做完,彼此不串 context。使用者在 IM 和 GitHub 上感覺永遠在跟同一個代理說話,不必記得哪個 session 記得哪些事。
作者說內部實例已經在跑:同一個開發任務可以在群組聊天和 GitHub Pull Request 評論之間接續;它也監看公開群組裡的回饋,沒有人標記它,自己找問題根源、開 PR 修掉。文章用一個例子說明「連續」是什麼感覺:使用者在 IM 說了 A 計畫、之後在 PR 評論改成 B 計畫,代理讀得出改變並調整手上的工。周邊配套包括事件驅動的觸發(訂閱、過濾、路由)、全雙工多通道互動、把運算與狀態分離(雲端跑 Agent Loop、端點裝置只放輕量 daemon),再加一個外部 Watchdog。
雲端那一步也帶著作者自己點出的風險。第八節談安全與隱私時寫得相當直白:Agent Loop 放在雲端、執行裝置放輕量 daemon 的設計,前提是雲端與端點互相信任,可是「If a server-side intrusion or a prompt injection compromises the Agent Loop, every endpoint device connected to it could be taken over」(若伺服器端被入侵或提示注入攻陷了 Agent Loop,所有連上它的端點裝置都可能被接管)。憑證也是同一類問題:只要端點上的憑證有機會進到模型的 context,正常執行也可能把它暴露出去,所以需要一種「用得到憑證、但模型看不到憑證」的機制,而這題還沒有解。
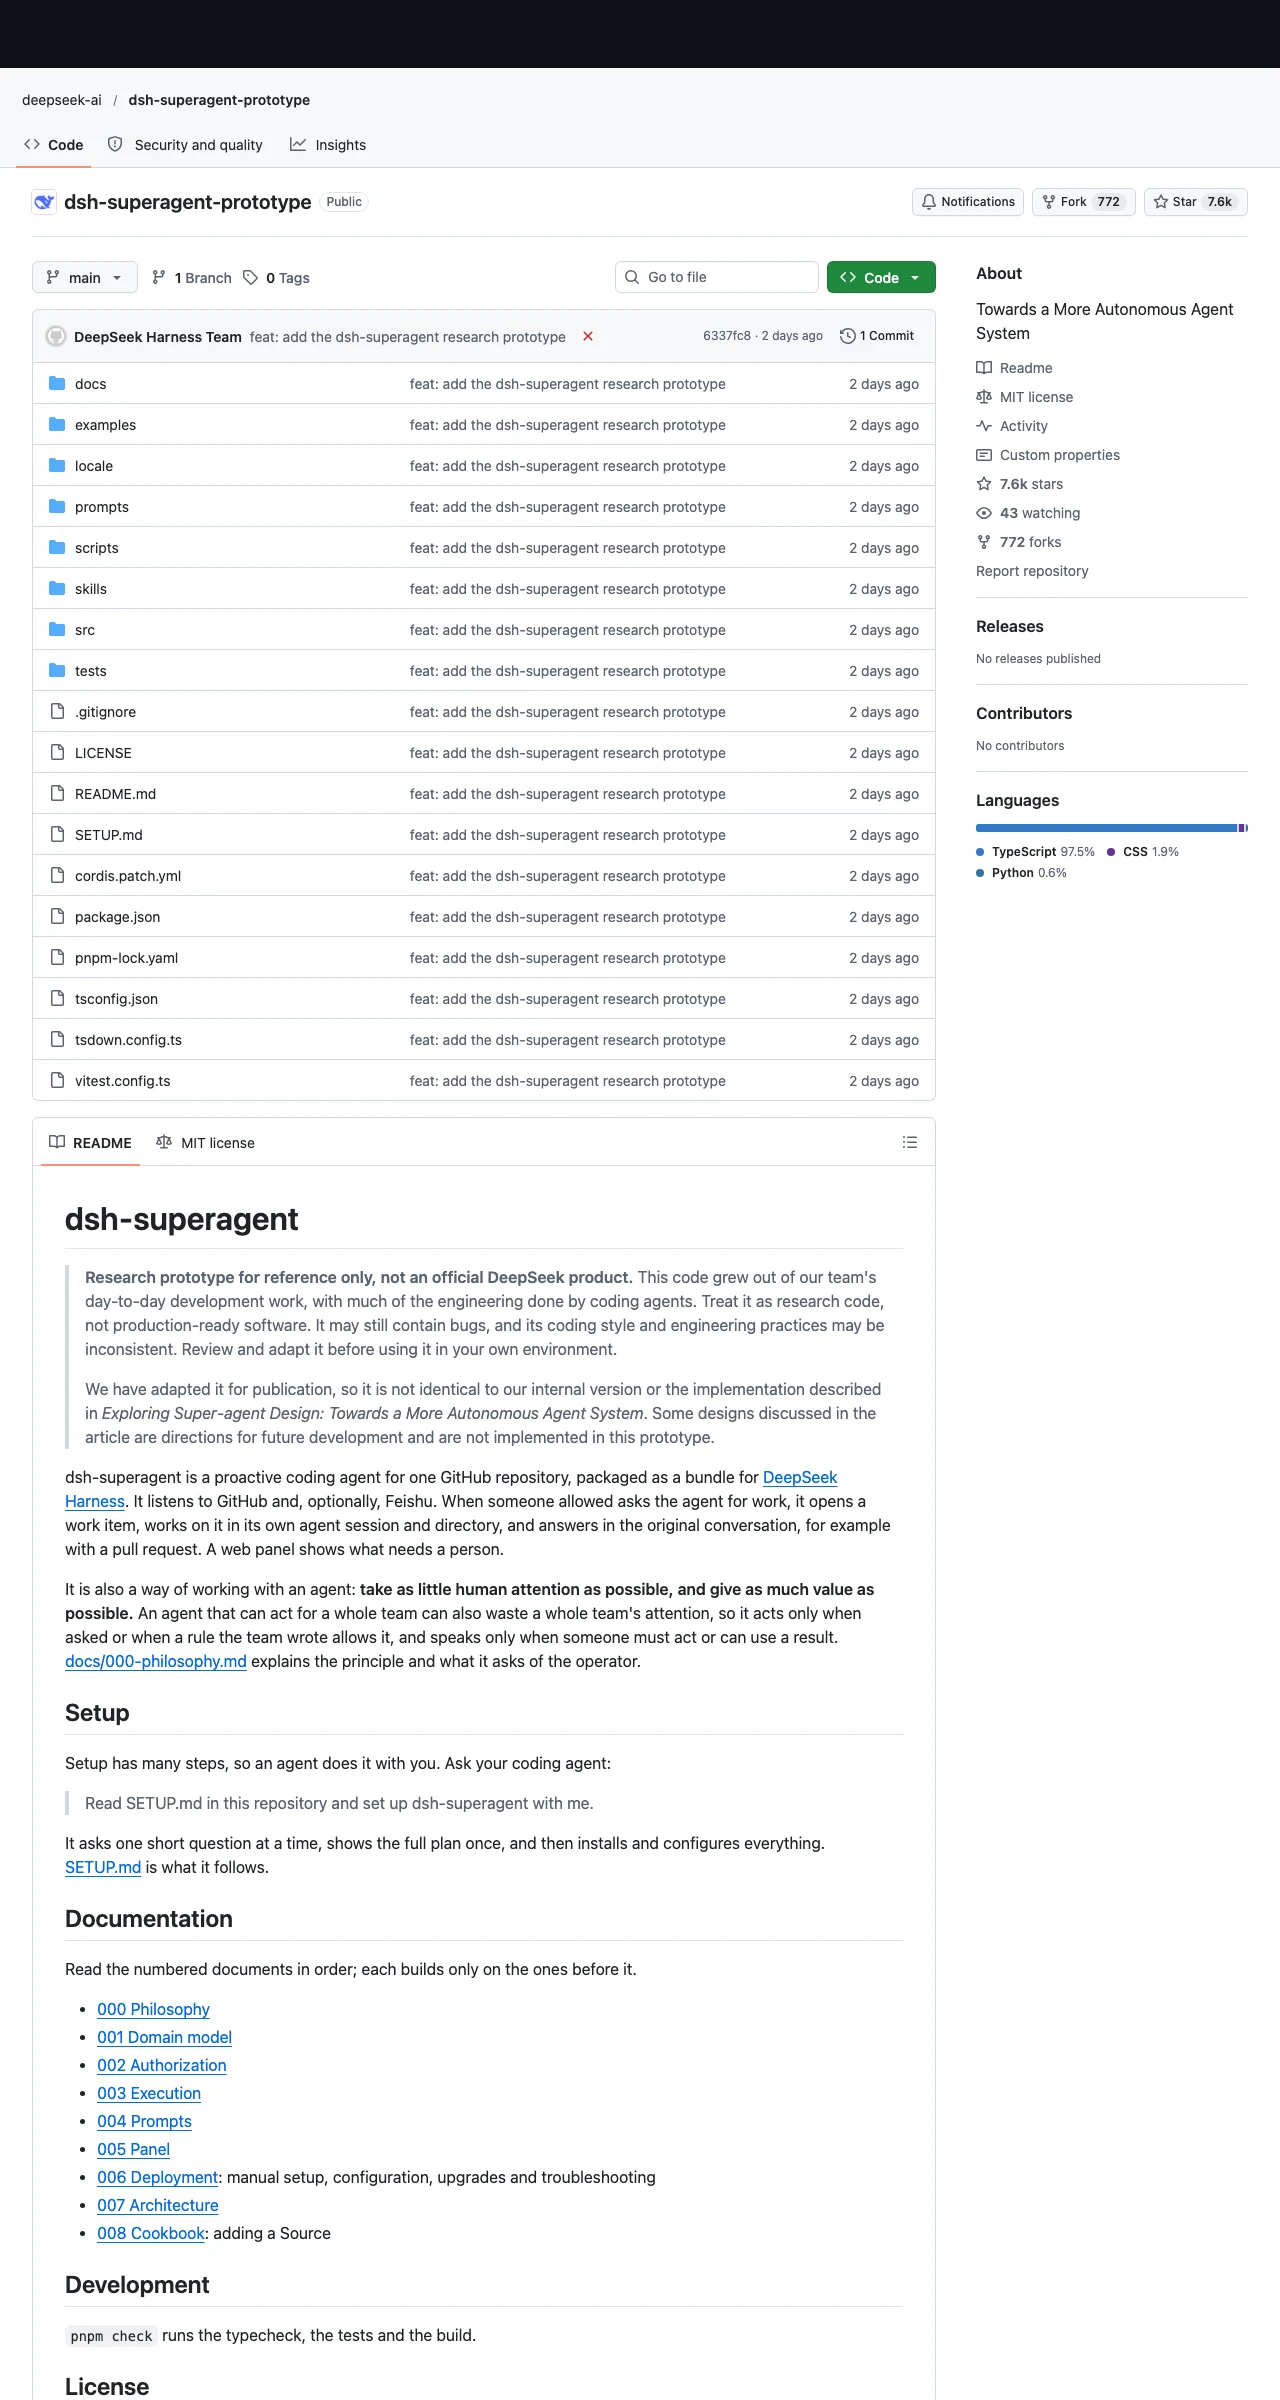
開源出來的原型比文章描述剋制得多。README 寫它是一個「針對單一 GitHub 儲存庫的主動式 coding agent」,監聽 GitHub,可選接飛書(Feishu);被允許的人開口請它做事時,它開一個工作項目,在自己的 session 與目錄裡做,回到原對話回覆,例如開一個 pull request,另有一個網頁面板顯示哪些事需要人處理。文章提到的雲端 Agent Loop、裝置端 daemon 那套設計,原型沒有實作,README 明講「文章裡的某些設計是未來方向,沒有在這個原型裡實現」。
README 開頭的定位聲明也值得原樣理解:「Research prototype for reference only, not an official DeepSeek product」(研究原型,僅供參考,不是 DeepSeek 官方產品),而且「為了發布而改寫過,與內部版本不相同的版本」,不少工程還是 coding agent 做的。DeepSeek Harness 本身是開源代理框架,想在生活中接觸這套生態,可以從把 DeepSeek Harness 收進桌面的封裝工具開始;框架視角的另一個近期樣本是 Google 開源的 Harness²。
這個原型能不能直接拿來用?文件把答案寫得很白,只是散在三份文件裡。
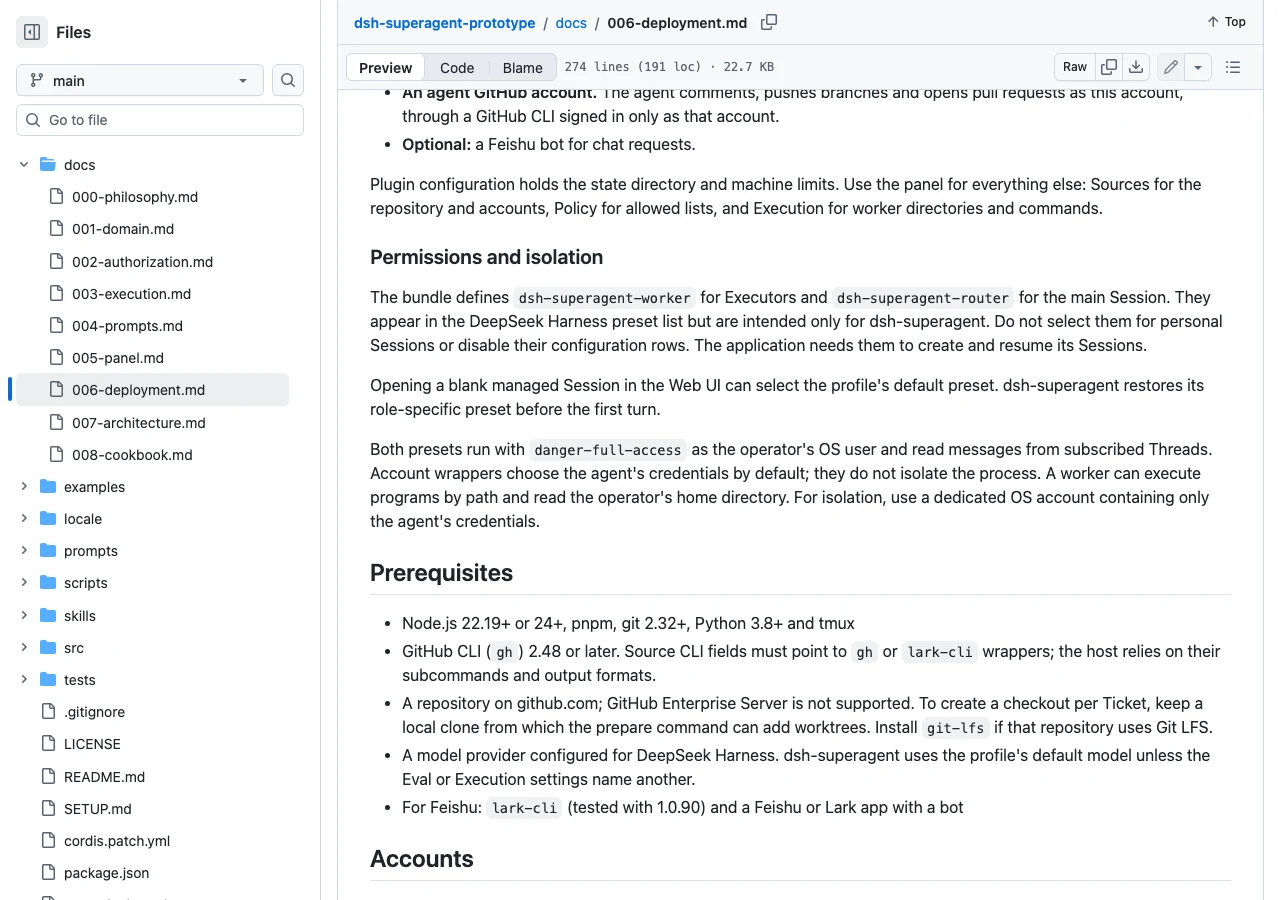
權限是最大的一條。docs/006-deployment.md 寫:「Both presets run with danger-full-access as the operator’s OS user」,兩種預設組合都以操作者的系統帳號執行、權限是 danger-full-access,worker 可以按路徑執行程式、讀操作者的家目錄。文件給的隔離建議是另建一個只放代理憑證的專用作業系統帳號。docs/003-execution.md 更直接:「These wrappers and directories establish defaults, not a security boundary」(這些包裝器與目錄建立的是預設值,並不構成安全邊界)。
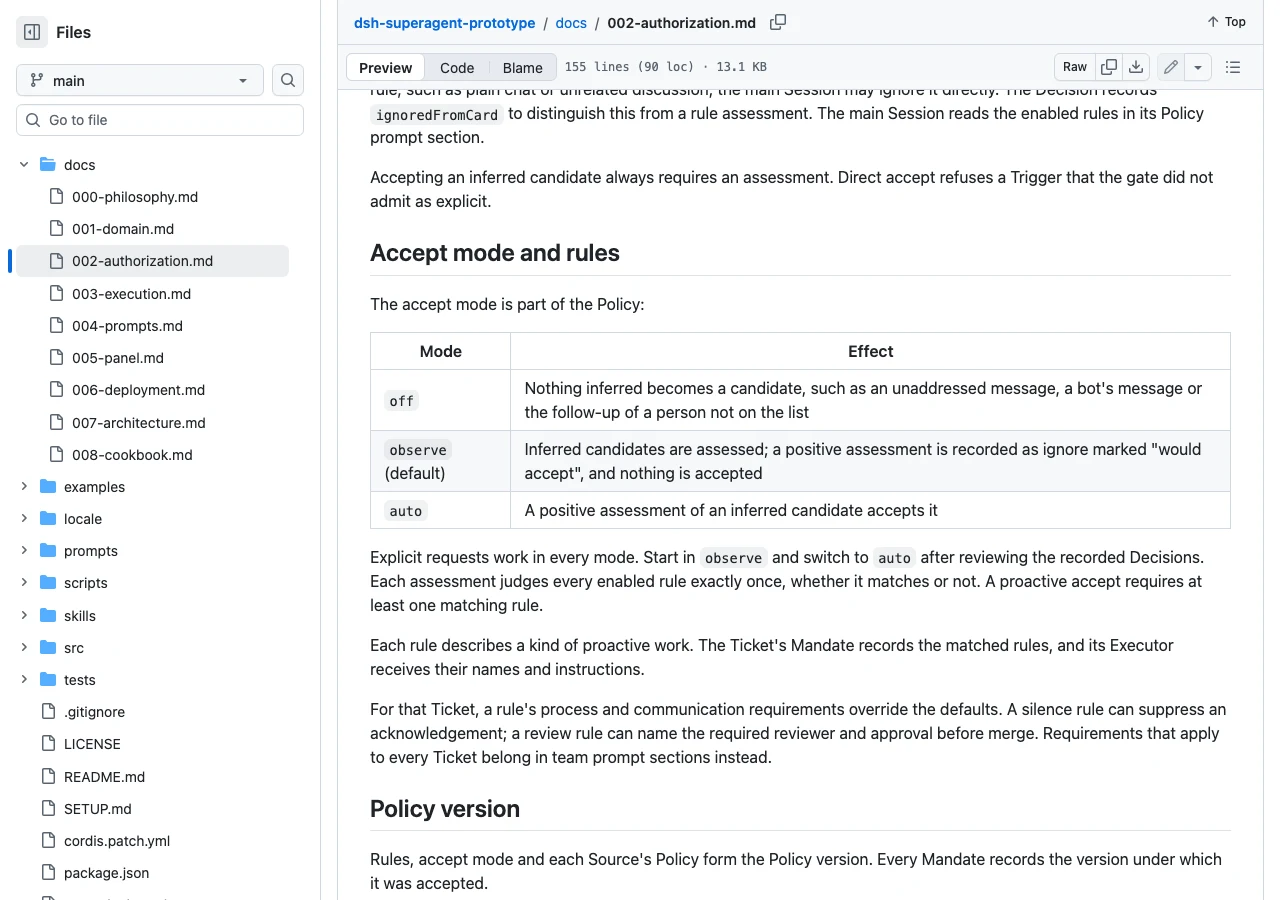
主動接工作的預設是關的。docs/002-authorization.md 的接受模式表列了三種:off、observe(預設)、auto。observe 模式下,代理會評估推斷出來的工作候選,正向評估只記成一條標了 “would accept” 的忽略紀錄,什麼都不會真的接下;明確被要求做事時,任何模式都會執行。SETUP 的問答也把專用 GitHub 帳號設為預設答案:代理用另一個帳號行動,不用操作者本人的。
自動合併預設不開。SETUP 第 9 題的預設答案是「No: people merge until the agent’s pull requests have been right for a while」(先由人合併,等它的 PR 穩定一陣子再說)。若開啟,預設指令也只允許對「已就緒、核可通過、增刪合計少於 200 行」的 PR 自動合併,而且代理不以自己的帳號啟用自動合併。
環境需求方面,機器要有 Node.js 22.19 以上(或 24 以上)、pnpm、git 2.32 以上、Python 3.8 以上、tmux 與 GitHub CLI 2.48 以上,儲存庫必須在 github.com,GitHub Enterprise Server 不支援。倉庫現況是單一 commit、無貢獻者名單、無 release,11 月 2 日讀取時約 7,600 顆星。
討論串裡還有一個常被引用的數字:Gradient 的貼文說,DeepSeek V4.1 Flash(1017)搭配 dsh 在 Zero2Repo 榜單解出 17 題裡的 8 題,OpenCode 7 題,Claude Code 5 題。這組數字在榜單上對得起來:同一個模型欄位分別配三種 harness(dsh、OpenCode、Claude Code),完全通過的題數正是 8、7、5。Zero2Repo 的判分方式是交付出來的儲存庫跑一次隱藏測試,全過才計 1。
不過這個榜單與前面的原型是兩回事。榜單量的是 harness 帶著模型從規格建成儲存庫的一次性表現,評審不看代理怎麼走,只看結果;dsh 在這裡是 DeepSeek Harness 框架的簡稱,super-agent 原型那套主動監聽、自動接工作的行為則屬於另一回事。Gradient 與 DeepSeek 的關係,兩邊都沒有說明。把它當成「原型打敗 Claude Code」的證據,是第二層的張冠李戴。V4.1 Flash 這個模型本身的定位,可以參考DeepSeek V4.1-Flash 發表當時的整理。
能下的判斷:在作者自己的模擬工作量下,把「接人」與「做事」分成兩層的設計,完成時間比單一 session 加 subagent 工具短而且穩,代價是更多 token;這個原型是一個態度嚴謹的研究參考實作,文件裡的但書(模擬、僅供參考、非官方產品、非安全邊界、公開版不等於內部版)就是它的使用說明。
不能下的判斷:它的寫程式品質、真實專案的成功率與費用、以及它與 Claude Code 或任何其他 coding agent 的優劣。README、文章、docs 與 DeepSeek Harness 官網都沒有這類數字,「找不到」不代表不存在,但至少目前沒有可引用的來源。
會改變結論的條件也明確:一是出現真實工作量的測試或第三方復現;二是 DeepSeek 把內部版本的能力帶進公開實作。在那之前,星數、瀏覽數這類數字每小時都在變,引用前以 GitHub 儲存庫與 DeepSeek Harness 的 X 帳號現況為準。想先圍觀的人,從 README 與 docs/000 的哲學文件讀起就夠;想動手的人,專用 GitHub 帳號、observe 模式起步、短白名單,是文件自己給的路線。