TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

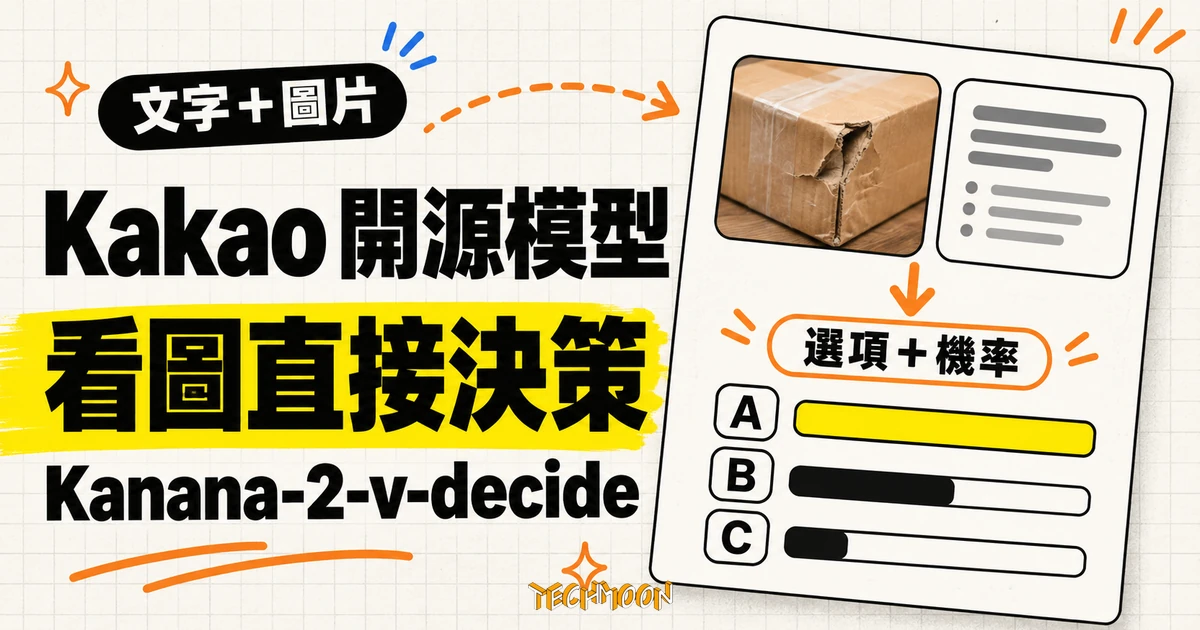
Kakao 於 2026 年 11 月 6 日在 Hugging Face 開放 Kanana-2-v-decide 權重:36.7 億參數的多模態決策模型,讀完文字與圖片直接回傳選項與機率,與 Jev 呼叫格式相容可自架。本文對照模型卡、官方新聞稿與開發部落格,拆三種問題型別與 confidence 讀法、三套評測分母、42ms 量測條件,以及授權對第三方提供 API 畫出的另行商業授權紅線。
用 AI 摘要這篇文章:
Kakao 在 2026 年 11 月 6 日把自家的多模態決策模型 Kanana-2-v-decide 放上 Hugging Face,倉儲全名 kanana-2-v-decide-3b-2611,權重直接開放下載。這個模型讀完文字與圖片後不生成句子,而是回傳候選答案的機率分布:分類該歸哪一槽、某個條件成立的機率是多少、評比分數落在哪一級,全部是程式可以直接接手的數字。總參數約 36.7 億,其中視覺編碼器約 4.9 億、語言模型約 31.8 億,基礎是 Kakao 自家的多模態模型 Kanana-2-v-3b。
「決策模型」這個品類在 2026 年 9 月 TypeSafe AI 發表 Jev 之後快速升溫,OpenAI、Perplexity、微軟與 Liquid AI 都在一個月內跟進。Vercel 十月的流量報告也顯示這個趨勢進了生產環境:決策模型已吃下 26% 的閘道請求,卻只占 0.53% 的花費。Kanana-2-v-decide 在這個品類裡的位置很清楚:權重開放可自架、看得懂圖片、呼叫格式與 Jev 相容。對已經在代理流程裡設了固定判斷點的團隊來說,多了一個把判斷層整段搬回自己基礎架構的選擇。Kakao 的 Kanana 系列 10 月底才開源過 Kanana-2-embedding 嵌入模型,這次是同一系列往決策任務再推一步;本篇數字都出自 Kakao 的模型卡、官方新聞稿與開發部落格,沒有下載權重另行實測。
模型卡定義了三種問題型別。choice 從多個候選裡挑答案,回傳每個候選的機率與選中的鍵;noul 回答是非題,交回敘述為真的機率;score 把結果放在二到十級的有序等級上,回傳各等級機率與等級索引的期望值。若等級是低、中、高(對應索引 0、1、2),回傳值就落在 0 到 2 之間,是各等級機率加權後的位置;業務端要的金額、百分比或文字評語,仍然要自己另外對應。
官方範例是客服場景:一張破損商品照片配上換貨請求,同一個請求裡同時問三件事,這筆詢問該歸到配送查詢、換貨請求還是付款詢問(choice)、商品是否損壞(noul)、客戶情緒多正面(score),系統再依結果決定轉人工或進換貨流程。一次請求可以帶多個問題,但模型卡也寫明每個問題要分別跑一次運算,多問不代表整批只算一次。
讀機率時最容易誤踩的是 confidence。choice 的 confidence 常被當成最高機率或把握度,實際計算是最高機率減去其餘候選機率的平均,描述的是領先幅度。模型卡同時明說,機率是相對於開發者給定的候選集合:多加一個相近的選項,原本集中在某個答案的分數就可能被分走。所以機率門檻要連候選文字一起訂,把別人的 0.8 門檻搬來、卻換了一組候選,判斷條件其實已經變了。介面另有溫度參數(預設 1.0),調高讓分布變平、調低更集中,但它調整的是分布的尖銳度,不會替你補上漏掉的候選答案。
還有一個會影響結果的開關:query_schemas。這個參數控制每個問題的候選文字要不要進入問題編碼,choice 與 noul 預設會把選項帶入,score 的等級則一定帶入。也就是說,候選不只是被拿來比較的答案,還參與了問題本身被編碼的樣子;同一組候選在不同開關下,模型其實看到不同的問題。除錯分數異常時,這是值得優先檢查的設定。
Kakao 在開發部落格補了兩組與輸出品質有關的數字。安全方面,用 MOPD(Multi-teacher On-Policy Distillation)把安全教師與原模型合併訓練後,電車難題式評估裡「不必要造成損害的選擇」從 286 次降到 77 次,類似情境前後矛盾的判斷從 1,343 次降到 851 次,表現比直接做權重加總的安全模型更好。校正方面,confidence 經驗證集調整後,與實際答對率的差距(ECE)從 2.06% 縮到 1.12%,測試集答對率不變。要拿 confidence 做低信心送人工審查的團隊,這組數字是門檻設計的依據,同樣屬官方量測。
報導這類模型最忌諱只引用一個總分。Kakao 這次給的三份文件,比較對象與分數其實對不起來,引用前要先問出自哪一份。
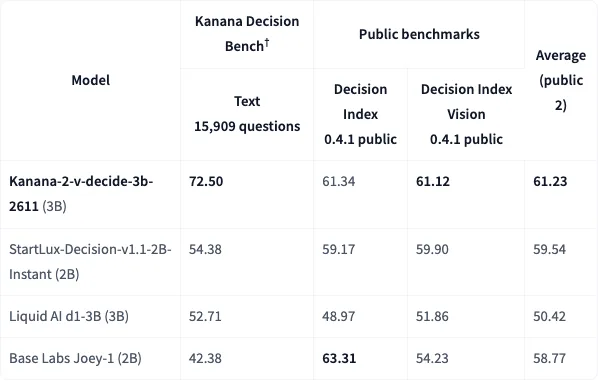
模型卡上的表,Kanana-2-v-decide 在 Decision Index 0.4.1 公開版拿 61.34 分,視覺版 61.12 分,兩項平均 61.23 是表內最高,視覺分數也是表內最高。但同一張表的文字欄,Base Labs 的 Joey-1 拿 63.31,高於 Kanana。表內另外兩個對手是 StartLux-Decision-v1.1-2B-Instant 與 Liquid AI d1-3B;在韓文自建的 Kanana Decision Bench(15,909 題)上,Kanana 拿 72.50,模型卡寫明領先表內次佳 18 分。
官方新聞稿點名的比較對象是另一套:微軟 Decision-1、TypeSafe AI 的 Jev、Perplexity 的 pplx-decider-v1.1-27B 與 Upstage 的 Solar Decide。微軟那篇的上線成績單我們先前拆解過。開發部落格又給出一套數字:Kanana Decision Bench 72.62,小幅領先微軟 Decision-1 的 71.98 與 Jev 1.14.0 的 71.66;Decision Index 公開文字版 61.35,高於 Jev 的 60.70 與 pplx-decider-flash-v1.2 的 60.13。
換句話說,同一個模型在官方自己的文件裡有 72.50 與 72.62 兩個韓文題庫分數、61.34 與 61.35 兩個公開版分數。差距都很小,但分母與對手名單各不相同,也沒有任何一份文件把幾套結果合併成一張表。官方沒有解釋兩個版本的分數差從哪裡來,可能是評測設定或對手版本有異動,這只能當推測;可以確定的是,把其中一個數字單獨拿出來當排名,都會講出官方沒有說過的結論。還要留意語言條件:模型卡的語言標示是韓文與英文,72.50 量的是韓文題庫,繁體中文資料上的表現沒有任何官方數字,台灣團隊採用前得自己帶資料驗證。
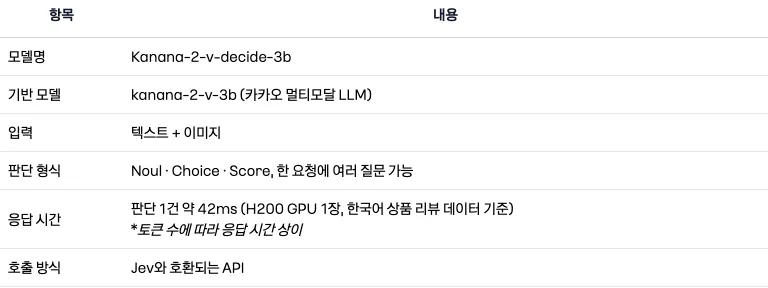
官方新聞稿的說法是:單張 H200 上平均回應時間低於 0.04 秒,比 GPT-6 Luna 快約 43 倍。開發部落格把條件說得更具體:約 42ms 是單次判斷的量測,資料是韓文商品評論,回應時間隨 token 數變動。兩份文件一個寫上限、一個寫約略值,都屬官方公布,目前沒有第三方在相同條件下重跑的結果。
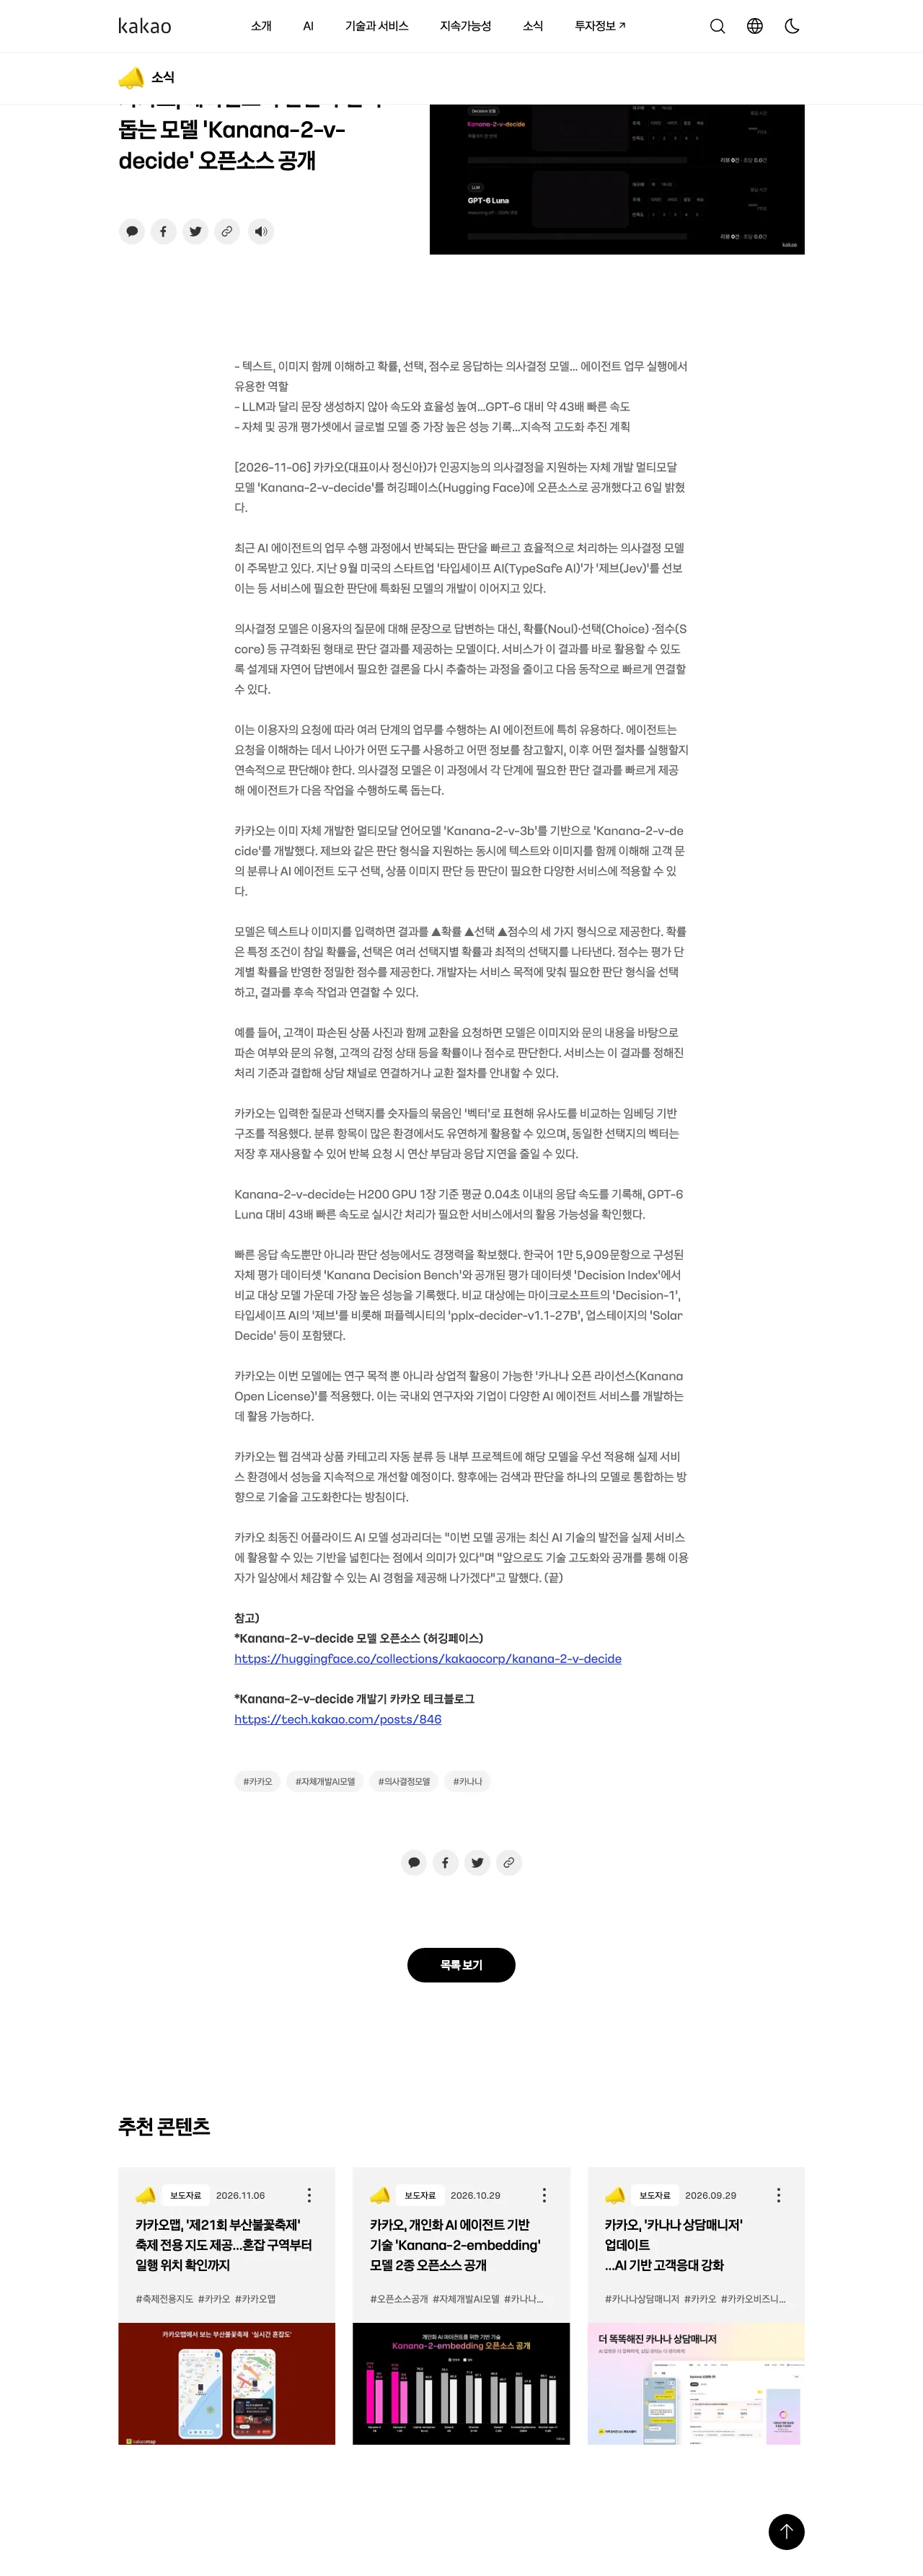
更關鍵的限制是,這個數字只量「判斷」這一步。代理流程裡的網路往返、圖片前處理、工具呼叫與後續的文字生成都不在量測範圍,把 43 倍換算成整條代理流程提速是過度延伸。TypeSafe AI 九月發表 Jev 時用的對比(LLM 8.6 秒對 Jev 0.11 秒)同樣是單一判斷的口徑,兩家都沒有宣稱流程端到端等比例變快。
速度之外,結構選擇對部署成本影響更大。Kanana-2-v-decide 捨棄「生成模型加分類頭」的路線,把輸入與問題編成一個 2,560 維向量,每個候選答案各自編成向量,用餘弦相似度配 softmax 算出機率。開發部落格拿結構已公開的 vLLM Semantic Router d3 當對照組:d3 是在 Qwen3.5 上加分類頭,答案綁在 255 個答案代碼上,候選最多 255 個,且候選順序可能影響結果;Jev 的內部結構則未公開。相較之下 Kanana 的候選數沒有上限、不受順序影響,開發部落格以千級分類(如 ImageNet 式的一千個類別)為例,說明這個設計可以直接撐住大量候選。
對固定候選集的工作負載,這個結構還有一個直接的紅利:同一批候選的向量算過就存下來重用,只有新候選需要先編碼一次。實際服務裡分類體系與工具清單通常是固定的,變動的是使用者輸入,這正好是重用效益最大的形態。Kakao 自己也是這樣用:內部先應用在網頁搜尋與商品類別自動分類,下一步計畫把檢索與判斷整進同一個模型,時程以官方說法為準。
Kanana Open License(全文)對「自己用」與「提供給別人」畫了明確的線。第 4.2 節寫明,只要不落入第 4.1 節的情境,用模型或衍生作品開發與營運自己的服務,不需要另行取得商業授權。第 4.1 節列出的三種情境則要向 Kakao 另外談商業授權,而且給不給由 Kakao 裁量:把模型或衍生作品用 API、雲端平台或其他遠端存取方式提供或轉售給第三方;包進系統整合或地端部署方案賣給第三方;嵌入第三方裝置。
換句話說,把模型放進自己的產品當後台判斷引擎,與讓客戶直接呼叫你包裝過的模型端點,在授權上是兩種交付形態,判斷標準是誰取得模型的使用權,與有沒有收費無關。散布權重或衍生作品時還有隨附義務:給取得者一份授權條款、在修改過的檔案標明修改、在相關網站與產品文件顯示 Powered by Kanana;若用模型材料或輸出訓練其他 AI 並對外散布,新模型名稱要加上 Kanana 前綴。條款的準據法是韓國法,爭議在首爾仲裁。對外提供服務前,值得把交付形態逐條對過 4.1 節再簽約。
輸出的歸屬是另一個簽約前該確認的點。條款第 5 節寫明 Kakao 不對你用模型生成的輸出主張權利,責任也由使用方自負;第 9.4 節則禁止在授權允許範圍外抽取、重製權重,或拿權重去訓練新模型。要把模型輸出再包裝成產品功能的團隊,這兩條界線都畫在你的交付物與衍生作品上,建議讓法務直接讀授權原文。
單次輸入上限是 20,480 個 token,最多附 10 張圖,不支援影片。超長內容預設會保留開頭與結尾、截掉中段,圖片則保留;HTTP 伺服器可改用嚴格輸入模式,把超長輸入直接拒絕,讓程式明確處理錯誤,不讓資料被默默刪改。如果分類依據剛好落在文件中段,預設行為就會讓模型看到的資料與使用者以為交出的不同,這個取捨要在介接時就想清楚。
圖片處理有幾個容易踩的細節。所有圖片會轉成 RGB,透明區域墊上白底;EXIF 的方向標記不會套用,手機直出的旋轉照片要先自己轉正,否則模型讀到的像素方向與螢幕看到的不同。前處理會先把大圖縮到至多 1,638,400 像素、小圖放大到至少 65,536 像素,再切成模型能讀的區塊,極端長寬比不支援。聊天紀錄要用訊息格式送入、保留角色與圖文片段,整段當純字串丟進去是不同的輸入條件。
倉儲附的伺服器程式用 Python 標準函式庫提供 HTTP 介面,端點是 System One API 的 /v1/systemone,與 Jev 的呼叫格式相容,既有的 typesafe-sdk 用戶端換 base_url 就能接。伺服器預設只監聽 127.0.0.1,可設定 DECISION_API_KEY 再對外開放;請求逐一處理,沒有內建併發。載入模型需要 trust_remote_code 與 bfloat16,實際推論離不開 CUDA 環境,「伺服器程式很簡單」與「生產環境就緒」是兩回事。
適合現在動手的團隊特徵很明確:有固定的分類體系或工具清單、判斷量大到延遲與成本開始有感、而且願意自己驗證。合理的起手式是拿自己的一組候選與歷史資料,對比現行作法的錯分率、機率門檻的行為與實際等待時間,官方分數只當入場參考;哪些工作適合交給決策模型,可以沿用我們先前介紹過的 Jev 使用情境盤點方法。同樣走開放權重路線的還有 Amos 1,兩邊都可以列入同一輪評估。
有一種流程暫時不適合直接換上:需要向終端使用者交代判斷理由的環節。決策模型只交出機率分布,判斷理由要靠下游另一個會生成文字的模型來補,這段成本與延遲要一起算進評估,兩個模型各站各的位置。
還沒揭曉的部分也該記著:視覺版評測在模型卡表格裡只有三個對手,開發部落格沒有給視覺版的對手分數;42ms 沒有等條件重跑資料;繁中表現沒有官方數字。模型卡的動態區目前只有 11 月 6 日開放權重一筆,Kakao 說會持續改進並朝檢索判斷整合的方向走,後續更新值得回頭追蹤。