TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

阿里巴巴在 2026 雲棲大會主論壇投影片上首度秀出 Qwen4-Max、Qwen4-Flash、Qwen4-Plus 與 Qwen4-27B 四個型號,全部掛 Coming Soon。從官方議程、現場報導到 Hugging Face、GitHub 與阿里雲百煉文件的紀錄,目前 Qwen4 僅止於名稱曝光:5 至 10 兆參數其實說的是 Qwen4.5 與 Qwen5,真正已公開的是它腳下那套開源新架構與自進化訓練成果。
用 AI 摘要這篇文章:
9 月 22 日上午的杭州雲棲大會開幕式,阿里巴巴在一張投影片上首次秀出 Qwen4 這個名字,畫面上三個標籤框分別寫著 Qwen4-Max、Qwen4-Flash & Qwen4-Plus、Qwen4-27B,配中英雙語的「Coming Soon」。這是 Qwen4 首度以官方姿態現身,但把它理解成「發布了」就讀過頭了。截至 9 月 23 日本文撰稿,我逐一查過 Hugging Face、GitHub 與阿里雲百煉的官方文件,Qwen4 在這些管道裡都還不存在:沒有模型卡、沒有 API 條目、沒有權重、沒有價格。
這場曝光真正值得記住的,是投影片背後兩件已經公開、可查證的事:Qwen4 將蓋在的那套新一代架構已經隨 Qwen3.8-Flash 開源,現場也給出了自進化訓練的第一批成果。判斷 Qwen4 值不值得等,看這些已經攤開的東西,比看四個名字準。
先還原事件本身。雲棲大會官方議程顯示,9 月 22 日 10 點 15 分至 10 點 30 分的主論壇場次「Qwen:邁向真實世界智能體」,由劉大一恆主講,官方列出的頭銜是「阿里巴巴 ATH 事業群 Token Foundry Qwen LLM 項目負責人」。部分媒體把這個頭銜簡化成「新任 Qwen 總負責人」,議程頁的原始文字並沒有這樣寫,引用時以官方版本為準。
Qwen4 的曝光發生在這場演講的投影片上。從現場照片(由與會者在 X 上拍攝發布)逐字核對,投影片主標題是「Qwen4 系列Coming Soon」,下方三個圓角標籤框依序寫著 Qwen4-Max、Qwen4-Flash & Qwen4-Plus、Qwen4-27B,其中 Flash 與 Plus 共用同一個框。投影片整體走深色底配放射狀光束的視覺,會場桁架上掛著雲棲大會的 APSARA 標誌,照片前景是觀眾剪影,是一張典型的主論壇現場紀錄。至頂網的現場報導也記下了同樣的四條產品線分工:以 Max 追求能力上限,Flash 與 Plus 兼顧效率與性價比,再提供面向本地部署的 27B 版本。
這張投影片能證明的,是 Qwen4 家族存在、型號命名延續現行的分層邏輯、而且即將推出。它不能證明的也一樣明確:四款會不會同天上線、各自參數量多少、Qwen4-27B 是否開放權重、授權條款長什麼樣,這些都還沒有答案。
「Coming Soon」的實際含義,可以用三個官方管道當場驗證。第一,Hugging Face 的 Qwen 官方帳號目前共有 468 個模型,我用名稱搜尋 Qwen4,結果是零,帳號內最新的模型是 9 月中上架的 Qwen-Image-2.1 系列,最受歡迎的是 16,042 個讚的 Qwen3.8-27B。第二,GitHub 的 QwenLM 組織最近建立的倉庫是 RecreationWorld 與 Omnilingua-Bench,同樣沒有任何 Qwen4 倉庫。第三,阿里雲百煉平台的官方模型文件裡,Qwen4 出現零次,現行旗艦是 qwen3.8-max,搭配 qwen3.7-plus 與 qwen3.8-flash 組成分層。
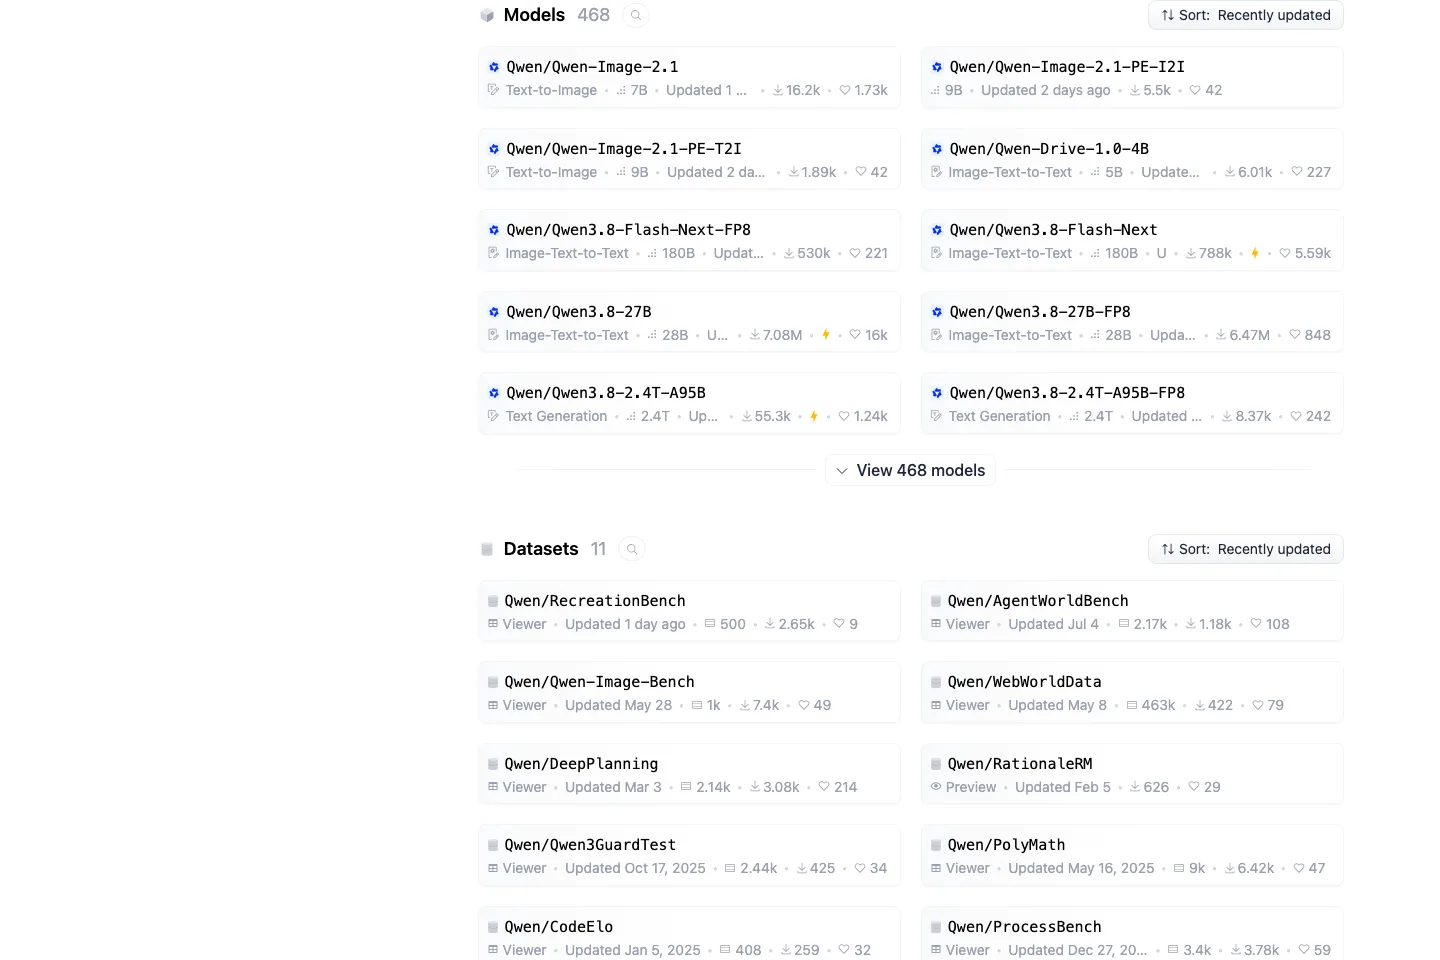
換句話說,現在距離能實際呼叫 Qwen4 還有完整的發布流程要走:模型卡、API 條目、定價、速率限制、可用地區,一項都還沒出現。正在用 Qwen3.8 系列的開發者不需要做任何準備動作,也沒有東西可以提前遷移。
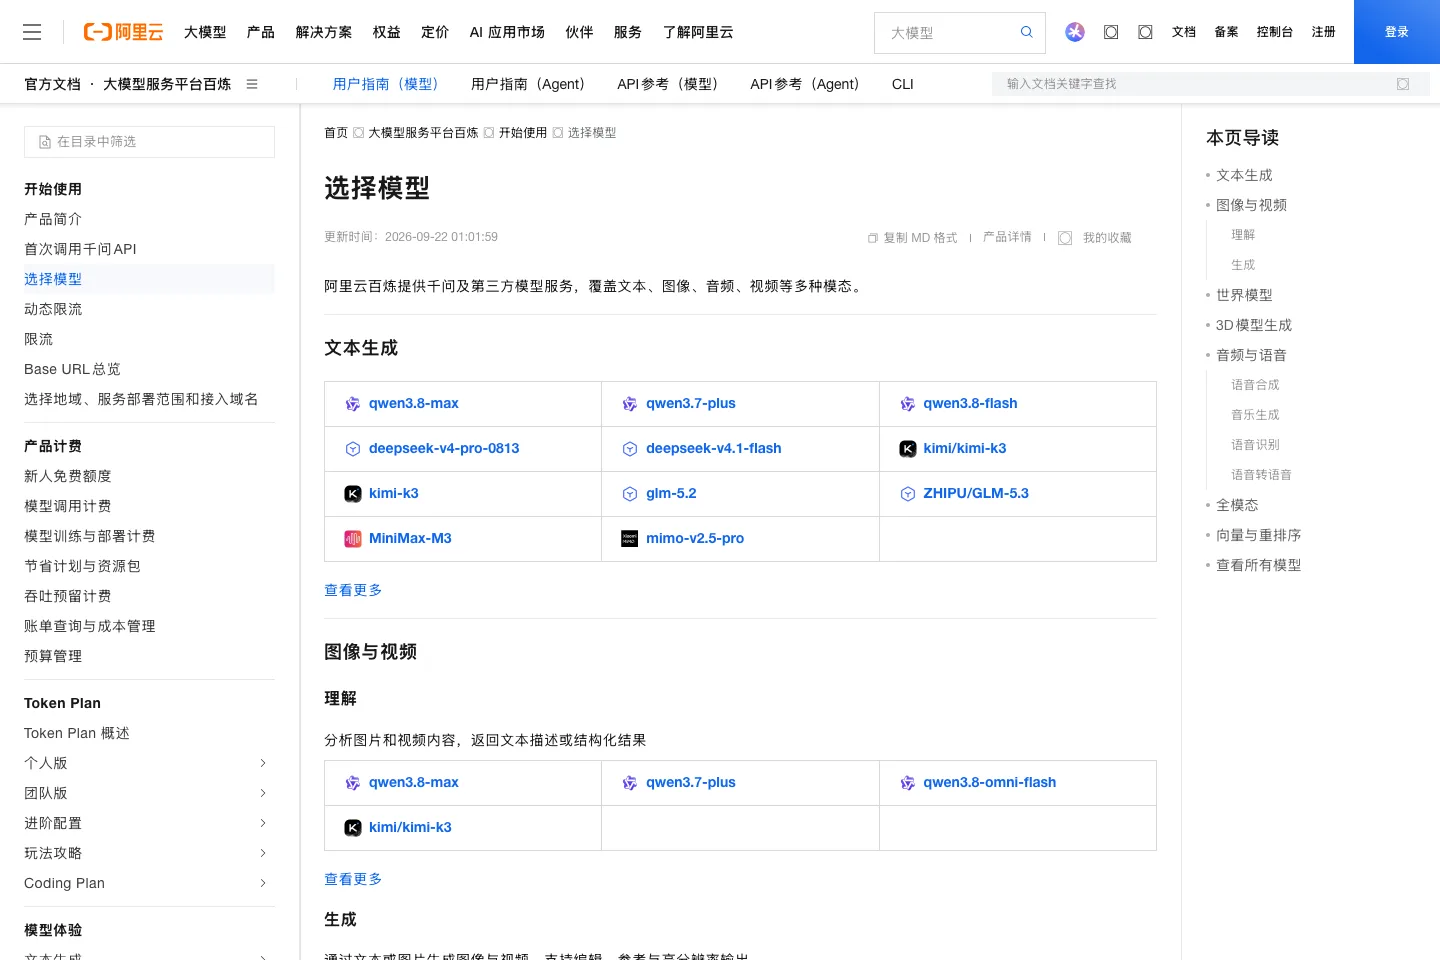
從現行產品線看 Qwen4 的命名,脈絡其實不難讀。百煉文件上的分工是 qwen3.8-max 扛旗艦能力、qwen3.7-plus 做平衡、qwen3.8-flash 拼速度與單價,本地的開放權重線則由 Qwen3.8-27B 領軍。Qwen4-Max、Qwen4-Plus、Qwen4-Flash、Qwen4-27B 四個名字正好對上這四個位置,等於官方預告了下一代會維持「能力、平衡、速度、可自架」四軌並行,而不是只堆一個最強旗艦。對企業選型來說,這比單一模型的排行榜名次更實際,因為真實工作負載本來就會依任務難度分流到不同等級的模型。
劉大一恆在現場說明,Qwen4 基於新一代架構,而且已經開始訓練。這套架構的特殊之處在於它早就公開:阿里已經把它隨 Qwen3.8-Flash 提前開源,GitHub 上的 Qwen3.8-Flash-Next 倉庫八月就建立了。架構的核心變化是把稀疏注意力與線性注意力結合,加上門控機制穩定訓練,並用 N-gram Embedding 在低計算成本下擴充模型容量。
至頂網的現場報導記下了這套架構的幾組數字:每個 token 僅激活約 6B 參數、訓練成本約為 Qwen3.7-Plus 的九分之一、百萬 token 輸入價格降為原本的四分之一、長上下文預填充吞吐提升 8.6 倍,Artificial Analysis 智慧指數比 Qwen3.7-Plus 高 14 分。這些是大會現場披露的說法,尚未有可獨立重現的文件,但方向很清楚:Qwen4 的賣點會建立在「更便宜地跑長任務」上,這正是智慧代理(AI Agent)場景最在乎的帳。一項長流程任務可能包含規劃、檢索、寫程式、測試、修改,反覆消耗 token,推理價格與吞吐直接決定這種任務在商業上站不站得住。智慧代理也是各家開源模型正在搶的位置,像是九月中的 Atria Dawn Preview 就以 Agent 基準成績當主打,成本架構因此成了下一輪競爭的分水嶺。
曝光當天流傳最廣的說法是「Qwen4 將是 5 至 10 兆(5-10T)參數的模型」。對照兩家現場媒體的報導,這句話其實被轉了好一手:劉大一恆的原意是基於新一代架構的 Qwen4 已在訓練,後續的 Qwen4.5 與 Qwen5 才會把總參數量推向 5 至 10 兆。5-10T 是對兩個世代之後的路線圖描述,不是 Qwen4 的已確認規格。現場也回顧了這條規模曲線:Qwen2.5 時代的旗艦是 72B,Qwen3.8-Max 的總參數量來到 2.4 兆,兩年放大約 33 倍,5 至 10 兆等於是把同一條曲線再往外延伸兩個世代。
「總參數量」這四個字也需要小心讀。Qwen3.8 家族在 Hugging Face 上有一個能直接對照的實體:Qwen3.8-2.4T-A95B,8 月 8 日上架,模型名稱直讀就是總參數 2.4 兆、每個 token 激活約 95B。這與現場「Qwen3.8-Max 總參數量已達 2.4 兆」的說法互相印證,也順便示範了混合專家架構(MoE)的關鍵特性:模型把知識拆進多個「專家」子網路,每個 token 只會喚醒其中一部分,總參數 2.4 兆的模型,推理時真正跑動的可能只有幾十 B。所以就算未來官方公布 Qwen4.5 是 10 兆參數,也不代表每次呼叫都在燒 10 兆參數的運算力,激活量與單價要等模型卡才能確定。參數量往上走也不自動等於回答更準,資料品質與訓練方法同樣佔比重。
演講裡最戲劇性的一段,是 Qwen3.8-Max 的自進化實驗。這套方法在阿里的說法裡叫遞迴自我改進(RSI),白話講就是把「訓練模型」這件事本身也交給模型:模型自己找缺點、自己設實驗、自己改自己。按現場說法,模型自己搭建訓練流程、構造訓練資料、設計實驗並定位缺陷,在人類完全不介入的情況下持續迭代超過一個月,完成 33 輪有效迭代,Artificial Analysis 智慧指數從 40 分升到 45 分。同一套方法還被用在推理與晶片設計上:在從未見過的平頭哥新款 GPU 上自主調校 Qwen3.8-Flash 的推理框架,把單實例吞吐量提升 96%;只憑一份真實的匯流排模組規範,自主執行晶片設計流程超過 60 小時、呼叫電子設計自動化工具上萬次,最後把晶片面積縮小 42%。
這些數字全部來自大會現場的口頭與投影片披露,目前沒有論文或技術報告可供獨立驗證,合理的讀法是把它們當成研發方向的展示,而不是 Qwen4 的正式成績單。不過「模型自己改進自己」如果走通,影響的會是迭代速度,這比任何單一版本的分數都更值得長期觀察。
Qwen4 之外,這場演講也集中交代了通義家族的近期動態。統一理解框架的 Qwen3.8-Omni 面向音視訊推理與代理任務,現場稱整體成本較上一代降低九成以上,示範應用包括從長篇電影素材自動剪出成片、用一句話替音樂生成 MV。圖像生成的 Qwen-Image-3.1 針對電商與設計場景優化,語音家族 Qwen-Audio-3.1 覆蓋轉寫、合成與即時互動,同聲傳譯的 Qwen3.8-LiveTranslate 則已在九月中先行亮相。
IT之家的現場報導另記下兩個時間點:下一代影片生成模型排在 11 月發布,方向是更長、更可控、更具敘事理解;手機端的 AI 全端方案 Qwen Intelligence 也在這場發布,把千問模型做成跨應用代理平台供手機廠商串接。主論壇其後的 Agentic Cloud 場次聚焦把智慧代理搬進生產環境,淘天首席科學家鄭波則預估三年內會出現原生全模態的統一模型。這些支線說明 Qwen4 只是整張藍圖的一角,阿里押的是從模型、基礎設施到終端的完整堆疊。
阿里在會中給出的開源成績單是:已開源 460 餘個 Qwen 官方模型、全球下載量突破 30 億次、衍生模型超過 30 萬個,Qwen3.8-27B 是 Hugging Face 平台上獲讚最多的開源大型語言模型。這幾個數字裡,468 個模型的帳號存量與 16,042 讚的 27B 排名我都在 Hugging Face 上實際核對過,與官方說法相符,Qwen3.8-27B 的下載量在同一次查詢中也已超過 707 萬次(「史上最多讚」的說法則以平台完整歷史為準,此處照引現場表述)。
這段累積直接關係到 Qwen4-27B 的想像空間。前一代從 Qwen3.8-LiveTranslate 的雲端 API 到 Qwen-Image-2.1 的開放權重,都延續雙軌並行的策略,27B 這個尺寸又是本地部署最受歡迎的級距,這一級的開放權重競爭也從沒停過,九月下旬 小米 MiMo-V2.6 才剛開放權重。以此推論,Qwen4-27B 開放權重的機率不低,但權重格式、授權條款與硬體需求是三個獨立變數,歷史前例不能代替正式授權文件,想本地部署的團隊可以提前評估硬體,採購決策建議等條款出來再定。
一般使用者與開發團隊此刻都不需要動作:Qwen4 沒有入口、沒有價格,現行 Qwen3.8 服務照常用。真正有用的是把注意力放在可觀察的官方訊號上,出現任何一項再回來更新判斷。四個訊號各有要看的重點:Hugging Face 出現 Qwen4 條目時,先看授權欄位與權重格式,那決定能不能本地部署;百煉文件新增 Qwen4 模型時,先比對輸入輸出單價與 qwen3.8 對應型號的價差,驗證新架構的成本承諾有沒有兌現;qwen.ai 掛出模型卡時,先看上下文長度與工具呼叫規格,這兩項直接影響代理任務的可用性;雲棲大會官方回放上線時(截至 9 月 23 日凌晨撰稿,演講頁仍顯示「回放生成中」),可以用完整演講核對本篇引用的現場數字。
已經在跑智慧代理或大量 API 呼叫的團隊,可以先替自己的工作負載建一套固定的測試題,記下目前模型的成功率、延遲、token 用量與單次任務成本。Qwen4 上線後用同一套流程重測一次,得出的結論會比任何官方排行榜都貼近自己的實際場景,也能直接回答「新架構的成本優勢有沒有兌現」這個問題。一張 Coming Soon 的投影片值得記錄,但值得為它改變技術路線的證據,還在後面。