TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

螞蟻集團螞蟻百靈平台發布 Ling-3.2-flash:560B 總參數、25B 啟用、百萬 token 上下文由輸入輸出共用,原生支援文字圖片影片輸入並相容 OpenAI 與 Anthropic 協定,上線後兩週限時免費。官方評測圖上文件解析與網頁視覺同場第一,難題推理與 3D 場景仍落後;接入前還得過支付寶綁定與每秒兩次請求兩道門。
用 AI 摘要這篇文章:
螞蟻集團的模型平台螞蟻百靈(Ant Ling)在 11 月 5 日上線新模型 Ling-3.2-flash,上線後兩週限時免費,換算下來大約到 11 月 19 日。規格面是 560B 總參數、每次啟用約 25B、上下文上限 100 萬 token,原生接收文字、圖片與影片輸入,並相容 OpenAI 與 Anthropic 兩種呼叫協定。不過官方發布評測圖上真正值得記住的是兩件事:文件解析與網頁視覺這兩類任務,它拿到六個模型同場的第一;難題推理、3D 場景理解與 Android 自動化,它與同場最強的 Opus 5 和 GPT-5.6-Sol 之間仍有明顯差距。
把這兩件事放在一起看,這次更新的輪廓就清楚了。想找便宜好用的文件理解或網頁視覺 API 的人,兩週免費期是個低成本的驗證機會;期待「全面超越一線模型」的人,同一張圖會先給你反證。
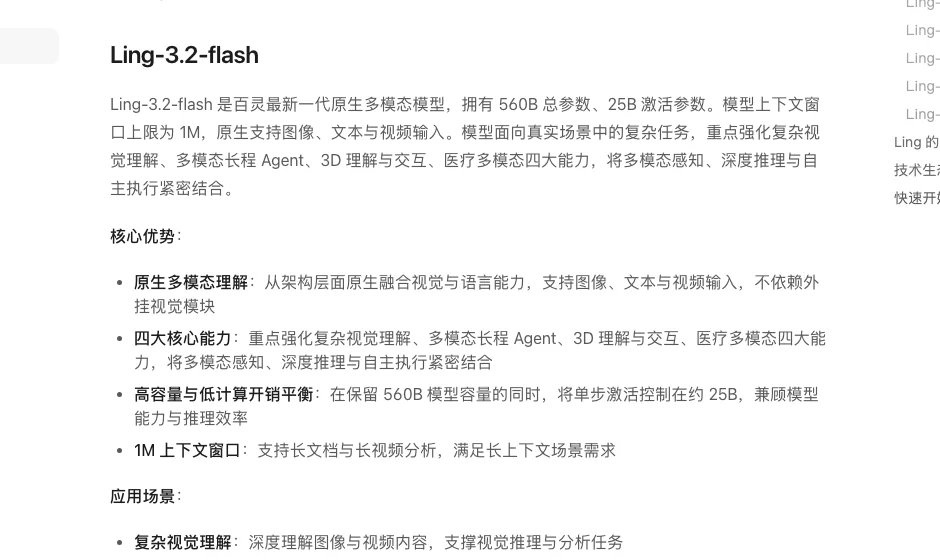
Ling-3.2-flash 在官方模型文件裡的定位是「最新一代原生多模態模型」。原生多模態指的是視覺能力從架構層就融進模型,圖片、文字、影片直接進到同一套推理流程,官方文件特別註明「不依賴外掛視覺模組」。它可以看影片回答內容問題,可以讀帶版面的文件,也可以在多步驟任務裡持續使用畫面資訊做判斷。這是輸入端的能力,官方沒有宣稱它能生成影片或圖片。
這個「第一次」需要說得精確一點。螞蟻百靈其實已有一個原生多模態模型 Ling-3.0-flash-VL,總參數 124B、啟用 5.5B、上下文 256K,而且權重已經開源。3.2 的增量是把原生多模態推上 560B 的旗艦檔位,重點強化官方列出的四個方向:複雜視覺理解、多模態長程 Agent、3D 理解與互動、醫療多模態。
從平台更新日誌看,這條產品線一年出頭走得相當快:2025 年 10 月以 Ling-1T 起家,2026 年 4 月的 2.6-1T 旗艦在隔月補上可調推理強度,7 月的 3.0-flash 轉向高性價比路線,9 月加上 3.0-flash-VL 的原生多模態,10 月補語音與圖像生成,11 月再把原生多模態推上旗艦檔位。這個背景解釋了 3.2 的定位:它站在一條每個月都在補品類的產品線上,而不是一次孤立的大版本跳躍。
家族裡另有 1.3B 啟用的 Ling-3.0-tiny,走本地端與低資源路線,與這次的旗艦多模態剛好是兩個極端。選型指南也提醒,對延遲敏感的線上服務可以考慮 3.0-flash,它的低啟用參數讓首個 token 的等待時間與輸出速度都更有優勢。
它和既有的 Ling-3.1-flash 是同檔位的分工,不是取代關係。兩者都是約 560B 總參數、25B 啟用、100 萬 token 上下文;官方選型指南把「個人助理、辦公任務、長流程開發」導向 3.1,把「複雜視覺理解、多模態長程 Agent、3D 理解與互動、醫療多模態」這類複雜多模態任務導向 3.2。換句話說,純文字的長任務官方自己都不建議換到 3.2,多出來的視覺能力才是這次付的錢(免費期內是時間)。
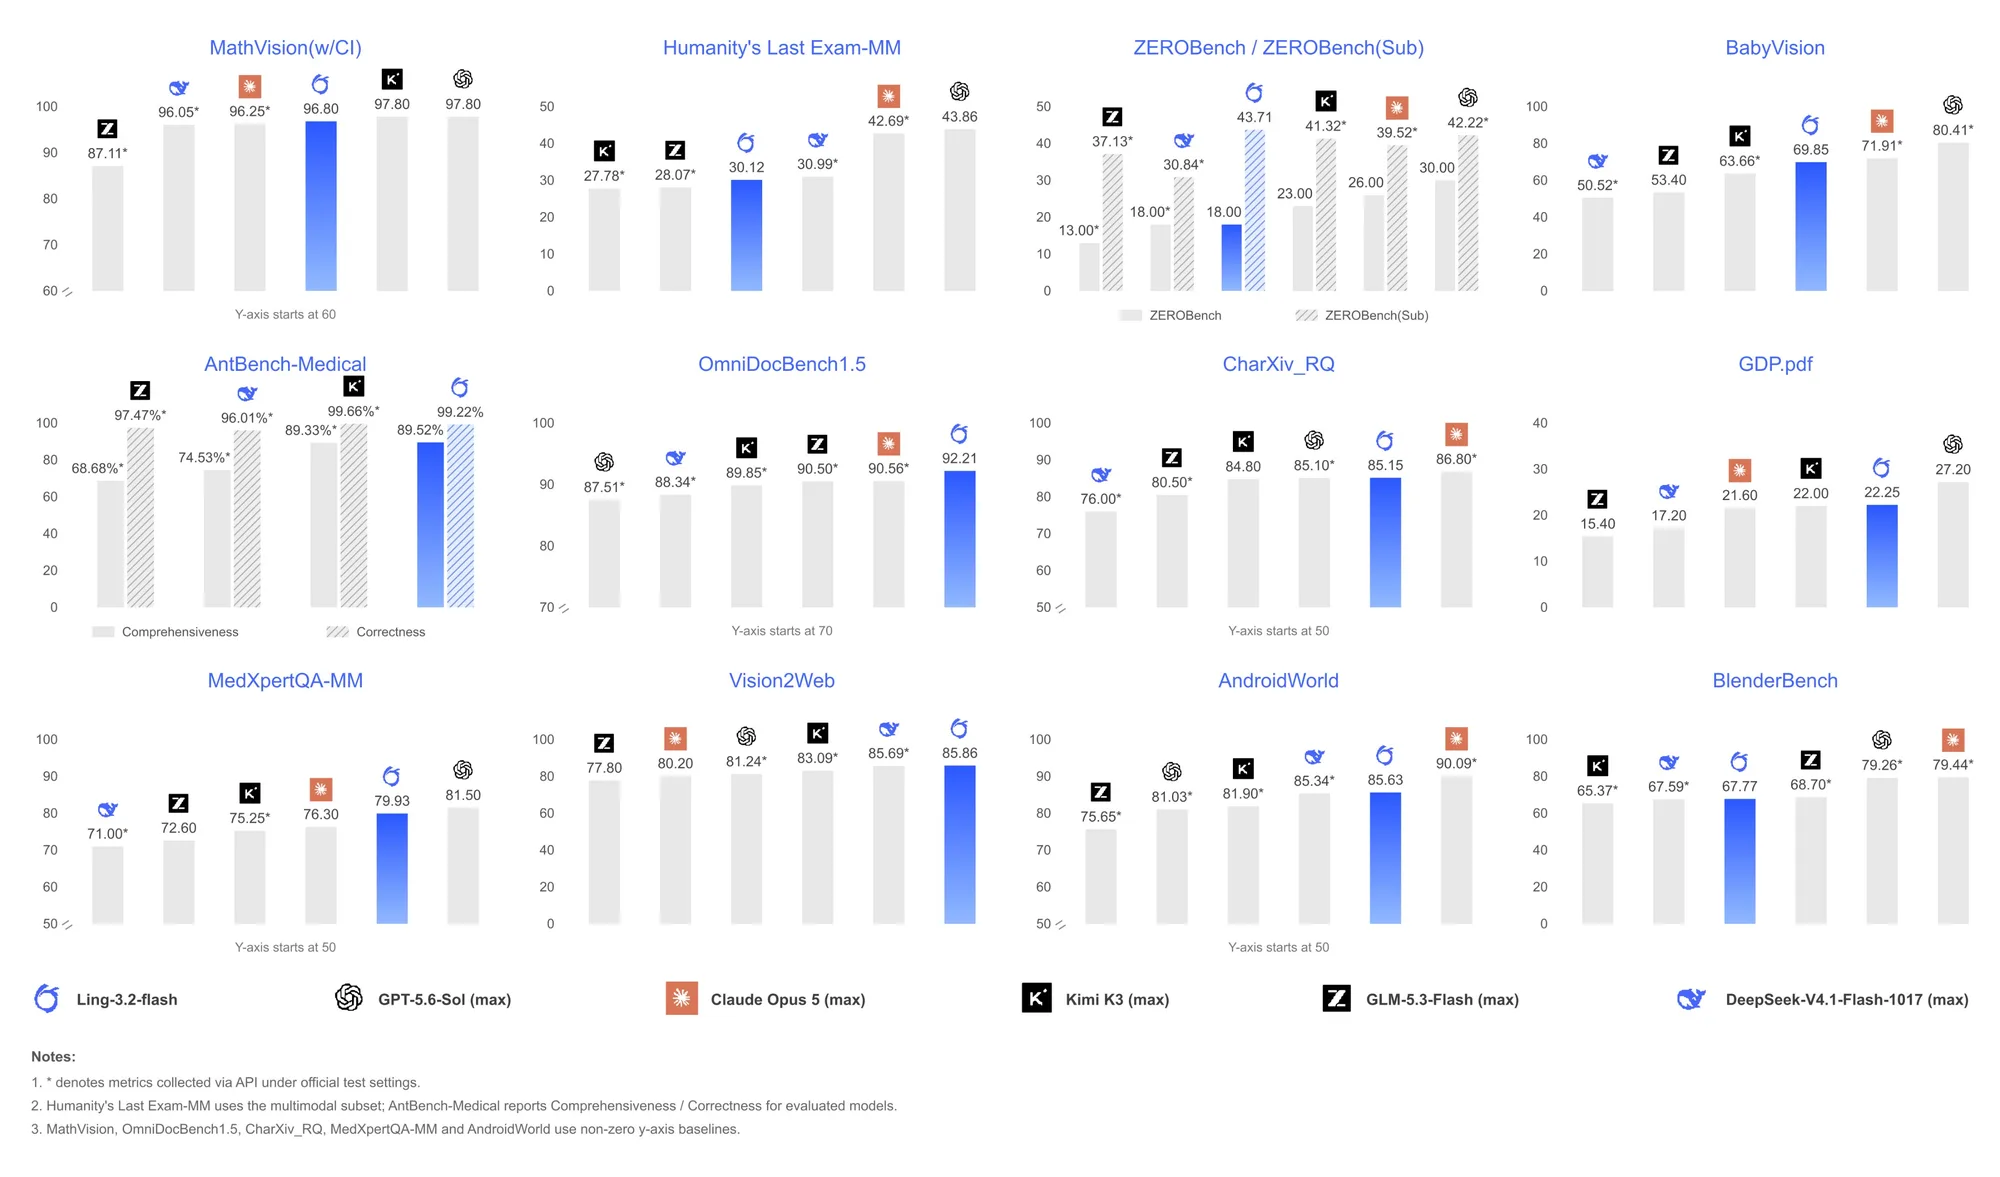
官方 X 帳號在 11 月 5 日發布的評測圖,把 Ling-3.2-flash 和 GPT-5.6-Sol、Claude Opus 5、Kimi K3、GLM-5.3-Flash、DeepSeek-V4.1-Flash 五個對手放在 12 個評測面板裡比較。先看它領先的部分,因為這部分和實際工作最對得上。
文件解析評測 OmniDocBench 1.5,Ling-3.2-flash 拿 92.21,高於 Opus 5 的 90.56、GLM-5.3-Flash 的 90.50 與 Kimi K3 的 89.85,是全場最高。這個評測考的是從 PDF、表格、混合版面裡把內容完整抽出來,分數差在這種場景會直接換成欄位正確率,對做文件抽取的人參考價值最直接。網頁視覺任務 Vision2Web 拿 85.86,領先 DeepSeek-V4.1-Flash 的 85.69 與 Opus 5 的 80.20,同樣是全場第一;這類任務的典型形態是看著畫面或設計稿還原可用的網頁。ZEROBench 的子項目(Sub)43.71 也是全場最高。醫療評測 AntBench-Medical 的完整性(Comprehensiveness)口徑它拿 89.52%,略高於 Kimi K3 的 89.33%。
| 評測項目 | Ling-3.2-flash | Claude Opus 5 (max) | GPT-5.6-Sol (max) | 全場最高 |
|---|---|---|---|---|
| OmniDocBench 1.5(文件解析) | 92.21 | 90.56 | 87.51 | Ling-3.2-flash |
| Vision2Web(網頁視覺) | 85.86 | 80.20 | 81.24 | Ling-3.2-flash |
| ZEROBench Sub | 43.71 | 39.52 | 42.22 | Ling-3.2-flash |
| HLE-MM(難題推理) | 30.12 | 42.69 | 43.86 | GPT-5.6-Sol |
| BabyVision | 69.85 | 71.91 | 80.41 | GPT-5.6-Sol |
| BlenderBench(3D 場景) | 67.77 | 79.44 | 79.26 | Claude Opus 5 |
| AndroidWorld(Android 自動化) | 85.63 | 90.09 | 81.03 | Claude Opus 5 |
表內數字全部取自官方發布圖。圖註載明對照模型的成績是透過 API 在官方測試設定下測得;對照組名稱都掛著(max)後綴,一般用來指最高一檔的努力設定,比較條件看起來是一致的;但整張圖仍是廠商自測,不是第三方獨立榜單,題目挑選與設定都在官方手裡。分數適合當方向參考,適合在用自己的資料驗證後再當結論。
官方貼文的用詞是「在發布評測中超越 Opus 5(max)」。把 12 個可比較的欄位逐項清點,對上 Opus 5 是 6 勝 6 敗;勝的是 MathVision、ZEROBench 子項、OmniDocBench 1.5、GDP.pdf、MedXpertQA-MM、Vision2Web,敗的是 HLE-MM、ZEROBench 全集、BabyVision、CharXiv_RQ、AndroidWorld、BlenderBench。對上同場的 GPT-5.6-Sol,是 5 勝 7 敗。領先集中在文件與網頁視覺,落後集中在另外三塊。
難題推理是差距最大的一塊。HLE-MM(Humanity’s Last Exam 多模態子集)Ling 拿 30.12,Opus 5 是 42.69,GPT-5.6-Sol 是 43.86;ZEROBench 全集它拿 18.00,落後 GPT 的 30.00 與 Opus 的 26.00。3D 場景理解的 BlenderBench 它拿 67.77,Opus 5 與 GPT 都在 79 以上。Android 手機自動化 AndroidWorld 它拿 85.63,Opus 5 是 90.09。對照 Vision2Web 的領先,可以看出它的強項在「讀懂網頁畫面」,到了「操作手機系統」就換人領先,這兩件事對想把模型接進自動化流程的人是不同的採購訊號。
中間帶的幾個項目也值得看一眼,因為它們顯示差距是漸層而非斷崖。數學視覺題 MathVision 它拿 96.80,高於 Opus 5 的 96.25,但輸給 Kimi K3 與 GPT-5.6-Sol 的 97.80;圖表推理 CharXiv_RQ 拿 85.15,以 0.05 之差高於 GPT-5.6-Sol、以 1.65 之差低於 Opus 5;醫學知識題 MedXpertQA-MM 拿 79.93,輸 GPT-5.6-Sol 的 81.50、贏 Opus 5 的 76.30。這幾個項目上六個模型都擠在十幾分的區間內,誰第一其實取決於題目分佈,真正拉開差距的是前面那些難題推理與 3D 項目。
讀這張圖還有兩個技術性提醒。圖上五個面板的縱軸不是從零開始(MathVision 從 60 起、OmniDocBench 從 70 起、其餘三個從 50 起),視覺上的柱高差距會放大實際分數差距;醫療的 AntBench-Medical 分完整性和正確性兩個口徑,Ling 在完整性最高、正確性 99.22% 略低於 Kimi 的 99.66%,兩個數字不該合併成一個「醫療能力」。官方文件對這個方向的定位是醫學影像理解與報告解讀、輔助專業分析;資料集分數和臨床可用性是兩件事,涉及實際醫療判斷的流程不該因為榜單分數而改變。
560B 總參數配 25B 啟用,是 MoE 架構的典型配置:每一個 token 只路由到一部分專家網路,模型容量按總參數走,回應速度與算力消耗按啟用規模走。對使用者的意義相當實際,這個模型的計費與延遲不會是「560B 等級」的,但知識容量是。
100 萬 token 聽起來很大,官方 FAQ寫得直接:這個上限由輸入和輸出共用。系統指令、對話歷史、工具回傳的結果、模型自己的回答,全部從同一個額度裡扣。丟一份接近上限的長文件進去,留給模型回答的空間就所剩無幾;多輪的視覺 Agent 任務還會因為每次工具回傳逐步吃掉容量。規劃長文件或長影片工作時,先算輸出預留再算輸入,比反著來安全。
token 和影片長度也沒有固定換算。影片會以取樣方式進入模型,畫面密度、解析度都會影響消耗,官方文件沒有提供「幾分鐘影片等於多少 token」的對照表,實際用量要自己測。
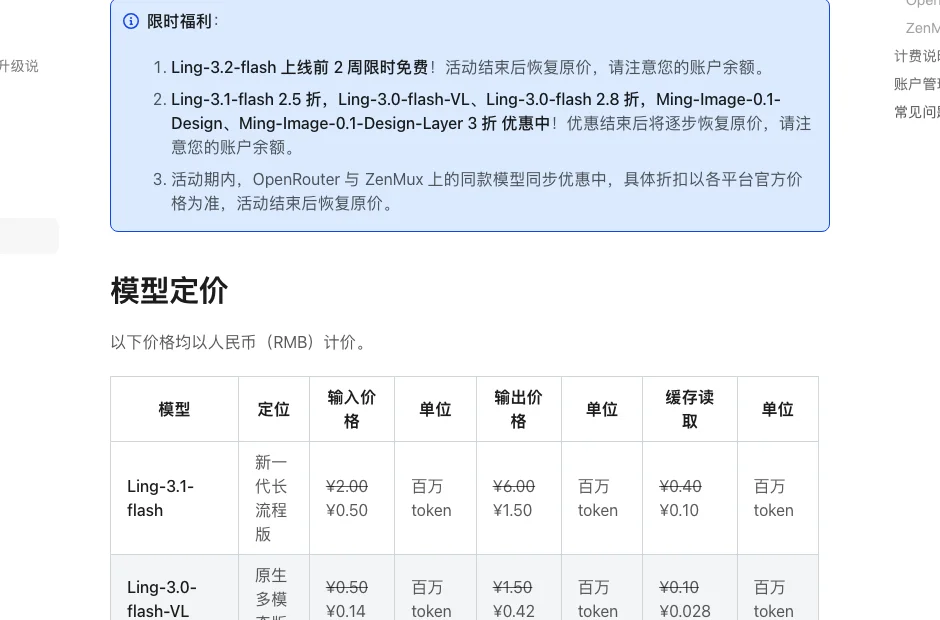
定價頁的寫法是「Ling-3.2-flash 上線前 2 週限時免費,活動結束後恢復原價」。定價表裡有兩個細節會影響免費期的用法。定價表裡目前沒有 Ling-3.2-flash 的常態價格,表中列出的是 Ling-3.1-flash(現折 2.5 折,輸入每百萬 token 人民幣 0.50 元、輸出 1.50 元)與 Ling-3.0 系列的數字;免費期結束後 3.2 的正式費率是未知數,拿 3.1 的價格去推算長期成本沒有依據。免費期之外,平台本來就有每日 50 萬 token 的常態免費額度(含輸入輸出,每天凌晨 2 點前發放,當日未用完不保留),免費期結束後小規模測試還有空間。計費按量結算、每天凌晨生成前一日帳單,餘額不足會直接暫停服務。照官方計費說明「1 個漢字約等於 2 個 token」換算,50 萬 token 大約是 25 萬個字的往來空間,跑問答和小樣本驗證夠用,跑整批文件就會見底。另照官方定價頁,3.1-flash 在 OpenRouter 上的計價是輸入每百萬 token 0.30 美元(折扣價 0.075 美元)、輸出 0.90 美元(折扣價 0.225 美元),3.2 未來若跟進第三方平台,美元價會是海外用戶另一個比價基準。
程式接入本身不複雜。API 端點是 api.ant-ling.com/v1,官方快速開始文件直接給 OpenAI SDK 的範例,換掉 base_url 和 model 名就能呼叫;Anthropic 協定也支援,站上還備了 Claude Code、OpenClaw、Kilo Code、Hermes Agent 四款工具的整合說明。要注意的是協定相容不等於每套軟體都放行:FAQ 點名 Trae 這類只接受特定雲端廠商官方渠道的 IDE,目前不支援自訂模型入口,想接的人得先確認自己的工具能不能改模型位址。真正的門檻在帳號與限制這一層。
支付寶是最先撞上的一道。開通服務要先在 API 控制台綁定支付寶帳號,儲值走支付寶小程式雲的雲錢包,定價頁明寫企業版支付寶帳戶暫不適用,企業合作被導向另一條聯絡管道。海外或企業用戶在測之前,得先確認自己過得了這關;台灣帳戶能不能走完開通流程,這裡沒有實測,請以實際註冊結果為準。
併發是接下來的上限。FAQ 載明 Ling Studio open API 的每秒請求數上限是 2,高併發需求要另洽官方或走螞蟻數科的大模型平台。做批次處理要自己排隊,做即時服務要預先評估這個上限。FAQ 把提升 QPS、企業級資源保障、開發票、包月套餐這些需求都導向螞蟻數科的大模型平台或客服,正規的生產接線要走那條企業路徑。
還有一道門同時擋住兩種人:沒有權重、也還沒上第三方平台。Ling 家族走開源路線,3.0 系列的權重也在 Hugging Face 與 ModelScope 上,但截至 11 月 10 日,Ling-3.2-flash 的權重尚未上架,OpenRouter 與 ZenMux 兩個聚合平台上的螞蟻百靈模型也還停在 3.1 以下。想自架或想用既有聚合平台帳號的人,此刻只有官方 API 和 Ling Studio 對話頁兩條路。
測試不一定要從程式開始。Ling Studio 對話頁就能直接跟 Ling-3.2-flash 對話,拿幾份自己的文件或截圖上傳,先看它讀版面的表現,是成本最低的起點。如果有文件抽取、報表解讀或網頁畫面理解的工作在手上,這兩週值得排一輪正式測試:固定同一批樣本,寫下預期答案,讓現用模型和 Ling-3.2-flash 各跑一輪再人工核對。文件類任務特別適合,因為這正好是它在評測圖上最強的帶;GUI 自動化類可以先小範圍試,它的 Vision2Web 領先但 AndroidWorld 落後,兩個場景別一起下結論。
測試期間順手留下紀錄:同一批樣本的通過率、失敗集中在哪類內容、每次呼叫的實際用量。等常態價格公布,這份紀錄就是判斷「值不值得付費」的直接依據,比免費期結束後再憑印象決定可靠。免費期結束前後有三件事要回來查:定價頁會不會補上 3.2 的常態費率、權重會不會像前代一樣開源上架、第三方平台會不會跟進。追蹤的入口就是官方更新日誌,從 9 月的多模態 3.0-flash-VL、10 月的語音與圖像模型到這次的 3.2,平台已經連續三個月每月有新品上架,這三件事的答案最快也會出現在同一個地方。在這三件事落地前,把它當成「免費試用中的文件視覺備選」,比當成「可以搬遷的主力模型」穩當。