TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

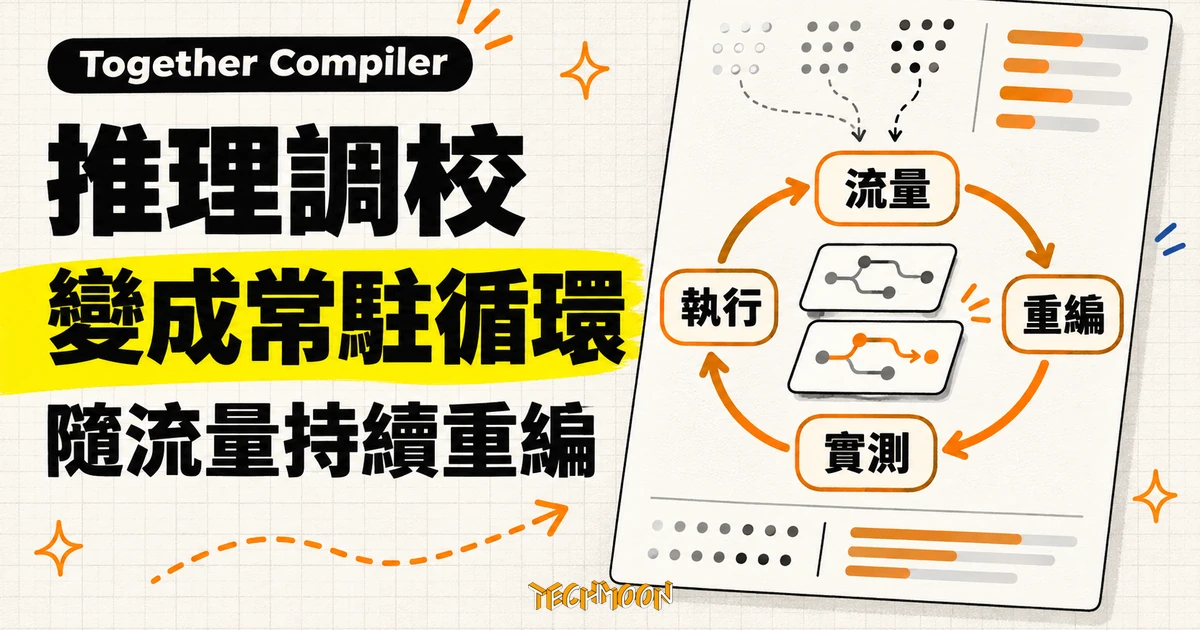
Together AI 在 11 月 4 日發布 Together Compiler(TKCC),讓 AI 代理對推理引擎持續提出修改、實測、換版。252 倍是實驗吞吐、2.6 倍才是服務吞吐,本文對照官方啟動時間表格與論文腳註拆解兩組數字的分母,並整理無伺服器端點已生效、專屬端點仍要申請測試的採用現況。
用 AI 摘要這篇文章:
Together AI 在 2026 年 11 月 4 日同時發布兩篇研究文章和一份 38 頁論文,主題是同一件事:把推理引擎的調校,從模型上線時做一次的靜態設定,換成一套持續運作的搜尋程序。這套系統叫 Together Compiler,簡稱 TKCC,輸入是流量特徵、模型和硬體,由多個 AI 代理不斷產生新的執行方案、實測、換掉效果變差的版本;論文作者群以 Reyna Abhyankar、Dylan Lim 和 Simran Arora 為首,AI 系統研究副總裁 Simran Arora 與官方帳號的宣傳貼文,則落在台北時間 11 月 5 日凌晨 1 時 27 分與 1 時 42 分。官方同時宣布,部分熱門的無伺服器端點已經用上它,正在服務每天以兆計的 token;想為自己的工作負載客製使用的客戶,目前要申請有限的測試資格。
發布當天最容易被記住的是兩個數字:252 倍和 2.6 倍。它們量的是兩件不同的事,換算不了彼此,這篇把它們各自的分母和條件拆開,再看誰現在真的受影響。
252 倍量的是試錯速度。TKCC 的輸入有三項:流量特徵、模型、硬體;輸出是一連串針對推理引擎的修改,每一步修改都附帶實測結果。官方的比較對象是既有的代理式效能調校系統:這類系統同樣讓 AI 代理提出引擎修改,再想辦法量測效果,瓶頸卡在後半段。TKCC 在同樣時間裡能完成的實驗數量是對方的 252 倍,這個數字描述研發管線的吞吐,不是任何一個使用者的回應變快了 252 倍。
2.6 倍量的是服務輸出。官方在 SemiAnalysis 的 AgentX 工作負載上(多回合、高併發的代理式請求型態,這點可以從官方為 Trainium2 準備的替代資料設計反推),從各家已公開發布的高組態引擎設定出發,讓 TKCC 在不到 24 小時內重新搜尋,推理吞吐最高提高 2.6 倍,測的模型是 Kimi K3、GLM 5.3、MiniMax M3.1-Flash 和 DeepSeek v4.1-Flash。吞吐指的是單位時間總共輸出多少 token;大量請求一起處理時,整體產出和單一使用者等多久是兩件事,官方圖表也分開呈現:六組模型與晶片的配對上,TKCC 每位使用者的生成速度都快過原有設定,多數模型則是在同樣的每人速度下多送出 token。
| 數字 | 量的東西 | 比較對象 | 條件 |
|---|---|---|---|
| 252 倍 | 實驗吞吐(單位時間能試多少候選方案) | 基準代理式調校系統 | 只描述研發速度,不直接等於服務加速 |
| 2.6 倍 | 推理吞吐(TPS) | 已公開發布的開源引擎設定 | AgentX 工作負載、不到 24 小時、特定四個模型 |
兩個數字都出自 Together 自己的量測,論文和文章都還沒有第三方團隊重現。引用時把分母講清楚,比自己記倍率重要。
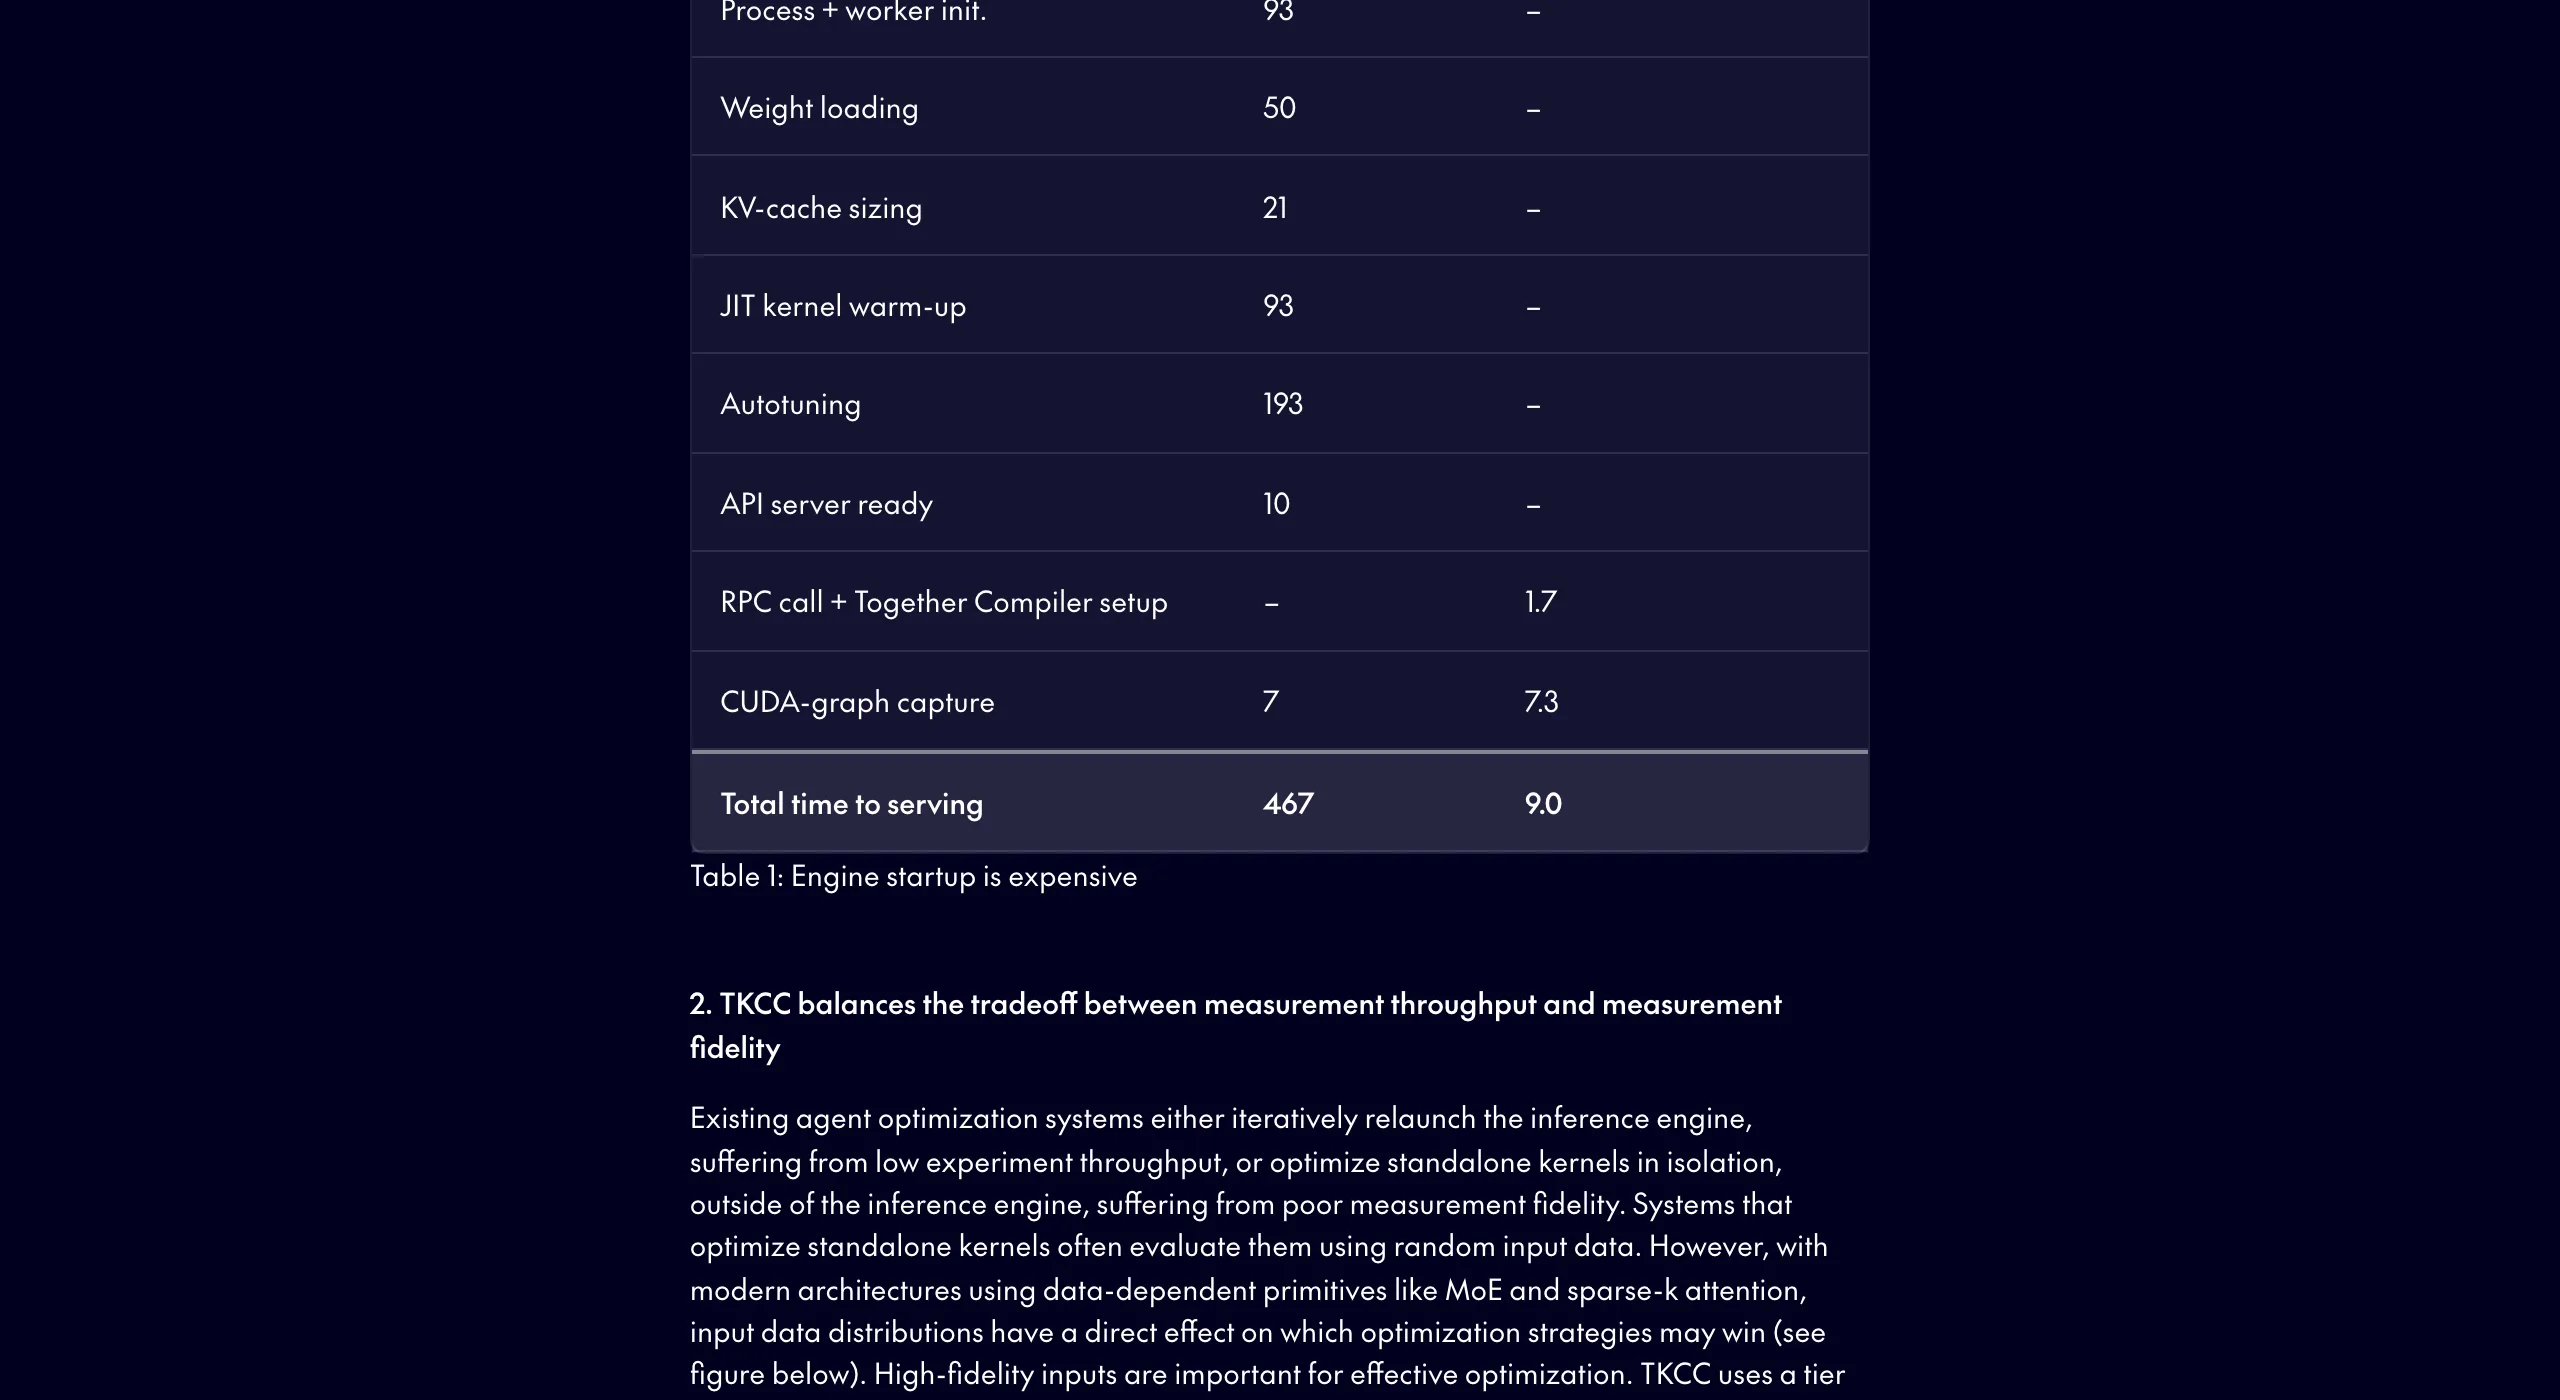
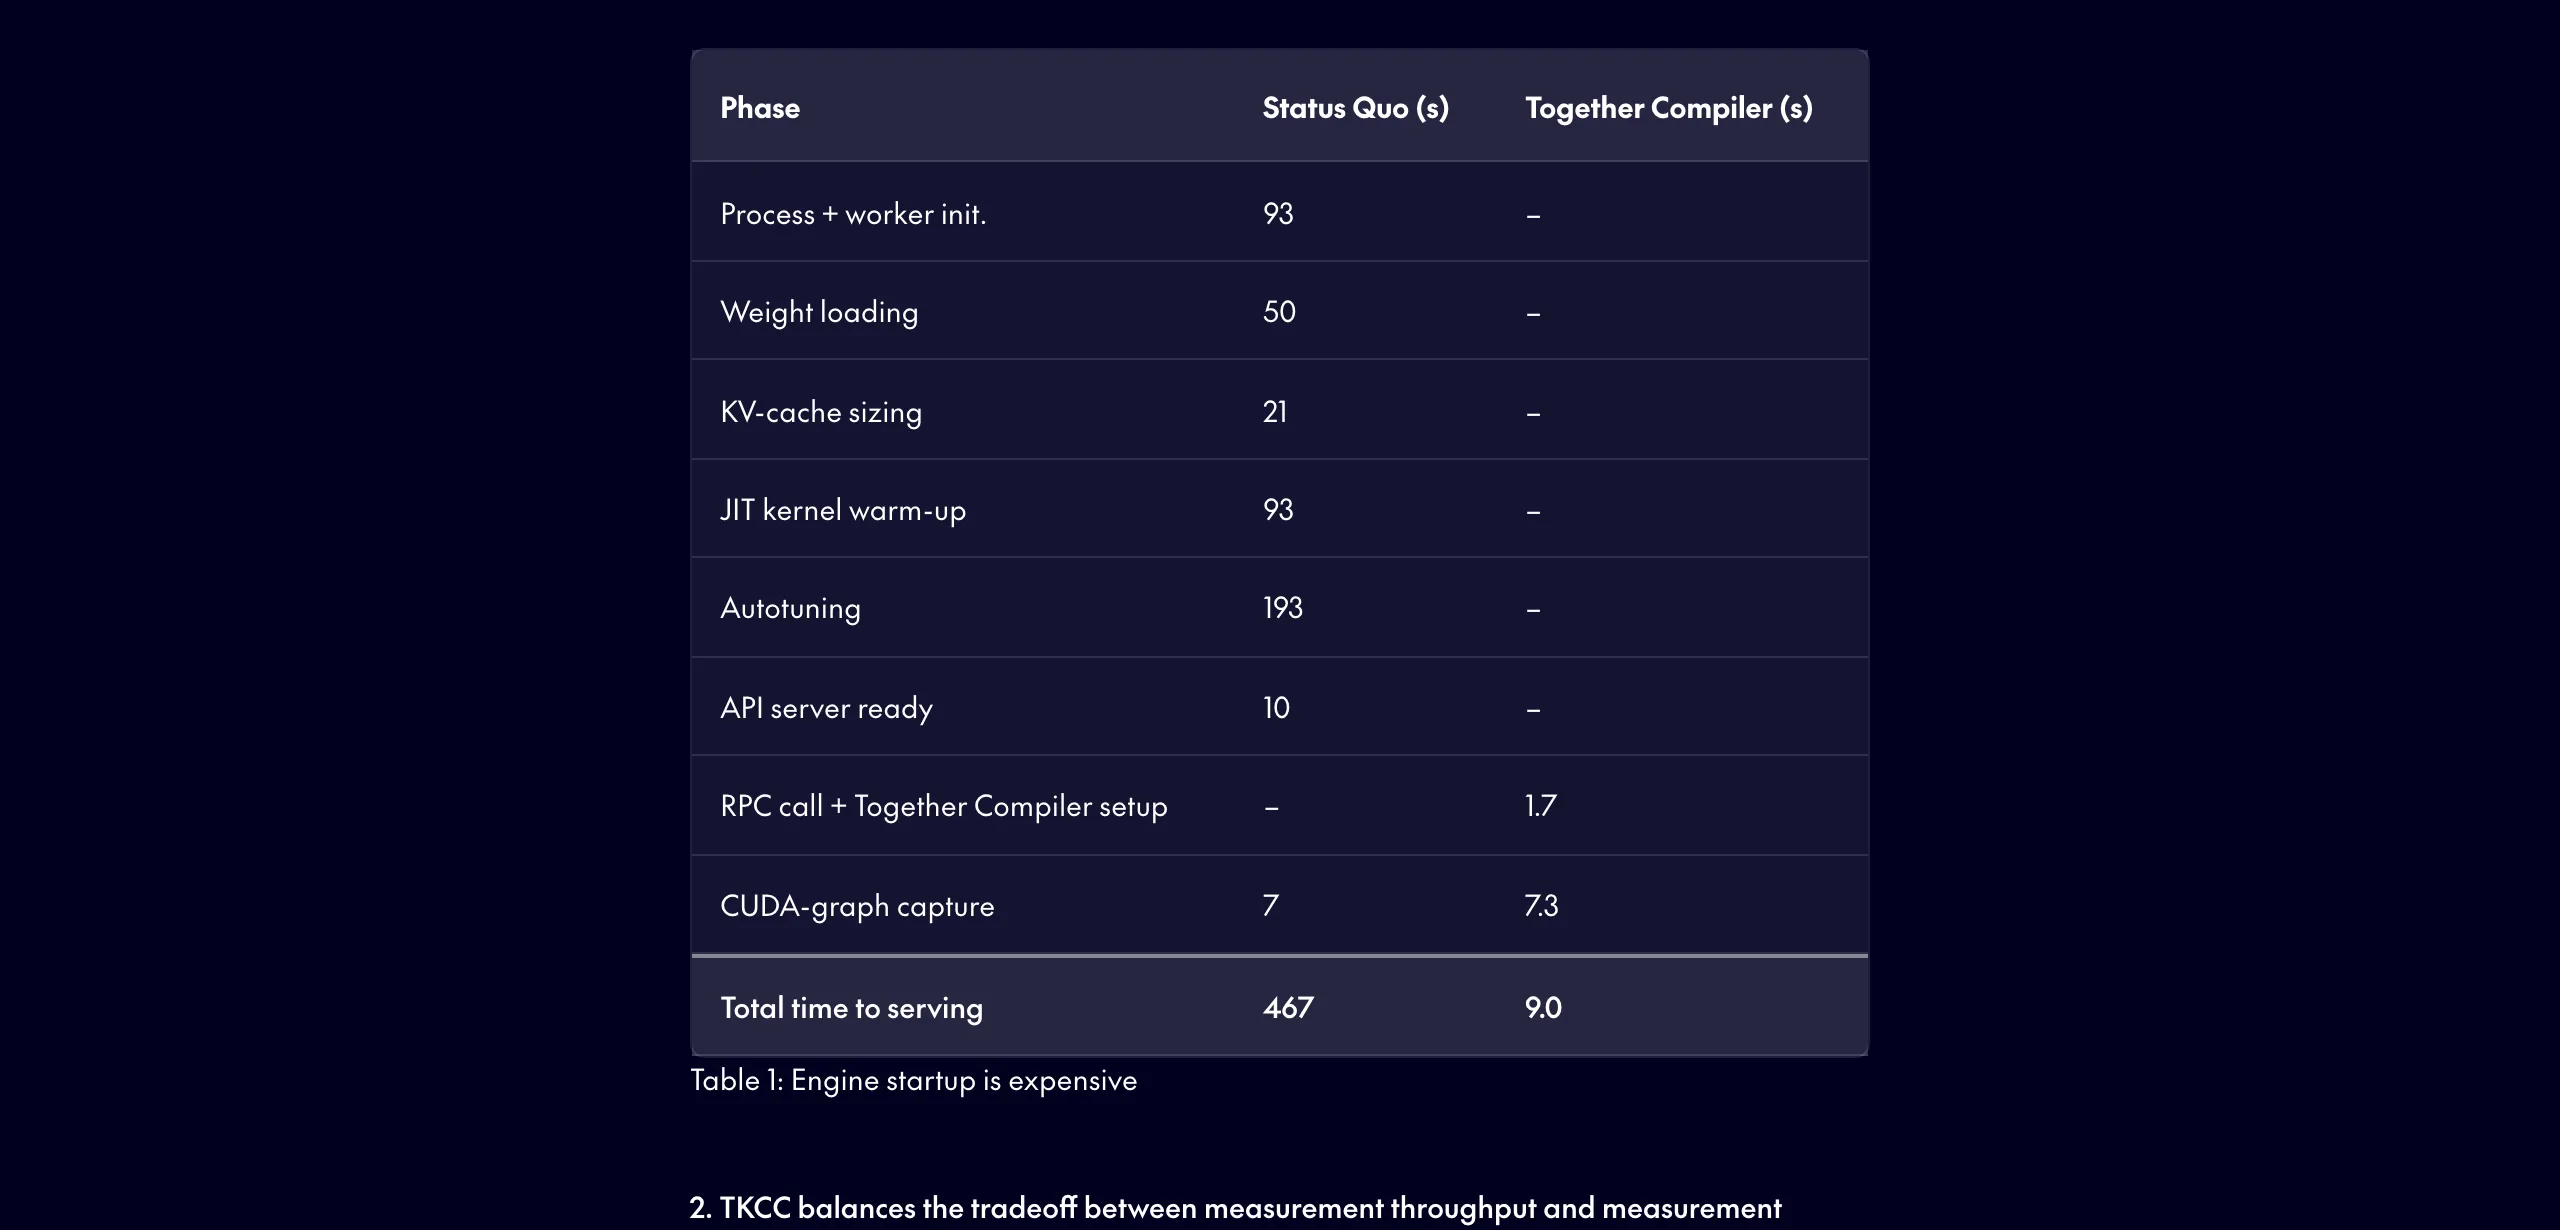
既有系統慢在哪裡,官方給了一張拆解表。傳統流程每試一個新方案,都要把推理引擎重開一次:程序初始化 93 秒、載入模型權重 50 秒、KV 快取空間配置 21 秒、核心即時編譯暖機 93 秒、自動調參 193 秒、API 伺服器就緒 10 秒、CUDA 圖形擷取 7 秒,加起來 467 秒。這八分鐘裡 GPU 在等引擎準備好,和量測本身無關。TKCC 的路徑只剩兩項:RPC 呼叫加系統設定 1.7 秒、CUDA 圖形擷取 7.3 秒,合計 9 秒。要留意的是口徑:官方正文說既有引擎的啟動時間動輒數十分鐘,表格裡的 467 秒已經是相對輕的案例,換句話說,這張表對傳統流程其實算客氣。
差別來自官方所稱的持久引擎(persistent engine):引擎開機一次之後一直活著,新的候選前向計算直接熱載入進去,不重啟。前向計算就是模型把輸入算成輸出的那條程式路徑,代理改的主要是它。為了讓引擎隨時有新方案可測,系統同時跑多個代理,透過訊息板協調分工,把提出改動和證明改動有效接在同一條管線上;GPU 花在重複初始化的時間被壓下來,同樣的時數能換到更多次實測。
第二個設計處理量測的可信度。在小例子上量到的加速,放回完整模型和真實流量可能消失,原因和架構有關:混合專家(MoE)與稀疏注意力這類會依輸入內容改變計算路徑的設計,同一批隨機輸入會把負載攤得比較平均,真實請求卻集中在某些專家上,用隨機資料測出來的結果因此常常偏樂觀。TKCC 分兩層量:快引擎只載入少數模型層,適合大量快速篩選;慢引擎載入多數層,用真實請求分布驗證候選能不能守住成果。另有一個成本模型,結合硬體規格、微型測試和實際前向計算的結果,替張量平行、專家平行這類平行策略預先篩選。逐項實測每種組合本來做不到:軟體實作還不成熟、組合又多,紙面規格與微型測試又抓不住專家負載不均、prompt 長度不齊這類資料特性。官方的量測顯示,照硬體規格紙面挑的配置不一定贏過實測挑的,而且併發一改,值得用的配置也跟著換。
低延遲情境官方給了兩個具體數字:MiniMax M3.1-Flash 每秒 1,111 個 token、DeepSeek v4.1-Flash 每秒 1,205 個 token,條件是 batch size 1,也就是同一時間只服務一個請求,貼近單一使用者打完字等回應的互動場景,和拚總量的離線批次是不同的目標函數。這兩項成績官方稱在 SemiAnalysis InferenceX 基準的低延遲項目創了新紀錄,而且平行配置是用自家成本模型選的,不是沿用 InferenceX 原本給的設定,官方說這樣選反而更快。
另一組 1.7 倍屬於完全不同的比較:Llama 1B、batch size 1,對象是手工調校的開源巨型核心(megakernel),在 H100 和 B200 兩種 GPU 上都成立。巨型核心是圍繞單一靜態工作負載精心設計的大核心程式,這個比較回答的是代理搜尋能不能贏過人類專家的極致手工,和前面服務級的 2.6 倍不能合併成一個普遍倍率。
論文腳註還交代了一個例外:Trainium2 晶片上的結果不是跑 AgentX,因為目前的實作還不支援高併發,HBM 記憶體容量也有限,官方改用合成的多回合資料(輸入序列 7 萬 token、新輸入 3,500 token 其中 95% 命中快取、輸出 700 token)。引用任何一個倍率,都該連著這類條件一起看。
受影響最直接的,是已經在用 Together 無伺服器端點的團隊。官方說法是 TKCC 已在部分最受歡迎的無伺服器端點上運轉,找到的改進疊在原本已經高度調校過的程式之上,一般呼叫 API 的使用者不需要做任何事,底層的調整已經發生。官方也拿 OpenRouter 當規模佐證,稱十月稍早在 OpenRouter 上服務的 token 量首度超過封閉模型實驗室。
想讓 TKCC 對著自己的專屬工作負載跑,現階段要向 Together 申請有限的測試資格。截至發布當日,專屬端點的一鍵自助調校還列在後續計畫,官方用的時間詞是 soon,沒有給日期。
用閉源模型 API 的團隊,這次發布與你無關;自己架 vLLM、SGLang 或 TRT-LLM 的團隊,TKCC 本體拿不到,但方法可以借。核心動作是同一件事:把調校從一次性工程,改成定期用真實流量分布重測現行設定,而且量測要保留原始請求的長度與快取比例,不是用隨機資料。實際操作可以縮成一個循環:固定一組真實請求當樣本,記下當時的引擎版本與配置,定期重測,數字變了就回頭查是流量變了還是版本變了。產品一旦改了代理的工具循環或推理長度,工作負載的形狀就跟著變,設定有理由重測;較快得到錯的輸出並不算加速,輸出品質先對齊,速度數字才有意義。
順帶一提官方的修辭。Polymorphic Inference 文章把這套系統稱為生產級的遞迴自我改進(RSI)系統;RSI 這個詞在產業語境裡通常指會改進自身的模型,這裡實際被改進的是推理引擎的程式與配置,宣稱的範圍讀者可以自行斟酌。
官方把這套方向命名為 Polymorphic Inference,字面意思是多形態推理:服務的形狀跟著模型、硬體和流量一直變,調校也必須跟著動。支撐這個判斷的數字都出自官方營運觀察:OpenRouter 上 80% 的流量流向發布不滿三個月的模型,官方只說開放模型推出的速度和頻率都比以往高,沒有給具體週期;本站最近介紹過的 Kimi K3.1 Pro 開放權重與騰訊混元 Hy4 正式版,都是這波汰換的縮影;OpenRouter 前十大開源模型的架構沒有兩個相同。
硬體也在快速換代:H100、B200、B300、NVL72 乃至其他廠牌的加速器,各有不同的可用策略。流量本身同樣會漂,某個國家工作時段的 prompt 平均長度是另一個國家的 1.4 倍(97,000 對 70,000 token);新模型發布後兩週,prompt 平均長度增加 80%,官方把這段變化歸因於使用者從聊天評估轉向代理式工作;此外客戶常在一天中的隨機時段送出爆量請求,prompt 長度突然翻倍、快取命中率跟著掉,也是官方列舉的常態。
這些觀察加起來指向一個樸素的結論:一份調校好的靜態設定,折舊速度取決於流量變化,而不是自己的工程品質。OpenRouter 的原始資料本文未另行核對,引用時以官方轉述為準。
TKCC 的量測迴圈能不能離開語言模型,官方也做了實驗:拿天氣建模、偏微分方程、時間序列和生物領域的開源程式碼來跑,比較基準是直接用 Claude Code 的目標指令做同樣的調校。四個模型裡有三個,TKCC 的幾何平均加速高於 Claude Code。這個比較的分母是程式加速倍率,和推理服務的每秒 token 又不相同。論文裡另有針對代理情境管理(agent context management)的消融實驗,以及把 TKCC 放進生產環境的經驗整理,想深挖技術細節的讀者可以直接讀論文。
還沒兌現的部分值得列清楚。一鍵自助調校沒有日期;隨流量調整的投機解碼(speculative decoding,用小模型先猜再驗證的加速技巧)和跨硬體部署的動態路由都還是研究議程,其中路由的基礎 ThunderAgent 已發表為 ICML 2026 論文。同一篇文章列出的議程還有模型塑造與工作負載感知的模型路由,不過這些屬於公司層級的產品線,與 TKCC 的關係是共用研究方向。API 費率也沒有隨這次效能數字調整,帳單上的變化要等官方自己的定價動作。
已經用 Together 無伺服器端點的團隊不用做任何事,變化已經在底層發生;關心品質的,可以把同一組真實請求留在手邊,之後比對延遲分布有沒有實際變化。要評估是否把工作負載搬上專屬端點的團隊,申請測試資格前先準備好自己的數字:模型與硬體需求、輸入輸出長度分布、快取命中比例和服務目標,並且用同一組真實請求建立比較基準,確認輸出品質相同之後,再看完成工作的總成本和等待時間。純用閉源模型 API 的使用者,這次發布沒有需要跟進的動作。
這篇的數字全部以 2026 年 11 月 4 日的官方文章和論文為準。一鍵自助調校正式上線、第三方團隊重現任何倍率、或 Together 調整定價,都是該回來重查這篇的時間點。