TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Vercel 發布 2026 年 11 月 AI Gateway Production Index:十月流量中決策模型吃下 26% 請求、只占 0.53% 花費,超過半數語言模型請求指向上架不滿兩個月的新版本,Anthropic 拿下新團隊首選約 2:1。
用 AI 摘要這篇文章:
生產環境的 AI 使用量正在拆成兩層:一層專門做判斷,呼叫量極大、帳單極小;另一層負責生成,吃掉絕大多數費用,版本卻換得飛快。Vercel 於 2026 年 11 月 9 日發布的《AI Gateway Production Index》十一月報告,用十月整月的實際閘道流量把這條斷層線量了出來。這是該系列自八月創刊以來的第四份月報,整理的是經過 AI Gateway 這個共同入口的路由流量,官方數字是每月超過 100 兆 token,涵蓋語言、決策、語音、圖像與影片五類模型;它看的是平台內的變化,直接向模型廠商採購、走其他閘道的團隊都不在樣本裡,拿來當全球市占率會讀錯方向。
先講三個最值得記住的數字。決策模型(decision models)九月才進駐閘道,十月已占全部請求的 26%,估計花費卻只有 0.53%;超過半數的語言模型請求,指向上架不滿 60 天的新版本,模型半衰期縮到約六週;語音模型的付費團隊採用率升到 10.7%,七月時還只有約 4%。三個數字背後是同一件事:團隊開始替不同性質的工作配不同的模型,流量與帳單從此分道揚鑣。報告由 Vercel 的 Amelia Charles 與 Harpreet Arora 執筆。
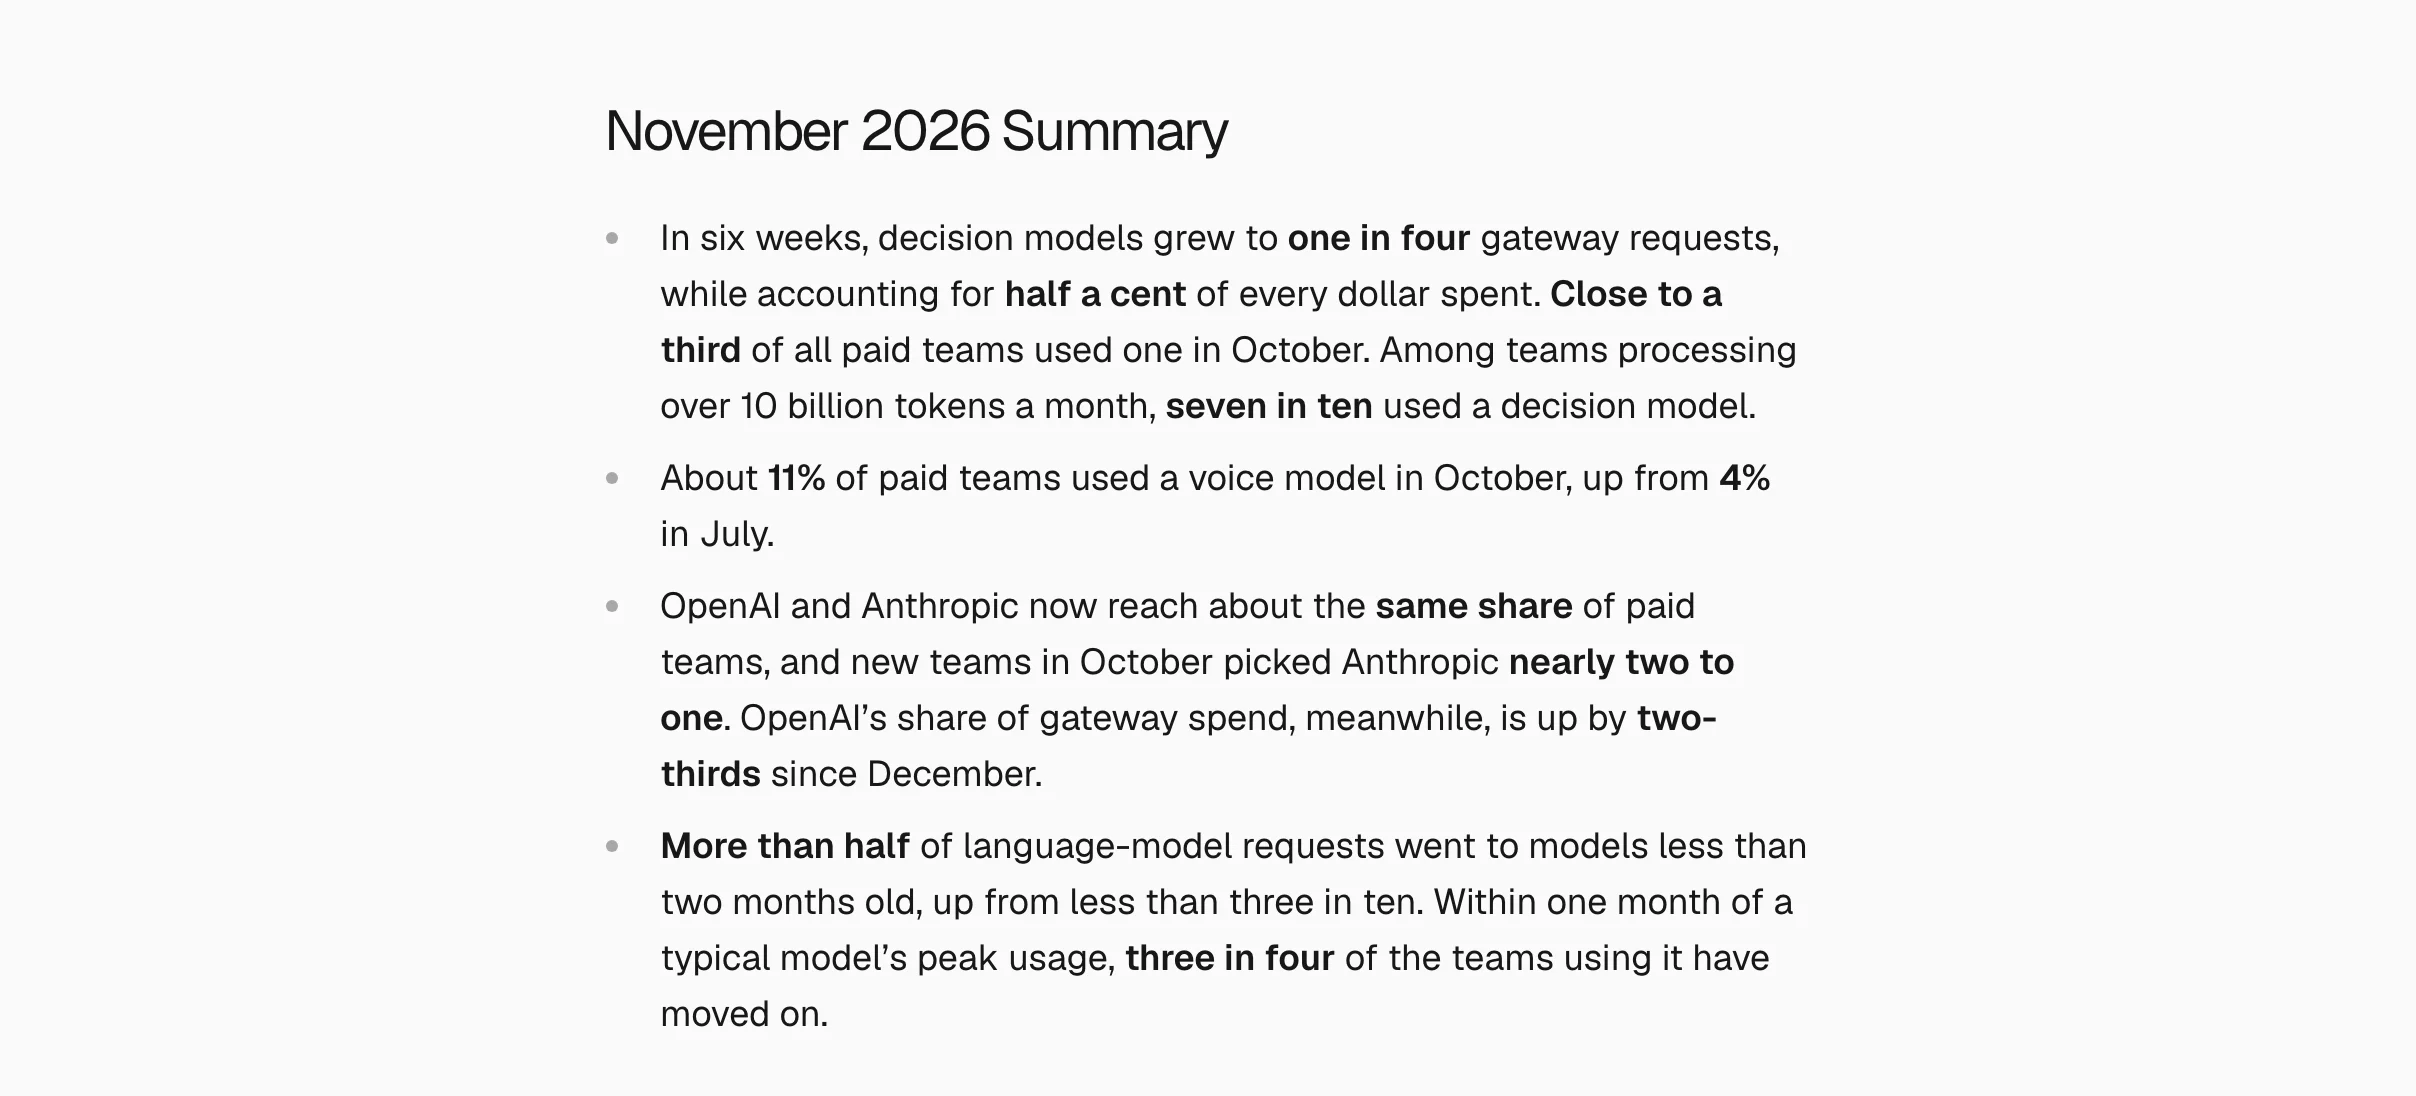
決策模型做的事情很單純:分類、評分,或從選項裡挑一個。它不逐字生成內容,回傳的常常只是分類、評分或挑選的結果,所以答案極短。報告把它定位為第三種選擇,夾在兩個舊選項中間:寫死的規則便宜但不靈活,語言模型聰明但慢且貴。這類模型每次請求的成本約為語言模型的七十分之一,答案短、單價低,兩個因素相乘,就造出 26% 請求量對 0.53% 花費的懸殊比例。
放到實際的應用裡會更具體。一個留言很多的社群服務,可以先用決策模型判斷每則訊息要不要人工審核、屬於哪個分級,只有被挑出來的那一小撮才交給語言模型寫回覆;一個多來源搜尋服務,可以用同一類模型先對候選結果評分排序,再讓生成模型處理最後的摘要。每一趟流程裡,判斷的次數往往遠多於生成,把判斷抽到便宜的那層,總成本的結構就變了。對流量的影響也直接反映在占比上:官方圖表註記,決策模型從八月的零占比長到十月的 26%,同期語言模型的請求占比掉超過五分之一,此消彼長已經在月尺度上看得見。
採用速度比數字本身更值得注意。九月中外上架,十月已經有 15 個決策模型、來自 8 家供應商;將近三分之一的付費團隊在十月用過至少一個,其中 11% 的團隊整個月只叫決策模型,連一次文字生成請求都沒發過。換句話說,每九個付費團隊就有一個的 AI 用量完全由判斷構成,這類應用從頭到尾不需要生成一段文字。判斷層已經能獨立支撐一批應用,不再是生成模型的附屬品。TechMoon 先前介紹過的 Amos 1 與 SubQ Snap 都屬於這個品類,前者把判斷題的答案連機率一起回傳,後者先讀完整份長文件再下判斷。
用量越大,採用越深。每月跑不到 1,000 萬 token 的團隊,只有略高於五分之一用過決策模型;1 億到 10 億 token 的區間接近一半;超過 100 億的達到七成。這與用量本身有關:花費前 1% 的團隊同時使用的中位數是 29 個模型,最後十分位只用了 1 個。請求量大的團隊,從每次請求省下的小錢會快速累積,分工的經濟動機也最強。
集中度是這條線的暗面。報告明說,幾乎所有決策模型流量都流向 TypeSafe AI 的 Jev,它一家的請求量接近 Anthropic 全部模型的四倍;每在 Jev 花 1 美元,團隊同時在 Anthropic 模型上花 64 美元。所以「決策模型占 26% 請求」不能平均攤給 8 家供應商解讀,這一類的規模目前由單一模型扛起,供應與計價的變動風險也集中在那裡。
Anthropic 與 OpenAI 誰領先,取決於你看哪個數字。報告裡三個指標的分母完全不同,放進同一張表就清楚了:
| 指標 | Anthropic | OpenAI | 這個數字在算什麼 |
|---|---|---|---|
| 新團隊第一選擇 | 42.7% | 24.0% | 新付費團隊第一個月把最多語言模型請求交給誰 |
| 付費團隊覆蓋率 | 54 | 55 | 每百個付費團隊有幾個用過該家模型,可重疊 |
| 花費占比 | 約 32 美分 | 近 15 美分 | 平台上每 1 美元估計支出(依牌價)流向誰 |
三行數字講了三個故事。新團隊把首月呼叫交給 Anthropic 的比例將近 OpenAI 的兩倍,而且 Anthropic 是最近 11 個月裡 9 個月的第一名(OpenAI 只在 2025 年 12 月與 2026 年 8 月領先),落後的 Google 為 16.5%、DeepSeek 為 6.6%。覆蓋率則幾乎拉平:去年 12 月是 OpenAI 70 對 Anthropic 48(每百個付費團隊),十月變成 55 對 54。只看去年 12 月就在閘道上的那批老團隊,兩家的觸及都還在擴大,用 Anthropic 的從約二分之一升到三分之二,用 OpenAI 的從約四分之三升到五分之四,兩家同時都用已是常態,花費前 1% 的團隊裡超過九成兩家都碰。花費占比方向又不同:OpenAI 從去年 12 月的約 9 美分一路升到近 15 美分,4 月起每個月都比前月高;Anthropic 則減半到約 32 美分,仍居第一,但報告也注意到它的占比在九月與十月連續明顯下滑。
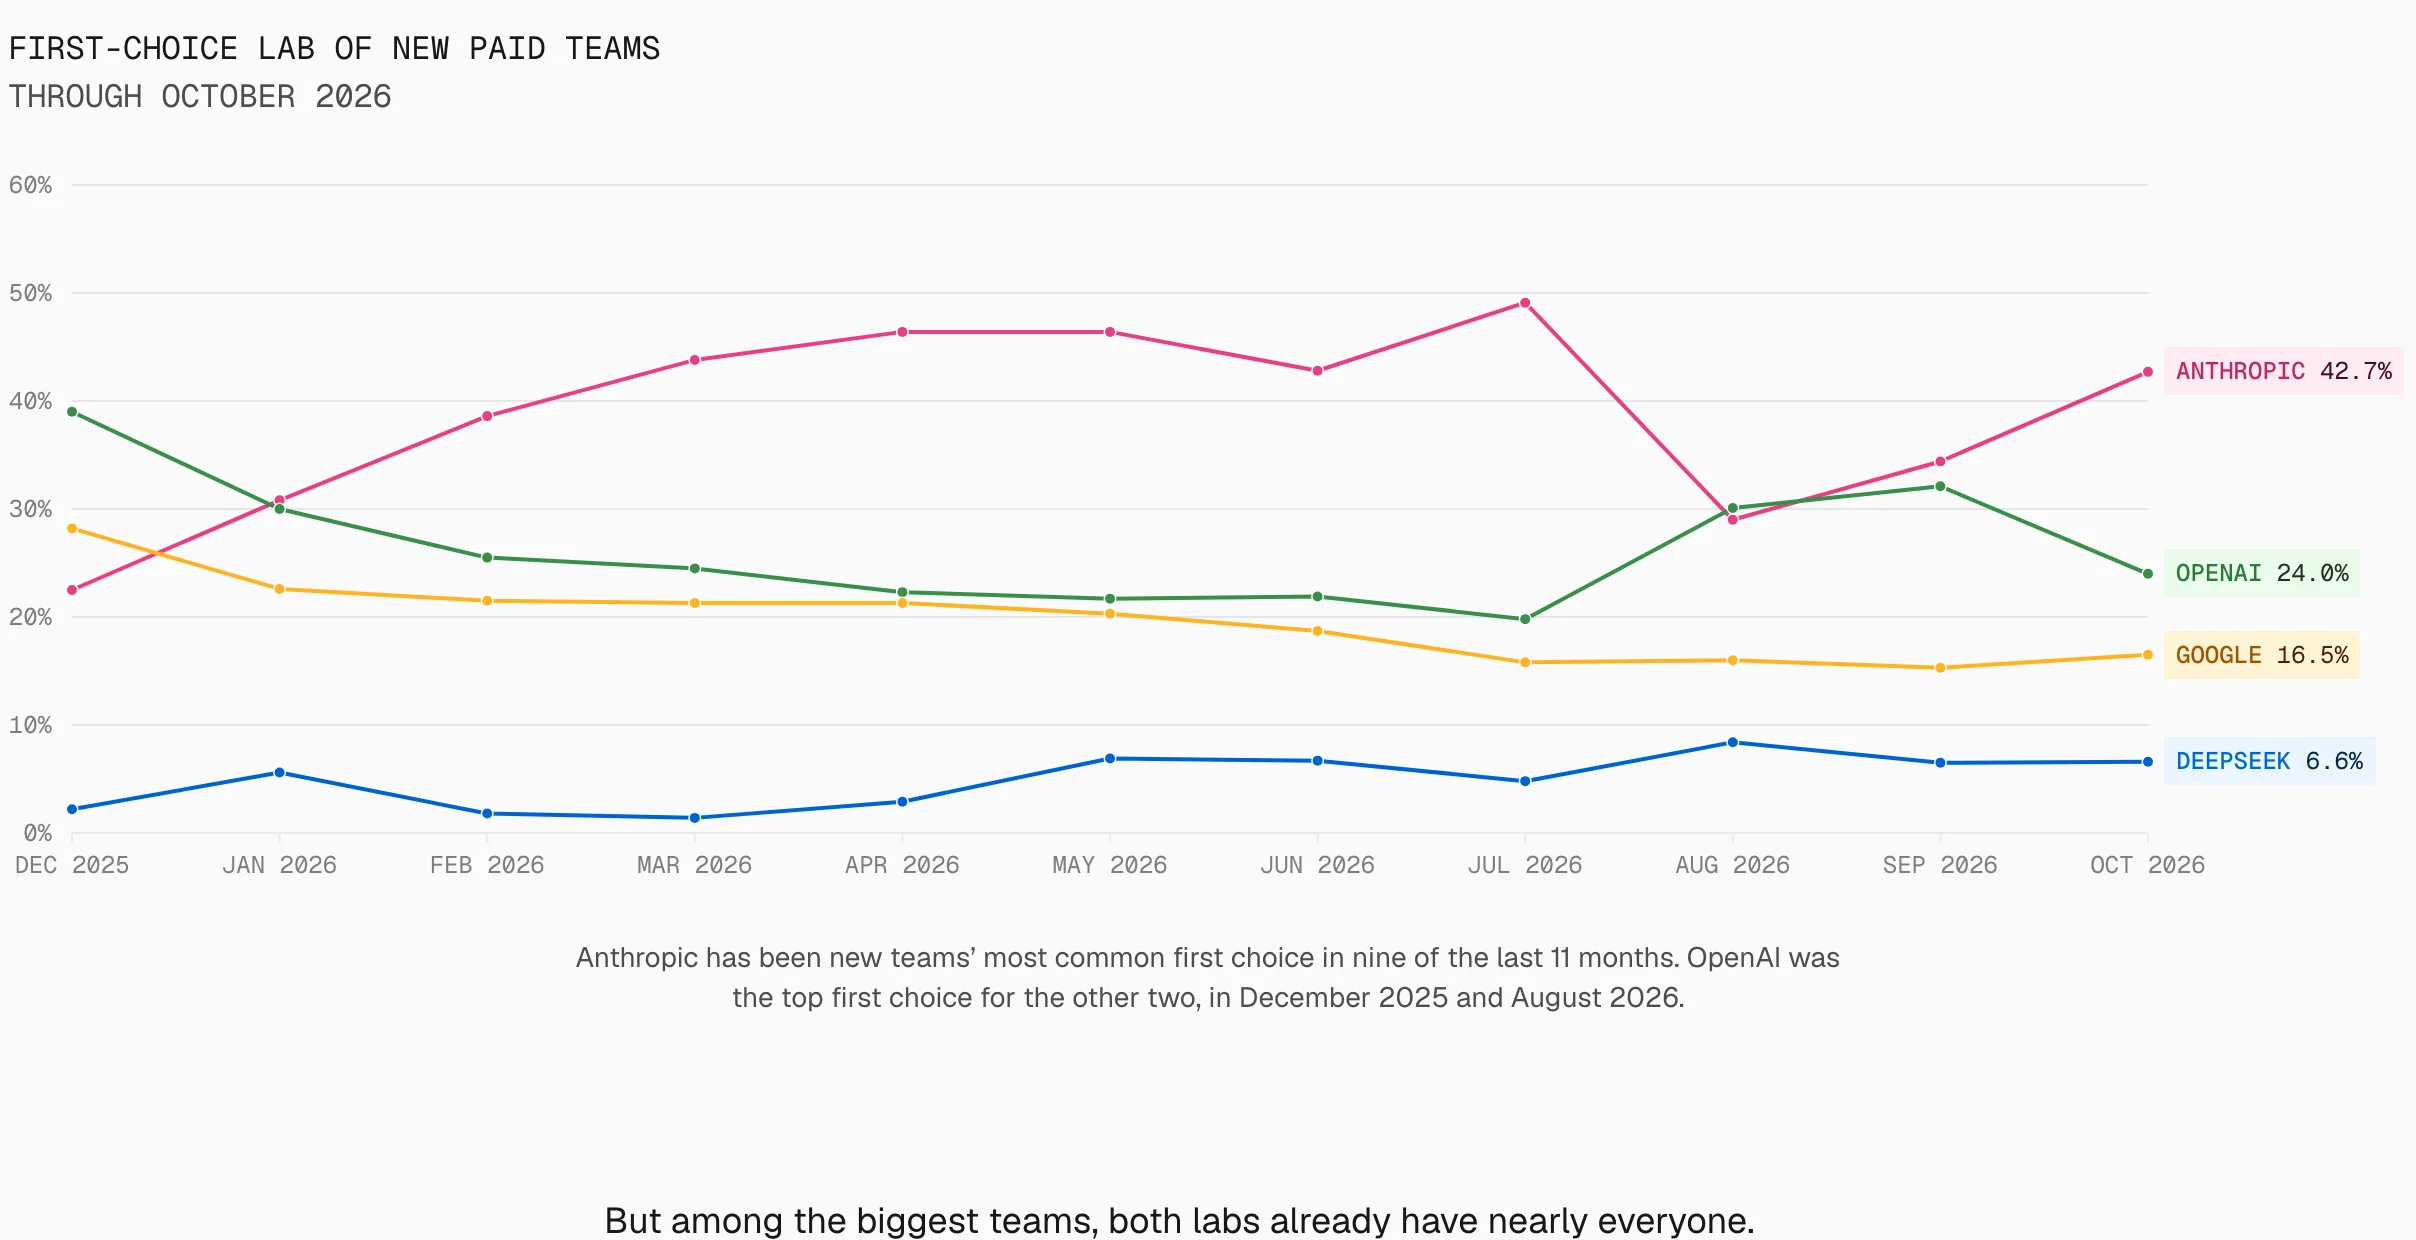
單看任何一張圖都會得出偏一邊的結論,把三張疊起來才是十月真正的樣貌:新團隊的起手偏好給 Anthropic,既有大流量團隊的帳單增量給 OpenAI,而最花錢的那批團隊兩邊都押。模型層的競爭已經從「二選一」變成「每種工作分配多少」。
花費榜本身也有新面孔。Opus 5.5 在第一個完整月份就成為花費第一的模型,約占全部團隊每 7 美元中的 1 美元;使用最廣的六個模型裡,四個是 Anthropic 的(Sonnet 5.5 觸及 26% 付費團隊、Haiku 5.5 為 22%、Haiku 4.5 為 20%、Opus 5.5 為 18%),另外兩個是 Jev 的 28% 與 OpenAI GPT-6 Luna 的 19%。花費冠軍與使用最廣分屬不同模型,兩種榜單引述時也要分開。
換版速度是這份報告裡最陡的一條曲線。十月超過半數語言模型請求指向上架不滿 60 天的版本,九月之前這個比例從未超過三成;九月時約六分之一的請求甚至在呼叫上架不到兩週的模型。每個模型家族中位數每 61 天出一個新版本,典型模型在上架後一個月內到達用量峰值,再過四週,峰值時用它的團隊四分之三已經換掉,無論家族有沒有出後繼版本。報告因此下了一個好記的註解:模型的半衰期約六週。換句話說,對使用方而言,模型廠商的籌碼永遠只有最新那一版,每出一版都要重新證明自己值得被叫用。
換版不等於離開。換版統計只看九月與十月都至少用 1,000 萬 token 的付費團隊:十月約半數換掉了自己最常用的模型,其中五分之四換到更新的版本,十分之六換到別家實驗室;但七成團隊仍會用至少十個月前的舊模型,只是典型團隊給它的 token 不到 3%。離開某個版本的團隊,大多數還留在閘道上,只是把量轉去別的模型,這是版本級的流動,不是平台級的流失。以 61 天的中位週期推算,一個模型家族半年內大約會迎來三個新版本,靠人工盯著每次改版並不實際,把驗收做成可重複執行的流程才是跟得上的方式。新版承接主力、舊版留做小量特定用途,是並存而非替換。對開發者的實際意義是:模型選型別當成一次性決定,按任務驗收、保留可回退的版本,比押注哪一家更可靠。想少改程式碼就換模型的團隊,可以參考 Vercel 自己的 AI Gateway Virtual Models,把路由與備援搬到平台設定層;要盯住成本曲線的,則有 Tracing 這類用量觀測工具。
語音的成長多數來自加裝,整套換掉是少數。十月有 10.7% 的付費團隊用到語音模型,七月約為二十四分之一,增幅 161%;七月與十月都付費的同一批團隊,採用率從 5% 升到 14%,成長不只在新增客戶。拆開看,語音轉文字占 8.0%、文字轉語音占 5.2%、三步包辦的整合式模型只有 1.8%,而且同一個團隊可以同時用多種,直接把三個占比相加會重複計算。語音轉文字自七月以來接近三倍,文字轉語音更超過三倍,多數團隊只用其中一到兩段:把使用者的話轉成文字,交給原本熟悉的語言模型回答,再朗讀回去。七月時約四分之一的語音團隊用整合式模型、六分之一自己組裝三段,到十月兩個比例對調,自己拼湊流程反而是主流。每月發出至少 100 次語音請求的團隊成長了五倍,九月用過語音的團隊六成在十月回頭(七月時連一半都不到),用量也在加深。
圖像與影片都創下閘道單月新高,而且最大的團隊跑最快。花費前 1% 的團隊裡,約三分之一現在用圖像模型(七月是四分之一),六分之一用影片模型(七月是十分之一)。OpenAI 最新的 GPT-Image-2.5 Sunburst 在第一個完整月份就拿下圖像花費第一,其次是其 Flare 與 GPT-Image-2;影片側由字節跳動的 Seedance 2.5 連續第三個月居首,領先 Google 的 Veo 3.1 與快手的 Kling 3.0。生成側的費用正在從純文字往多模態分岔,這條腿會長多快,十二月報告值得回頭對照。
報告的測量方式有幾條硬規則。花費依公開牌價估計,不是實際帳單;付費團隊定義為當月至少發過一次付費請求;團隊規模按當月 token 總量分級,與員工人數無關;模型年齡從該版本上閘道的第一天起算(閘道歷史自 2025 年 10 月 20 日累積),與廠商正式發表日未必相同;語音資料從 2026 年 6 月 22 日起算;換版統計僅涵蓋九月與十月都至少用 1,000 萬 token 的團隊。官方也明言方法更新時,過去月份的數字可能跟著修訂。十月數字到了十二月未必原樣,引用時附上出刊月份比較安全;同樣地,十一月才發表的新模型與新定價,效應要等十二月版才看得到。
還有一層樣本偏差要自己警覺:會選擇統一閘道的團隊,本來就可能是更常切換供應商、更在意路由彈性的那群人,這點報告沒有提供全市場抽樣來排除,屬於讀者的推論空間而非報告結論。它能回答的是「經過這個入口的流量怎麼變化」,不能回答全球市占、模型優劣,或任何一家廠商的營收。官方把統計方法與可下載的公開資料放在閘道排行榜頁面,想自己做對照的人有第一手材料可用。
對高頻應用,這份報告最實際的用法是當對照組:盤點自己的請求量裡有多少其實只是分類、評分與挑選,把那部分拆出來用短答案、低單價的模型跑,成功標準照舊驗收;生成側則維持按任務的比較與可回退設計,別因為請求榜或花費榜的名次改變就整批搬遷。請求占比、團隊覆蓋率與花費占比,三個數字三種分母,看懂差別,這份每月報告才會從熱門榜變成決策材料。