TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

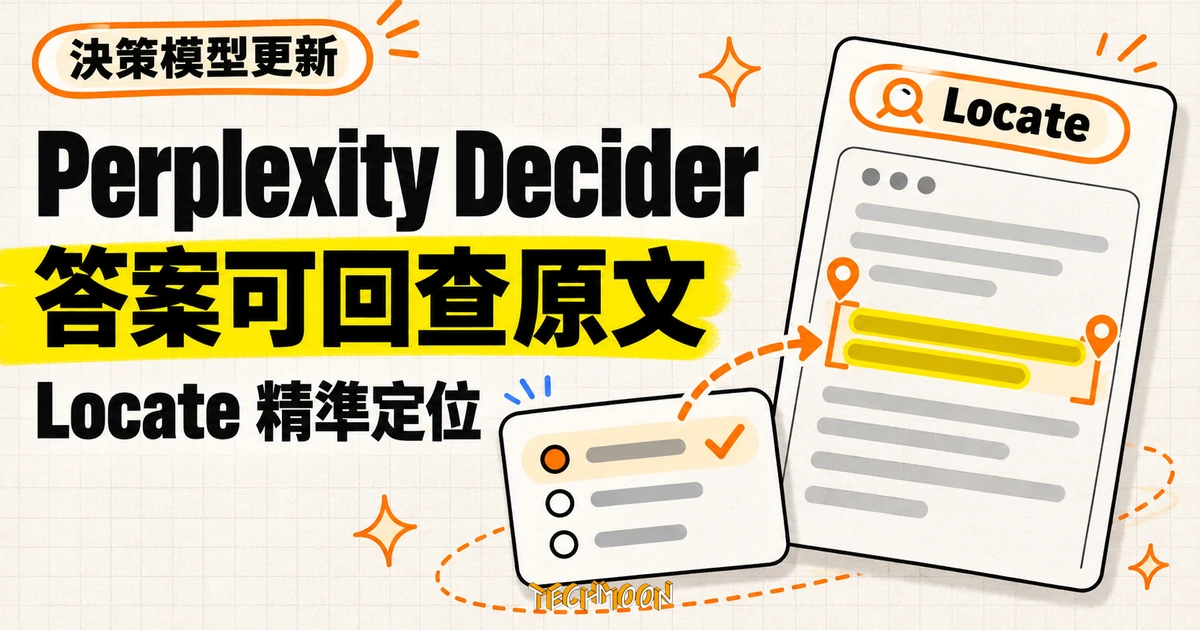
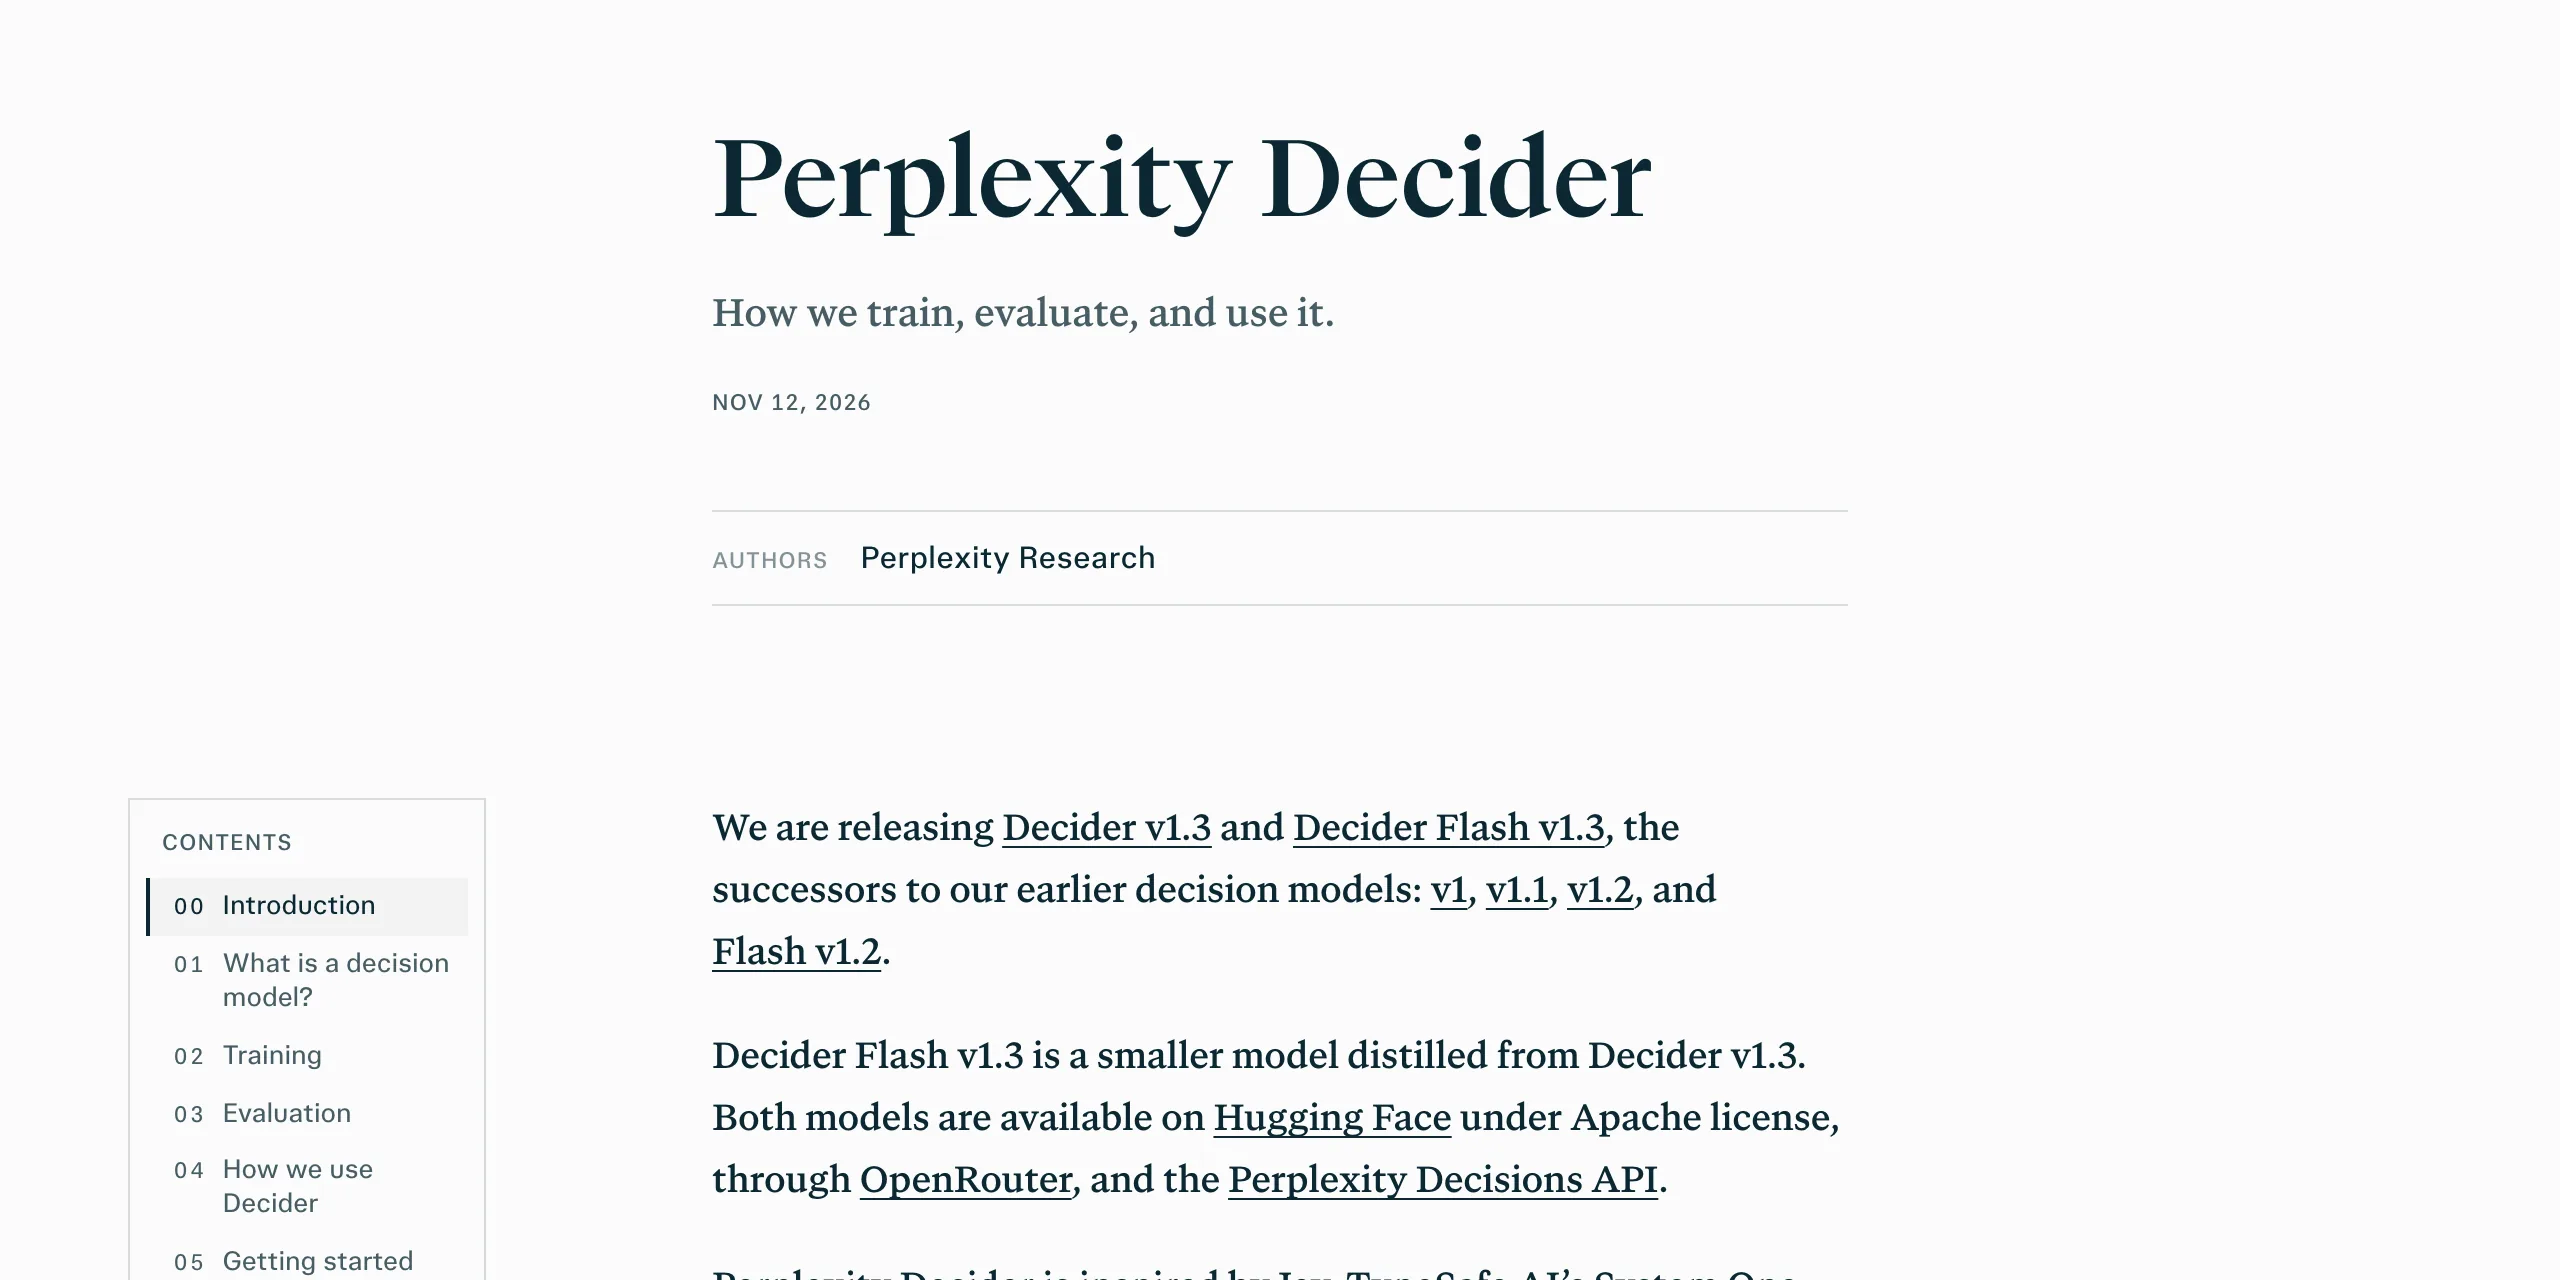
Perplexity 於 2026 年 11 月 12 日發布 Decider v1.3 與 Flash v1.3,新增加 Locate 原文擷取:回傳逐字片段、字元起迄位置與分數,可對回原文做證據標亮。權重以 Apache 2.0 開放、OpenRouter 標免費、Decisions API 每百萬輸入 token 0.02 美元;文字輸入限定、單次最多 128 個擷取問題,v1.2 遷移要重建請求格式並重校門檻。
用 AI 摘要這篇文章:
Perplexity 在 2026 年 11 月 12 日刊出研究文章,發布決策模型 Decider v1.3 與小尺寸版 Decider Flash v1.3,兩個模型的 Hugging Face 儲存庫則已在 11 月 9 日上架。這次更新的核心是一個叫 Locate 的新輸出類型:以前問 Decider「這張客服單該給哪個團隊」,它回你一組機率;現在你可以再問「錯誤代碼在原文哪裡」,它會把符合描述的逐字片段連同字元起迄位置與分數一起回傳。
對寫程式的人來說,這個改動的意義可以一句話講完:分類答案旁邊第一次多了可以對回原文的證據。接手的人不用重讀整段文字,介面可以直接把答案在原文裡標亮。取用的門檻也壓得很低:權重在 Hugging Face 以 Apache 2.0 提供、OpenRouter 頁面標了免費、Perplexity 自家的 Decisions API 每百萬輸入 token 收 0.02 美元。不過官方文件同時寫清楚了三件事:Locate 只吃文字不吃圖片、混合請求要多跑一次運算、從 v1.2 遷移要重建請求格式並重新校準門檻。這些限制直接決定它適不適合接進自己的流程。
先看規格。模型卡定義 Locate 的回傳是 spans 清單,每個 span 有四個欄位:起點 start、終點 end、文字 text、分數 score。終點不包含在片段內,而且模型卡明寫一條保證:state[start:end] 切出來的內容會完全等於回傳的 text。這代表程式可以直接拿位置對回送進模型的原文,做標亮或存證都不用再猜。
找不到符合內容時,官方規格允許回傳空的 spans 清單。對需要留證據的流程來說,明確說沒找到,比硬擠出一段像摘要的東西有用得多,這點官方設計有照顧到。
問題怎麼問?Locate 的問題名稱本身就是預設標籤,例如 "person": {"type": "locate"} 就是找人名;想問得更精確,加一段 instructions 換掉標籤,像「找出簽合約的那個人」。官方部落格給的定位是命名實體辨識、個人資料識別與擷取式問答,訓練時混了這三類任務,欄位描述從短標籤到完整句子都有,避免模型只認得固定標籤集。
有一條界線要分清楚:位置與原文一致是規格保證,片段是否真的回答了你的問題則是另一回事。問「合約簽署人是誰」,模型可能抓到文件裡出現的另一個人名,字串確實在原文裡,但答案不對。所以導入時的驗收不能只檢查回傳格式合法,要拿自己標好正確答案的資料分開量:該抓的有沒有漏、不該抓的有沒有多抓、同一個名字出現多次時位置有沒有指對段落。
實作上官方用的是外掛而非重訓:模型維持原本的分類能力,Locate 靠新增的特殊 token、一個 span head 與 LoRA 轉接器完成,主幹與決策頭全程凍結。官方也說明了為什麼不把轉接器合併回主幹:合併會讓決策類請求的表現倒退,目前仍做不到無損,所以轉接器保持獨立,第一次收到 Locate 請求時自動載入。儲存庫裡也確實有獨立的 locate-span/adapter.safetensors 檔案對應這個設計。
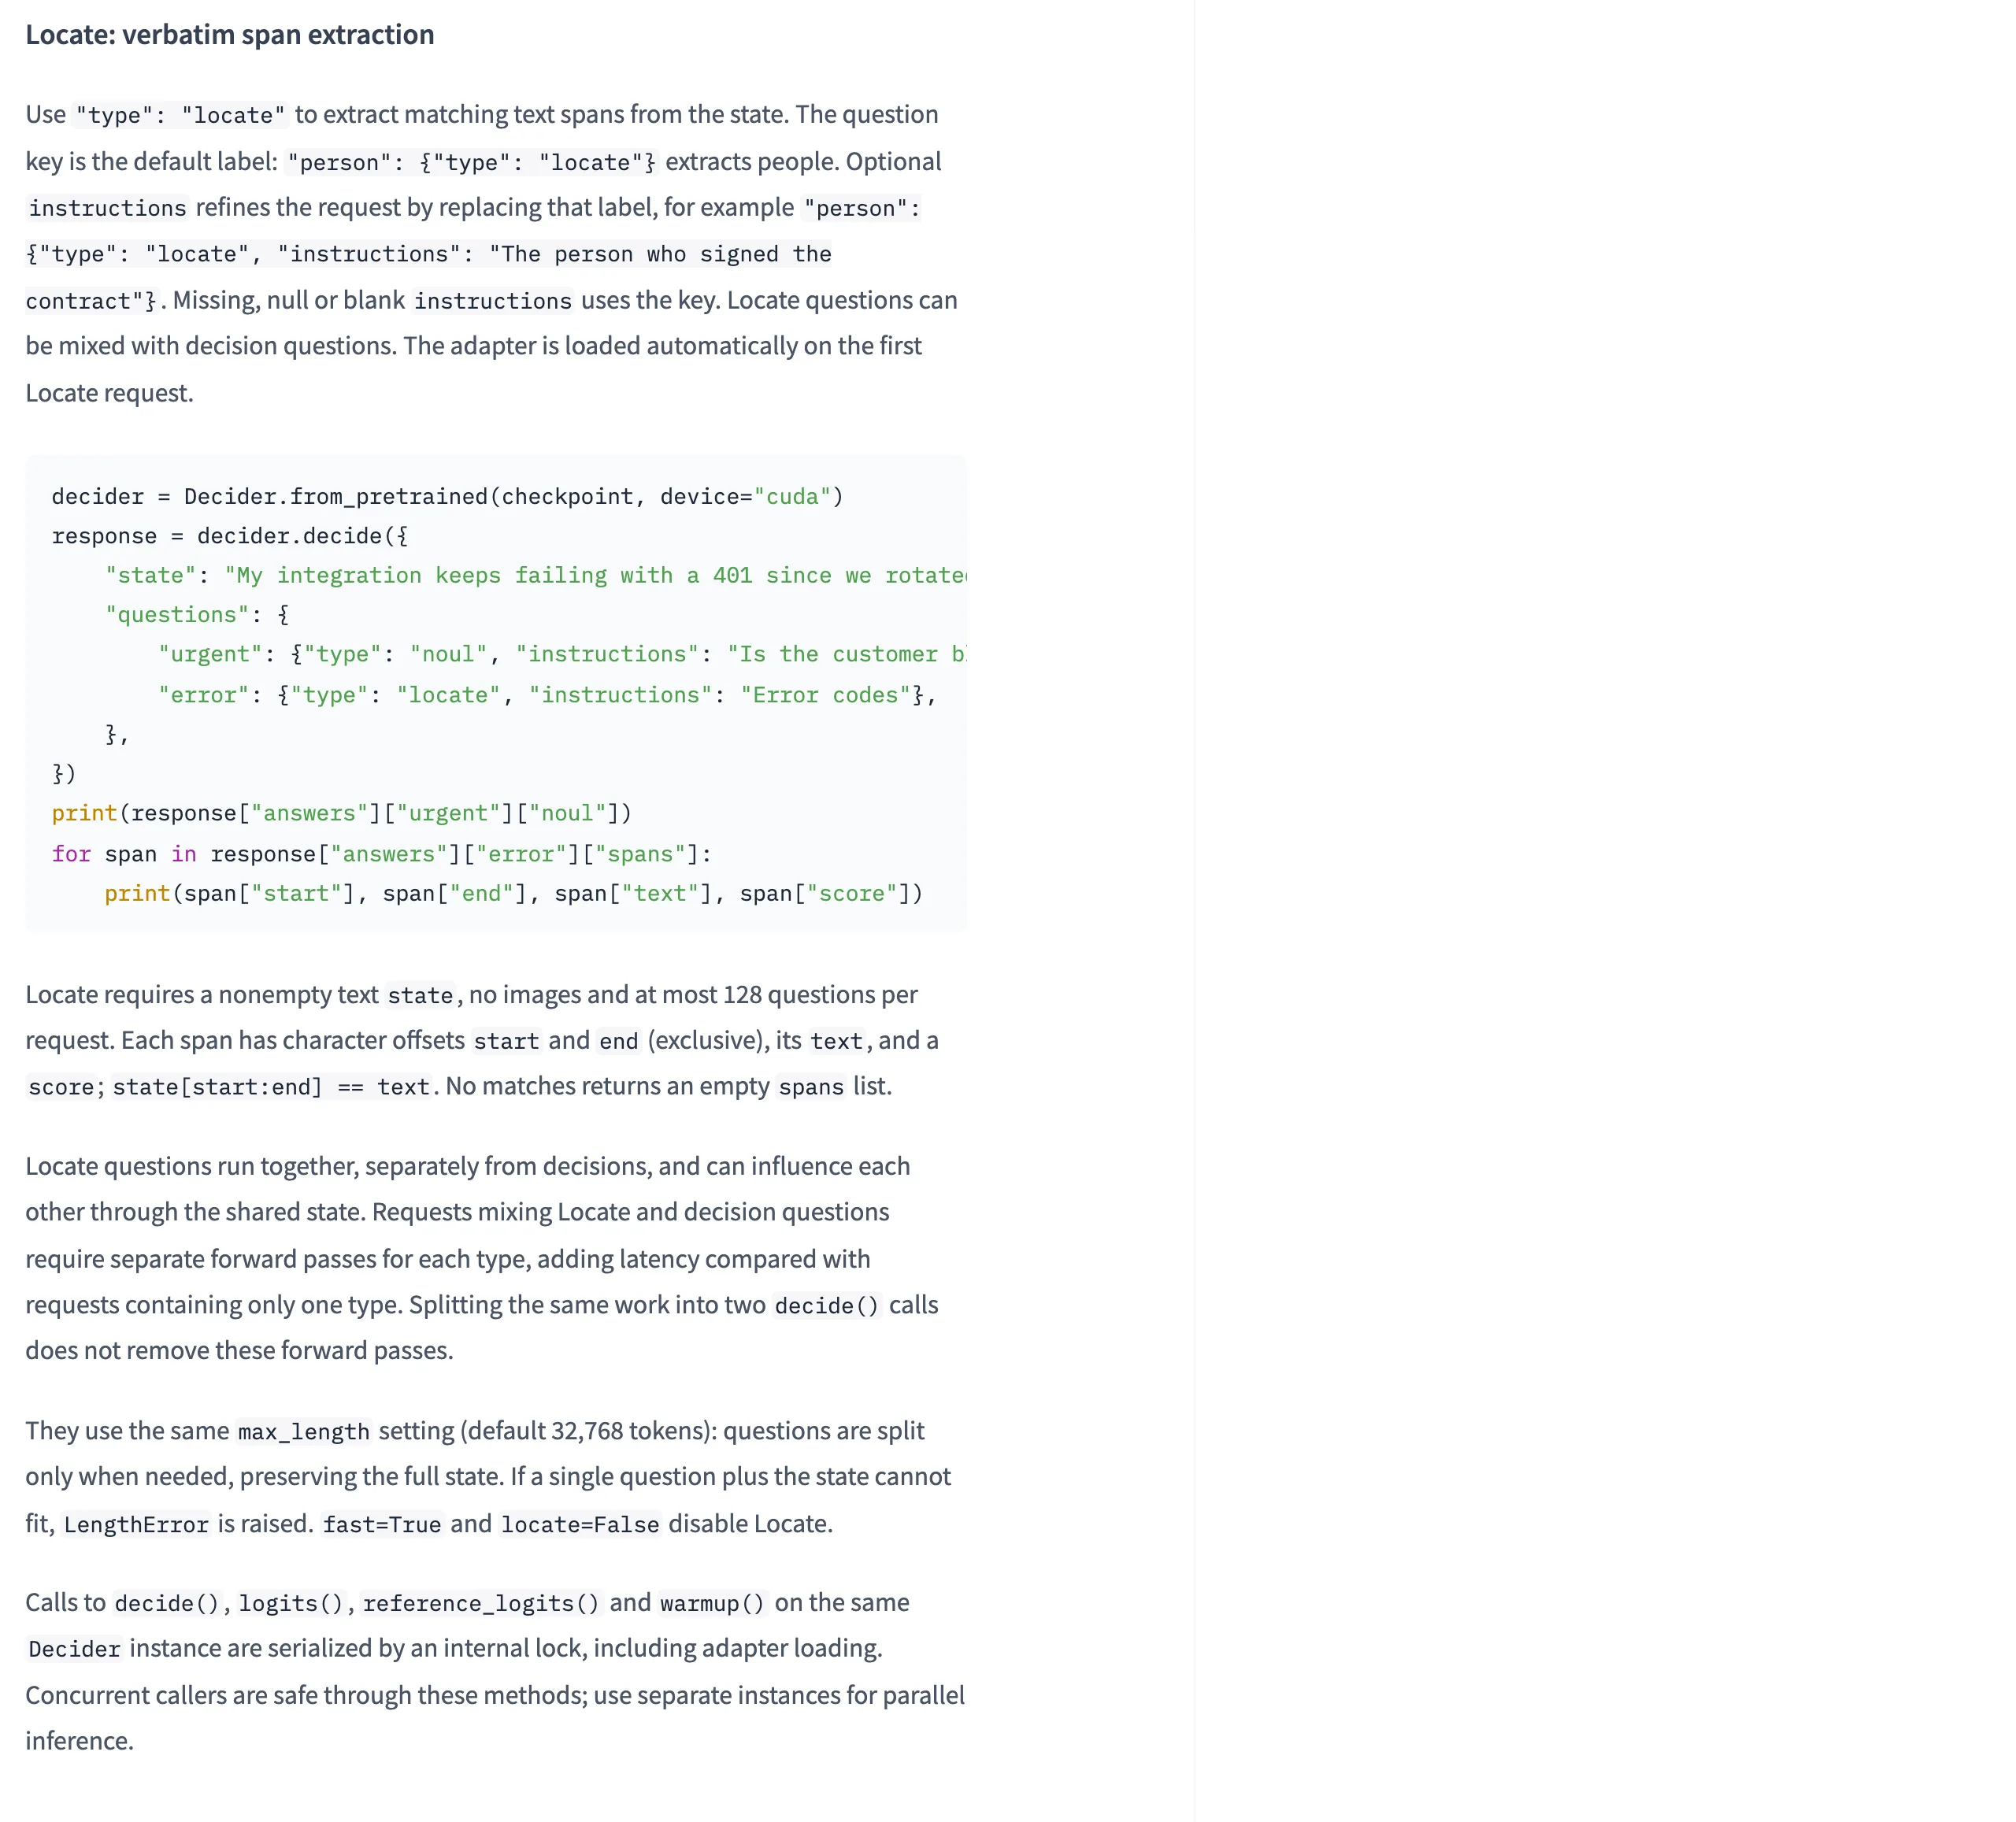
Locate 的限制寫得很白,但很容易在規劃流程時被漏掉。
輸入是最先撞上的限制。Locate 要求非空的文字 state,不接受圖片,單次請求最多 128 個擷取問題。分類模式自 v1 起就能看圖(每張圖等比例縮到最多 1,638,400 像素,約佔 1,600 個序列位置,會計入長度限制),但這個能力不會延伸到擷取:手上如果是掃描文件,前面得自己接文字辨識,而且辨識與擷取要分開驗證,錯誤可能發生在任何一層。
運算方式也要重算。Locate 問題與決策問題可以放在同一份請求裡,但兩種任務會分開跑模型運算,混合請求因此比單一任務的請求多花時間。官方還補了一句很實在的話:把工作拆成兩次程式呼叫,也省不掉這些運算,該跑的還是要跑。
加速模式有個陷阱。fast=True 會停用 Locate,locate=False 也是。這代表分類模式的加速成績不能直接拿來承諾擷取流程的延遲,兩種工作要分開量。
長度方面,擷取模式預設上限是 32,768 個 token,問題會在必要時拆批、狀態保持完整;但如果單一問題加狀態就是塞不下,模型會直接回 LengthError,不會自動幫你截斷。長文件要先想好切分方式,並保留每段對應的原始位置。
模型卡的疑難排解區有一條會直接影響既有系統:v1.3 要用它自己的請求建構方式,不能沿用 v1.1 或 v1.2 的提示建構器。只換模型名稱、保留舊格式,得到的結果不可比較。換版的工程量要先估進去。
門檻也要重校。模型會套用一組在保留資料上擬合的溫度參數來調整機率分布,但官方明說單一溫度不可能適合每一種流量的任務,每個任務用自己的門檻通常更好。舊系統如果用「高於某分數就自動處理」的規則,換版後分數格式即使看起來一樣,也該拿人工標記過的歷史資料重新對照高分錯誤與低分正確的比例,再決定新門檻。分類分數與擷取片段的分數是兩種任務的輸出,數值不能互相比可信度。
行為差異則要回到這一版最大的架構變動。v1.2 的注意力格局是「全部互相看見」:狀態與所有問題一起處理,答案會隨著其他問題增減而變。v1.3 改成「隔離問題」:狀態讀一次,每個問題只看狀態與自己,題目之間不再直接干擾,官方的理由是結果更穩定。官方還提了第三種沒有採用的「可快取」格局,讓狀態只看自己、跨請求重複使用,方便吃提示快取的紅利,但因為狀態看不到題目對好幾類任務影響很大而作罷,官方說小量微調可以切換過去。程式介面則有 separate 與 isolated 兩種模式,預設的 separate 讓每題各自讀狀態、增減題目不影響他題;isolated 把整份請求編成一個序列、狀態只讀一次,省運算,但官方樣本中有 1.5% 到 2.2% 的最高選項與預設模式不同。省錢與穩定之間要自己選,選了就整份工作單重測。
版本節奏也值得記一筆:v1 在 10 月 1 日上架、v1.1 在 10 月 5 日、v1.2 與 Flash v1.2 在 10 月 15 日,v1.3 的兩個儲存庫在 11 月 9 日建立、11 月 12 日配上一篇完整的訓練與評測說明。六週內四個版本,表示這條產品線還在高頻改版,接進生產流程的人要有隨時再遷移一次的心理準備。
| 管道 | 門檻 | 費用 |
|---|---|---|
| Hugging Face 權重自架 | 49 GiB(Decider)或 8.5 GiB(Flash)BF16 權重加 CUDA 與 Python 3.12 | 模型免費,Apache 2.0,硬體自付 |
| OpenRouter | 有帳號就能呼叫 | 頁面標示 free |
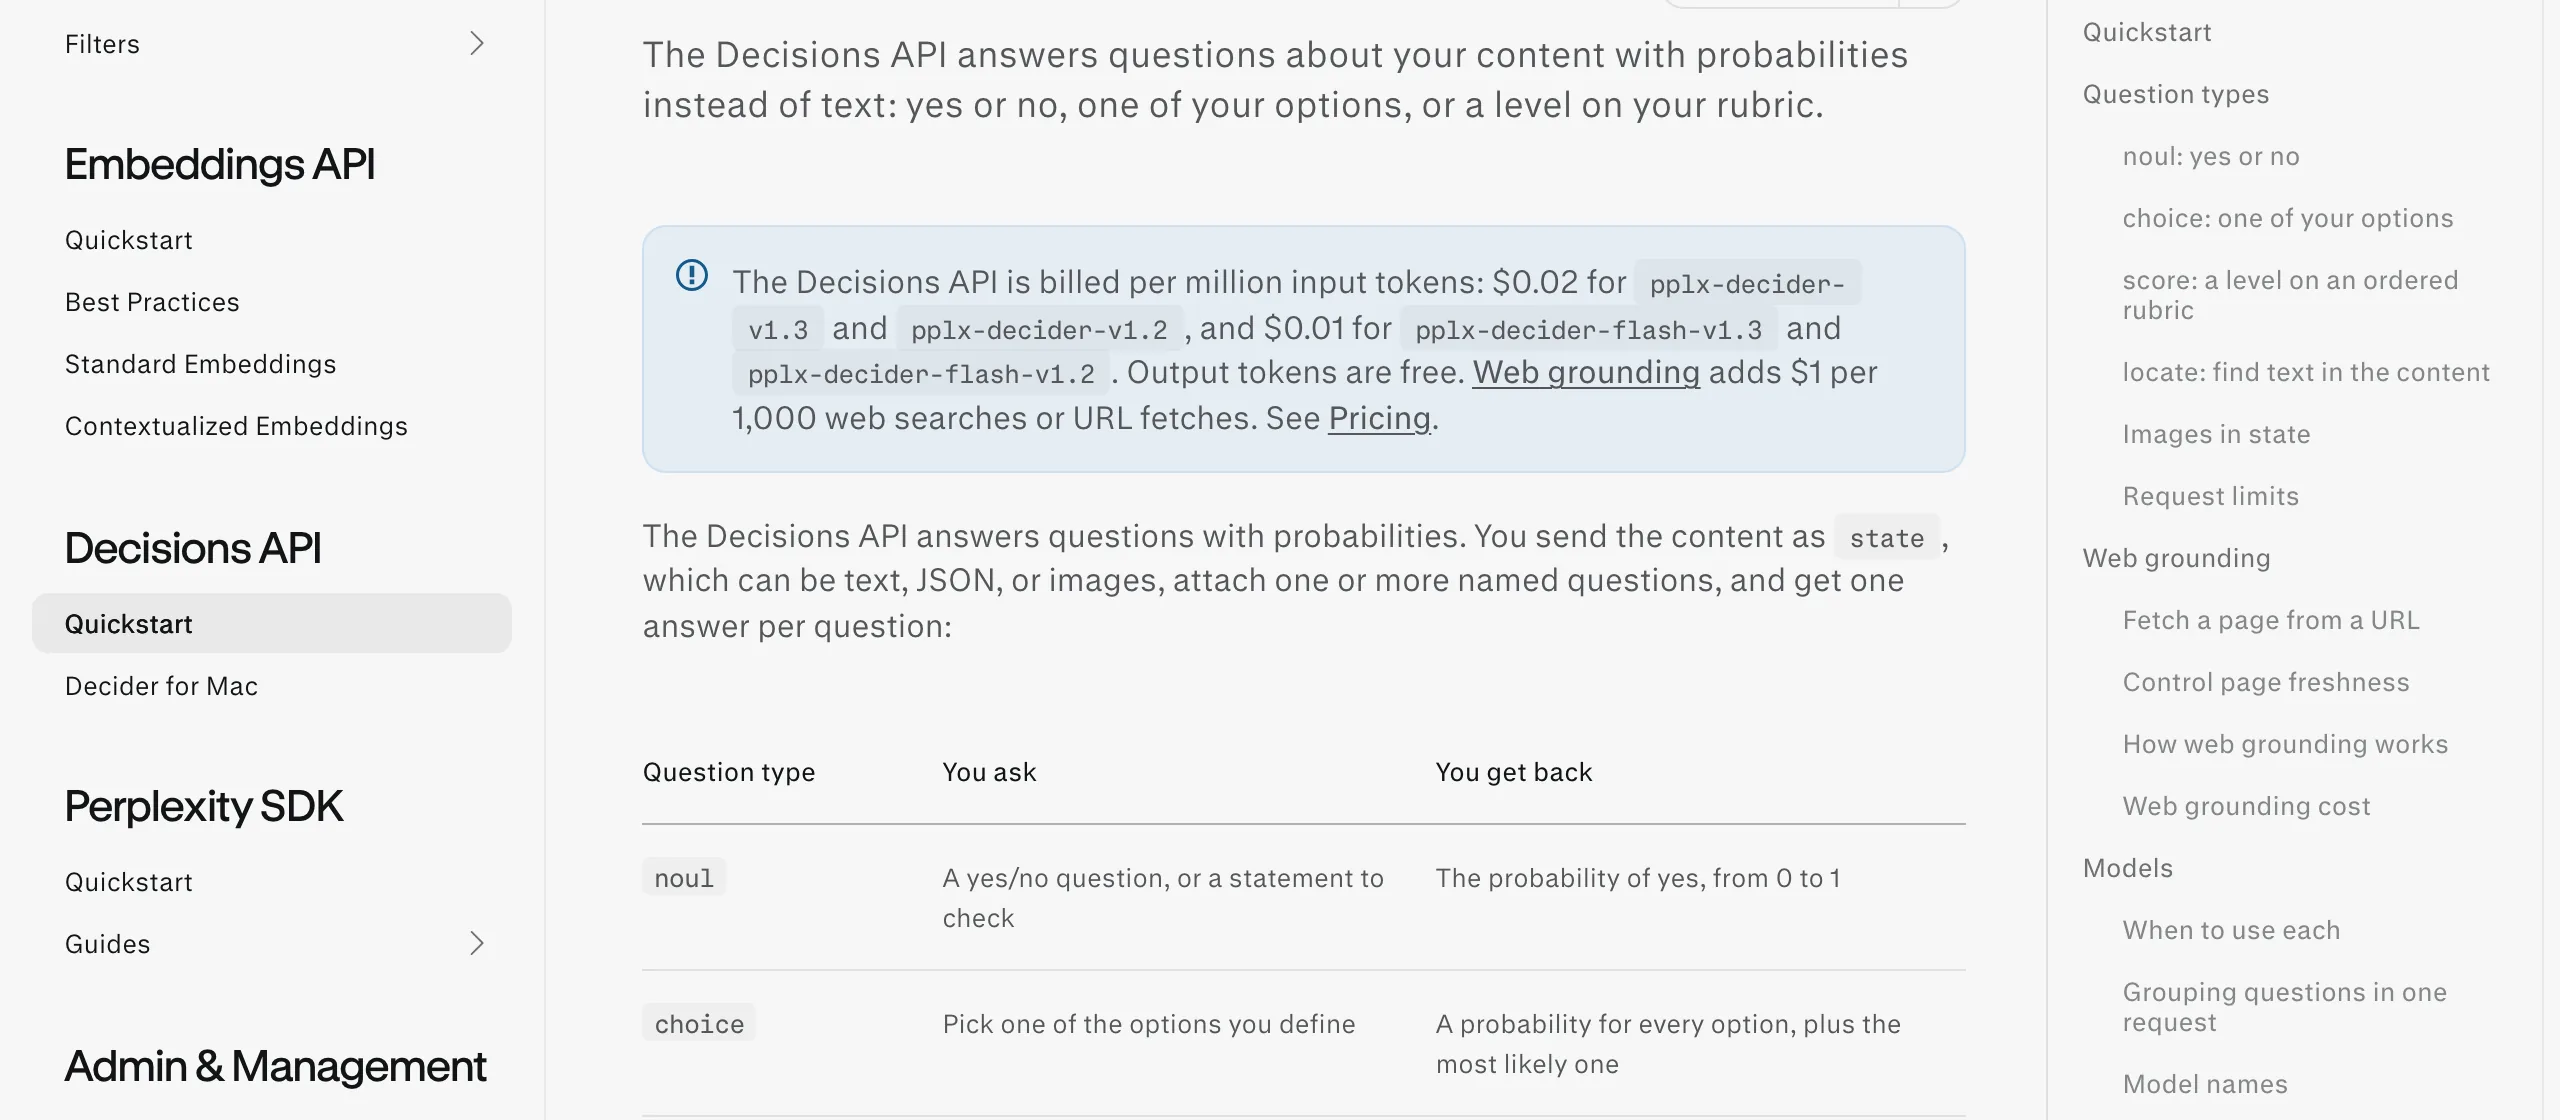
| Decisions API | 申請 API 金鑰 | 每百萬輸入 token 0.02 美元(Decider)或 0.01 美元(Flash),輸出免費 |
想試用,先看 Hugging Face 權重。兩個模型都以 Apache 2.0 授權,授權欄位與模型卡 frontmatter 都寫得明確。這裡有個文件與現況的落差值得記下:模型卡內文寫「此儲存庫是私有的,需有權限的 token 才能下載」,但我在未登入的狀態直接抓 config.json 與權重分片,分別拿到 HTTP 200 與 206,Hugging Face API 也標示 gated: false。也就是說,權重目前實際上公開可下載,模型卡那句敘述沒有同步更新。取用前自己再確認一次,別被那句話勸退。
自架的硬體門檻差一個量級:Decider v1.3 基座是 Qwen3.8-27B,BF16 權重約 49 GiB,還要另留運算空間,等於一張高階顯卡起跳;Decider Flash v1.3 基座是 Qwen3.5-4B、由 27B 蒸餾而來,約 8.5 GiB,規格與功能含 Locate 都相同,官方定位是延遲與成本優先的場景。
不想自架,還有 OpenRouter。perplexity/pplx-decider-v1.3 與 perplexity/pplx-decider-flash-v1.3 兩個頁面都已上線,頁面標題直接標了 free,是三條路裡摩擦最小的。免費標示會維持多久官方沒有說。
最後是 Perplexity 自家的 Decisions API。計價按每百萬輸入 token 算:Decider 收 0.02 美元、Flash 收 0.01 美元,輸出 token 免費;需要讓模型邊判斷邊查網頁的話,網頁查證另計每千次 1 美元。模型別名用 pplx-decider-latest 與 pplx-decider-flash-latest。帳單有個細節:文件註明 Flash 在同一份請求放多個問題時,每題分開評估,狀態也每題各計一次費,多問題請求的成本不是「一份狀態算一次」,估預算時要按題數放大。
Perplexity 這篇文章給了非常完整的評測數字,讀的時候要記住一件事:這些全是官方自己量自己,對照組的挑選與口徑都是官方決定的,當方向參考可以,當採購依據之前要用自家資料重跑。
Locate 的部分,官方在 17 個域外任務上量測,範圍從維基百科、科學論文、資安報告到隱私權政策與法律合約,Decider v1.3 平均 69.0 分、Flash 63.6 分,對照的 Liquid d1 是 43.3、Cloudflare 的 Clairic 是 41.5、GLiNER large v2.5 是 33.6,官方宣稱每個類別都領先。量測口徑值得一提:命名實體與個人資料用的是嚴格的精確邊界 F1,邊界差一個字都不算對,這比寬鬆的重疊計分老實。
生產環境的數字更有參考感。官方抽了 Decisions API 上線頭 18 天的 100 萬筆去重、遮罩過個人資料的請求(共 232 萬個問題,皆經使用者同意用於研究),因為生產請求沒有標準答案,改用前沿 LLM 當裁判量一致率:Decider v1.3 拿到 93.98%,高於 v1.2 的 93.68% 與 Jev 1.14 的 93.35%。穩定度實驗裡,改選項順序、換標籤文字後,Decider 答案翻轉率 0.27%,Jev 是 2.69% 到 4.84%;同一輸入重複送,Decider 零變化,Jev 有 1.88% 會變。
其他軸向的數字順序帶過:多語分類覆蓋八種語言、19 個任務、46,484 個樣本,Decider 平均 88.16%、Flash 86.50%、Jev 85.41%,Decider 在八種語言全勝、Flash 贏六種;文件分類為主的五項影像任務,Decider 76.99%、Flash 72.77%;查詢分類的 63 個內部任務上 Decider 平均 91.6% 正確率,官方宣稱超過自家生產分類器 6.54 個百分點。訓練方法上有一段對技術團隊有參考價值的細節:Flash 用 KL 散度從 27B 蒸餾,官方量到這比直接用交叉熵泛化得更好,並以假說解釋:老師模型對非正確選項的信心分布也被一併帶走;訓練資料則排除各基準的訓練集並做偏誤稽核,防止分數是被資料偏倚撐起來的。
成本比較圖官方自己加了三個但書:工作量特定、本機硬體成本會計方式未指明、沒有延遲對齊比較。這三句但書比圖本身更有參考價值,拿這張圖去算自己的帳會算錯。
內部用例給了規模感:Perplexity 拿 Decider 離線掃代理日誌找規則漏抓與誤抓,一天讀 10 億 token、覆蓋 7,000 個代理 session,促成 14 項安全規則修正、其中 6 項兩天內上線,重放一週日誌後最忙的規則量少了 52%。另外兩個內部場景是監控強化學習的 rollout(只觀察不改獎勵)與爬蟲頁面品質過濾。
官方文章開頭就說 Decider 的設計受 Jev 啟發,也就是 TypeSafe AI 的 System One Model,那個不生成文字、只回決策的原型。這次評測裡 Jev 1.14 也是出場最頻繁的對照組,七個領域 Decider 全部領先(官方數字,金融最多 12.9 個百分點),但 Flash 在金融、程式、法律三個領域反而落後 Jev,選小模型不是純省錢。
決策模型這條線最近確實熱鬧:微軟的 Decision-1 用同價對齊 Jev 打企業市場,Kakao 的 Kanana 決策模型開放了權重,還有 Amos 1 把判斷題答案連機率直接回傳。Perplexity 的差異化在兩件事:把原文擷取併進分類模型同一套請求格式,以及開放權重加免費 API 端點的取用組合。
如果你的流程裡有「分類完還要人工回原文找證據」這一步,這次更新直接相關。合理的起手式是挑一條低風險流程先試:標籤固定、原文可回查、錯了能發現的那種,例如整理客服單的錯誤代碼。驗收時把分類正確、擷取漏抓、擷取多抓與整體延遲分開記,混合請求與純分類請求的延遲也要分開量,因為它們本來就會分開運算。門檻一律用自己標記的資料校,官方溫度只是起點。
還沒有答案的部分:OpenRouter 的免費標示未給期限;官方評測目前仍缺第三方複驗;Locate 的 17 項評測也尚未單獨拆出中文或多語成績(官方多語評測覆蓋八種語言,但量的是分類任務)。定價與免費標示都是會變動的數字,導入前以官方頁面現況為準,這也是這類低價 API 供應節奏下唯一穩當的做法。