TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

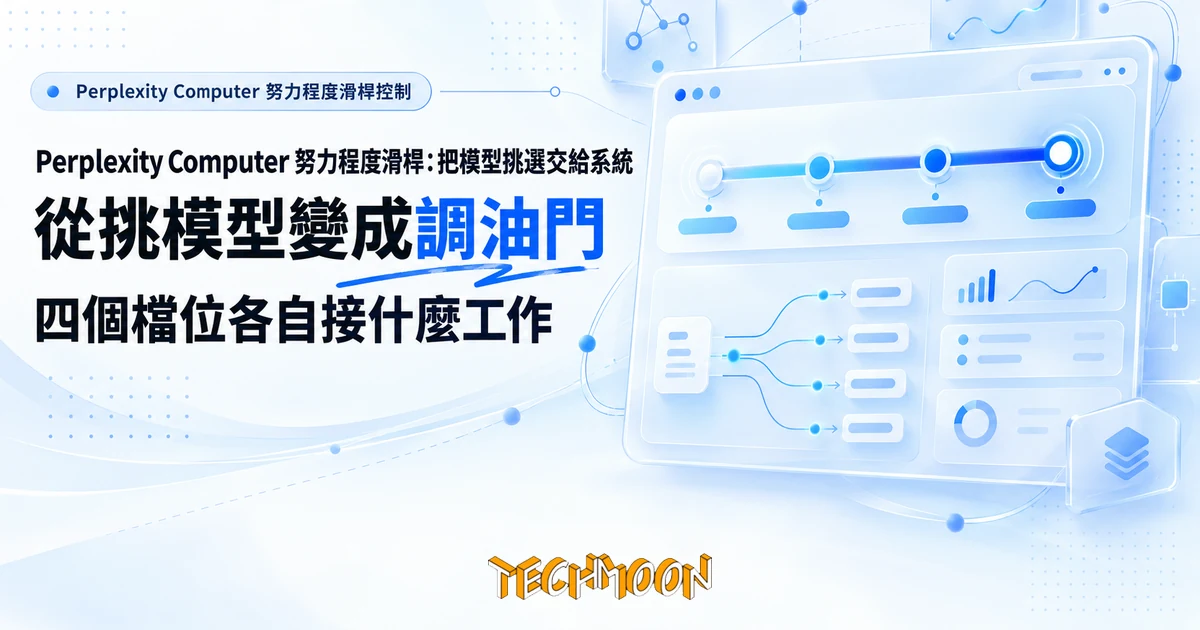
Perplexity 於 2026 年 9 月 17 日為自主代理 Computer 推出努力程度控制,Omnibar 滑桿提供 Light 到 Ultra 四檔,使用者只決定任務投入多少,模型挑選與推理深度交給系統,自訂控制保留並用,網頁版已上線。
用 AI 摘要這篇文章:
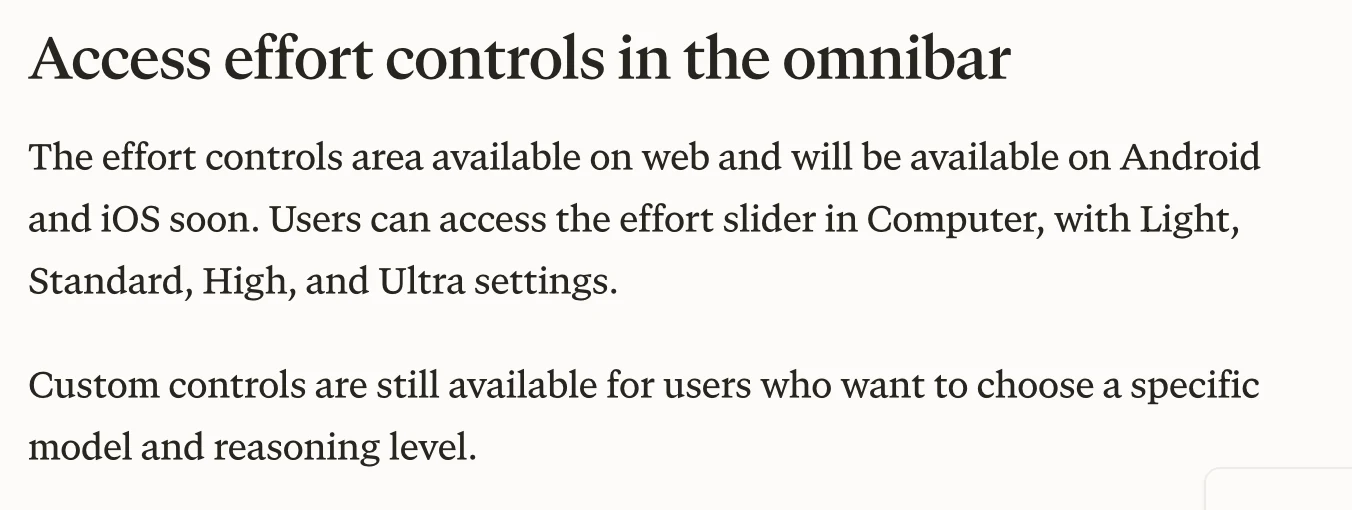
2026 年 9 月 17 日,Perplexity 在官方部落格發布〈Computer adds effort controls for model selection〉,為旗下的自主代理產品 Computer 加上努力程度控制。使用者在命令列(omnibar)裡拖動一段四格滑桿,從 Light、Standard、High 到 Ultra 四個檔位裡選一個,Perplexity 再依這個設定替每項任務挑選底層模型與推理深度。換句話說,你不再指名要用哪個模型,只交代這件事要投入多少心力。
官方把這次更新的動機講得很直白:使用者告訴他們,想自己決定一項任務值得多少努力、願意為它花多少,至於模型挑選就留給 Perplexity。原本的自訂控制(custom controls)並沒有被拿掉,想繼續指名特定模型與推理等級的人照舊能用。新滑桿是加在旁邊的另一條路,對象是那些不想研究模型型號、只在乎結果與花費的人。這個設計把一個本來屬於玩家的知識問題,換成任何人都能回答的預算問題。
Computer 是 Perplexity 從今年 2 月開始經營的通用代理產品:交辦目標後自行規劃執行、產出文件與應用,而 omnibar 這條命令列一直是各種能力的入口,7 月的 Model Council 也是從這裡發動。理解這一點,滑桿出現在 omnibar 裡就不是隨手的介面裝飾,而是這條命令列的定位延伸:入口管的是你要什麼,至於底下怎麼分工,產品打算自己處理。
先看被放在旁邊的舊做法。Computer 過去的模型控制走自訂介面,使用者自己點開清單、指名模型、設定推理等級。這對知道自己在做什麼的人沒問題,但對多數人等於把採購決策塞進日常工作:你得先弄懂各家模型的長處,再猜這個任務配哪個等級才恰當。任務簡單時選了旗艦模型,錢燒在多餘的反覆思考上,一份表格整理可能得多等一會兒才吐出來;任務複雜時選了輕量模型,產出又在半路垮掉,看起來快,事後重做的時間反而更多。這兩種浪費,正是這次更新想收掉的東西。
新滑桿把決策介面換掉。四個檔位對應的是投入程度,不是型號:Perplexity 依你選的檔位決定派哪個模型上場、讓它思考多深。公告裡關於成本的保證只有兩句:低檔位使用比較便宜的模型,點數消耗取決於 Computer 實際執行的工作。再多就沒有了。任何告訴你某個檔位比另一個檔位省幾成、貴幾倍的數字,在官方公告裡都找不到出處。
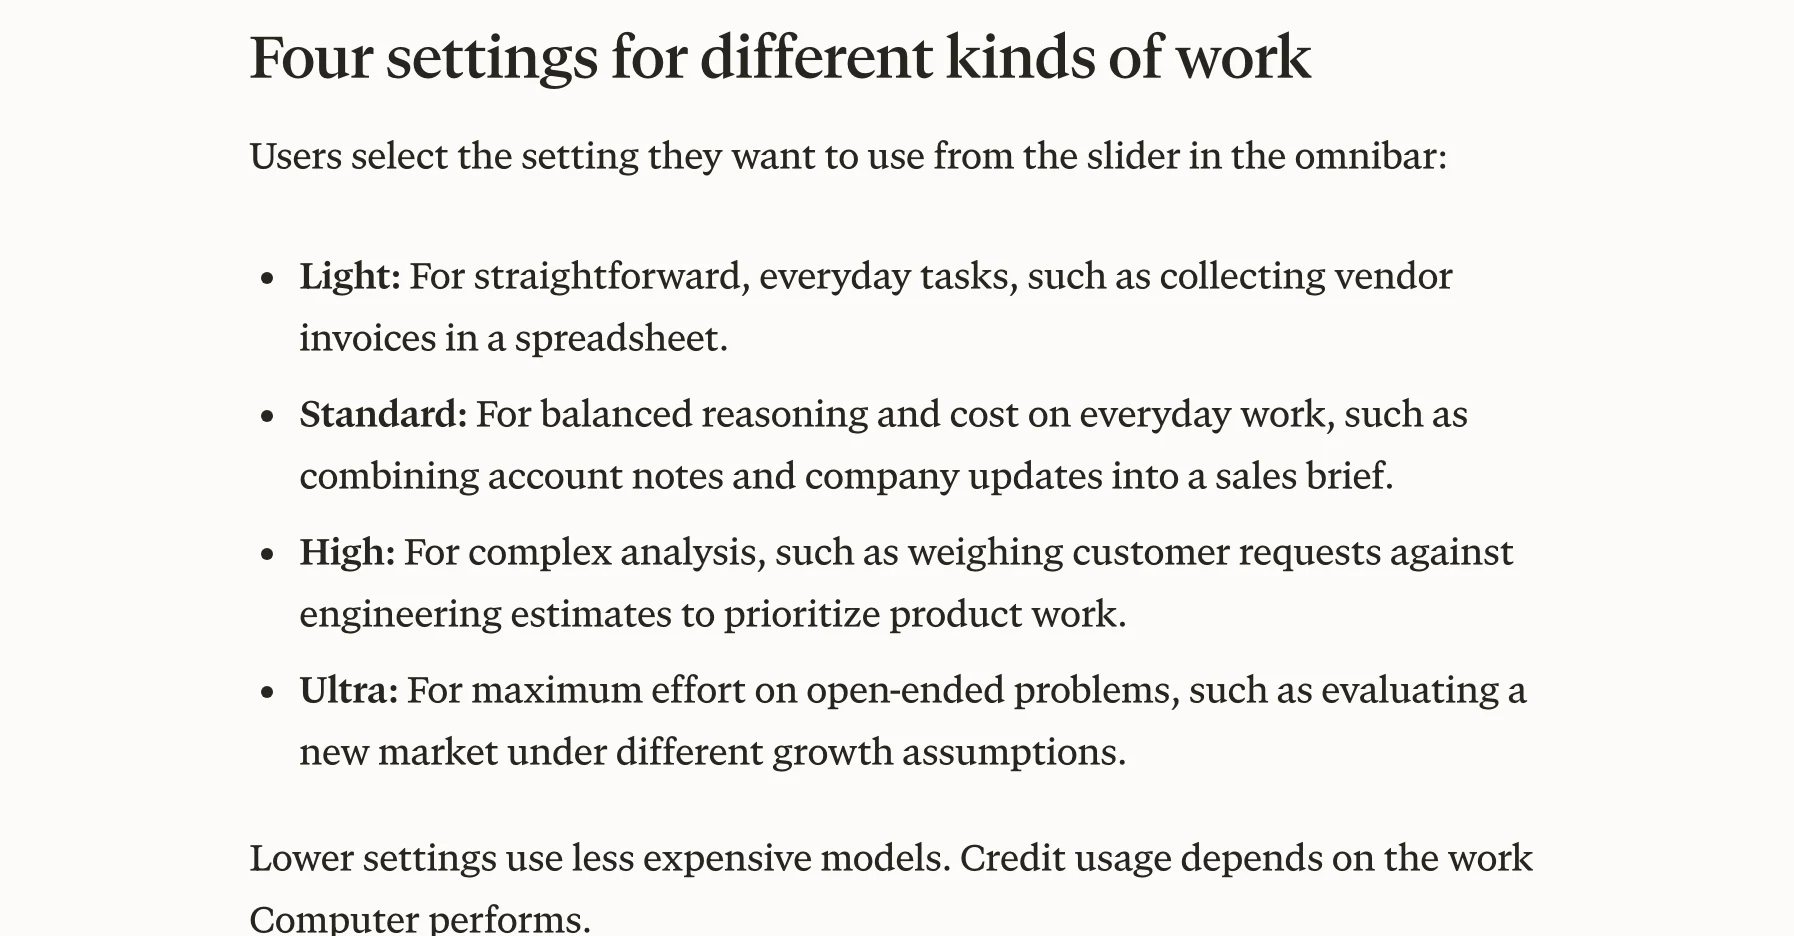
四個檔位在公告裡各有一句定位與一個例子。Light 給直接的日常工作,例子是把供應商發票收進試算表;Standard 在日常工作中平衡推理與成本,例子是把客戶往來筆記和公司動態整併成一份業務簡報;High 給複雜分析,例子是衡量客戶請求與工程估算之後排定產品優先順序;Ultra 給開放式問題的最大投入,例子是在不同成長假設下評估一個新市場。
四個例子放在一起看,檔位之間的分界其實是任務的模糊程度,而非資料量或篇幅。收發票有標準答案,Light 夠用;業務簡報要一點組織力,Standard 上場;排優先順序要權衡多方立場,屬於 High;評估新市場沒有唯一正解,需要多方推演,這才是 Ultra 的位置。同樣是讀十份文件,抽欄位填表跟提出投資判斷就是兩個檔位的事。照這個邏輯選檔,比記型號對應表實際。
官方例子全部來自辦公情境,但檔位的判斷邏輯可以自己搬去別的場域:寫程式的人把批次抽欄位放 Light、重構一個模組放 High;做研究的人把收集資料放 Light、讀完五篇論文寫綜述往 Ultra 靠。本文的建議只有一個問題要問:這件事做錯了,回頭補救要花多少力氣。代價高的往高檔放,代價低的讓機器省著做,這比任何型號清單都好記。
公告對機制的描述只有一段,但結構講清楚了。你設定的檔位決定兩件事:哪個模型負責協調這項任務,以及它推理到多深。接著協調器(orchestrator)決定怎麼拆解工作,把其中一部分委派給支援代理,而這些支援代理可以使用來自不同供應商的模型。多模型的用法就此換了入口:協調層自己分配誰做粗活、誰做需要深想的部分,使用者不必把整個任務押在單一模型身上。
官方還給了一個貼近實務的例子:一份要拿來做重要決策的備忘錄,值得在有人照著它行動之前做更深入的分析。放在舊模式下,你得自己判斷該換哪個模型、推理等級調到哪;放在新模式下,同樣的判斷變成把滑桿往高檔推一下。判斷本身沒有消失,只是從技術語言換成預算語言。
模型配對的依據,Perplexity 自述來自回答數十億次查詢累積的經驗:他們測試不同供應商的模型在不同推理等級下的表現,比較工作品質與成本,當成本較低的組合能做出相當的結果,就把省下來的預算留給真正需要深度推理的任務。這個立場其實是他們一貫的說法,七月的 Model Council 公告裡就寫過,Perplexity 不把使用者鎖在單一模型或單一模型家族裡,而且自稱會替每類工作指派合適的模型,無論是研究、分析、寫程式還是產出素材。系統代選本來就存在,這次真正的新東西是把投入程度變成使用者手上的一個旋鈕。這段是廠商對自家方法的說明,公告沒有附上可供第三方複驗的測試資料,也沒有公布各檔位實際入選的模型名單,採信到什麼程度,讀者可以自己拿捏。
把時間往回撥,同一條 omnibar 上今年 7 月已經出現過另一種多模型玩法。7 月 28 日上線的 Model Council 走完全相反的方向:使用者自己從 OpenAI、Gemini、Anthropic 與開源陣營挑 2 到 8 個模型組成陣容,對同一個問題各自作答,還能自選分析深度,從簡短洞察到詳細報告。系統接著整理哪些模型同意、哪些不同意、各自看到什麼別人沒看到的,甚至能把這份綜合結論直接做成報告或簡報檔。當時官方就把它開放給所有 Max 使用者與 Computer 裡的 Pro 使用者,網頁與手機都能用。
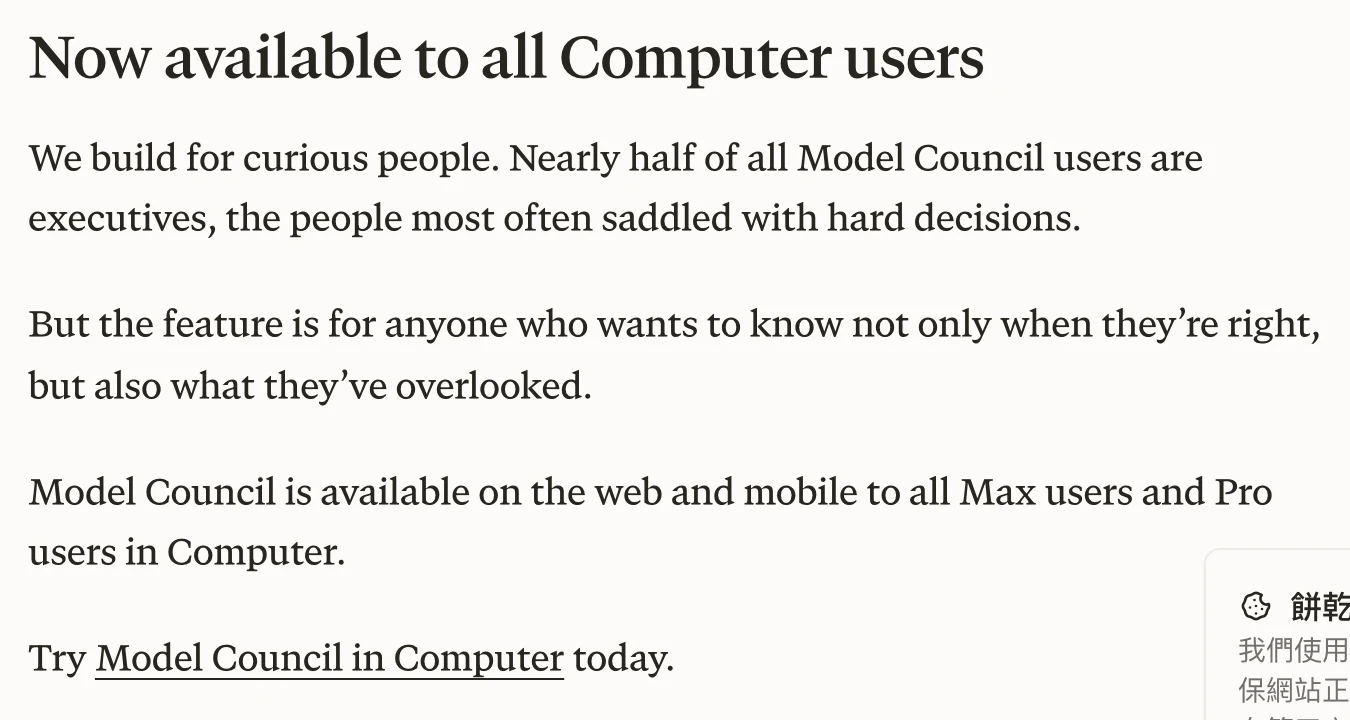
Model Council 的設計邏輯是問分歧:官方自己建議的問法包括問模型會押哪一邊、為什麼的這類對抗性問題,因為模型之間的信賴度落差會暴露不確定性在哪裡。它累積下來的使用場景也偏向判斷型工作:官方示範過法務審賠償條款、策略上自建或外購的問法,列出的熱門場景則橫跨估值、稅務、架構評估到函式庫選型。兩個功能並排放,控制權的兩端就看得清楚。Model Council 把選擇權推到最滿,你自己點兵;努力程度滑桿把選擇權收到最簡,你只說投入多少。前者適合高風險決策,想看模型之間的分歧點;後者適合日常流水,不想管誰來做。Perplexity 兩種都留著,沒有互相取代的意思,這對評估產品方向的人是個可用訊號:模型選擇這件事,正在從使用者的技能變成系統的服務,但手動模式不會消失。
努力程度滑桿現在在 Computer 的網頁版上線,官方對 Android 與 iOS 只說即將推出,沒有給日期,桌面應用程式則連提都沒提。Computer 的可用額度綁在訂閱方案上。依照 9 月 18 日查閱的官方定價頁,Pro 方案限時附贈價值 US$40 的 Computer 點數與擴充存取權,Max 方案限時附贈 US$450 點數與最大使用量。公布的資格條件裡沒有地區欄位,台灣的訂閱者與其他市場走同一套規則,能不能用的分界畫在方案,不在國界。
順著產品線看,這已經是 Computer 今年下半年的一連串動作裡最新的一步。2 月 25 日產品發表,4 月底談工作場景的應用,7 月 28 日 Model Council,8 月下旬再把執行環境往使用者機器搬:Portable Computer 推出後陸續登上 Linux 與 Windows(Windows 版 9 月中跟上),強調檔案不出本機、本機工作不扣雲端點數(我們先前整理過 Windows 版的細節)。這次的滑桿補上雲端這側的另一半拚圖,本機路線顧隱私,雲端路線顧產能,兩邊共用同一個品牌與點數體系。點數的消耗邏輯也要分清楚:本機版的工作不動用雲端點數,會扣點數的是雲端 Computer 實際執行的工作,而滑桿檔位影響的是這些工作用上多貴的模型、想多深,不是另開一種計費名目。
把這次公告沒講的講清楚。四個檔位各自對應哪些模型,官方沒有揭露;點數在檔位之間的倍數關係,官方也沒有給任何數字,唯一確定的是計費跟著 Computer 實際執行的工作走。若讀到省幾成、貴幾倍的數字,先當轉述者自己的推估,別當規格。行動版的推出時間同樣未知,需要等官方再發消息。如果你要拿這些數字做採購決策,等官方文件更新再說。
幾個可以盯著看的回查節點:Android 與 iOS 版跟上時,介面與檔位是否原樣搬進手機;官方未來若公布各檔位的模型組成或點數對照,直接以公告為準;第三方實測(同一任務跑不同檔位比較點數與品質)出現之前,對「省多少」的所有說法都保持懷疑是合理的態度。功能面上線不等於資訊面上線,這中間的空窗就是轉述者塞私貨的空間,也是轉述內容需要打折的地方。
實際使用的判斷可以很簡單。日常的收集、整理、格式化交給滑桿,從 Standard 這個中間檔起步,感覺太慢或太貴再往 Light 降,遇到要權衡判斷的任務往 High 升;真正需要指名模型做對照,或是有合規要求限定特定供應商時,退回自訂控制。滑桿的價值在於把「這件事該花多少」這個你比任何系統都清楚的判斷,還給你。至於推理等級這件事在各家模型生態裡怎麼被對待,可以對照我們寫過的 GPT-6 Astra 提示詞指南裡 effort 參數的角色;代理產品怎麼把工作拆給多個執行單位,Claude 專案重構後的並行執行緒是另一個可供對照的設計。