TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Scira 開發者 Zaid Mukaddam 發布 Amos 1,四款 0.5B 到 27B 的開放權重決策模型以 Apache 2.0 釋出,免金鑰 API 直接回傳選項與機率。官方成績單要逐榜讀:Decision Bench 的 94.9% 與對手區間重疊,typed decisions 排在微軟 Decision-1 之後;免費服務的代價是每筆請求連照片保留 90 天,全家族僅支援英文。
用 AI 摘要這篇文章:
Scira 的開發者 Zaid Mukaddam 在 10 月 14 日凌晨(台北時間 00:13)於 X 發布 Amos 1:四款介於 0.5B 到 27B 的開放權重決策模型,全部採 Apache 2.0 授權,附一個免金鑰、免費的公開 API。所謂決策模型,指的是你先定義好問題與選項,模型讀完案例後直接回傳答案和每個選項的機率,全程不生成任何文字。我實際送了一個客服案例的請求,匿名、沒有註冊任何帳號,答案連同機率照約定回來,回應裡的輸出 token 數是零。
不過這次發布的帳要分兩本看。94.9% 的高分確實在官方成績單上,但那是 27B 的 large 在 Decision Bench 單一榜上的表現,官方自己在同一頁註明頂端名次的區間互相重疊;換到另一個 2,000 題的 typed decisions 測試,large 的 76.1% 反而排在微軟 Decision-1 的 79.5% 之後。另一本帳是免費 API 的交換條件:官方隱私頁明文寫著每一筆請求(含照片)都會被保留 90 天,被選進訓練集的案例留得更久,而且全家族只吃英文。
Amos 的介面只有一個端點:POST /v1/systemone。你送進去的是一個案例(文字、JSON 或照片)加上一組事先命名好的問題,每個問題指定答案的型別,模型逐一作答。官方文件列出六種型別:是非(noul)、單選(choice)、評分(score)、複選(multi)、原文引述(span)與圖片方框(region)。前四種決定答案的值,span 會附上引文在原文中的位置,region 回傳照片上指向目標的方框座標。
官方文件的快速入門示範一次把五種型別裝進同一個請求(方框題需要照片,不在這個信件例子裡):一封說發票被重複扣款 306 英鎊的客服信,同時問是不是要退款、該哪個組處理、急迫程度、信裡提了哪些細節、金額是多少。示範回應裡退款的是非題給 0.992,分派選了 billing 附三個選項的完整機率,急迫程度落在 2.0 附近(圖例從可以等到今天三級),金額用 span 原封不動引回「£306.00」並附上它在原文中的位置。
我自己送的請求拿官網首頁的桌子案例改寫:一張客服來信說桌腳送到時就有裂痕,顧客問能不能只換桌腳。兩個問題一起問,回應裡「問題屬於哪類」選了 damaged_item,機率 0.978;「顧客想要退款」的機率只有 0.144。單選、評分與引述的答案另帶信心值,文件說明這個欄位的算法比照 TypeSafe,用途就是讓程式判斷哪些結果可以直接執行、哪些該轉給人。回應的 usage 欄位把輸入拆成案例本身的 token 和每個問題各佔多少,輸出欄位固定為零。
這種「不寫文字、只回結構化答案」的設計,正是先前 TypeSafe 的 Jev 模型 打開的品類:判斷題交給專用模型,輸出直接進程式,省掉解析自然語言回覆的那一層。Amos 把型別從 Jev 的三種擴到六種,並補上讀照片與標方框的能力。官方首頁的示範區還把同一個介面接到小遊戲上:猜字每次一個請求、貪食蛇每步一個請求,讓「每次判斷都帶機率」這件事變得看得見。
把時間軸拉開看,這場發布其實是分波出貨。Hugging Face 的儲存庫紀錄顯示,最小的 mini 在 10 月 2 日就上架,medium 接在 10 月 5 日,small 和 large 同在 10 月 12 日出現,X 上的官宣貼文則落在 10 月 13 日 16:13(UTC),也就是台北 14 日凌晨。截至 10 月 14 日上午,四個儲存庫合計的下載次數只有 8 次,是剛上架幾天的數字。官宣貼文裡「Decision Bench 94.9% 贏過 Perplexity、Gemini 和 Jev」與「JevBench hard 贏 Jev 十分」兩句,是官宣的兩句話,都出自官方首頁的 Where it stands 成績區塊。
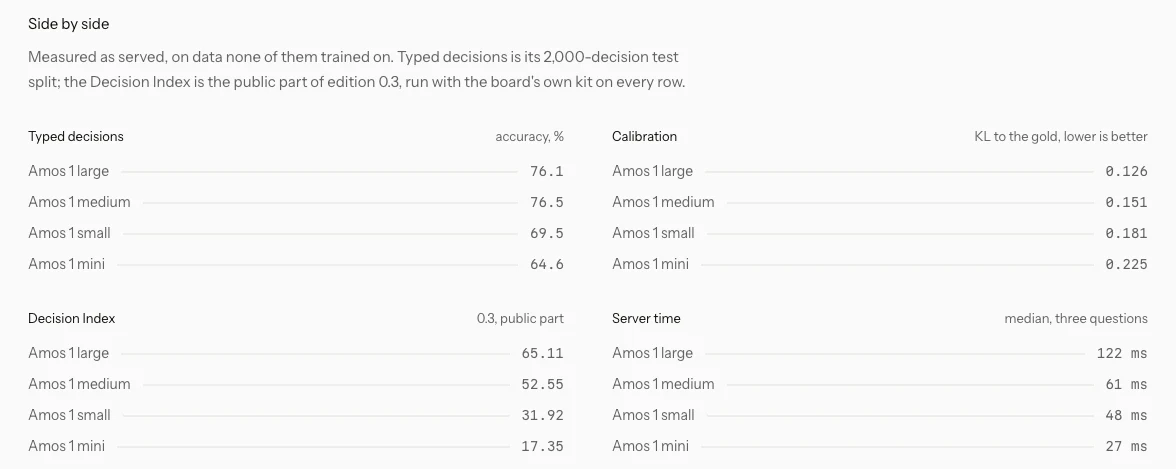
四個尺寸的分工,官方在模型頁的側對側表列得很直白:
| 尺寸 | 參數 | 上下文 | typed decisions | Decision Index 公開部分 | 伺服器回應 |
|---|---|---|---|---|---|
| large | 27B | 128K | 76.1% | 65.11 | 122 ms |
| medium | 9B | 128K | 76.5% | 52.55 | 61 ms |
| small | 2B | 256K | 69.5% | 31.92 | 48 ms |
| mini | 0.5B | 9K | 64.6% | 17.35 | 27 ms |
幾個細節停下來看會有發現。medium 的 76.5% 比 large 的 76.1% 還高,參數翻三倍沒有換到這個測試的分數;small 的上下文反而是全家最大的 256K;mini 標明可以在筆電 CPU 上跑,模型卡給的數字是每個請求約 93 毫秒,也是 API 不指定模型時的預設,而它 9K 的上下文上限代表案例加問題必須塞得進這個長度,長文件場景直接超出它的能力範圍。要照片、引述和方框,官方把這類工作指給 small,並提醒它閒置兩小時後會休眠,喚醒要等一段時間;文件頁寫約兩分鐘,API 的模型清單端點卻寫約一分鐘,兩處的喚醒時間對不上。表格下方另有一行量測說明:分數以實際部署的服務量測,四個模型都沒有訓練過測試內容。
底座的透明度分成兩層。模型卡明白標出 large 基於 Qwen3.8-27B、medium 基於 Qwen3.5-9B、small 基於 Qwen3.5-2B、mini 基於 Johns Hopkins 的 Ettin 400M 編碼器加 Google 的 SigLIP2 視覺編碼器;但 API 的資訊端點裡,large 和 small 的底座欄只填了 runs/ 開頭的內部路徑。同一件事兩種寫法,模型卡與 API 端點對底座的紀錄不一致,以模型卡為準。
官方首頁的「Where it stands」區塊一次列了四個榜,全部讀完會得到和單看官宣貼文不同的結論。
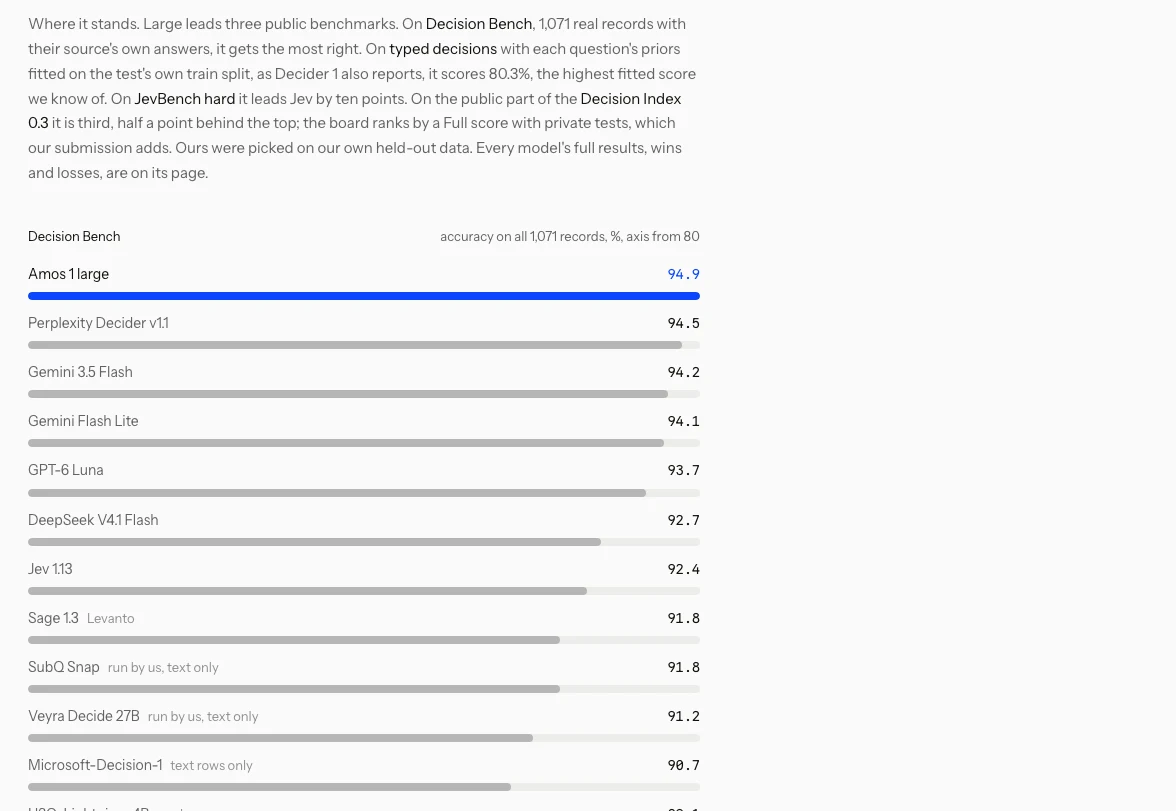
Decision Bench 是開放基準,由開放授權資料集裡的真實紀錄組成,每列附出處、授權與答案。Amos 1 large 在全部 1,071 筆、含照片、用基準自己的評測工具跑的條件下拿 94.9%,Perplexity Decider v1.1 是 94.5%,差距 0.4 分,官方在圖表下方自己註明「頂端區間重疊」。同一張圖裡還有一個對不起來的地方:首頁圖表列 Jev 1.13 為 92.4,large 的模型卡卻寫排行榜列 93.8,官方兩處給了不同的數字。
typed decisions 測試換了一批對手也換了結果。這是 2,000 題、模型沒訓練過的四種工作流測試,large 的 76.1% 排在 微軟 Decision-1 的 79.5% 與 Decider 1 的 76.8% 之後;官方註明對照組是 Amos 團隊自己跑的,Decider 1 的數字是其開發者自報,微軟那個則是它唯一公開的數字。把每題的先驗機率在訓練切分上校正後再測,large 來到 80.25%,Decider 1 是 80.1%,差距又縮到 0.15 分。
JevBench hard 是官宣「贏 Jev 十分」的出處:large 84.7% 對 Jev 1.13 的 74.1%;同一個基準的簡單與標準級,large 都拿了滿分。但到了 Decision Index 0.3 的公開部分,large 的 65.11 排第三,落後榜首 RSI-Jev v6.1 VL 27B 的 65.64 半分以上,官方也說明正式排名還加計只有榜方維護者能跑的非公開測試。
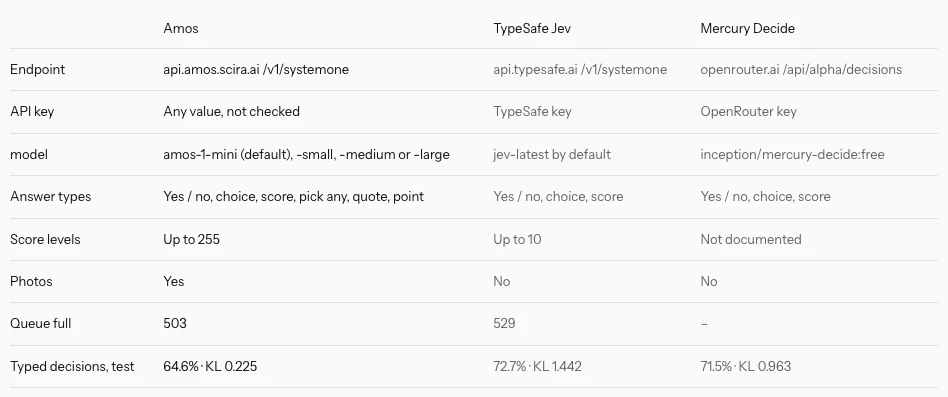
還有一個官方自己擺出來的對照,很容易在轉述中被略過。文件頁末的 System One 介面比較表列了三個同型服務的 typed decisions 成績與校準誤差:Amos 用的是預設的 mini,64.6% 配 KL 0.225;TypeSafe Jev 是 72.7% 配 KL 1.442;Mercury Decide 是 71.5% 配 KL 0.963。也就是說,不指定模型直接打免費 API,準確率輸給兩個對手一段距離,但機率分布校準得比它們準。校準好而準確低的組合,對「高信心直接執行、低信心轉人工」的分流設計反而有用,前提是你接受它答錯的頻率比較高。
照片與方框的能力也有具體數字。官方文件給 small 的成績是在 RefCOCO 照片上把方框中心放在指名物件上的比例約 94%,五個方框裡有四個蓋住物件至少一半;large 模型卡給自己的數字是 91.9% 與 71.3%,mini 則只有一半左右。引述長數字時 large 十題全對、mini 九對,但模型卡也提醒長引述可能被切短。
把四個榜的未擬合數字擺在一起,贏了兩個、輸了兩個;官方首頁自己的總結是 large 在三個公開基準居前,用的是先驗校正後 80.3% 那套口徑。除了 JevBench hard 的十餘分領先,其餘榜上的差距都在幾分之內。要判斷 Amos 適不適合自己的工作,先問自己的問題長得像哪個測試:案例分類與讀照片接近 Decision Bench 的組成,長文件多步驟判斷就該看 typed decisions 和 Decision Index 的臉色。SubQ Snap 在 Decision Bench 圖表裡也有 91.8% 的紀錄,同場競技的決策模型已經排成一排。
隱私頁沒有藏話,開頭就寫「Amos 回答的每一筆請求都會被保留以改進模型」,並明說這涵蓋 playground 和 API 兩邊。被保留的內容包括案例的文字或 JSON、隨附照片、問過的問題和給過的答案,以及哪個模型在什麼時間回答、花了多久。IP 位址不隨請求保留,服務沒有帳號系統。原始請求在 90 天後刪除,被選進訓練集的案例(先移除姓名、信箱、電話、帳號號碼等個人資料)可以留得更久。要刪除特定請求,寫信到 [email protected],附上送出時間和足夠辨識的案例內容。
有一個設計細節寫得相當誠實:與任何公開基準重疊的案例會被排除在訓練之外,官方給的理由是「讓分數保持誠實」。另外官方在訓練前的清洗只保證移除「明顯的個人資料」,文件的例子是姓名與幾種號碼,案例裡的其他敏感內容不在保證範圍。
實際接上程式還有幾道硬限制。每分鐘 60 個請求、同時 20 個、單次請求上限 4MB,超過會收到 429 或 503 並附重試等待時間,官方 SDK 會自動重試。單選、複選與評分題最多 255 個選項。錯誤回應是 JSON,格式錯誤的 422 會指名是哪個問題出了什麼狀況,例如對著沒有照片的案例問方框題。全家族只支援英文,這條寫在文件的 Language 欄;首頁示範區雖然展示了西班牙文、日文等九種語言的客服信分派,官方沒有對中文情境給出任何品質承諾。中文客服信件是不是也能這樣分派,官方沒有給答案,得先用自己的匿名樣本測一輪再說。
四個權重都以 Apache 2.0 釋出,放在同一個 Hugging Face 合輯裡,不需要申請就能下載。每個儲存庫附上自帶的 serve 套件(Python 3.12、PyTorch 2.14,版本鎖在量測成績的同一組),一行 python -m amos.serve 起本機服務,端點格式與雲端一致。代價差很大:large 要一張 80GB 記憶體的 GPU,mini 在筆電 CPU 上就能跑。
介面相容是這次發布另一個實際的影響。Amos 直接說自己講的是 TypeSafe System One API,官方 SDK 不用改程式,換掉 base URL 就能呼叫,環境變數裡 API 金鑰隨便填個 amos,伺服器不檢查。已經在用 Jev 的團隊,把判定工作搬到 Amos 試跑的改動成本接近零;不過 span、複選與方框這三種 Amos 自有的型別,Python SDK 沒有對應的輔助函式,要直接讀原始回應。生產環境要確認實際用上的是哪個版本,可以打 GET /v1/models 看線上服務的模型清單,GET /v1/info 則回參數、上下文與支援型別;既然不指定模型時由 mini 回答,程式裡最好明確寫出要用的版本。官方的對照表也把三個同型服務並排:Amos 六種型別、Jev 三種、Mercury Decide 一種評分,照片支援目前只有 Amos 一家。
想試的人,最快的路是 playground 貼案例,或照文件用 curl 打一個請求,記得先用假資料。要認真評估,拿一批已有人工答案的匿名案例,六種型別各自測一輪,把機率分布和實際對錯對起來再決定門檻,會比看任何排行榜都準。
還不知道的部分也該記下來:開發者 Zaid Mukaddam 先前的作品是 開源 AI 搜尋引擎 Scira,Amos 沒有對長期維護與服務等級做承諾,除了「免費」兩字也還沒有商業模式的說明;排行榜分數會隨各榜更新與競品改版變動,看到的當下記得確認日期。權重已經在手,就算哪天 API 收攤,Apache 2.0 的授權不會跟著消失。