TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

微軟把決策模型 Decision-1 放上 Foundry 與 OpenRouter:端點沿用 system-one 形態、三種問答原語與 Jev 同名,輸入每百萬 token 0.042 美元與 Jev 完全同價。官方自報 36 項基準最準最快,但它引用的公開榜第一名是別家、校準也輸 Jev,接入前先把宣稱層與可核對層分開看。
用 AI 摘要這篇文章:
微軟在 10 月 9 日把一款名為 Microsoft-Decision-1 的決策模型放上 Microsoft Foundry 與 OpenRouter,「決策模型」這個幾週前才由新創打開的品類,大型雲端業者正式踏進來了。真正值得停下來看的不是又多了一顆模型,而是它進場的方式:API 端點直接沿用對手已經跑通的形態,三種問答原語連名稱都一字未改,輸入價格也與品類代表 Jev 完全相同。至於官方宣稱的「36 項基準最準、量測最快」,那是另一層的事,分開讀才不會誤判。
決策模型賣的是一件很小但很普遍的事:給它一段內容和一道有固定選項的問題,它不寫文章、不解釋,直接吐出每個選項的校準機率,讓程式拿去分流、過濾或排序。代理要評估下一步該繼續、停止、重試還是交還給人或模型,客服訊息要判斷給哪個團隊,搜尋結果要按相關性排先後,都是同一種形態的工作。微軟在公告裡算過一筆延遲帳:二十個連續決策每個多一百毫秒,整條工作流就多兩秒,這正是這類模型存在的理由。
時間軸先排清楚。微軟 10 月 9 日在官方部落格 Command Line 刊出公告,由技術長辦公室軟體工程副總裁 Achint Srivastava 署名;Azure 目錄裡的模型資產時間戳記是當天 18:21 UTC,OpenRouter 的上架時間戳也是當天 22:29 UTC,Microsoft Learn 的部署文件也標註同日更新。公告本身在 10 月 10 日又修訂過一次,編者註寫明這次修訂是補上 Jev 的準確度與校準對比,也就是說,最初的版本裡並沒有這家打開品類的對手。
同一週這個品類還有別的動作。九月中旬 Jev 以 API 服務的形式亮相,十月初,開放權重的 Drex 1.5 把權重與量測結果放上程式庫,微軟則在同一週把 Decision-1 推上型錄,而且一次就給到正式版:目錄頁的生命週期欄位寫的是 Generally Available,模型版本 1,不是預覽。
取得管道有兩條。走 Azure 的人在自己的 Foundry 專案裡部署,目錄頁或 Azure CLI 指令都能建 deployment,驗證用 Microsoft Entra ID 或 API 金鑰,計費與治理全部進既有的 Azure 帳務與權限體系,這是微軟對企業採購最實際的賣點;不想綁 Azure 的人可以走 OpenRouter,由 Azure 端點供應,單價相同。模型卡把它歸類為文字分類與零樣本分類,輸入純文字、輸出 JSON,上下文視窗 32,768 個 token,OpenRouter 端的供應狀態顯示近三十分鐘可用率百分百。
打開官方部署文件,最顯眼的細節藏在路徑裡:決策 API 的端點是「資源端點加上 /providers/microsoft/v1/systemone」。system-one 是 Jev 對自家快速判斷介面的稱呼,文件甚至自己寫明「請求模式類似 system-one API」。請求的骨架同樣是 state 加 questions:state 放待判斷的內容,純文字或 JSON 都行,連「訊息加客戶聯絡次數」這種混合結構都可以;questions 放一或多道有固定選項的問題,模型一次跑完,每道題回傳型別化的數值結果。
三種問題原語的名稱與 Jev 完全相同,連 Jev 體系特有的 noul 一詞都原封不動:
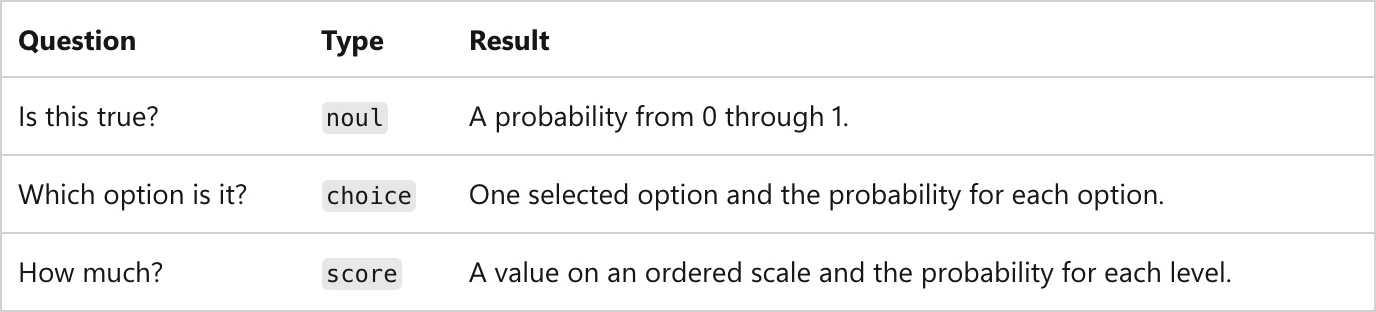
| 問題形態 | 原語 | 回傳內容 |
|---|---|---|
| 是非題 | noul | 0 到 1 之間的機率值 |
| 單選題 | choice | 選中的選項,加上每個選項各自的機率 |
| 量表題 | score | 序列尺度上的數值,附每個等級的機率 |
noul 適合當閘門與過濾器,例如某則回覆是否承諾退款、某段輸入是否藏了提示注入;文件建議在 true 與 false 各寫一句判準,讓邊界案例更精確。choice 負責分類與路由,例如工單該給帳務、工程還是一般支援,回傳會附上每個選項的機率,最高機率偏低時就是該轉交給人或另一個模型的訊號。score 做排序與評等,回傳值是各等級索引的機率加權平均,四級量表會落在 0 到 3 之間,可以停在兩級中間,文件也提醒它是相對排序工具,別當絕對的校準評等用。同一份 state 的多個問題可以併在一個請求裡,一件工單同時問派單單位、嚴重程度、是否重複來訊,省請求數也讓判斷脈絡一致。
微軟文件沒有明說「與 Jev 相容」,但對已經照著 Jev 的三原語寫好分流邏輯 的團隊來說,端點名稱、請求骨架、原語名稱三件事湊起來,遷移成本接近只改 base URL 與金鑰的程度。有個實作面的細節要注意:請求裡的 model 欄位填自己的 deployment 名稱;底層模型名會出現在回應的 model 欄位,例如 microsoft-decision-1。錯誤碼表也一併公布,從 400 的問題定義無效、403 的權限不足到 429 的限流都有對應建議,限流的建議是指數退避重試。
這個選擇本身就像一次表態:決策模型的介面慣例已經有人先畫好了,微軟決定站在慣例這邊。
價格是另一處對齊。公告的定價段寫明:輸入每百萬 token 0.042 美元,輸出免費。對照 TypeSafe 現行文件,Jev 1.13 的牌價是每十億 token 42 美元、換算每百萬 0.042 美元,輸出同樣免費。兩家數字一字不差,很難當巧合看,更合理的解讀是微軟直接把對手的定價當基準點,把競爭推回品質、速度與治理面。輸出免費對這類模型特別合理:它本來就不生成文字,輸出只有一組機率數字,計費重心天然落在輸入。
部署形態有兩種。DataZoneStandard 把推理處理留在靠近應用的資料區域,僅在精選區域提供;GlobalStandard 使用全球產能,延遲可能較高或較不穩定。文件同時提醒:部署類型不保證較低延遲,要用自己的工作負載實測。有一個採購面的小坑值得記下:Azure 目錄模型卡的價格欄寫著「供應商未提供」,也就是說走 Azure 目錄看模型卡的人查不到價格,價格只出現在公告與 OpenRouter 頁面,走企業採購流程的人要自己把這頁文件釘進採購單。
公告的核心宣稱是:36 項基準的比較中準確度最高、量測中最快,比第二名 H2O-Lightning-4B v1.1 快 2.5 倍,比 GPT-6 Sol 快 35 倍。內嵌比較表的原始數字,節選幾組對照:
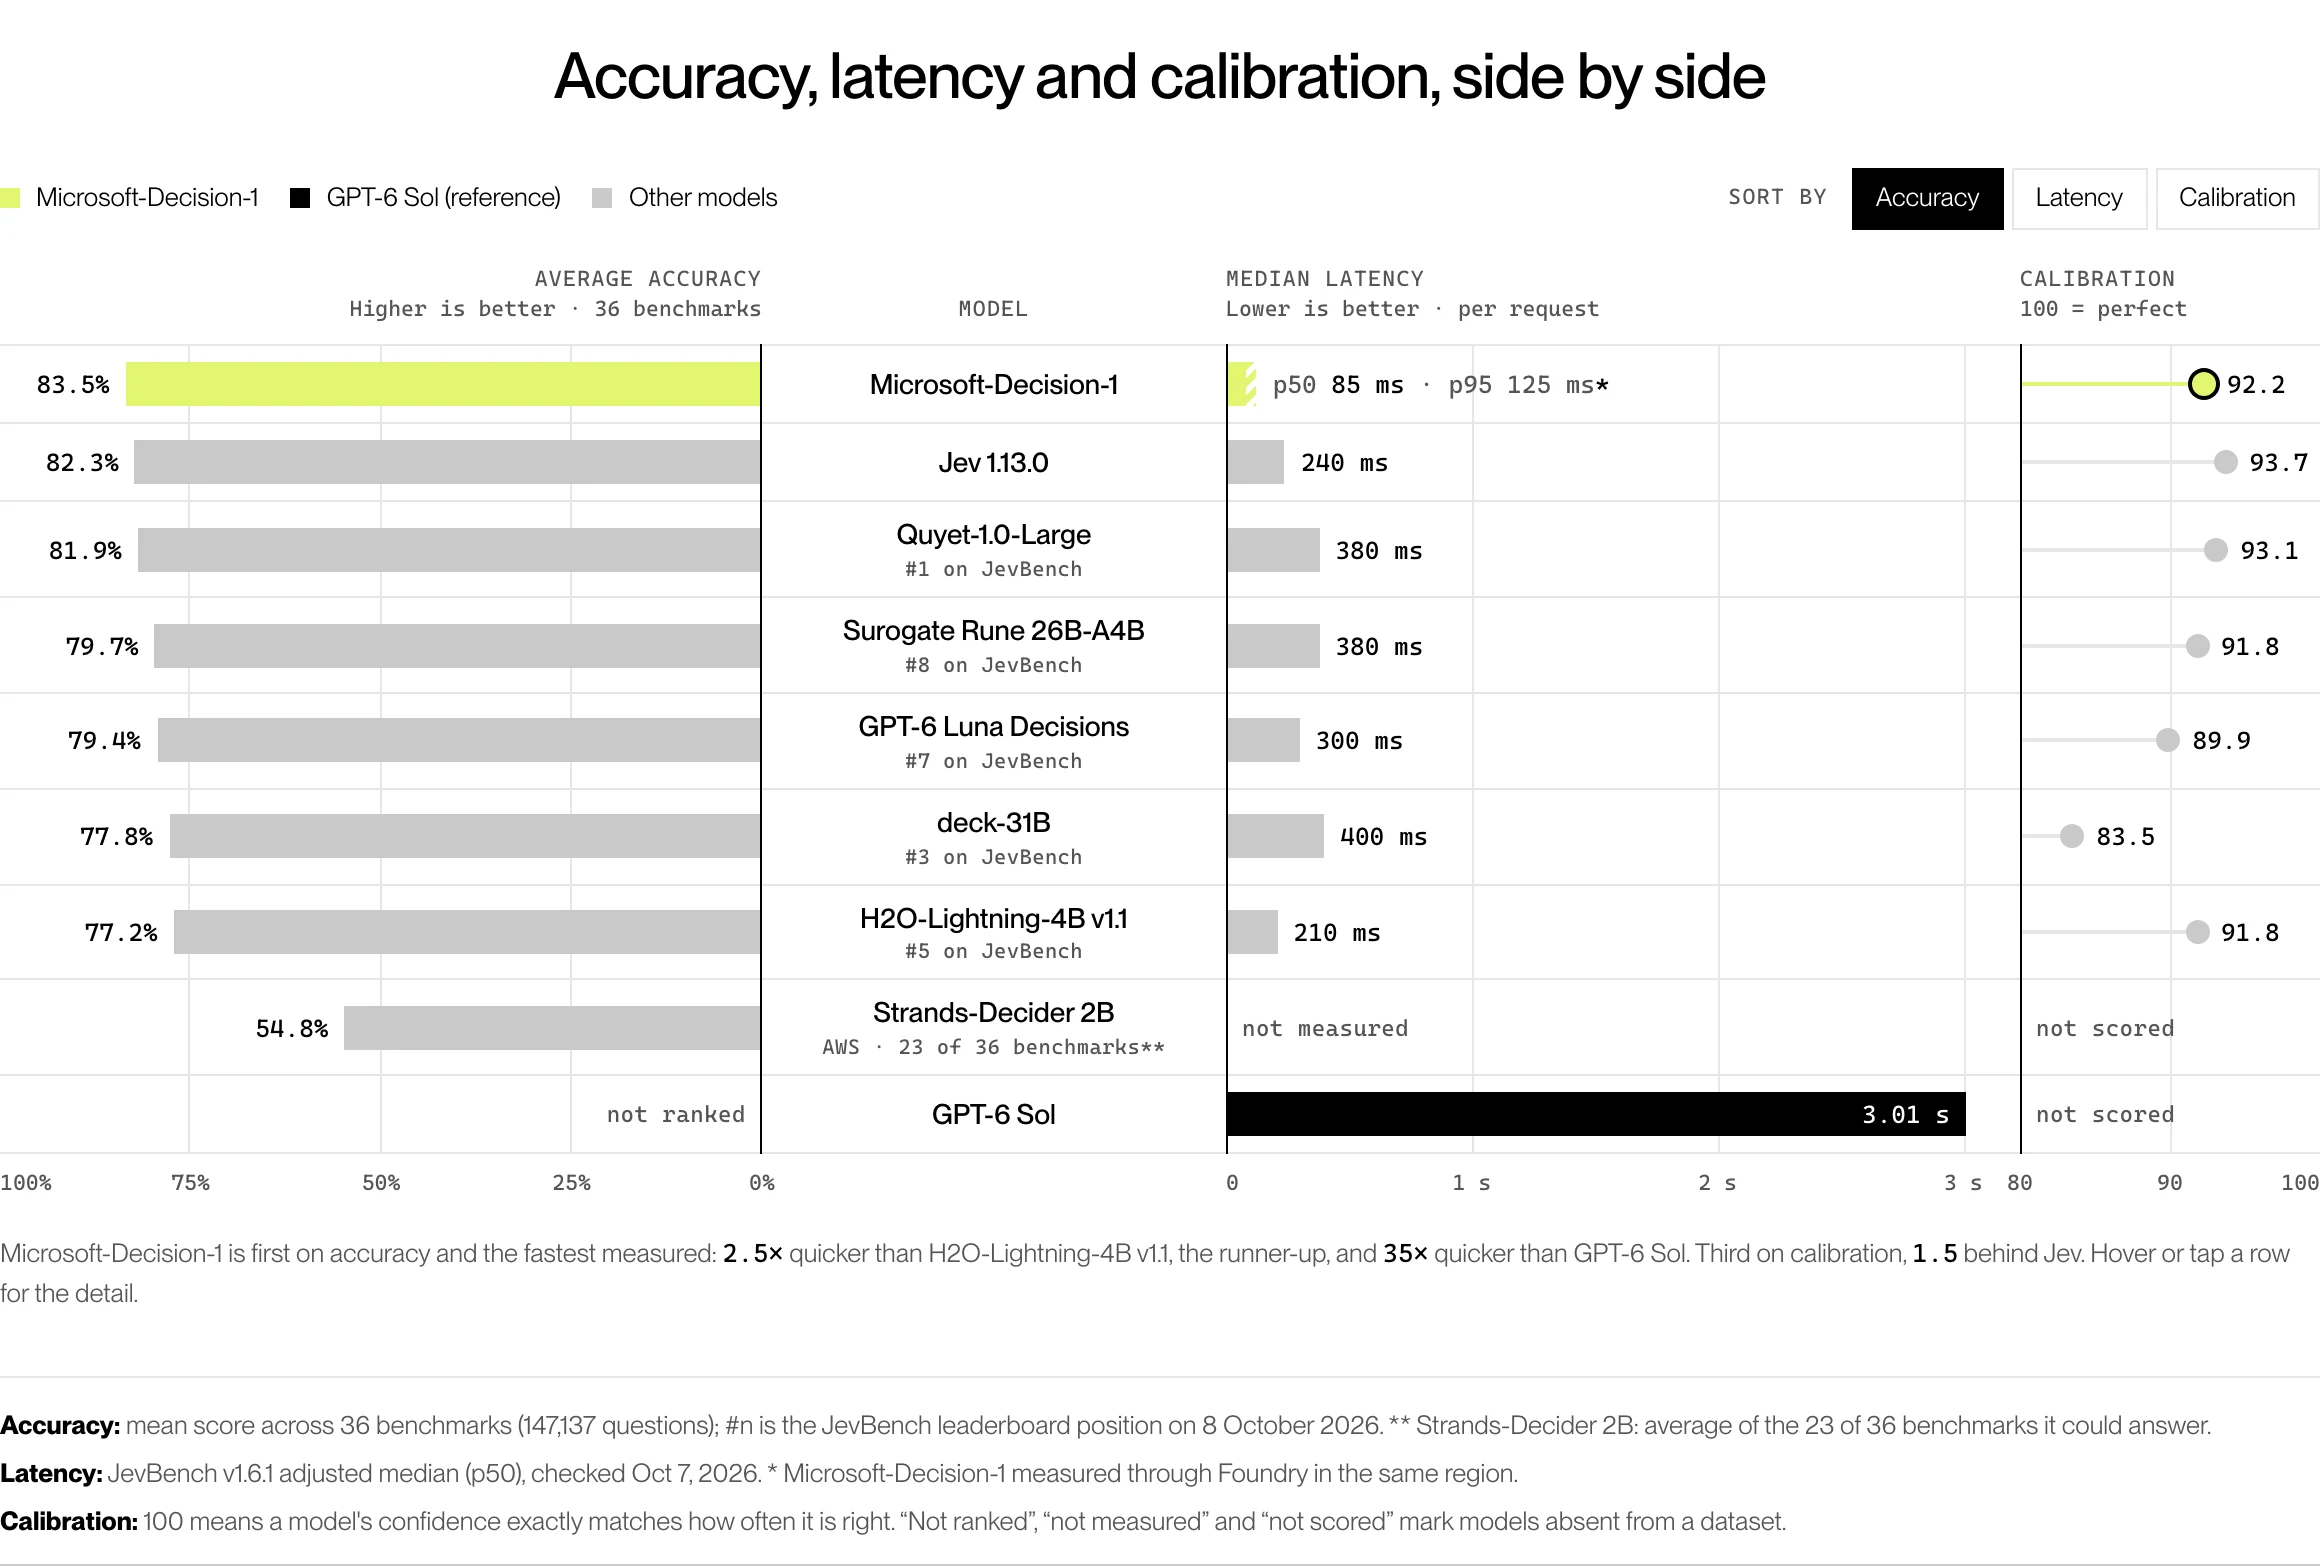
| 模型 | 平均準確度 | 延遲中位數 | 校準分 |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85 毫秒 | 92.2 |
| Jev 1.13.0 | 82.3% | 240 毫秒 | 93.7 |
| Quyet-1.0-Large | 81.9% | 380 毫秒 | 93.1 |
| H2O-Lightning-4B v1.1 | 77.2% | 210 毫秒 | 91.8 |
| GPT-6 Sol | 未列 | 3,010 毫秒 | 未列 |
這張表要拆開看。最外層是考卷本身:36 項基準是微軟自選的組合,含公開與私有基準,共 147,137 道題,官方說這些基準對訓練保持盲測,但選哪些、怎麼組合,決定權都在出題方手上;公告原表墊底的 Strands-Decider 2B 只在 36 項裡答得了 23 項,分數是照可答的子集算的,比較口徑並不整齊。再看榜位:表上每個模型的 JevBench 榜位是 10 月 8 日的快照,而那張公開榜的第一名是 Quyet-1.0-Large,在微軟自選套件上它拿 81.9,低於微軟的 83.5;換句話說,「最準」的範圍限定在微軟自己出的這份考卷,在它引用的公開榜上,第一名是別人。剩下的是校準分(信心與實際答對率的吻合程度,100 為完美):微軟排第三,92.2,落後 Jev 1.13.0 的 93.7 有 1.5 分,而校準恰恰是「敢不敢讓它自動化」的最直接依據。順帶一提,公告原本連 Jev 都沒排進比較,是 10 月 10 日修訂才補上的。
延遲數字也有出處註記:量測來自 JevBench v1.6.1 的調整後中位數,10 月 7 日核對,微軟自己的數字經 Foundry 在同區域測得。85 毫秒對 3,010 毫秒的差距是真的,但 GPT-6 Sol 在表上掛的是「參考組」,本來就不是為單次快速判斷設計的模型,拿生成模型當速度對照,行銷意義大於工程意義。對延遲敏感的真實對手是 210 毫秒的 H2O-Lightning 與 240 毫秒的 Jev,領先幅度是 2.5 倍與 2.8 倍這一級。表上另一個名字是 OpenAI 的 GPT-6 Luna 決策模式,79.4 分、300 毫秒,OpenAI 自己的開發文件也有 decisions 指南,這個品類的戰線已經同時有新創、開源社群與微軟、OpenAI 兩大 AI 業者。
穩健度與安全的量測同樣是官方自報:同一請求做八種擾動,決策翻轉率平均 1.3%,改寫選項描述、反轉或打亂選項順序時翻轉為零;安全面測了 5,250 個請求、11 項基準,宣稱拒絕有害行為同時保有可用度。內部案例的倍數更響亮:XBOX Research 用它處理逾萬則問卷、商店評價與社群意見,品質與 GPT-6 Sol 相當,單則分類從約 2.6 到 2.8 秒縮到 143 到 188 毫秒,每則成本從 1.03 到 2.92 美元降到 0.005 到 0.013 美元;Copilot 團隊的回應品質測試與 GPT-5.6 Luna 相當且快 100 倍;Microsoft Discovery 的評分一致性是 LLM 評分的 46 倍,自適應計畫修訂快了近四倍。這些都是自證案例,測量方法與原始資料都未隨文公布,引用時掛「官方自報」四個字是底線。
模型卡把血統寫得很直白:底座是阿里巴巴的開放權重 Qwen3.5-9B,由微軟後訓練,訓練期間 2026 年 9 月到 10 月,訓練資料是經微軟開放資料流程處理的公開資料集加自產合成資料,並預告之後會換到微軟自家的 MAI 與 OpenAI 模型上重建。對手 Jev 並未揭露底座,這一點上是微軟罕見地比新創更透明;換底座的預告也意味著現在的成績單有保存期限,重建之後的分數要重新驗。
能力清單上有幾項官方明列、但容易被速度數字蓋過的:依據輸入證據評估回覆是否站得住腳的接地評估、對 AI 回覆與代理動作按準則給分的評等、以及明確的棄權設計,選項裡可以放一個「無法判斷」,證據不足時讓模型棄權而不是硬選。
紅線也列得完整。它不設計用來生成文字、開放問答、對話、翻譯或摘要;沒有封閉問題與固定選項的任務、需要輸入以外知識的任務都不在範圍內。更重要的是三條治理邊界:不得作為信用、就業、住房、保險、教育、醫療、法律權益等重大決策的唯一自動決策者;不得用於監控、剖析或追蹤個人;模型為純文字、不產出解釋或理由,選項怎麼定、門檻怎麼設、什麼時候交給人,責任全在串接的應用端。文件另列四項已知限制:可能繼承底座與訓練資料的偏誤;分數會受問題措辭與選項排序影響,措辭不良的問題照樣會回傳分數;校準在熟悉的任務型態上最強,模型不提供解釋、可能依賴過時知識;當安全過濾器用時,可能漏掉細微的有害內容,或誤判無害內容。
真的要試,文件裡的最佳實務清單比多數第三方意見更貼近採用場景,可以拆成五個動作:
對台灣的開發者,現實的路徑有 GlobalStandard 與 OpenRouter 兩條,DataZoneStandard 的精選區域清單要另行確認。市場的變動速度也是要納入的變數:Jev、Drex、微軟在一個月內先後進場,價格已經被釘在同一個點上,下一輪分野大概會出現在換底座之後的品質與企業治理整合度。採用前把測量日期標在引用旁邊,這個品類的數字保鮮期以週計。