TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
xiaozhi-esp32 是 30,254 星的 MIT 開源專案,用 ESP32 開發板自組小智 AI 聊天機器人。本文逐項核對 repo 實數:48 個廠商目錄、128 個板型目錄、40 種介面語言含繁體中文、OTA 以 MAC 與 UUID 上報身分;官方 xiaozhi.me 免費用 Qwen 即時模型,自架有四個社群伺服器,先選路線再買板子。
用 AI 摘要這篇文章:
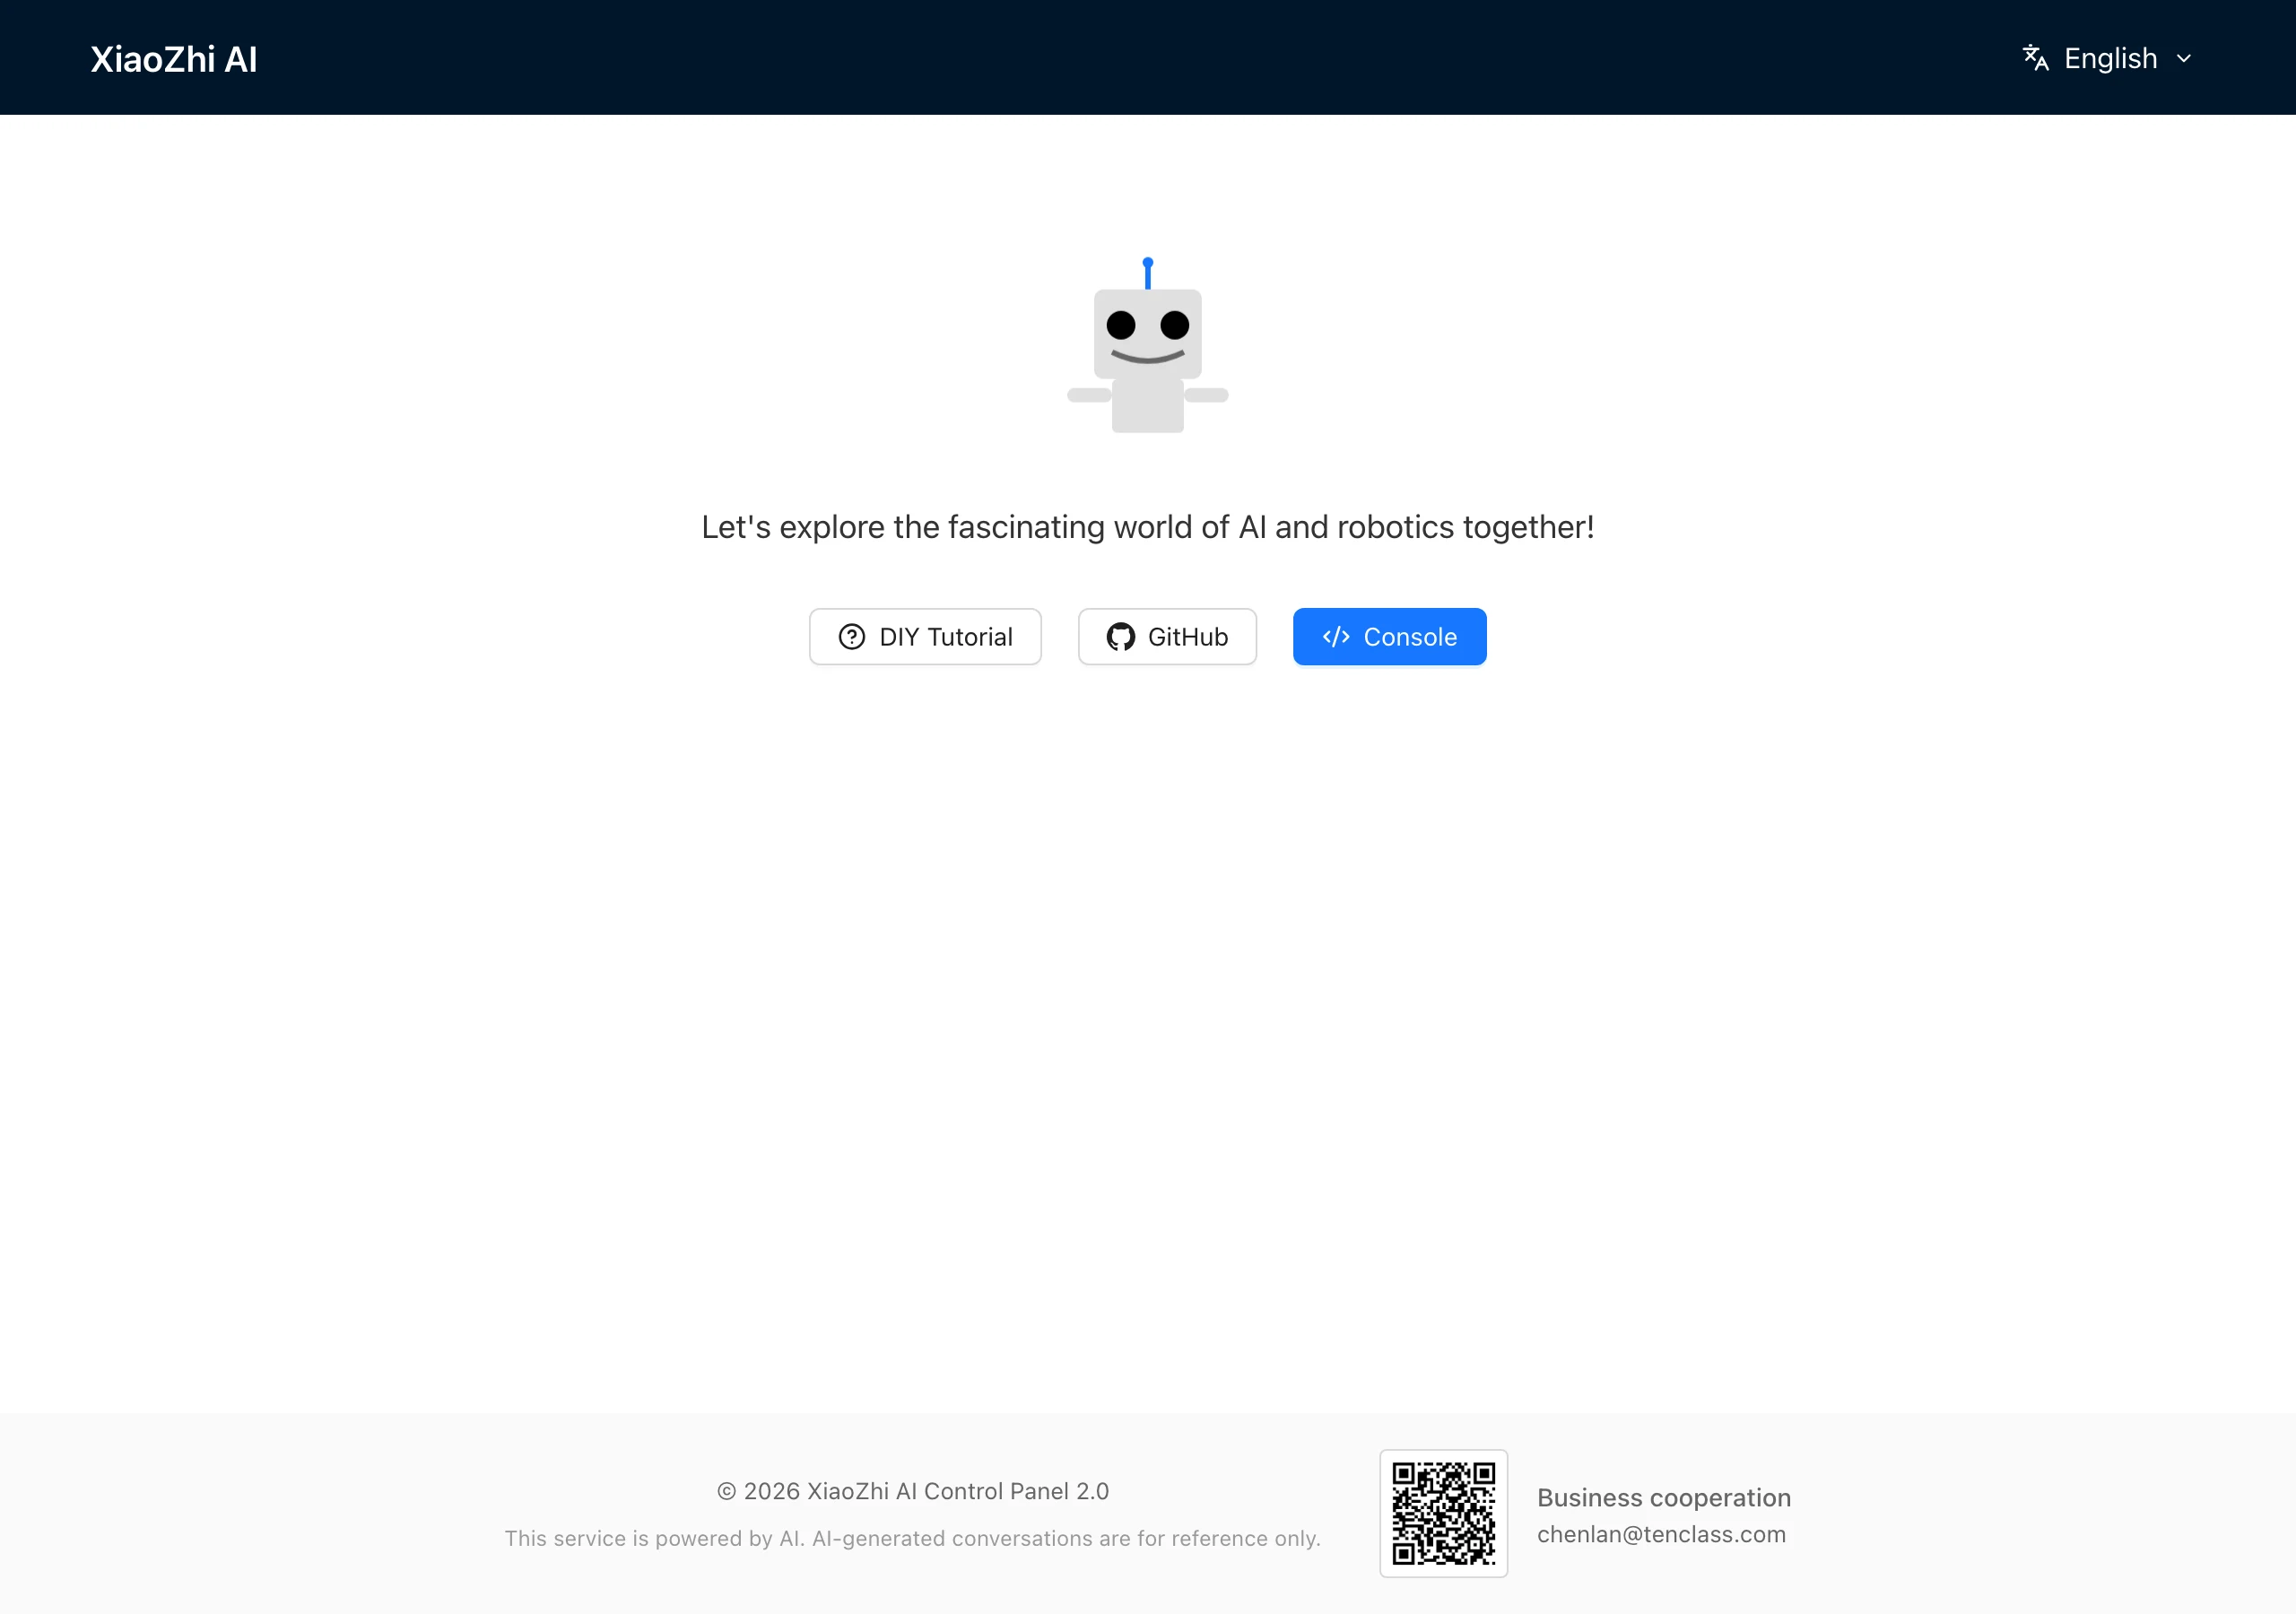
把 AI 語音助理做成一台拿在手上的實體裝置,2026 年的入門材料費是一張 ESP32 開發板加上收音和發聲模組。xiaozhi-esp32 是這條路上目前最受矚目的開源專案:GitHub 上有 30,254 個星、7,073 個 fork,MIT 授權連商業使用都開放,2026 年內已經出到第七個正式版。官方網站 xiaozhi.me 首頁做得清爽,一隻機器人吉祥物配三個按鈕:DIY 教學、GitHub、控制台,頁尾掛著「© 2026 XiaoZhi AI Control Panel 2.0」與商務合作信箱,信箱網域屬於 tenclass 家族,和韌體連線的 api.tenclass.net 同源,營運主體的線索就藏在這種細節裡。
不過在把板子放進購物車之前,更該先答三個問題:這台機器的腦子要放在哪裡、板子怎麼挑、說出去的話去了哪。三個問題的答案都寫在 repo 的原始碼與檔案結構裡,其中幾個數字官方文件自己都對不上。
韌體出廠的預設行為,是連上作者的 xiaozhi.me 官方伺服器。README 寫得直接:個人使用者註冊帳號,就能免費用 Qwen 即時模型。這是零成本路線,代價要分兩層看。
第一層是資料流向。對話的運作方式是裝置把收音內容編成 Opus 音訊串流,送到伺服器做語音辨識、跑大型模型、合成語音再傳送下來,等於整段對話的音訊都離開你的桌子。配套的身分申報寫在原始碼裡:韌體每次檢查更新時,ota.cc 會帶上 Device-Id(網卡 MAC 位址)、Client-Id(板子 UUID),有序號的機種再加 Serial-Number,連介面語言代碼都隨請求送出。這不是推測,是第 60 到 71 行逐行看得到的行為;同一套檢查更新的機制,在本站先前實測的桌面版用戶端上,就是伺服器下發連線端點與憑證設定的通道,韌體這端的用途一致。
第二層是條款。我想核對官方伺服器的隱私條款時發現,xiaozhi.me 是單頁應用,/terms、/privacy、/about 三個路徑拿到的都是同一個 1,969 位元組的空殼,條款內容在純 HTTP 層驗不到。搭配先前的發現:這個後端在 repo 與文件裡都找不到隱私條款。想走免費路線的人,信任只能建立在「作者開源、社群盯著」這個事實上,而不是一份可引用的承諾。
自架路線把這兩層都翻轉。README 的 Related Open Source Projects 段落官方列出四個伺服器專案:xinnan-tech 的 Python 版、joey-zhou 的 Java 版,加上兩個 Go 語言實作。語音辨識與模型對接全部搬進自己的機器,資料不出家門,模型金鑰自己組態;交換條件是你要選一套、架起來、持續維運,升級與安全都自己來。對話引擎本身有兩種模式可選:傳統的辨識加模型加合成管線,以及 Realtime 端到端語音模型,硬體支援 AEC 的機種還能全雙工邊聽邊說,這些能力面官方文件寫得完整,速度與品質取決於各板硬體與自架機器,官方文件也未提供基準數字。
雲端還有一條延伸線值得知道:專案支援雲端 MCP,讓伺服器端的模型可以呼叫智慧家庭、電腦桌面操作、知識搜尋、郵件之類的外部工具,擴充性強,代表權限邊界也更大。對話過程預設走 WebSocket,也能改用 MQTT 加 UDP 的混合傳輸,配網則用熱點或 BluFi 藍牙配網,甚至有 ML307、EC801E 這類 4G 模組的上網選項,做行動裝置的彈性是有的。自架時等於這些能力都由自己把關。
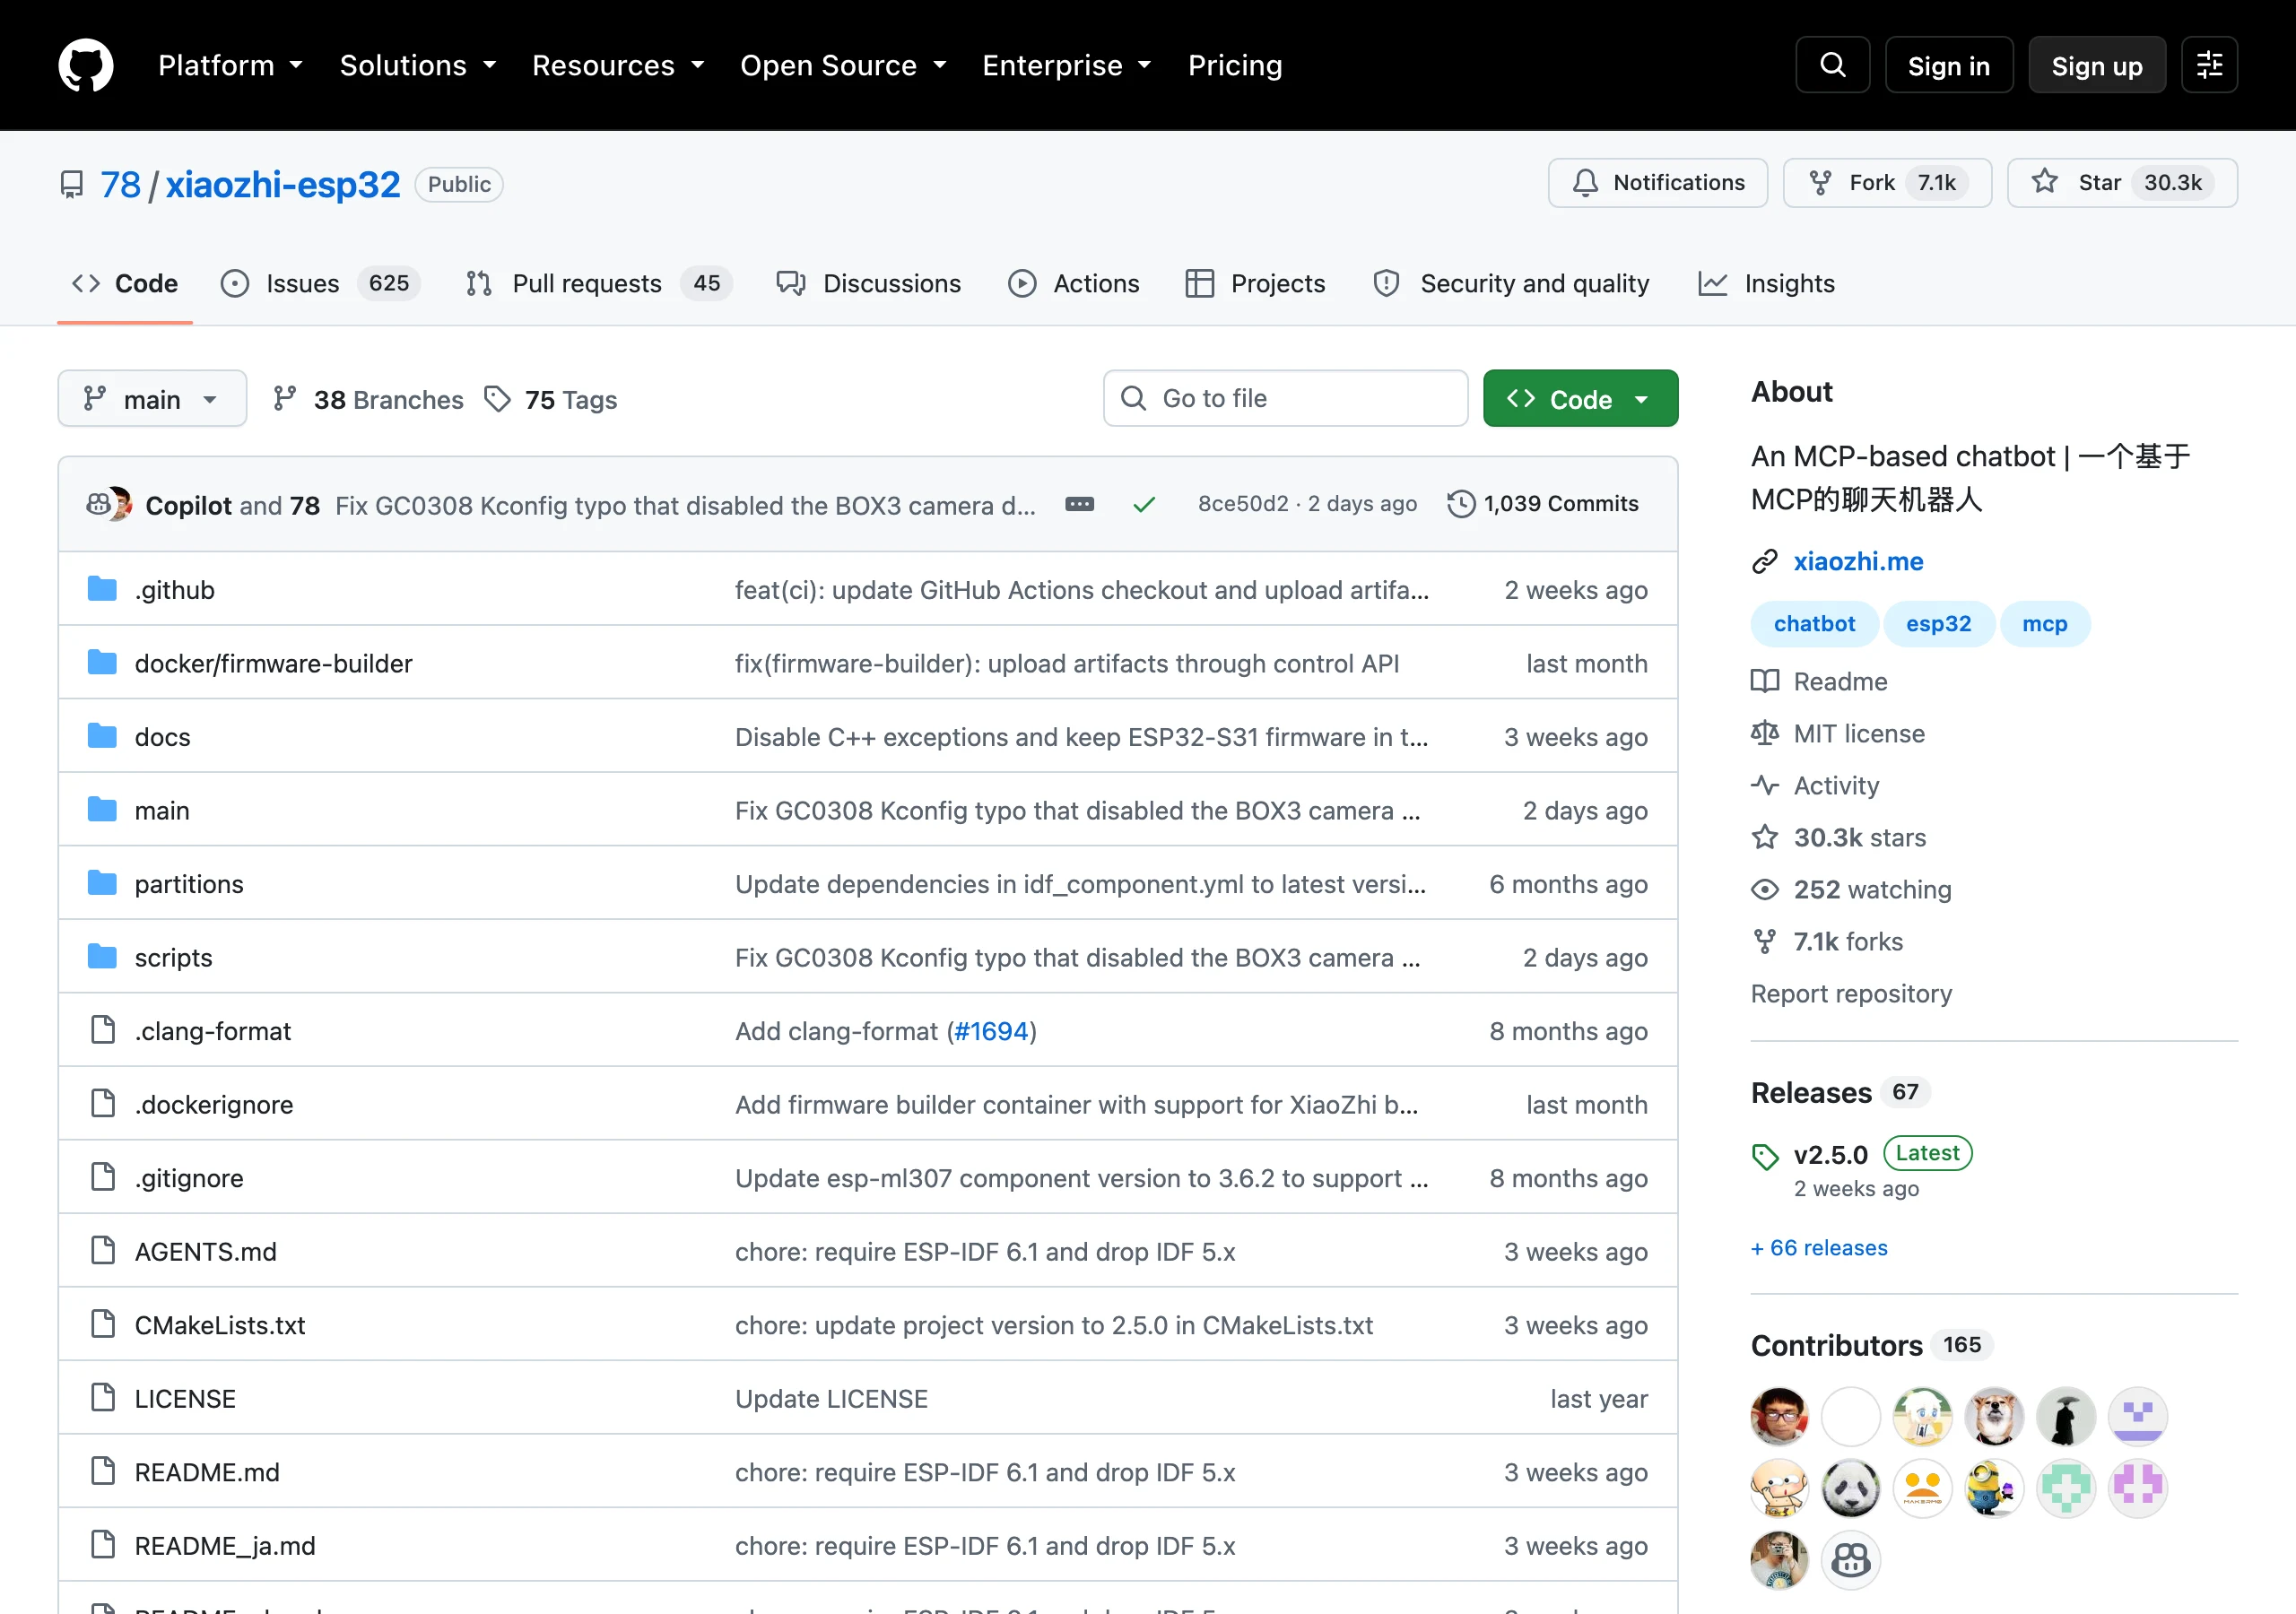
README 說支援 138 個板型目錄、171 種發布變體。我把 2026 年 9 月 28 日 main 分支的完整檔案樹抓下來數:main/boards 之下是 48 個廠商目錄、151 個 config.json,其中 Waveshare 一家就占 42 種設定,Espressif 官方板 16 種、M5Stack 12 種。用板型目錄同一個口徑去數是 128 個,和官方宣稱的 138 對不上;151 個變體設定檔離官方的 171 也有一段距離。板型支援還在爆炸成長,文件跟不上。
對照組是介面語言的數字。README 英文版寫 39 種介面語言,中文版寫 38 種,而 main/assets/locales 資料夾實際放著 40 個 language.json,三個數字各說各話。好消息藏在細節裡:40 個語言檔包含 zh-TW 繁體中文,介面有繁中可用,對本地自組者是實質加分。
挑板子的實務建議因此很單純:不要照著某一篇舊教學買,先到官方維護的「小智 AI 百科」文件查你手上或想買的板型有沒有進支援清單。入門有兩種姿態,一種是麵包板路線,開發板加模組自己接線,成本最低、最有學習感;另一種直接買 M5Stack CoreS3 這類整合好收音喇叭與螢幕的成品開發板,貴一點但少掉接線除錯。兩種都能走免開發環境燒錄,官方明確建議新手先不下載 IDE,用現成韌體就能開機。
板子上還有一批容易被忽略的硬體能力,README 的功能清單都列了:OLED 與 LCD 螢幕能顯示表情和情緒,部分機種支援相機做視覺輸入,電池電量顯示與電源管理也在架構裡,晶片平台從便宜的 ESP32、ESP32-C3 一路到 S3、P4 都涵蓋。想把機器做成桌伴、掛飾甚至機器狗,社群裡都有現成板型可用,這是買成品 AI 玩具拿不到的改造空間。
要留意的是開發路線的門檻在 2026 年年中墊高了:現版專案要求 ESP-IDF 6.0.1 以上、建議 6.1,ESP-IDF 5.x 已明確不支援。網路上 2025 年的教學多半以 5.x 為基底,照著做到環境這步會直接卡死,這是自組者最常見的第一個坑。
燒錄這步也有對帳動作。每個正式版的發布頁會為各板型配上各自的韌體檔,180 個資產就是這樣來的,下載時要對準自己板型的檔名,不是抓最新就好。板型支援由建置腳本 scripts/build.py 的清單驅動,板型有沒有被排進這一版,看清單比看文章快。
隱私要拆成兩層看,這個專案在兩層的表現不一樣。
喚醒層在本地。esp_wake_word.cc 用 Espressif 的 ESP-SR 引擎,喚醒詞模型放在裝置的模型分割區,離線判斷「你好,小智」,不依賴網路,這是晶片原廠的成熟方案,也代表最靈敏的那段監聽不需要連線。想換喚醒詞有兩條路:官方提供線上工具 assets generator,喚醒詞、字型、表情、聊天背景都能在網頁上編輯訓練,方便,但訓練這一步要過雲端服務;原始碼裡另有一條 custom wake word 路徑,會把喚醒音訊編成 Opus 上傳判斷,等於喚醒判斷外包給伺服器。自訂的彈性和資料邊界,在這裡是同一個開關的兩面,值得在第一次燒錄前就想清楚。
對話層在雲端。依專案的設計,裝置把收音編成音訊串流送上伺服器,辨識、推理、合成都在那一端完成。README 的功能清單還列了說話者辨識,引用的 3D Speaker 是 ModelScope 上的開源聲紋模型,能分辨現在講話的是誰;換句話說,送出去的音訊在架構上足夠做聲紋層級的處理,家裡每個人對它說的話,理論上都能被分開歸檔。語音模型的清單則在 xiaozhi.me 控制台裡,需要登入才看得到,免費額度有多少、模型有哪些,註冊前無從核對,只提醒一件事:介面語言有繁中,不等於語音辨識聽得懂台灣口音,兩層要分開判斷。早期介紹文宣稱支援國語、粵語、英語、日語、韓語五種識別,那是 2025 年初的伺服器配置,現在的清單以控制台為準。把這兩層疊起來,家庭情境的取捨就清楚了:喚醒詞在晶片裡判斷,平常在家講話不會上傳;一旦開口對話,整段音訊加上「現在是誰在說」的判斷都送到伺服器端,家裡有小孩或習慣對著機器聊天的人,這條界線要自己畫。
專案活躍度不假。v2.5.0 在 2026 年 9 月 10 日發布,附帶 180 個韌體資產,比二月那版的 125 個成長近一半,數字本身就是板型支援膨脹的軌跡;往前 8 月、7 月各有一版,main 分支最新修正落在 9 月 26 日,累積約一千個提交。issue 每天有人開也有人關,9 月 26 日當天仍有維護者關單與併入修正,內容從攝影機驅動設定拼錯到顯示緩衝區邊界都有,看得出是在修真問題而不是表演式更新。670 個未關議題對 30,254 星的專案屬健康水位,多半是板型支援請求與個別硬體的疑難。專案從 2024 年 8 月底建立,兩年長成這個規模,也難怪文件追不上。
這種節奏的另一面,就是前面那些對不上的數字:語言 38 對 39 對 40、板目錄 138 對 128、五語識別的舊宣稱。結論不是專案不可信,而是自組者該把信任放在 repo 與官方百科文件這兩個會動的來源,靜態 README 的數字看過就好。好消息是韌體更新走空中下載,板子燒好之後跟版不需要重接線,跟版的成本是注意力,不是工具鏈;壞消息是開發環境的要求一年內抬過一次(ESP-IDF 5.x 到 6.x),未來再抬一次也不意外,想長期玩的人要有心理準備。
材料費之外,真正的成本是時間。自組一台能對話的機器,要經歷挑板、接線或組裝、燒錄、配網、綁帳號或架伺服器五段流程,第一次跑通通常是一個週末的事;如果這個投入本身對你就是樂趣,它是便宜的玩具,如果不是,它只是比較費工的智慧音箱。
如果讀到這裡的結論是「想先試試看」,有兩條不買板子的路。同生態的 py-xiaozhi 是桌面版客戶端,Windows、macOS、Linux 都能跑,代價是啟動同樣要綁 xiaozhi.me 帳號,本站先前實測過它的綁定與資料流向,安裝包以百 MB 計,想理解這套生態的信任結構可以先讀那篇。另一派玩法是拿現成的小米智慧音箱刷機改造,open-xiaoai 專案做過完整的兩層級示範;預算壓在 5 美元附近、想跑另一套 OpenClaw 生態的,MimiClaw 也用同一顆 ESP32。
自組路線真正的獨賣點,是桌面版做不到的裝置端 MCP:模型可以直接控制喇叭、LED、伺服馬達與 GPIO 腳位,官方文件還提供了物聯網控制的協議說明。做一台會依情緒轉頭的桌面機器人、讓模型控制房間燈光,這類把 AI 接到實體世界的實驗,就是這個專案存在的教學目的,README 自己也說希望幫助更多人理解 AI 硬體開發。
真要自組,順序建議倒過來:先決定伺服器路線。在意語音出門又不想管機器的人,這個專案兩邊都不站,買成品 AI 音箱比較快;能接受官方免費路線的人,直接免環境燒錄最快;要條款透明與資料自主的人,選一套自架伺服器再挑板子,別讓順序顛倒,因為板子相容性最終跟著你選的伺服器版本走。挑好板子、燒好韌體之後,第一件事是把雲端 MCP 的外部工具授權清單看一遍再開啟,這台會聽、會說、還能操作其他設備的小機器,權限開多大,責任就開多大。