TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Perplexity 把 8 月只在 NVIDIA DGX Spark 上的本機 agent 環境 Portable Computer 帶到 Windows:GeForce RTX 或 RTX PRO 顯示卡 24GB VRAM 起跳、Pro 或 Max 訂閱才能啟用。本機完成的工作不耗 Computer 點數,內容要送上雲端前會先徵詢同意,顧問模型只拿到核可後的摘錄並只回文字建議。
用 AI 摘要這篇文章:
台北時間 9 月 14 日深夜,Perplexity 在官方部落格宣布 Portable Computer 登上 Windows:這套 8 月底首先搭在 NVIDIA DGX Spark 上的本機 agent 環境,現在裝進既有的 Perplexity Windows 應用程式,用你自己的 RTX 顯示卡跑。模型、agent harness、orchestrator、scheduler 全部改在使用者的 Windows 裝置上執行,檔案與查詢留在本機,本機完成的工作不消耗 Computer 點數。NVIDIA 同日在自家部落格發出對應公告,等於兩家官方來源互相背書了這個時間點。
這則更新跟大多數人的距離,卡在兩道寫得非常明白的門檻:顯示卡必須是 VRAM 24GB 以上的 NVIDIA GeForce RTX 或 RTX PRO,帳號必須是 Pro 或 Max 訂閱(個人與企業方案都可以)。兩者缺一,Windows 應用程式裡就不會出現這套本機引擎。官方公告沒給的東西也一樣明確:沒有支援顯卡型號的白名單,沒有寫 Windows 版本要求,DGX Station 的支援只寫了一句 expected to come soon。以下內容以官方公告與研究文件刊載的版本為準。
Perplexity 的 agent 產品線叫 Perplexity Computer,負責規劃並執行多步驟任務,原本的推理全在雲端。Portable Computer 是它的本機版本:同一套 agent,換成在使用者自己的硬體上跑。今年這條線的推進節奏可以用三個日期講完。
| 日期 | 產品動態 | 推理位置 |
|---|---|---|
| 7 月 28 日 | Personal Computer 登上 Windows 桌面 | 雲端(可碰本機檔案、連結應用程式與網頁) |
| 8 月 25 日 | Portable Computer 首發,僅限 NVIDIA DGX Spark,首版為 Linux | 本機 |
| 9 月 14 日 | Portable Computer 開放 Windows PC(GeForce RTX 與 RTX PRO) | 本機 |
前後差異值得說清楚。7 月底那版 Personal Computer 已經讓雲端 agent 能在 Windows 桌面上工作,碰本機檔案、操作連結好的應用程式,但思考過程發生在 Perplexity 的機房;9 月 14 日這次,思考過程整包搬進使用者自己的機器,NVIDIA 的公告同時寫明,這一步疊在既有的 DGX Spark 與 Linux RTX PC 支援之上。官方公告的用字是,模型、agent harness、orchestrator 與 scheduler 完全在 Windows 裝置上執行,這也是「本機完成的工作不耗點數」這句承諾的來源:算力是你的顯示卡出的,帳單結構自然跟著變。
至於 8 月首發的 DGX Spark,是 NVIDIA 的桌面級 AI 電腦,Grace Blackwell GB10 平台、128GB 統一記憶體,定位本來就不是一般消費者會買的機器。這次 Windows 版的意義正在這裡:入場券從一台特定設備,換成一張高階消費級顯示卡。
24GB VRAM 是這次公告裡最硬的一條線。市售主流顯示卡的記憶體多落在 8GB 到 16GB,等於直接把大多數遊戲卡與幾乎所有筆記型電腦排在門外,官方文件只給了 VRAM 這一個判斷標準,沒有列出型號清單。想確認自己的卡夠不夠,Windows 內建工具就查得到:工作管理員、效能、GPU,看「專用 GPU 記憶體」的數字是否在 24.0GB 以上。之前介紹過的 Can I Run AI 硬體自查教學,同樣的判斷流程也適用在這裡。
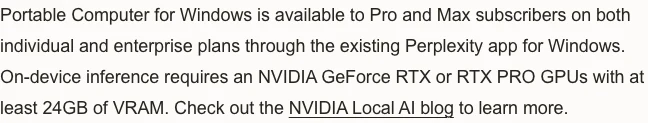
第二道門檻是訂閱。官方公告寫明 Portable Computer for Windows 開放給 Pro 與 Max 訂閱者,個人與企業方案皆可。以 9 月中從 Perplexity 定價頁看到的數字,年繳方案分別是每月 17 美元與 167 美元,兩個方案當時都掛著限時加贈 Computer 點數的促銷。換句話說,就算推論用你自己的電、跑你自己的卡,這套 agent 環境本身仍是訂閱制服務,harness 的維護、連接器與模型微調都包在費率裡。
點數規則是這次更新對成本結構影響最大的部分:本機完成的工作不計入 Computer 點數,把任務升級到雲端(前沿模型、Perplexity Search 之類)時才會動用到點數額度。對每天要跑大量例行任務的人,這等於把「敢不敢讓 agent 跑整夜」的問題從計費焦慮裡拿出來。如果你偏好更徹底的自架路線,之前介紹過的 AgenticSeek 開源本地 AI 助手是另一種用顯示卡換掉雲端月費的選擇,代價是環境要自己顧。
隱私架構是這套產品最值得盯的部分,可以拆成三層來看。第一層是預設:檔案、查詢與 agent 活動留在 PC 上,8 月的公告把整個堆疊列得很細,orchestrator、planner、tool router、scheduler、durable task queue、本機搜尋索引,全部在使用者裝置上。
第二層是上雲的閘門。本機 27B 級模型碰到需要即時資訊或更強推理的步驟時,可以把任務升級到雲端,對象是 Perplexity Search 或 15 種以上的前沿模型。關鍵規則寫在兩份公告的同一個位置:當任務需要把任何內容送出裝置,Portable 會先徵詢使用者同意才繼續。研究文件對這道閘門給了更細的設計:升級前,harness 會挑選相關上下文、用 PII 分類器標記敏感資訊,並把即將離開裝置的內容攤給使用者看;雲端那端的顧問模型只拿到核可後的內容,只回傳文字建議,碰不到你的檔案、工具或對話紀錄。要不要啟用升級、每次手動批准還是自動放行,也都由使用者決定。
第三層是沙盒。工具與程式碼執行被關在作業系統層級的隔離沙盒裡,對檔案與連結應用程式的存取按政策管制;研究文件特別強調一個設計選擇:沙盒不可用時,harness 會在任何工具呼叫前先把自己停用,拒絕降級成無沙盒執行,這點與 Pi、Hermes 這類開源 harness 預設以使用者權限直接跑指令的做法明顯不同。NVIDIA 的公告則補充 Windows 版使用 Perplexity 自家的 SPACE 沙盒,並附帶內建瀏覽器。要誠實標註的邊界是:以上三層都是官方對設計的描述,實際攔截與隔離效果,還需要等第三方檢驗。
先花三十秒把幾個名詞講白。agent harness 是 agent 的外框工程:管理送給模型的提示詞、把大任務拆成步驟、維護多步驟之間的狀態、在出錯時觸發自我驗證。orchestrator 則是調度核心,Perplexity 的研究文件特別強調這個核心由確定性程式碼實作、語言模型不在其位,負責維持執行迴圈與強制政策,模型只負責提議下一個動作,真正的工具呼叫由 orchestrator 在沙盒裡執行。看懂這個分工,就會明白「harness 與模型一起設計」為什麼是這套產品的核心主張:小模型撐不起為大模型設計的複雜外框,外框就得反過來配合小模型的能力曲線。
這條路也不是九月才開始走。Perplexity 在六月就提出過第一個混合本機與雲端的推論 orchestrator,決定哪些工作該留在裝置上、哪些該交給雲端 agent;八月的 DGX Spark 版是把整個堆疊放上單機的第一步,這次的 Windows 版再把同樣的架構帶到消費級硬體。雲端、專用機、通用 PC 這三步在三個月內走完,節奏比多數人預期的快。
Windows 版把「排程」搬進了本機。官方給的例子是物流公司的財務人員:每天早上讓 Portable 在授權資料夾裡對帳,把每張貨運發票對上承運商的本機費率表,標記重複收費或偏離合約的項目,產出一張待處理清單,註明每筆異常與建議的爭議動作。發票與費率資料從頭到尾不出公司裝置。NVIDIA 版公告另外給了一個更貼近個人理財的例子:把兩年份的券商對帳單與報稅資料交給 agent,讓它找出哪些重複持有的部位在製造最多可避免的費用與稅負,而且每個數字都標註出自哪個檔案的第幾頁,過程中沒有任何一份文件進到聊天機器人。這類每天重複、資料又敏感的流程,正是零點數本機推論最能發揮的場景。
連接器的官方清單,Windows 公告列了 Gmail、Outlook、Slack 與 GitHub,NVIDIA 版的公告另外列出 OneDrive、Word 與 Google Drive。Windows 公告另外給了一個工程師場景:讓 agent 對照本機程式碼庫審視 GitHub 上待處理的 pull request,分成可合併、待審、卡住、過期幾類,工程師確認摘要與行動項目後,agent 再把結論貼到團隊的 Slack 頻道並標記負責人。更往外延伸的機制是 MCP:Portable 透過跑在 Windows 裝置上的本機 Model Context Protocol 伺服器,連接其他桌面應用程式,讓本機模型把那些應用程式的工具與資料納入自動化流程,官方舉的例子是設計師把 Portable 接上本機安裝的設計軟體,讓 agent 直接改檔案,模型、原始檔與操作全程留在本機。
模型選擇上,9 月的公告點名的是 Qwen 3.8 27B,一個為 Perplexity Computer 後訓練、針對 RTX 最佳化的本機模型;8 月的 DGX Spark 版本還提供在其基礎上再後訓練的 PPLX 27B,Windows 版選單是否同步列入,公告沒有逐項寫。Perplexity 在 8 月的公告也預告過 30B 的 Nemotron 3.5 Lightning 會進到模型選單,時間同樣只寫了即將。安裝流程壓得很低:下載 Perplexity Windows 應用程式後,在模型下拉選單裡選好模型,一鍵下載權重就能開始。8 月首發時連聽寫都放在本機,用的是 NVIDIA 的 Nemotron 3.5 ASR 模型,對著文件口述交代任務,語音與轉文字都不經過雲端。
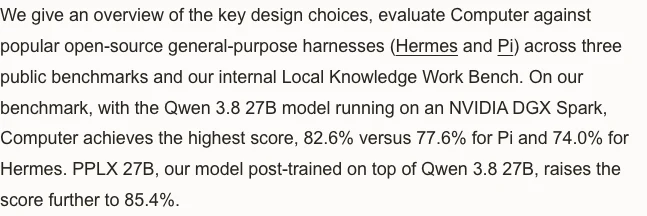
本機模型的能力定位,Perplexity 在 8 月 25 日的研究文件裡給過完整成績。在自建的 Local Knowledge Work Bench 上,這是 53 項日常知識工作任務的基準,同樣跑 Qwen 3.8 27B 的情況下,Perplexity 的 harness 拿到 82.6%,高於通用開源 harness Pi 的 77.6% 與 Hermes 的 74.0%;換上後訓練的 PPLX 27B,分數再上升到 85.4%。這組數字的量測平台是 DGX Spark,Windows RTX 版目前沒有對應數字,比較時要記住這個前提。
更值得看的是程式開發端的差距。在 89 項任務的 Terminal Bench 2.1 上,純本機的 Qwen 3.8 27B 拿 59.6%;讓它適時向 Claude Opus 5 顧問求援,分數升到 73.0%,每次任務估計花 0.415 美元的 API 費用;整個任務直接交給 Claude Opus 5 跑是 82.4%,每次 0.65 美元。官方自己下的結論是,顧問模式用約三分之二的成本,拿回約五分之三的差距,而這筆交易什麼時候值得,決定權在使用者手上。這組數字也把產品邏輯講白了:日常雜務交給本機免費跑,遇到硬骨頭才花錢問雲端。
harness 本身有幾個為小模型量身打造的設計,可以當成判斷這類本機 agent 好不好用的參考。Qwen 3.8 27B 的上下文視窗雖有 260K,官方實測超過 100K 後表現開始衰退,所以核心提示詞與工具集保持精簡,其他能力做成按需載入卸載的技能模組,對話太長時自動摘要壓縮;連接器也不是以肥大的 MCP 定義塞進上下文,而是改寫成精簡的命令列工具。這些工程選擇換來的,就是小模型在長流程裡的穩定性。
DGX Station 的支援只寫了 expected to come soon,沒有日期。Nemotron 3.5 Lightning 進駐模型選單同樣只有一個即將,8 月的公告就先預告過,至今仍在路上。價格與點數規則也會動:本文引用的年繳費率與限時加贈點數,是 9 月中定價頁的快照,限時促銷結束後歸零,實際費用以官方頁面現值為準。另外,24GB 門檻擋下的大量中階卡使用者,官方沒有給任何降級方案或量化模型選項,要不要等更輕的版本,目前沒有承諾可等。

硬體達標的人,流程很短:先照上面的方法確認 VRAM 到 24GB,下載 Perplexity Windows 應用程式,登入 Pro 或 Max 帳號,在模型選單裡一鍵下載本機模型,之後在設定裡就能啟用本機引擎。第一次下載權重會占不少硬碟空間,建議留意安裝磁碟的餘量。
顯示卡不到 24GB 的人,現實一點的替代路線有三條。留在 Perplexity 生態內,雲端版的 Computer 功能不受這道門檻限制,代價是點數計費與資料上雲;想徹底本機又願意自己動手,開源自架的 agent 方案一直都在,從先前介紹過的 AgenticSeek 到手機上離線跑 LLM 的 Google AI Edge Gallery,隱私邏輯相同,工程量不同。至於為了這個功能專門升級顯示卡值不值得,把年繳訂閱費、點數用量與一張 24GB 卡的價錢放在同一張紙上算,答案會因人而異,官方顧問模式那組數字(0.415 對 0.65 美元)可以當計算的起點。