TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

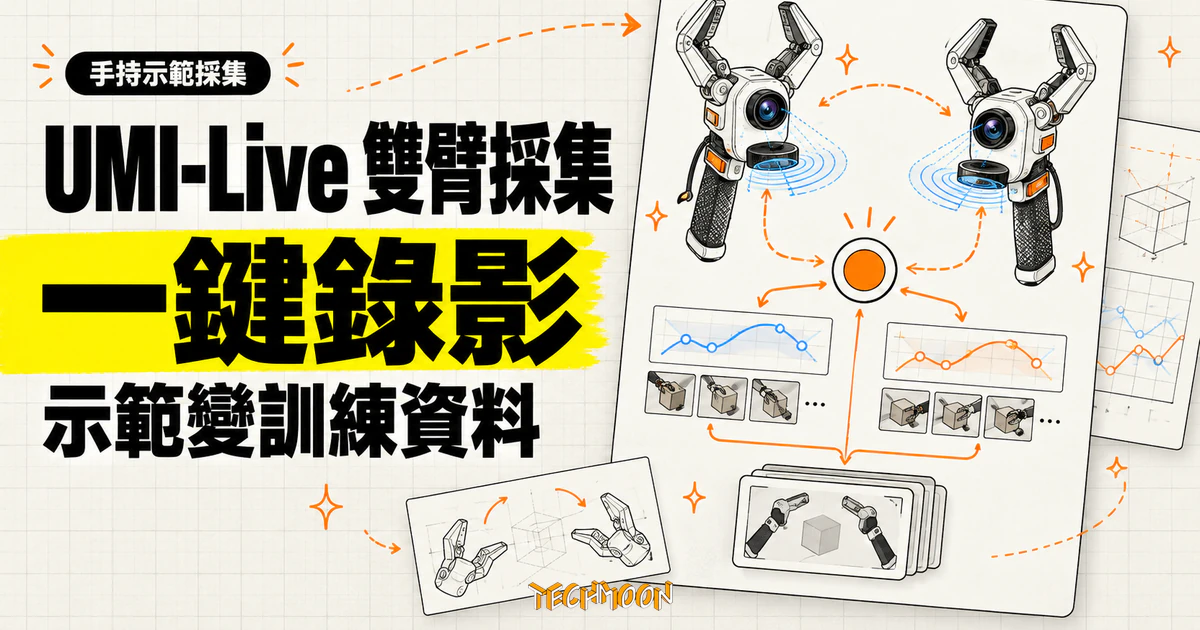
UMI-Live 於 10 月 29 日發布論文並開源整套雙手示範採集系統:兩支自帶相機、LiDAR 與電池的手持夾爪按一顆鍵錄影,後端自動跑 SLAM 重建並產出 LeRobot 資料集,同時釋出 3,255 段約 39.7 小時示範資料與一對 1,930 美元的硬體設計。
用 AI 摘要這篇文章:
機器人研究團隊 AfterQuery Research 與 Yale、CMU、UPenn、Harvard 的合作者,在 10 月 29 日提交論文、10 月 30 日公開宣布一套名為 UMI-Live 的開源系統:兩支自帶相機、光達(LiDAR)、算力與電池的手持夾爪,按一顆錄影鍵就能收集雙手示範,後端伺服器自動把錄影重建成可直接訓練的資料集。團隊同時釋出 3,255 段、共約 39.7 小時的示範資料,以及一對約 1,930 美元的硬體設計,論文獲 CoRL 2026 UMI Arena Workshop 收錄。
這套系統延續的是 2024 年 UMI(Universal Manipulation Interface)提出的路線:讓人拿著手持夾爪做示範,代替遙控機器人收資料。論文回顧這條線時寫得具體:用腕上相機畫面加上重建出來的夾爪軌跡訓練策略,確實能執行有難度的任務,包括雙手任務;後續也有人嘗試不同的感測、追蹤與夾爪設計,但重現這些系統需要清楚的硬體組裝與校正說明,加上能把資料接進訓練的軟體。新論文在摘要裡把還沒解決的部分講得很直白:拿這些示範來訓練,仍然需要一致的硬體設定、校正流程與資料處理。UMI-Live 補的正是這一段,把雙手採集、後端處理與資料交付接成一條生產線,連雙臂遙控與策略訓練、推論的軟體也一併釋出。不過值得先講清楚血緣,UMI-Live 的六位作者(Govind Velamoor、Adrian Lin、Sam Jung、Spencer Mateega、Brandon Y. Yang、Amish Sethi)與當年 UMI 論文的作者群是兩批人,新論文以引用文獻的方式站在 UMI 概念上,並非原班人馬的續作。同樣想把示範收集規模化的路線還有 NVIDIA 的 ScheduleGen,它在模擬環境裡把多臂示範生成當成排程問題處理,UMI-Live 則把力氣花在真實世界的人手採集。
面對這種發布,讀者最需要的三個問題其實很具體:按一顆錄影鍵真的就把示範收完了嗎?橘子入碗任務 10/10 的成功率是什麼性質的證據?現在釋出的東西,授權狀態能不能直接拿來用?
先看現場。每支握把整合了全域快門相機、RoboSense Airy 光達、慣性感測器、Raspberry Pi 5 算力與可拆式電池,所有感測與儲存都在握把裡,收集時不需要在環境裡架任何追蹤設備,也不需要校正收集環境。夾爪手指重新設計過,PLA 硬底加 TPU 軟墊,開口 80 公釐,論文說這是為了適應小物件的精細操作。
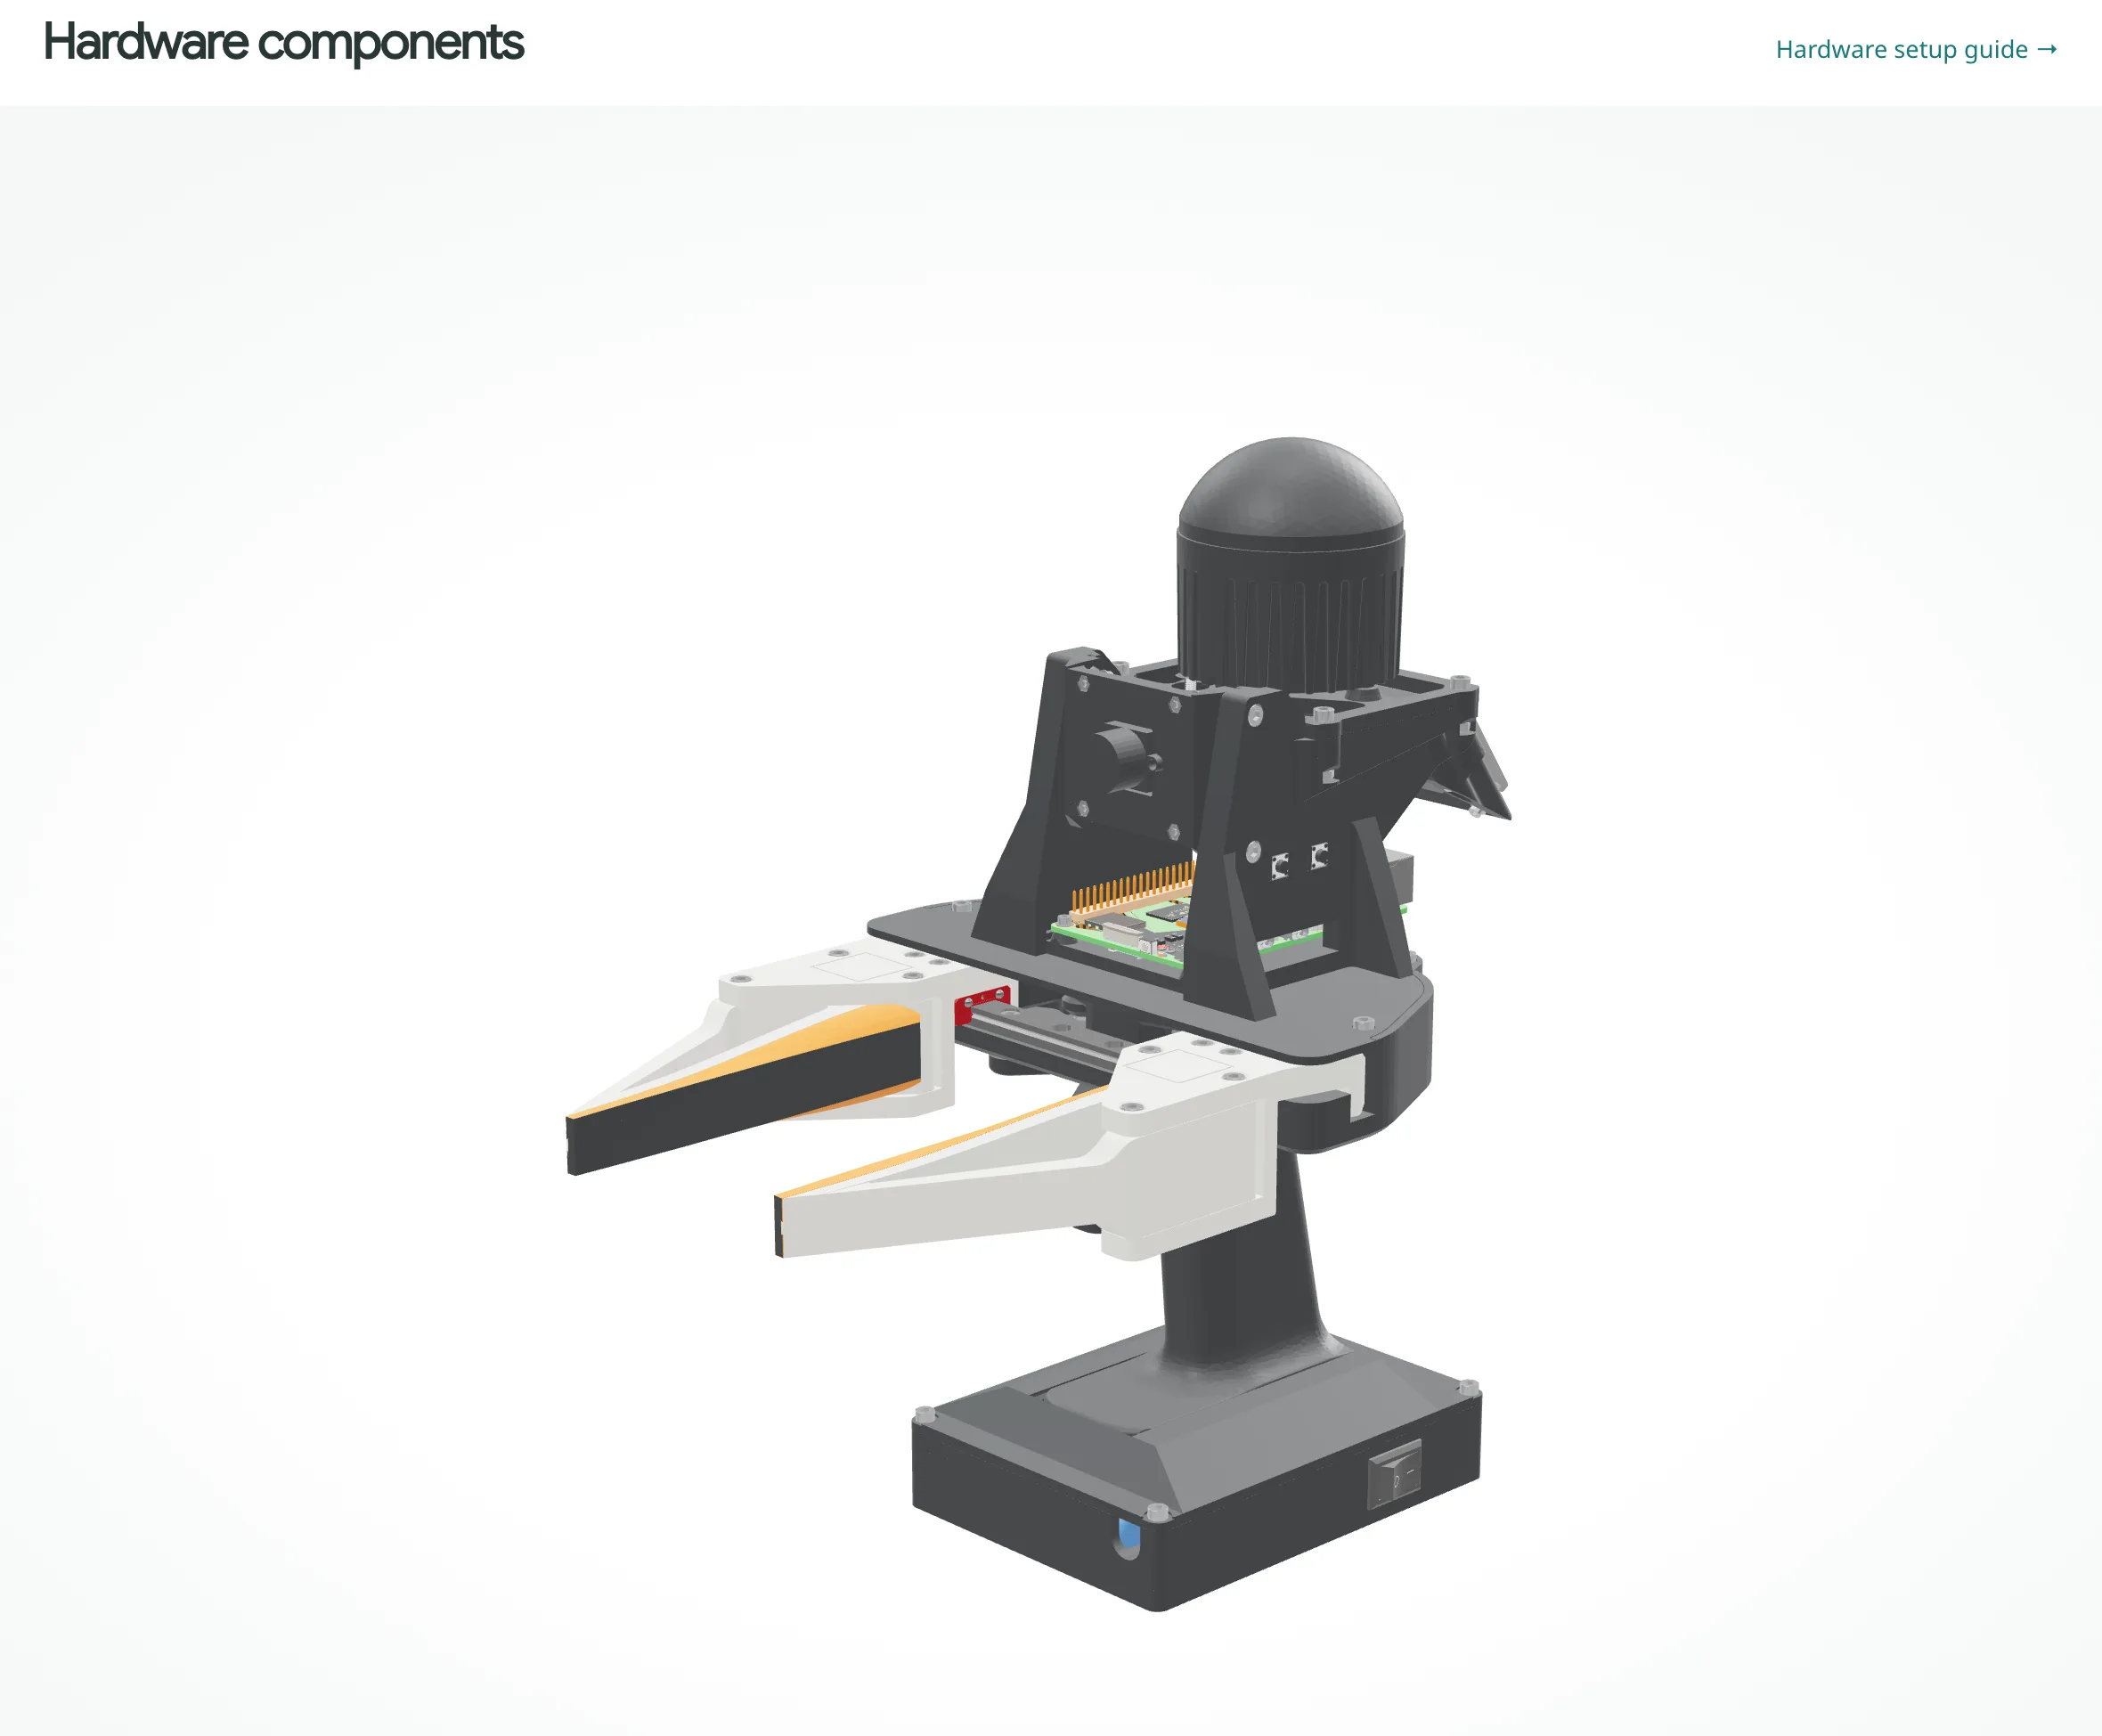
兩支握把分成領導端與跟隨端。錄影由領導端上一顆實體按鈕控制,按一下兩端同時開錄,再按一下同時停止;跟隨端沒有確認時,領導端會拒絕開錄。開錄前每台相機會檢查連續五個畫面格,夾爪上該出現的兩個 ArUco 標記(一種印出來給相機辨識的方框圖碼)如果沒有在這五格內各至少出現一次,這次錄影就不會開始,小螢幕會直接顯示缺哪一個編號。
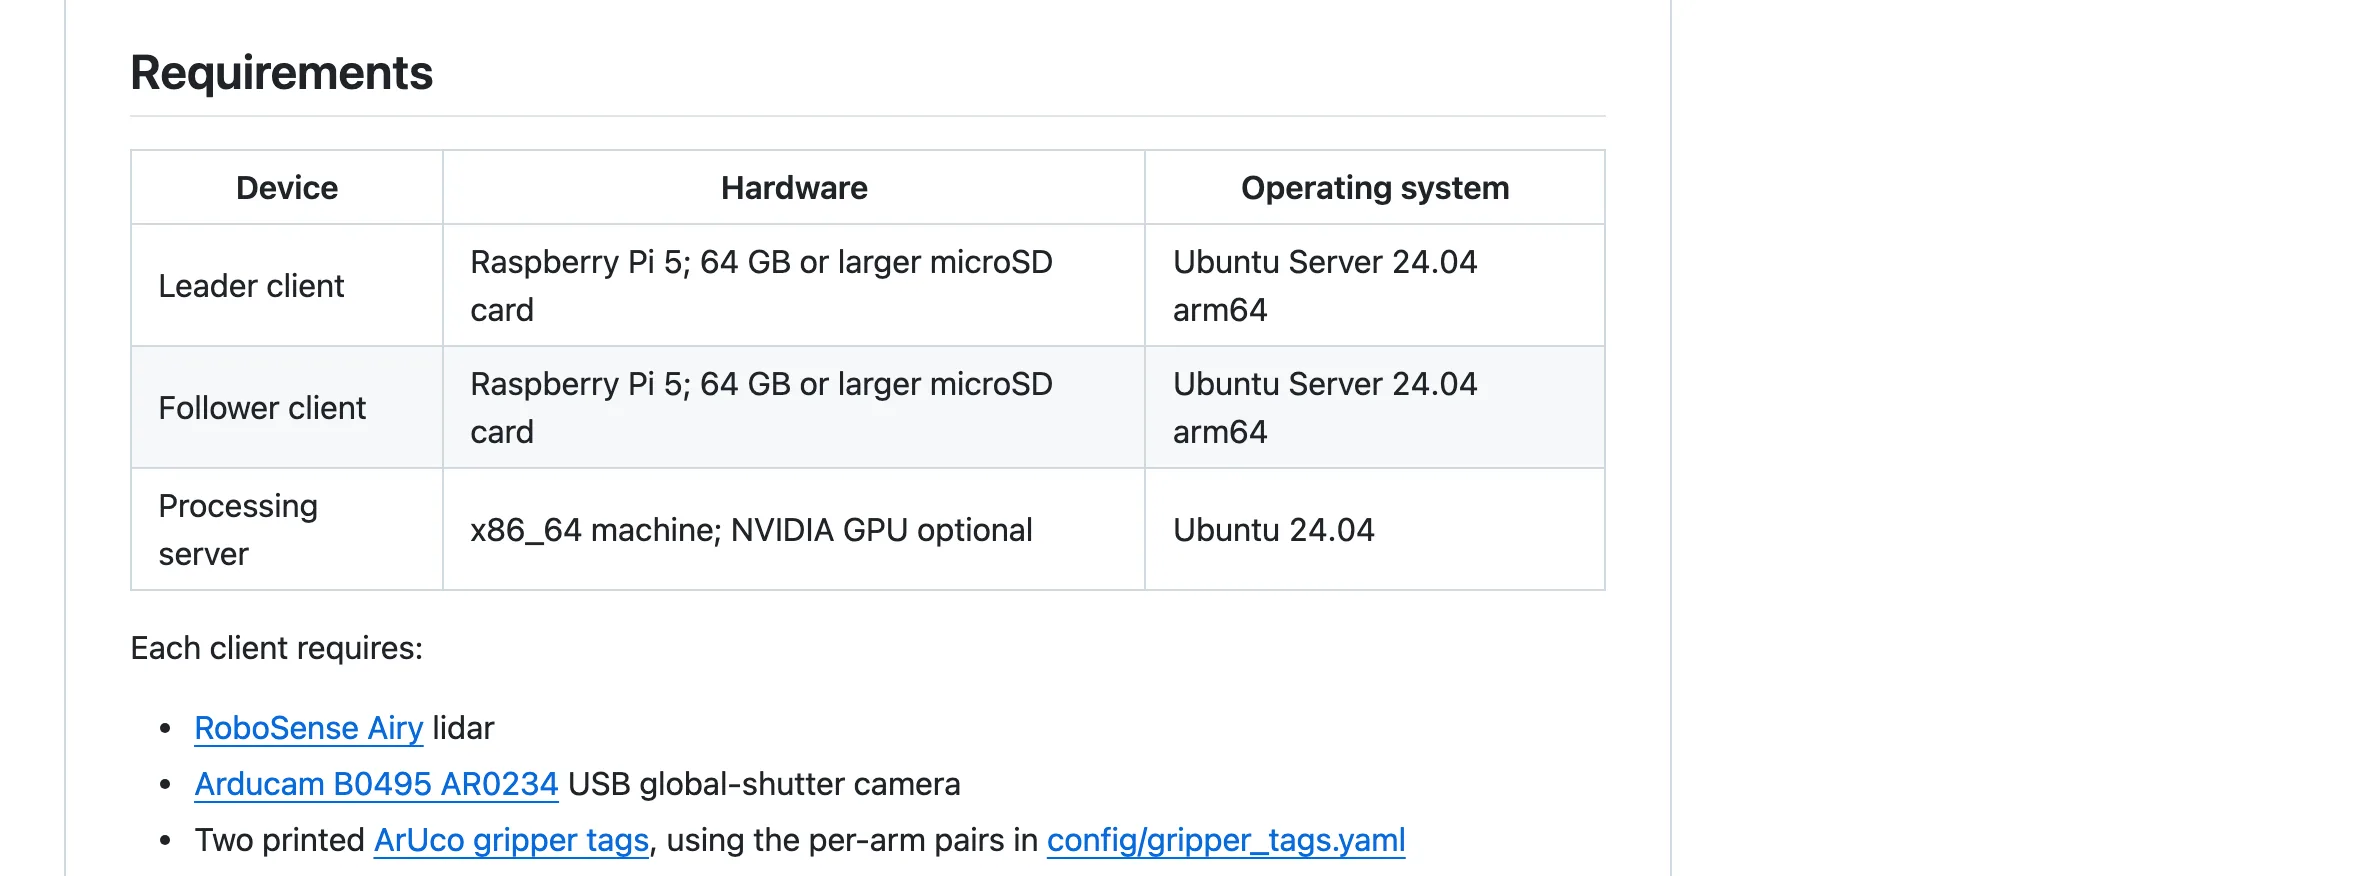
真正的分工發生在錄影之後。兩端先把原始資料存在自己的 microSD 卡,再透過 SSH 通道上傳處理伺服器;伺服器把兩端配對成同一段示範,對每支握把獨立執行 GLIM 這套光達與慣性資料的 SLAM 重建(根據感測紀錄回推握把走過的軌跡),用 ArUco 標記估算夾爪開度,通過驗證後寫入本地的 LeRobot 格式資料集。這種影像、雙手位姿與夾爪狀態的組織方式,讓資料可以直接接上模型訓練流程。
因為重建在背景跑,錄上一段的人可以繼續錄下一段,採集節奏不必等最慢的整理步驟。領導端還能自己開一個私人無線網路讓跟隨端加入,錄影協調與時鐘同步不依賴現場的基礎 Wi-Fi。處理流程也有斷點續跑的設計:每個階段完成後會留下紀錄,中斷的處理可以從已完成的輸出接著算,不需要整段重來。伺服器收資料時也不是照單全收,它會檢查兩端的同步證據、修正感測器時間戳記,再對齊各種資料流,通過段數與資料集一致性檢查的錄影才會被接受為一段示範。
團隊在部署時還要面對一個座標系抉擇:可以開啟對齊功能,把兩支握把的光達軌跡註冊進同一個公制座標系;也可以關掉它,讓每段示範保留各自獨立的相對座標。要不要讓兩手共享同一個世界座標,取決於後續訓練怎麼使用相對動作,這是重現流程裡真正會影響資料形態的設定之一。
不過按錄影鍵兌現的只是現場這一半:錄完不等於資料就緒,每段錄影要等到伺服器上出現完成標記才算配對處理完畢,把錄了多少段直接當成可用訓練資料的數量,會高估自己的進度。處理完成一小時後,伺服器會自動清掉重複的原始配對檔與解碼暫存,保留合併後的原始資料、SLAM 輸出與最終資料集,這也是追蹤進度時要知道的檔案生命週期。
UMI-Live 省掉的是環境端的追蹤布建,裝置端的校正仍然存在,這兩件事常被混在一起談。倉庫裡的程式碼附了預設的相機內參,直接沿用等於假設預設值符合自己那台相機的實際成像;要換成自己那台相機的實際校正值,得拿 ChArUco 校正板對著鏡頭掃,直到即時覆蓋率檢視全部通過,新的內參才會寫入兩台裝置。
夾爪的校正更直接影響資料意義。每支夾爪要手動做一次全閉與全開的端點校正,之後物理開口才會被換算成 0 到 1 的共通刻度。假設兩支夾爪的最大開口不同,卻把相同的原始讀值當成同樣的張開程度,模型收到的就是前後不一致的資料。換掉硬體或換掉標記,這些設定都要重做。
手持的負擔也寫在硬體表裡:每支握把含電池重 1.42 公斤,雙手示範等於兩支一起拿;單次充電運作約 1.5 小時,採集者要在這個時間內完成一批示範。一對採集器約 1,930 美元,論文明確標示這是評估版本(evaluated revision)的硬體估算,機器手臂、處理伺服器與模型訓練都不在內,把它當成整套系統的報價會差很遠。
還有一個容易誤解的邊界:手持採集不需要外部追蹤,遙控示範的配置卻把光達換成 VIVE tracker,並使用 Lighthouse 基站做外部追蹤。想混入目標機器人的遙控資料時,基站會回到現場,免架設的優點不能延伸到訓練與部署的每一段。
真機驗證的設定本身就有很多細節。測試用兩支 i2RT YAM 六軸手臂,任務是把六顆橘子全部放進碗裡,六顆全進才算成功;每次試驗從固定的機器人起始姿態出發,橘子與碗的位置隨機擺放,過程允許抓取重試與撿回掉落的橘子。這個任務的訓練池有 296 段手持示範與 75 段目標機器人遙控示範,每個微調條件都從模型公開釋出的檢查點出發。
| 模型與條件 | 手持/遙控比例 | 完成任務次數 |
|---|---|---|
| MolmoAct2 釋出版檢查點 | 未微調 | 0/10 |
| π0.5 微調 | 95%/5% | 9/10 |
| π0.5 微調 | 90%/10% | 10/10 |
| MolmoAct2 微調 | 75%/25% | 8/10 |
表中數字取自論文 10 月 29 日提交版的 Table 2,每個條件十次試驗,微調從各模型公開釋出的檢查點出發。結果表裡最有價值的一列其實是 0/10:MolmoAct2 直接用釋出版本上場,十次全敗;加入 75%/25% 的混合資料微調後變成 8/10。π0.5 微調後 95%/5% 拿到 9/10,90%/10% 拿到 10/10。這些數字支持的事情很明確:混合手持與遙控示範的微調,能讓現成的視覺語言動作模型(VLA,把相機畫面與文字指令直接對應到機器人動作的模型)適應這項具體任務。
但它們不支持更強的結論。論文沒有做只用手持示範或只用遙控示範的對照組,兩種資料來源各自的貢獻分不開;π0.5 的兩個比例只差一顆橘子,十次試驗的規模說不出哪個比例普遍更好;每個條件只跑一個訓練隨機種子,重複訓練是否得到相近結果也還沒有答案。把成功次數當唯一量尺要小心的地方,在近期的機器人評測也反覆出現:SO-101 Bench 把模擬排名與真機成功率分開量,micro1 的雙臂模擬評測則顯示模型自稱完成與感測器確認的完成可能差很遠。論文自己的限制段寫了,光達與慣性重建的品質取決於場景幾何與動作方式;換到新的桌面、遮擋變多或快速移動的場景,紀錄品質就該當成需要重新驗證的變數。
遙控示範在混合裡的角色也有明確的原因。論文注明這批手持示範是在另一個地點、不同燈光下收集的,與機器人測試現場不同;混入目標機器人的遙控紀錄,等於讓模型有機會先看過最後要執行任務的那個環境。微調本身的份量不輕,每個條件從檢查點出發跑 12,000 次更新、全域批次大小 32,適應是有代價的計算,不是把資料倒進去就結束。
範圍也值得畫清楚。釋出的 39.7 小時資料涵蓋橘子入碗、倒水與摺毛巾三種任務,但真機上的自主執行驗證只做了橘子入碗這一項。倒水與摺毛巾目前是資料,還不是被驗證過的策略能力。專案頁的影片區塊在標示上就把界線畫出來了:小物件操作、點火柴、摺襯衫放在人類示範的區塊,切水果、開瓶蓋放在錄製示範的區塊,名稱本身就說明這些是收集過程的紀錄,不是自主模型的執行成果。
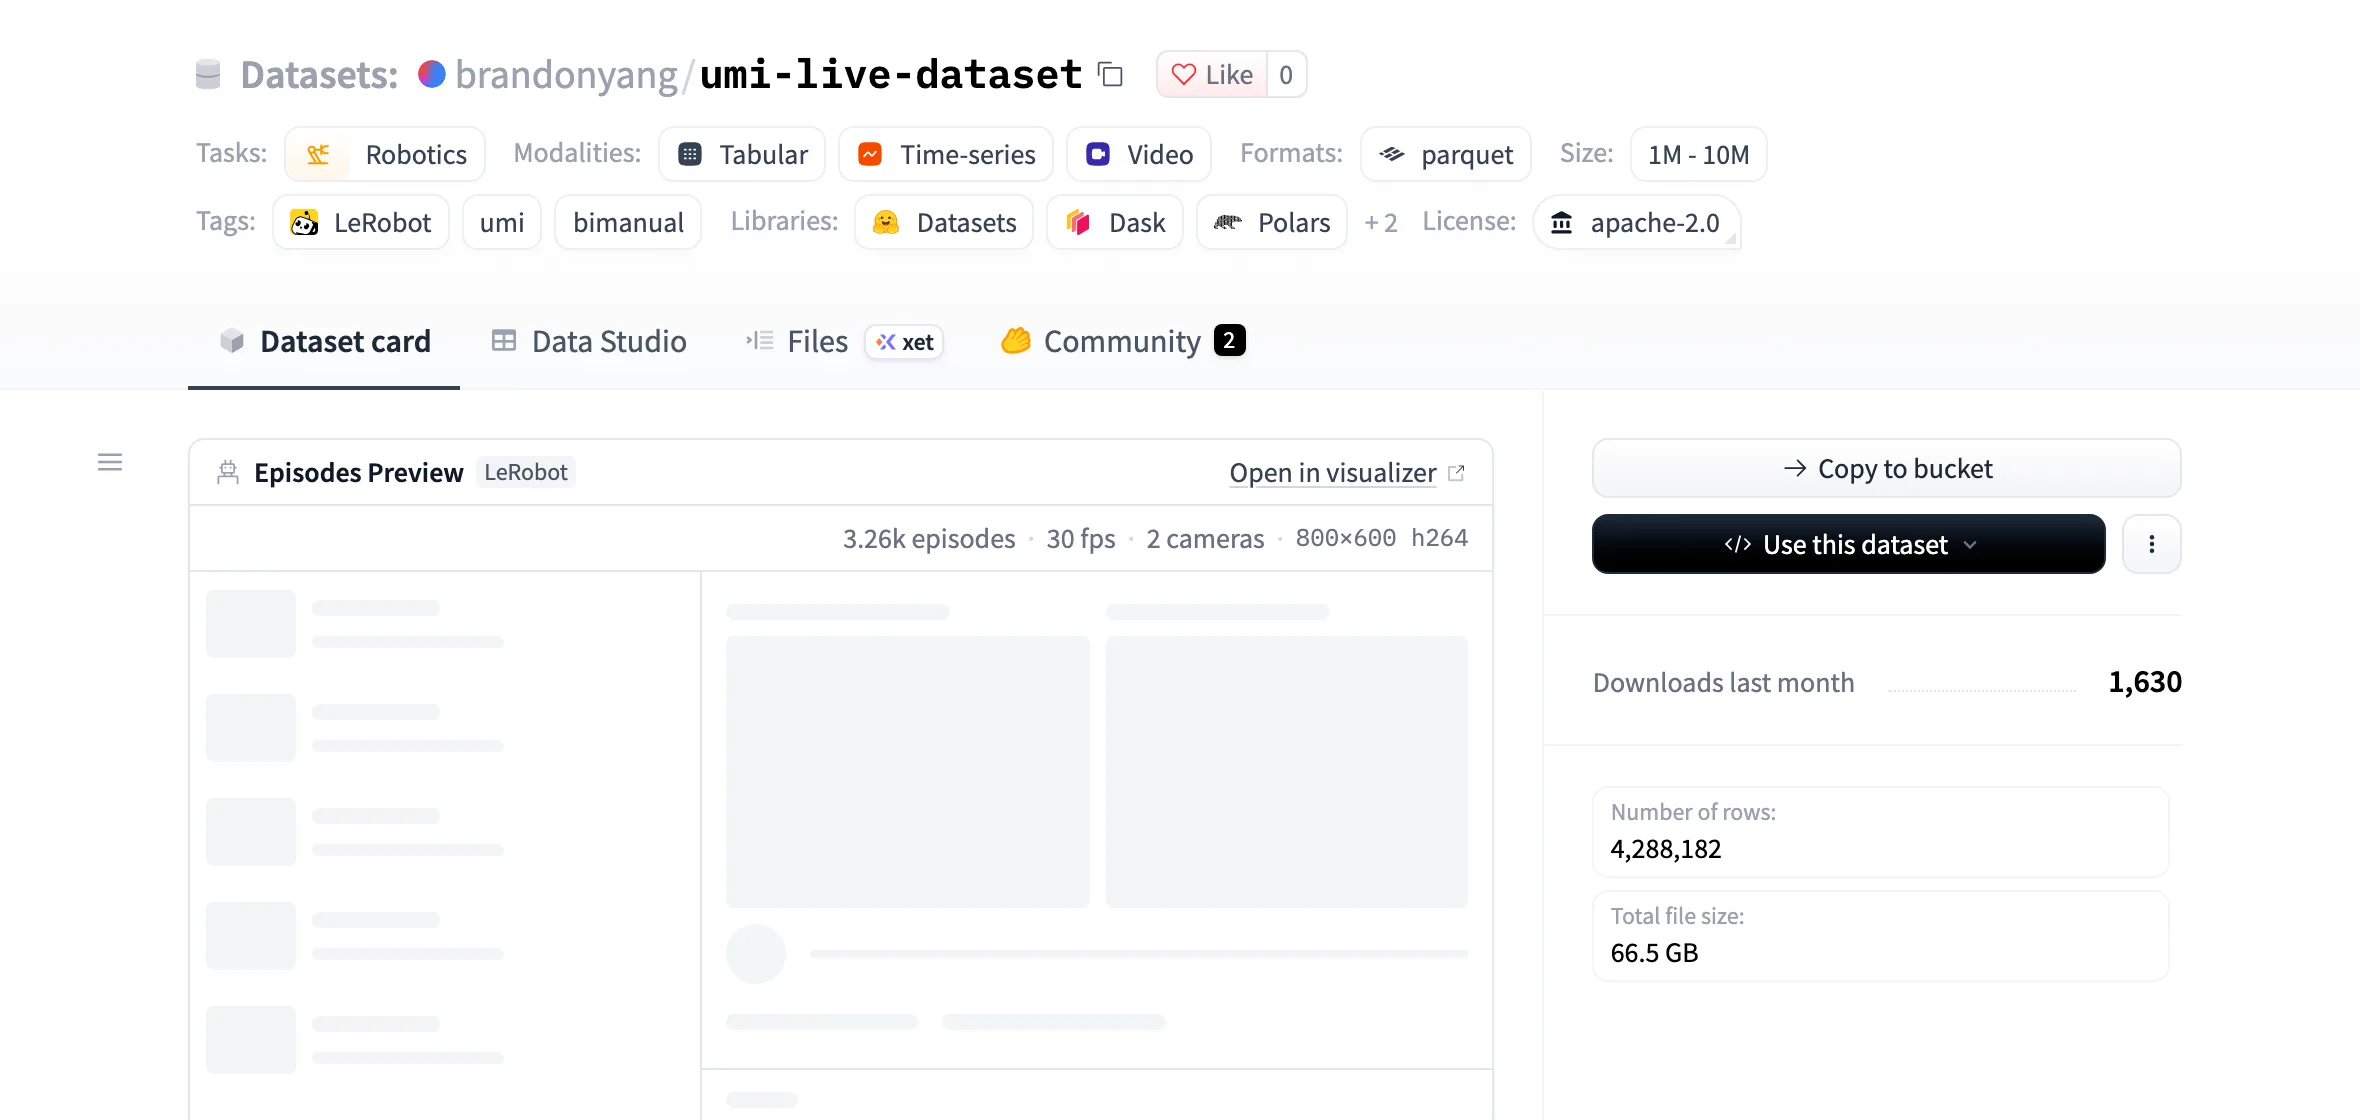
資料集放在 Hugging Face(brandonyang/umi-live-dataset),公開且不需申請,授權為 Apache-2.0,到 11 月 2 日頁面顯示近一個月約 1,630 次下載、資料量約 66.5GB。3,255 段示範以 30Hz 取樣,附同步的腕相機影像、雙手位姿與夾爪狀態,以及任務指令,釋出時還附了各段的來源標記,專案頁上也提供一段範例資料的線上檢視器,做策略學習研究的人可以先看過內容再決定要不要拉下整包。
隱私的預設值設計得保守。程式預設只把資料集留在本機伺服器,要另外設定 Hugging Face 儲存庫與寫入權杖才會同步,而且第一次推送建立的是私人倉庫;推送失敗時本機資料不會丟失,下一次會自動補同步。換句話說,按下錄影鍵不代表同意公開任何影像,對外發布是另一個要主動開啟的決定。
硬體與重現這端,倉庫提供完整的零件清單、部署指令與校正流程,遙控軟體則放在另一個 umi-teleop 倉庫。授權現況是採用前最該看清的一格:作者在 X 上稱這是 completely open-source,論文摘要的自稱是 full-stack open-source,資料集也確實掛了 Apache-2.0,但截至 11 月 2 日,umi-live 與 umi-teleop 兩個程式倉庫都沒有 LICENSE 檔案。程式碼看得到、抓得到,重用與改作的正式授權依據此刻還不存在,什麼時候補上,作者沒有給時間表。
所以三種讀者可以有不同的下一步。做策略學習研究的人,資料集授權清楚,現在就能取用,引用時把單任務、單種子、十次試驗的範圍寫明白就好。想重製硬體的團隊,1,930 美元是採集端投入的參考價,先確認 1.5 小時續航與兩支 1.42 公斤的負擔能不能配合自己的採集節奏。想基於程式碼做二次開發的人,比較穩的做法是等授權補齊,或先與團隊確認授權意向。授權狀態與下載次數都是會變動的動態數字,動手取用前再到倉庫與資料集頁面確認一次最保險。下一個會改變判斷的證據也很清楚:更多任務的真機結果,以及程式碼授權的落地。