TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

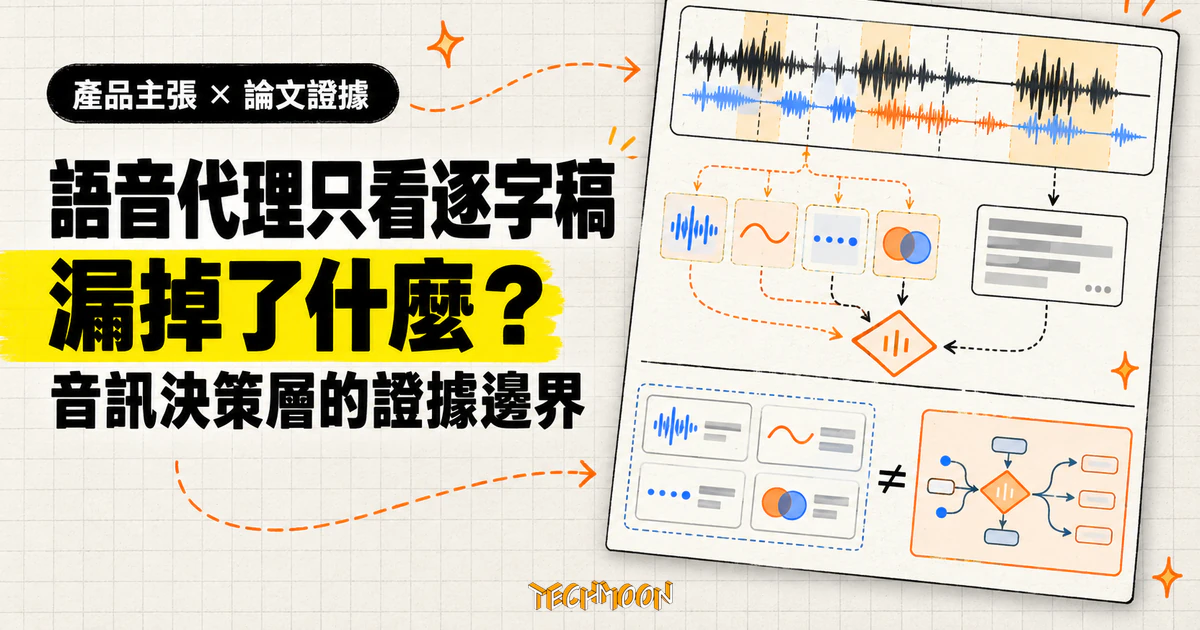
語音代理下判斷多半看逐字稿,Tazo Labs 以 X 長文與部落格系列主張該補一層直接聽音訊的決策模型。回到底層論文逐項核對:74.8% 對 7.8% 是真的,39% 量的是別的任務,唯一的真人研究被 Tazo 引錯一個數字,產品端則只有申請表單而沒有任何公開評測。
用 AI 摘要這篇文章:
目前量產語音代理的慣例,是把「現在換誰說話」交給一個計時器。OpenAI Realtime API 的文件把它叫做 server_vad,用靜默時段自動切分音訊;Daily 的語音代理入門材料把靜默閾值設成 0.8 秒,超過就當對方說完了。而人類對話的輪替間隔,依 Kyutai Moshi 論文跨十種語言的量測平均只有約 230 毫秒。台北時間 10 月 19 日晚間 9 點,開發者 Naman Jain 在 X 發表長文〈Voice agents aren’t listening. They’re reading.〉,把這個落差濃縮成一句:多數語音代理下判斷時,看的是轉出來的文字,聲音本身在轉檔那一步就被丟掉了。到 10 月 20 日上午,這則貼文累積 819 個讚與 105 則回覆,長文開頭引用 @miramurati 的譬喻是「當它們在想事情時,幾乎像又聾又盲」。
這則長文並非孤立觀點。新創 Tazo Labs(登記名 Kodimo, Inc.)從 10 月 2 日起在官方部落格連發至少六篇文章鋪陳同一套主張:語音代理該補一層直接聽通話音訊、隨時輸出各種行動機率的「音訊決策模型」,讓該回話還是該等、要不要附和、發言權何時讓出去、工具何時先叫、通話何時收尾,共用同一個判斷核心,而語言模型繼續負責講話的內容。這套論述引用了多篇論文撐腰,也因為推出者自己就在賣這一層,讀的時候值得把每個數字回原著核對。核對完的結果分成兩半:逐字稿丟掉音訊線索這件事,證據相當硬;至於「該買一層音訊決策模型」,目前還沒有任何公開評測支持。
量產語音代理多採串接式架構:音訊進來,語音辨識轉成文字,大型語言模型想回應,再轉成語音出去。Tazo 指出的要害在於呼叫者音訊與語言模型之間那段:語音活動偵測加靜默閾值。這個門檻決定代理何時開口,等於整條流水線裡後果最嚴重、智慧含量最低的環節。客服電話的典型失敗都從這裡長出來:使用者念卡號唸到一半停頓被搶話;問了簡單問題後代理沉默太久;使用者應了一聲「嗯」就被當成插話而住嘴;說完「沒事了,掰」代理還繼續講。
Tazo 自己也補了一個公道細節:判斷「說完了沒」這個單一決策,產品界已經在往音訊搬。Daily 的 Smart Turn v3 用 800 萬參數在 CPU 上 12 毫秒推論,Krisp 的模型約 610 萬參數且只用音訊,Deepgram 的 Flux 把輪替判斷摺進語音辨識,LiveKit 在 2026 年 6 月推出音訊版 Turn Detector,在自家基準的 300 毫秒延遲預算下誤切率 9.9%。Tazo 加的但書也值得原樣記下:廠商基準就是廠商基準。真正的問題在下一步:說完沒有只是通話裡的一個決策,附和要不要停、質疑要不要讓、訂單號唸完能不能提早查、背景人聲要不要理,這些判斷彼此相依,拆成六條各自調參的規則遲早會打架。Krisp 對現況的形容被 Tazo 原文引用:多數系統用的是粗糙的啟發式,對任何聲音都觸發的語音活動偵測、固定時間門檻、最低字數或停用詞清單。Tazo 另引 AssemblyAI 的 2026 年調查佐證痛點規模:47.5% 的開發者回報自己的代理會在使用者句子中間插話,55% 說使用者最大的挫折是被要求重講一遍。
那為什麼不直接把判斷交給語言模型,或乾脆換成邊聽邊說的全雙工語音模型?Tazo 的答案是兩邊都有結構性的洞。語言模型看到文字時,端點判斷早就發生過了,被叫起來這件事本身就是決策,Daily 的拆解顯示語言模型光是想出第一個字就要約 650 毫秒,是人類輪替間隔的三倍;全雙工模型把「何時說話」與「說什麼」纏在一起,難以設定門檻與稽核,而且工具呼叫的可靠性偏弱,Daily 的入門材料直接寫語音對語音模型不如文字模式模型可靠地遵循指示與呼叫工具,2026 年的 Full-Duplex-Bench-v3 基準裡表現最好的系統首次嘗試也只通過六成任務。這也是企業多數仍跑串接式架構的原因,而這正是各家把語音代理做成 API 產品時共同面對、卻很少攤開來講的一段。
Tazo 的提案用五個性質定義「決策模型」:直接讀通話兩端的原始波形、每隔數十毫秒就重新判一次、對同一組動作輸出機率、輸出經過校準、掛在語言模型旁邊而非裡面。校準的實際意義,是模型報 0.8 把握時,十次裡大約八次真的會對,於是重視禮貌的銀行可以把門檻調高、講求速度的得來速通道可以調低,同一個模型不用重訓。Tazo 借了網路工程的比喻:語音辨識、語言模型與語音合成是搬運內容的資料面,決策模型是指揮內容何時移動的控制面,兩者分開,換模型、換提示、換聲音都不動輪替行為。這個願景在概念上自洽,而且每一條都對應到計時器做不到的事;問題從頭到尾只有一個:它還沒有拿出自己的成績單。
長文與部落格最醒目的一組數字,出自 2026 年 9 月上傳 arXiv 的端點偵測論文(編號 2609.11066,四位作者都任職 Uniphore)。實驗在五千句真實英語電話對話上做受控消融:語料是銀行、保險、零售、電信領域的專有通話錄音,只取單一說話者連續發言、對向聲道活動低於 10% 的片段。結果是純文字版 F1 分數 0.292、過早誤判率 74.8%;聲學加韻律的組合 F1 0.930、誤判 7.8%、中位延遲 400 毫秒;純聲學也有 0.927。每個摻了文字的組合,誤判都比對應的無文字版本更高。論文對這個現象的解釋是同一句話裡常有許多語意完整的停頓點,文字模型在每個點都想插話。
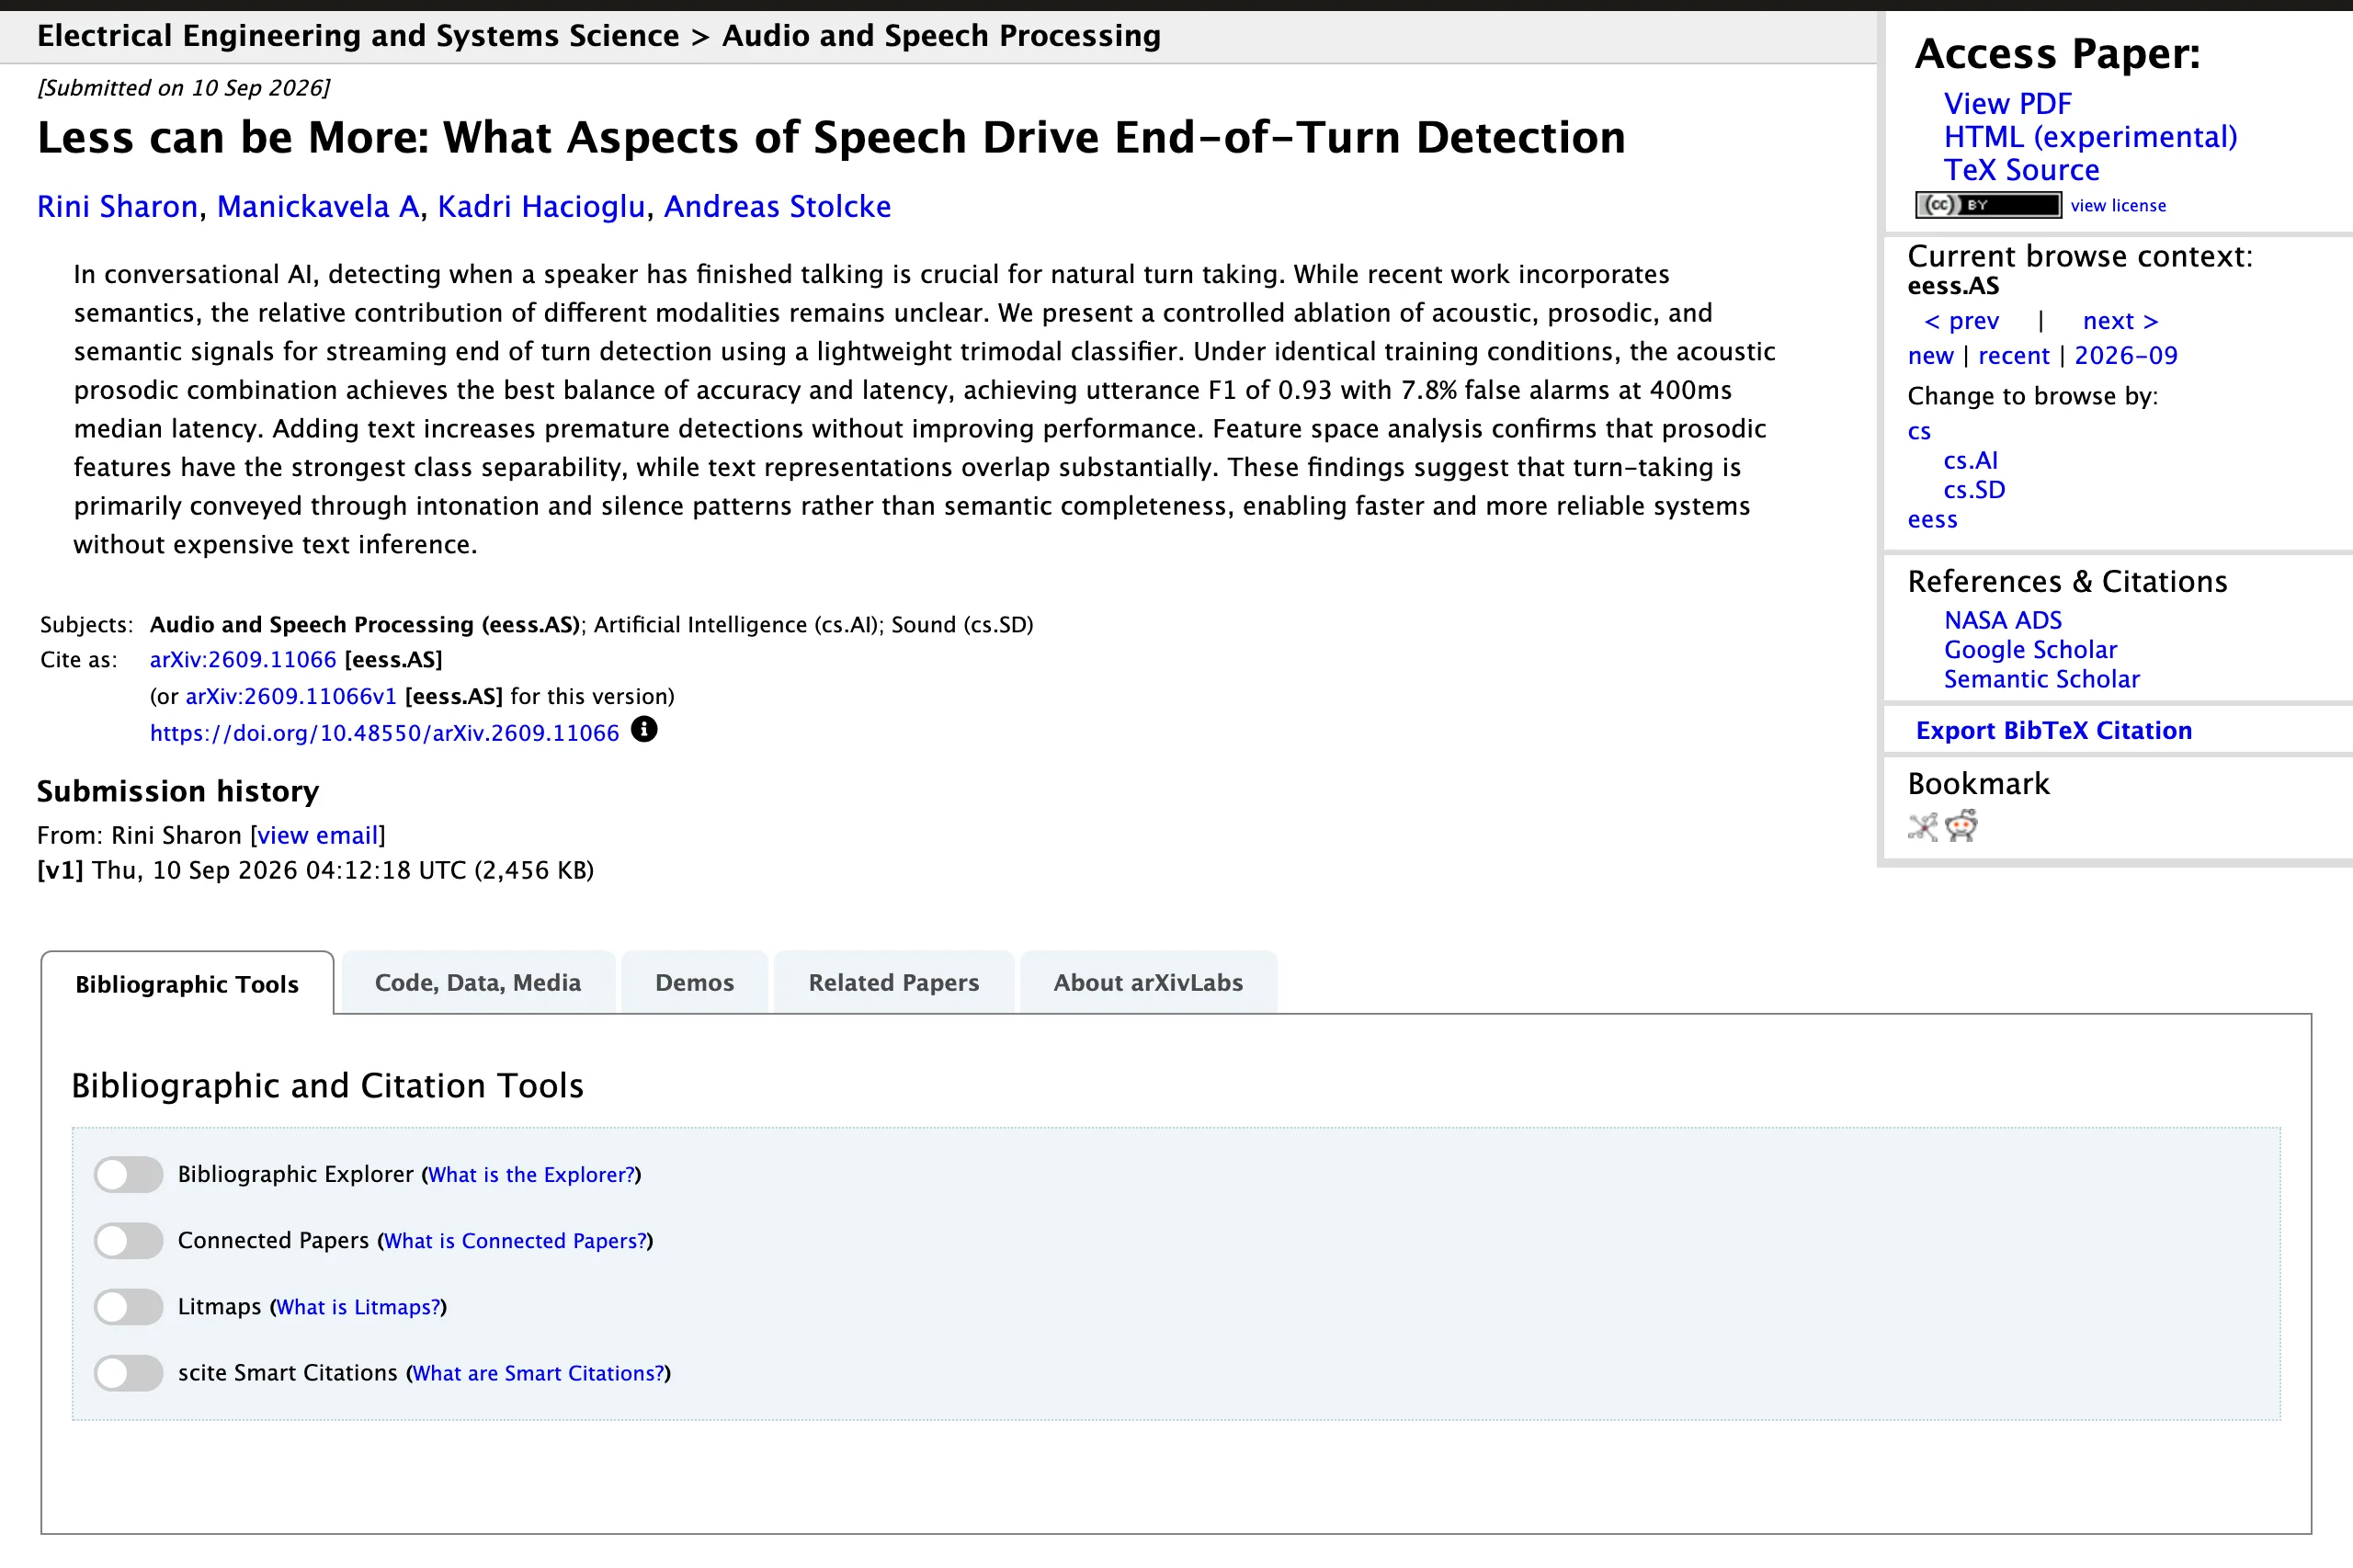
不過這篇論文自帶三個使用說明。文字版的延遲只在五千句裡的 853 句算得出來,論文自己形容這個估計樂觀且不可靠。限制段明寫結果僅適用同領域的兩人英語電話,在聲音線索稀薄的語言或高噪音環境,文字可能反而更有用。文字流餵進去的還是錯字率 13.8% 的不完美轉錄。另外,整個分類器只訓練約 26 萬參數的小模型頭,特徵來自冷凍的 70M 參數 Zipformer 編碼器,「小模型能扛下這類判斷」這半句倒是有架構層面的支撐。換句話說,這篇論文支持的是「韻律與聲學帶有文字沒有的線索」,支持不了「音訊決策層能取代逐字稿」。
蘋果與紐倫堡理工研究者的論文(arXiv 2403.14438,2024 年 3 月)提供另一組常被轉述的數字。它量的是裝置導向語音偵測:拿掉喚醒詞之後,判斷一句話是不是對著助理說。最佳純文字系統等錯誤率 12.15%,最佳多模態系統 7.45%,相對改善 38.7%,摘要四捨五入寫成最多 39%。任務與輪替時機無關,而且得獎的那個系統同時使用文字、音訊與語音辨識解碼器訊號,示範的是加線索,不是換輸入。
Meta 與 CMU 等研究者的 Stream RAG 論文(arXiv 2510.02044,2025 年 10 月)的 20% 工具延遲改善,來自訓練模型在使用者還在說話時就預測工具查詢並提早發出,Qwen2.5-7B 的工具呼叫延遲中位數從 2.78 秒降到 2.20 秒。這支持「邊聽邊動作」的方向,量測對象卻是何時發出工具呼叫,跟音訊對文字這條軸沒有直接關係。Tazo 把同一個方向包裝成「投機式工具呼叫」:通話進行中就猜可能要查什麼、下場先跑,等對方說完再讓語言模型下真正的判斷,猜中就直接用快取結果,猜錯就丟掉。官方強調這個設計無損:每個真正的決策仍由語言模型拍板,猜錯浪費的只有運算,行為與沒有投機的版本完全相同。產業裡已有先例可對照,Deepgram 的急切端點判斷要價是多了五到七成的語言模型呼叫量,Salesforce 的示範系統靠背景預抓達到 75% 的快取命中率(以上皆 Tazo 引述)。同系列還有 2026 年 3 月的 DualTurn(arXiv 2603.08216,單一作者,投稿 Interspeech 2026):5 億參數模型在動作預測加權 F1 0.633 勝過 VAP 的 0.389,字級輪替預測 AUC 0.930 勝過一個 31 億參數音訊加文字模型;只是對照組裡同樣沒有「只讀逐字稿」的版本。把這幾篇加總成「音訊勝過文字」的一般性結論,每篇都會抗議。
整場論述裡唯一真人實測,是 Skantze 與 Irfan 發表在人機互動會議 HRI 2025 的研究:39 位成人與 Furhat 機器人對話,同一批人分別體驗靜默計時器基準與學習式輪替系統。新系統的中位回應時間從 2.7 秒縮到 1.5 秒,打斷率從 16.6% 降到 6.9%。偏好題的原始結果是 9 位倒向基準系統、3 位未表態,換算下來偏好新系統的是 27 位。Tazo 部落格則寫成 “30 of 39 participants preferred”,與論文對不上,方向不變、數字引錯。這個案例剛好示範了為什麼廠商引文要回原文核對。
這組真人證據的邊界也要畫清楚:新系統同時用了音訊模型 VAP 與文字模型 TurnGPT,對照的又是靜默計時器,所以它證明的是學習式輪替模型勝過計時器,證明不了音訊勝過逐字稿;場景還是機器人對話,與電話客服有距離。它給評估者的啟發在別處:回應速度與禮貌程度這兩個目標,在計時器上是直接交換的,調快就多搶話;學習式模型讓兩者同時變好,這才是「決策層」這個概念真正誘人的地方。這個領域的評測文化也還年輕,Tazo 引的一份 2025 年回顧統計,輪替研究裡有 72% 根本沒有與前人方法比較,等著論文互相印證恐怕等不到,自己量測的份量因此更重。
回到產品現況。Tazo 官網首頁掛著「跳過逐字稿」的標語與 Try Tazo 按鈕,按下去開的是早期存取申請:留下工作信箱等聯絡。頁尾的 Get API key 與 Playground 按鈕,在瀏覽器停用 JavaScript 時的後備行為是寄信給客服,網站上找不到定價,找不到開發文件,也沒有任何一條評測結果。首頁那排 LinkedIn、Google、Microsoft、DeepMind 等公司標誌,措辭是「來自這些公司的開發者信任我們」,講的是開發者出身,與客戶採用無關。導覽列還連著名為 Manifesto 的頁面,打開來是找不到頁面。
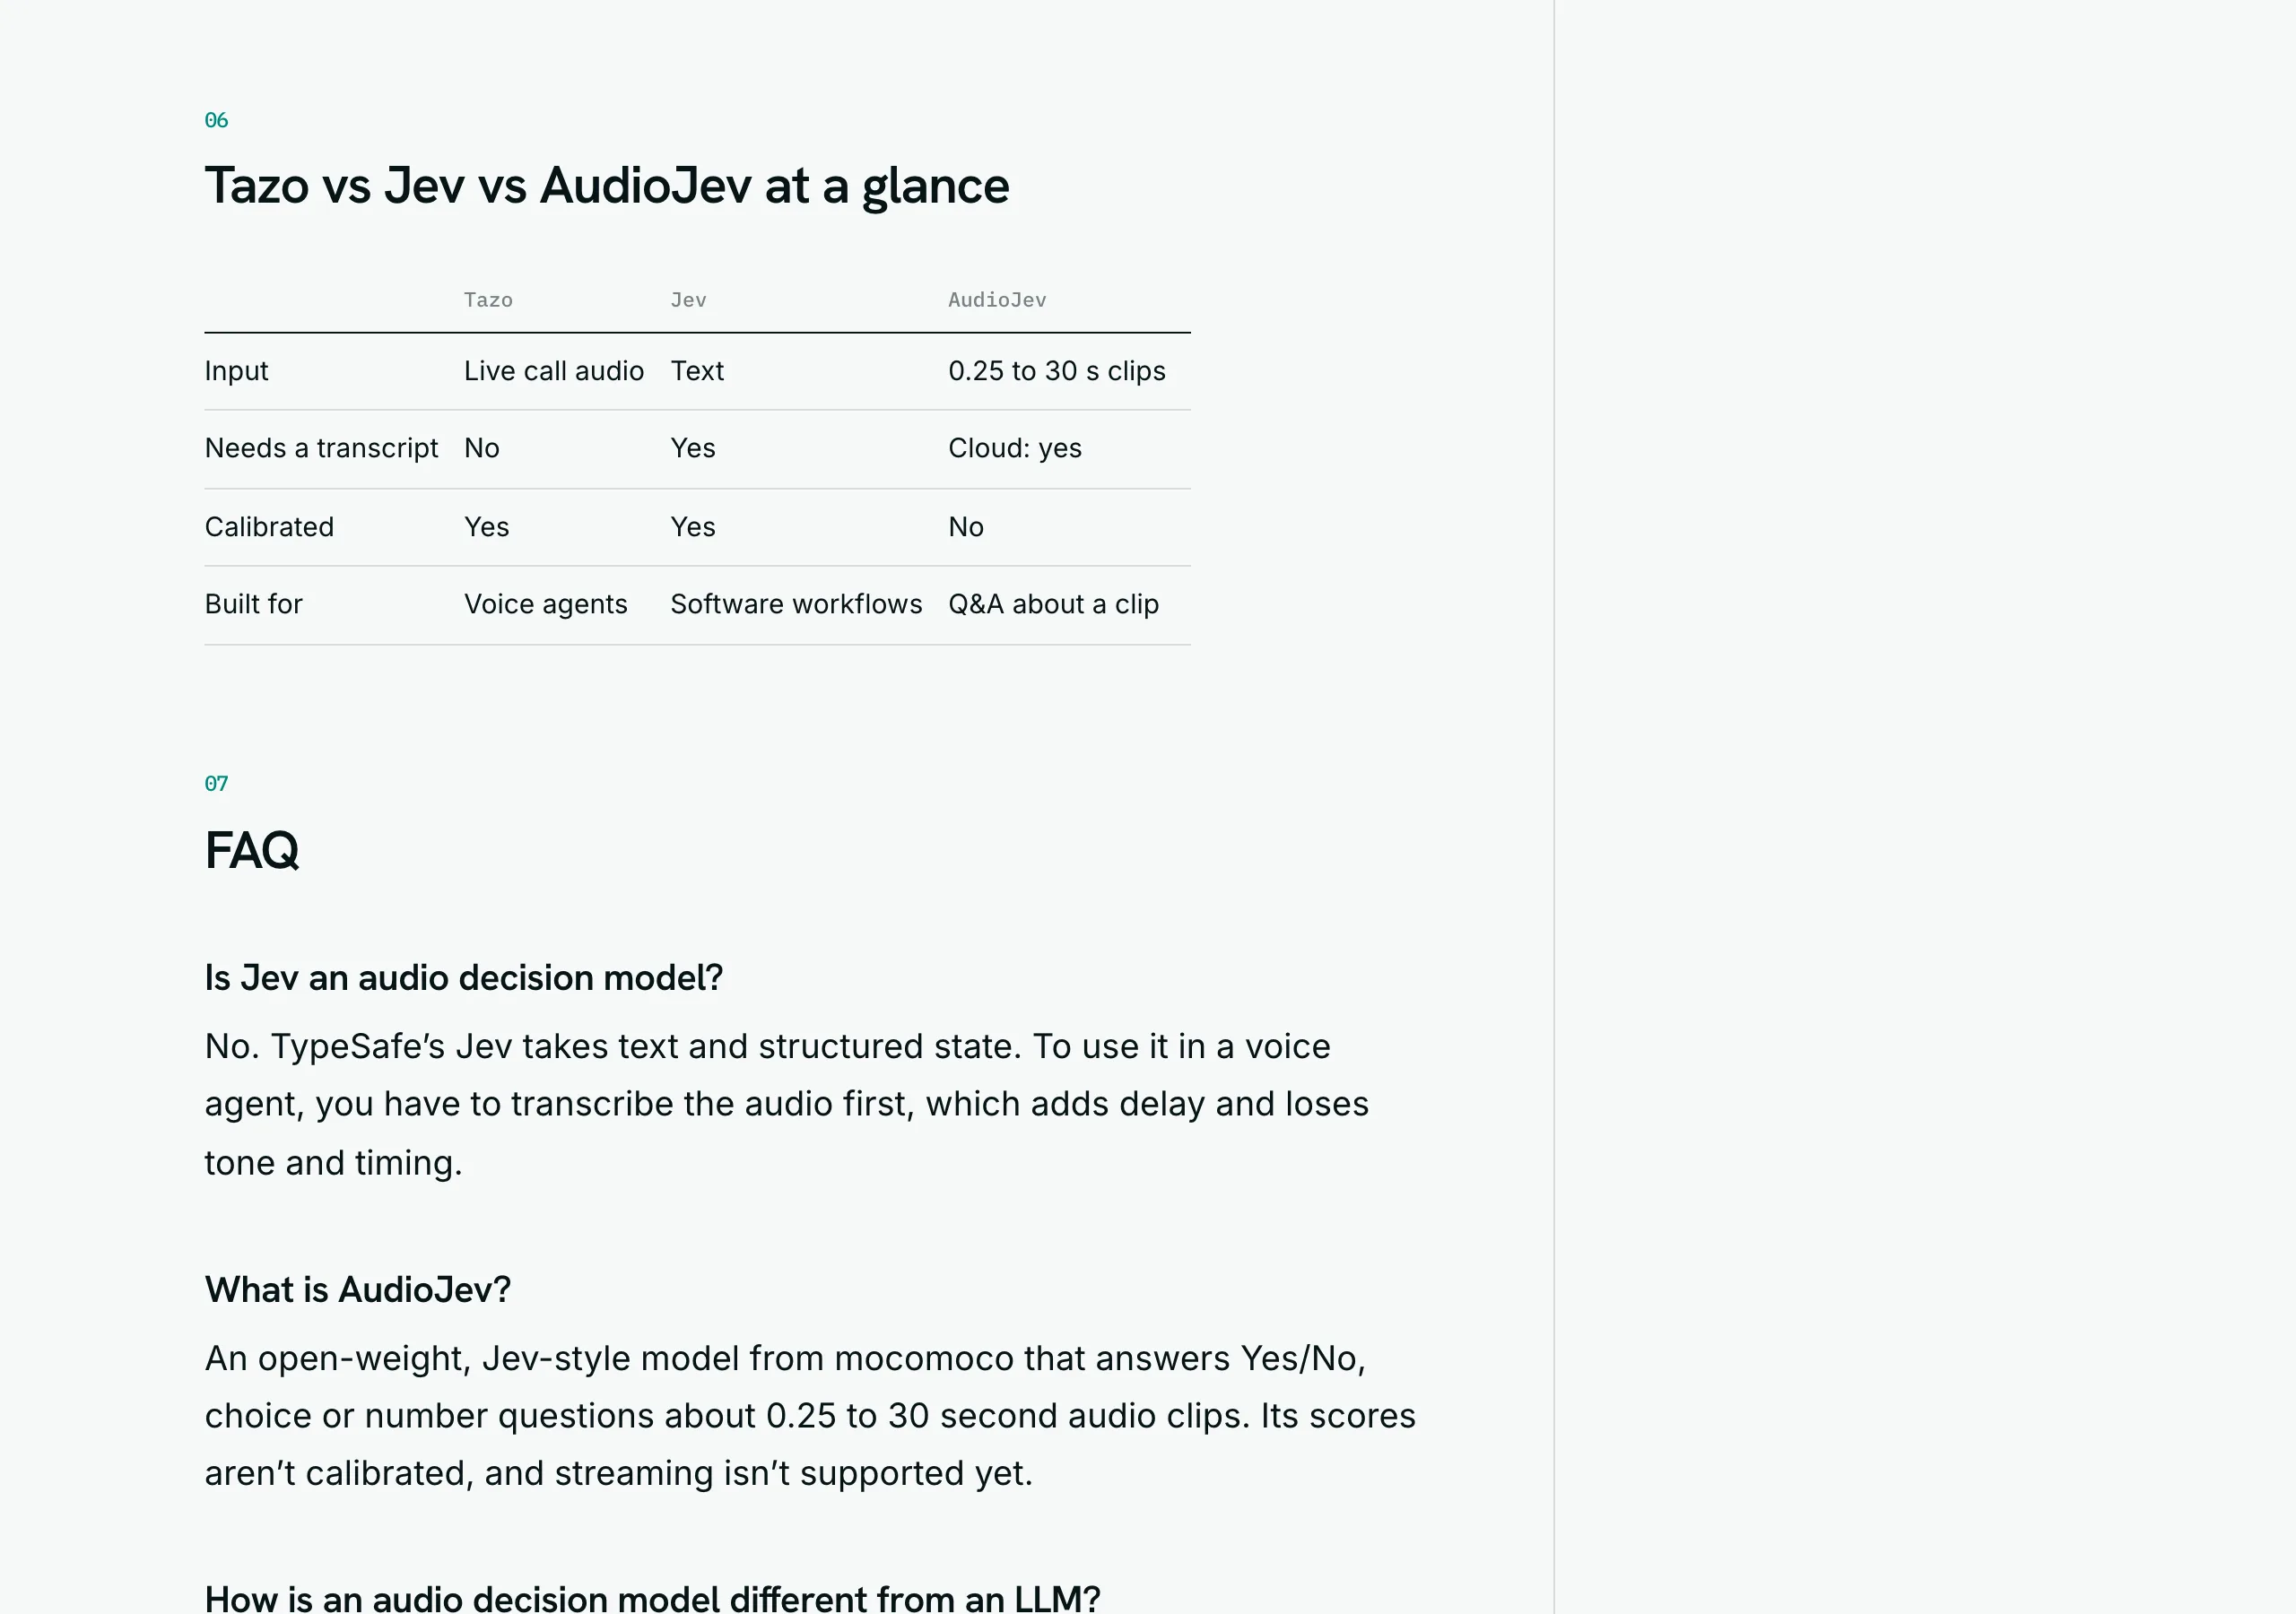
Tazo 也把自己與兩個鄰居並排:TypeSafe 的 Jev 於 9 月中開放早期存取,吃文字輸入,端到端回應 70 到 500 毫秒(Tazo 引述 TypeSafe 的說法);mocomoco 的 AudioJev 於 9 月 21 日以開放權重登場,回答關於 0.25 到 30 秒短片片段的是非、選擇與數字題。這張對照表是能力盤點,不是評測:表裡唯一的分數 88.75%,是 AudioJev 在自家 240 題固定題庫上的成績,模型卡自己註明分數未經校準、新問題還在評估;Tazo 自己的分數,一個都還沒有給。行銷素材裡「800 毫秒查詢提早 1.2 秒觸發、六成命中率每輪省 480 毫秒」那組數字,是官方拿單一工具推導的示例算式,量測紀錄並不存在。
把視野拉遠一點,這個品類確實正在成形:微軟的 Decision-1 已經同價對齊 Jev,文字側的使用案例地圖也先跑了起來,音訊側目前只有宣示。Tazo 在 10 月 18 日的文章裡另描繪了一個值得記下的用法:把代理的狀態圖交給決策模型當路由器,每次轉移都留下分數、門檻與當時的音訊視窗,事後可以重放比對。官方給的範例是身分驗證節點上「留在原狀態 0.31、進入退款 0.64、轉人工 0.05」,退款門檻設 0.90,所以即使 0.64 是最高分也不該過門,而文字路由器多半會直接過去,因為它只看誰最高。這段範例的數字官方自己標明是示意,但機制描述是整個系列裡最能看出除錯價值的一段:通話出錯時,先查哪個轉移錯了,再決定補資料、調門檻還是修提示,把「代理為什麼出錯」從讀逐字稿猜,變成查紀錄。
對正在建置或採購語音代理的團隊,這場討論最實用的產出是評估方法,恰好也是 Tazo 部落格寫得最像工程文件的一段:別被單一準確率說服,要看固定延遲預算下的誤切率曲線(或反過來固定誤切率看延遲)、附和被誤停的比例、真正插話後代理安靜下來的速度、工具呼叫與掛斷這類動作的精確率召回率,以及面對重講、改口、長停頓的行為。落到操作面,先錄下幾十通取得同意的真實通話,標出每一個不該被打斷與不該被等待的時刻,讓現行流水線跑一遍記下誤差,之後任何候選模型都用同一批重放比較,就沒有義務採信任何一方的說法,Tazo 也不例外。兩個前提別省:把原始通話音訊送進模型,聲紋與環境音就跟著進去,資料保存與使用者同意的設計,都與只處理逐字稿時不一樣,先過法務;簡單問答型的代理用現行計時器可能就夠,少一層模型少一層風險。
會改變結論的訊號也明確:Tazo 公布逐決策的評測曲線、出現獨立第三方的對照、或先給出價格與文件,都值得重看一次。論文證據支持的是音訊與韻律裡有文字讀不到的線索;還沒有任何一篇證明,多加這一層模型之後,你的通話會比現行作法更穩。這兩句話之間的距離,就是現在值得自己動手量測的東西。