TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Meta 在 10 月 12 日發表 Muse Wonder 模型系列,主打跨對話記憶與長任務執行:一般版走 API,每百萬輸入 4 美元、輸出 20 美元;Full 版不賣 token,只綁每月 50 與 200 美元的 Muse Code 訂閱。官方 14 項基準裡,記憶與長程式任務贏過列名對手,健康問答、從零寫程式與綜合指數仍輸 Opus 5.5,本文把兩面攤開來讀。
用 AI 摘要這篇文章:
Meta 在官方日期 2026 年 10 月 12 日發表 Muse Wonder 模型系列,祖克柏(Mark Zuckerberg)在台北時間 10 月 13 日凌晨 0 點 55 分於 X 貼出公告,介紹這組「為個人與專業代理工作打造的新前沿模型家族」。這次一次推出兩個版本,賣法完全不同:Muse Wonder 走 API 按 token 計費,每百萬輸入 4 美元、輸出 20 美元;Muse Wonder Full 不賣 token,只綁在每月 50 美元與 200 美元的 Muse Code 訂閱方案裡。
主打的能力有兩項:Active Memory 讓模型跨對話記住重要背景,任務需要時主動取回;Active Focus 讓模型遇到阻礙仍朝目標推進,該問就問、重要行動前先確認。對每天用 AI 接手長任務的人,該問的問題不是型號強弱,而是你的工作落在官方成績單的哪一列:記憶與長程式任務這次確實贏過表上所有對手,健康問答、終端機操作、從零寫程式與綜合指數仍然輸給 Claude Opus 5.5。把這張成績單讀對,比記住任何一句發布文案更實在。
依官方開發者頁列出的規格,一般版模型識別名稱是 muse-wonder-1.0,上下文 100 萬 token,每百萬輸入 token 4 美元、快取輸入 0.20 美元、輸出 20 美元,同時供應給 Meta Model API 與 Muse Code。模型卡的規格欄另載明:輸入端吃文字、圖片、影片與音訊,輸出只有文字,也就是看得懂截圖與影片內容,但生成畫面不在它的能力範圍。Muse Code 本體是裝在終端機的編碼代理,官方提供 macOS 與 Windows 版,一行安裝指令就能裝起來。API 相容 OpenAI SDK 的寫法,官方快速上手文件明言「把你現有的 OpenAI SDK 相容客戶端指向 Meta Model API」就能開始。第三方市集 OpenRouter 也在同日上架 meta/muse-wonder,單價與官方完全一致,等於多一條不改程式碼的接入路。從家族價格看階梯更清楚:上一代主力 muse-spark-1.3 每百萬輸入 1.25 美元、輸出 4.25 美元,Wonder 輸入調到 4 美元、輸出 20 美元,輸出單價是前代主力的四倍多。長任務的 token 消耗又以輸出為大宗,模型回答愈長、帳單漲得愈快,這件事在後面看第三方量測時還會再出現。
Full 版走另一條路。官方模型頁在 muse-wonder-full-1.0 這一列只寫「透過 Muse Code 訂閱供應」,價格欄位全部留空,並註明「Power Usage 與 Maximum Usage 方案可用」。對照 Muse Code 的四檔方案:Everyday Usage 每月 5 美元、High Usage 每月 15 美元、Power Usage 每月 50 美元、Maximum Usage 每月 200 美元,後兩檔才拿得到 Full。換句話說,5 美元與 15 美元的低檔訂閱碰不到這次最強的版本,想用 Full 只有訂閱一條路,而且官方沒有揭露 Full 換算成 token 的等值單價。方案頁的用量倍數都以最低檔為基準:High 是 5 倍、Power 20 倍、Maximum 80 倍;最低檔每 5 小時可送 10 到 50 個提示,含圖片影片上傳、語音模式與網頁搜尋。一般版 Wonder 在 Muse Code 裡適用哪些方案,官方沒有逐項列明,訂閱前要以方案頁當時載明的模型清單為準。
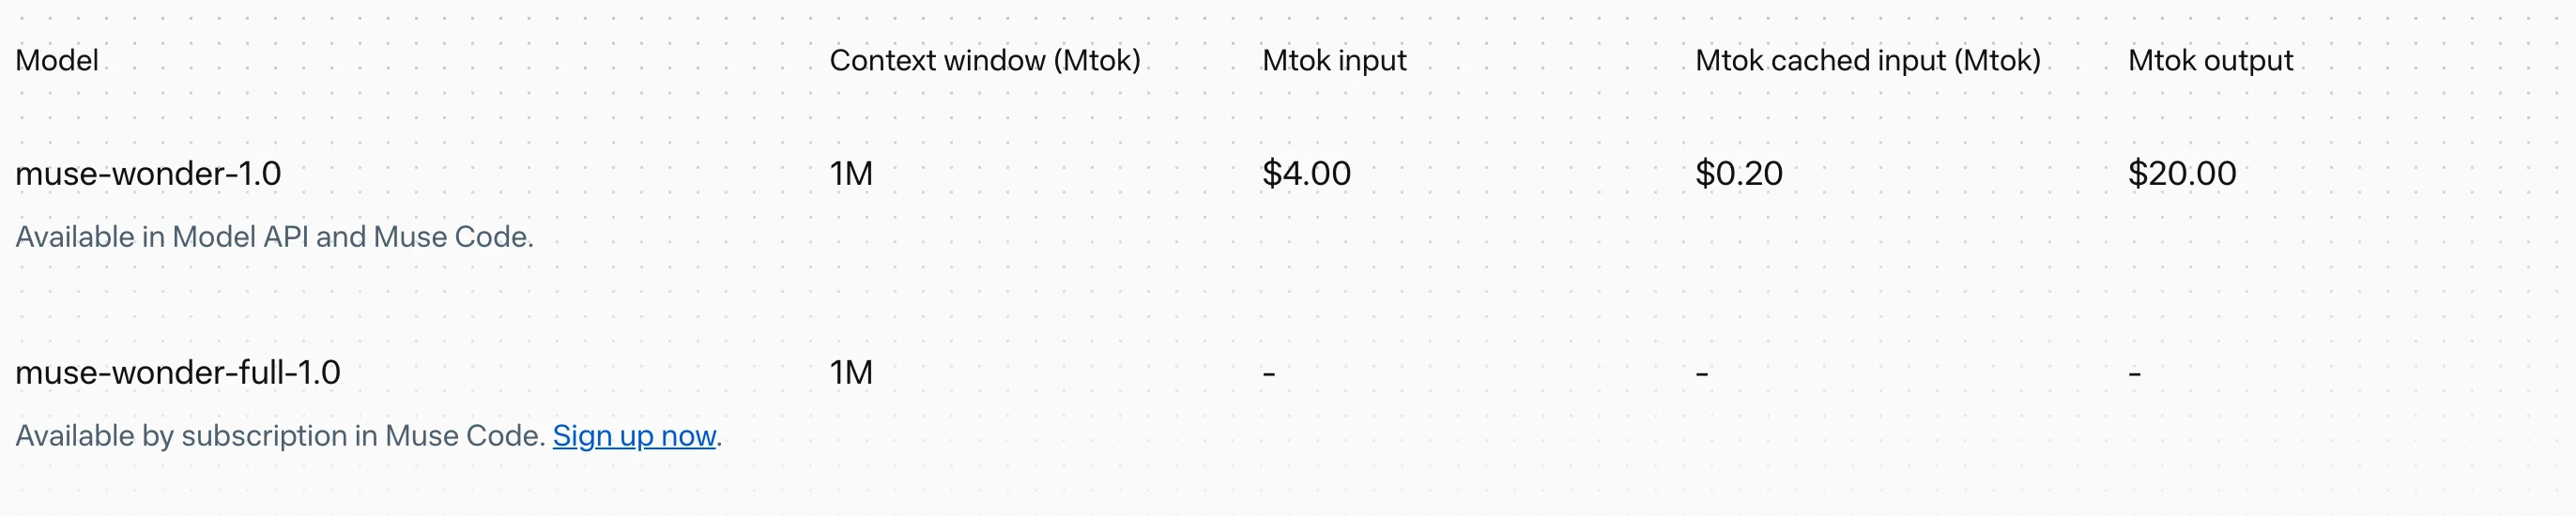
成本可以自己算。以未命中快取的 10 萬輸入 token 加 2 萬輸出 token 為例,一般版模型費是 0.4 加 0.4 共 0.8 美元。這只是模型呼叫費,長任務通常會多次來回、又會叫工具,實際帳單要看任務總 token 量,代理工作耗的是輸出端,而輸出單價是輸入的五倍。
一般使用者先不用急。官方公告寫明 Muse Wonder「接下來會陸續進到 Muse 應用,訂閱者優先」,Meta 也預告之後會用 Wonder 系列衍生專門化模型。Muse 應用何時輪到免費帳號,官方沒有給日期。從第三方目錄的上架時間戳看疊代節奏:Spark 1.1 七月中、1.2 八月初、1.3 九月初,Wonder 十月十二日進場,官方在公告裡稱這條路線是「可預期、嚴謹的擴展」,新一代模型的間隔大致一個月一次。想看 Muse 這條產品線的起點,可以回頭讀我們九月追過的Muse 個人 AI 代理報導;訂閱生態的全景則整理在Meta One 全平台訂閱解析。
用官方文件的原話拆開看,這次的主打其實對準兩種日常工作裡的失敗情境。
Active Memory 的定義是「跨對話帶著關於你的重要背景,並主動取回與當前任務相關的細節」。實際的痛點:專案本來用藍色主視覺,上週改成綠色,這週請助理改頁面,它卻照舊抓藍色的規格。記憶要能更新、要認得出舊要求已經作廢,才有用。
官方用內部基準 MemoryBench 驗這件事,測法要看清楚:對話長度 6.4 萬到 10 萬 token,裡面混入干擾對話,也插入會與目標細節衝突、或事後更新內容的訊息,最後由 LLM 評審按加權評分標準給分。兩個重點值得停下來:測試對話最長只到 10 萬 token,不是 100 萬,模型卡的上下文規格與記憶測試涵蓋範圍是兩回事;而且這是內部基準,題目與評審都是自家設計。它可以支持「記憶情境下表現好」,不能直接換算成「你的百萬 token 專案每個細節都找得回來」。
Active Focus 則是「持續朝有挑戰的目標工作:嘗試其他做法、處理阻礙、隨新資訊調整,途中需要時提出澄清,重要行動前回報確認」。對程式開發尤其關鍵,因為功能要跨檔案修改、跑測試、再修測試抓到的問題,很少一次生成就收工。開發者頁對長任務的描述更具體:工作會跑上數小時,模型先規劃、把部分工作派給子代理、平行呼叫工具、出錯後自己恢復。官方並給出多段示範,包括:從圖片輸入做出可玩的 3D 廚房遊戲、在瀏覽器與多個應用之間安排週六跑步計畫、用個人 Instagram 照片設計並下單訂製周邊、照複雜配對條件排婚禮座位表。示範把「跨工具、帶背景、多步驟」具體演了一次,但示範不能換算成你自己任務的成功率,而且模型卡同時把 3D 視覺與空間理解列為已知弱點,廚房遊戲示範與限制清單並讀才是完整畫面。
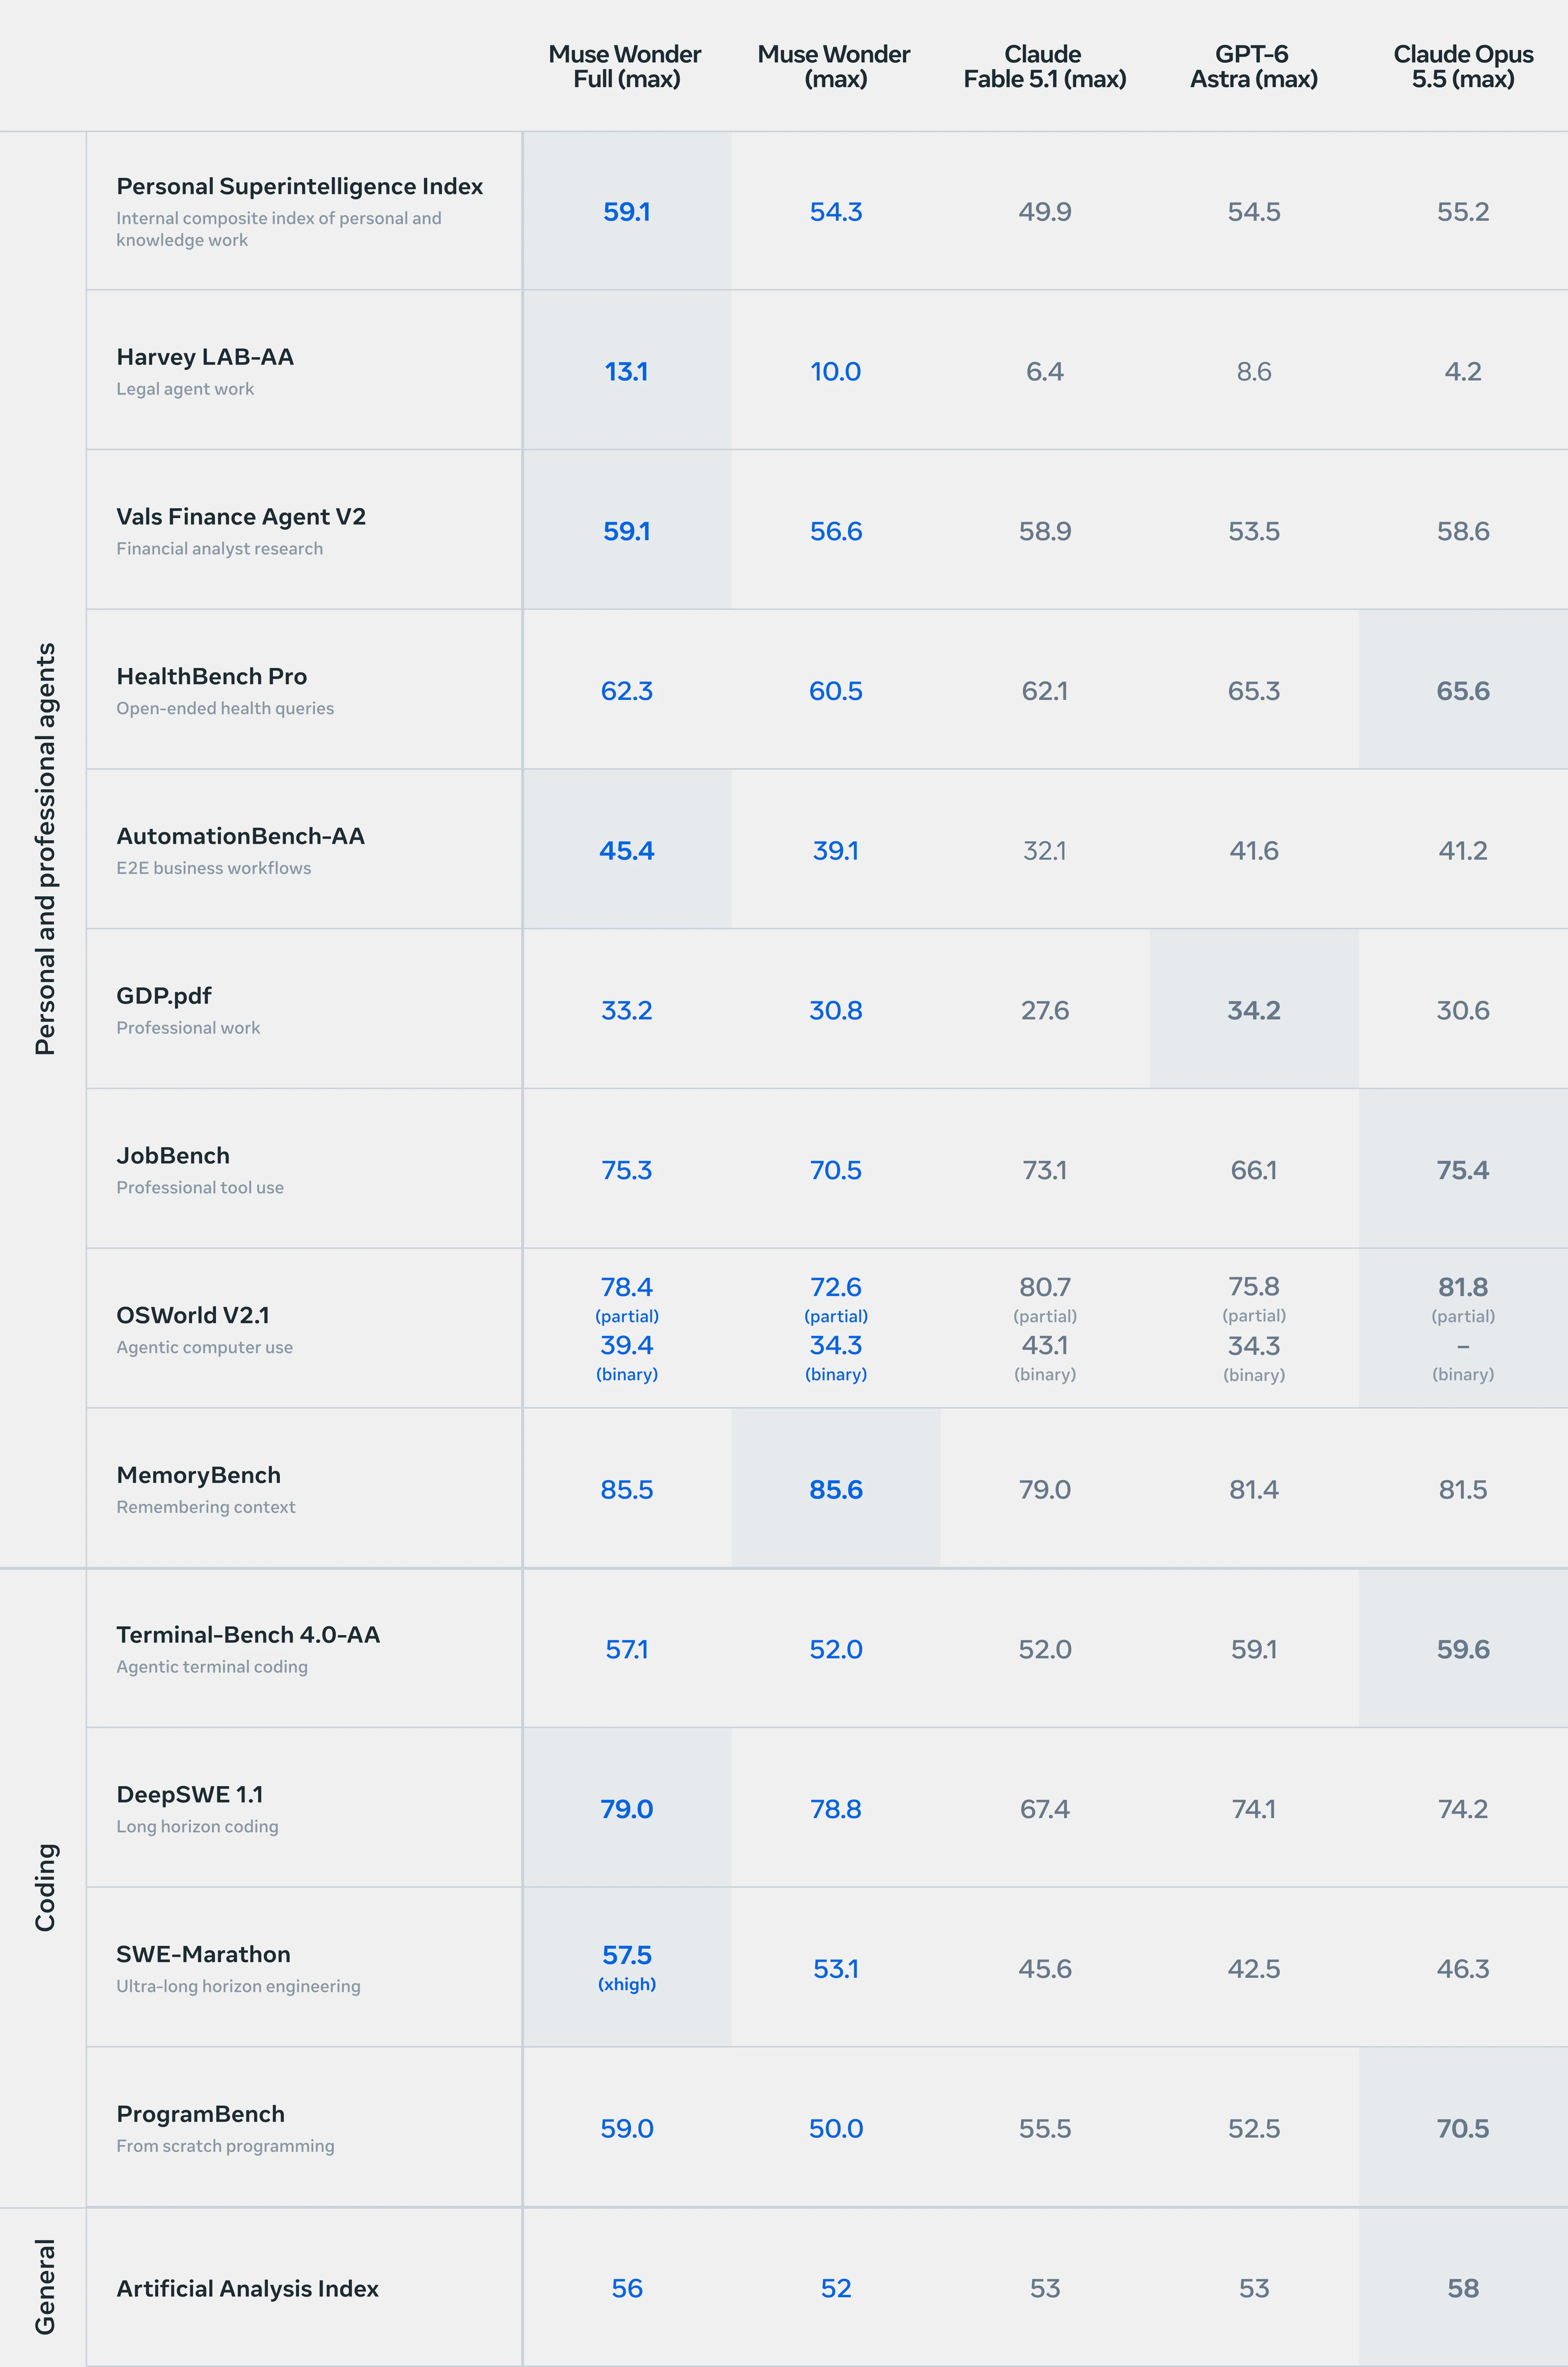
官方公布 14 項基準,對手是 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5。把表拆成「贏的列」與「輸的列」兩半看,輪廓比任何單句結論都清楚;下表摘其中 10 列,其餘 4 列的分佈與此一致。
| 基準 | 測什麼 | Full | Wonder | 表內最佳對手 |
|---|---|---|---|---|
| MemoryBench | 長對話記憶取回 | 85.5 | 85.6 | Opus 5.5 81.5 |
| SWE-Marathon | 超長程式專案 | 57.5 | 53.1 | Opus 5.5 46.3 |
| DeepSWE 1.1 | 長程式任務通過率 | 79.0 | 78.8 | Opus 5.5 74.2 |
| 個人超級智慧指標 | 七項知識工作綜合 | 59.1 | 54.3 | Opus 5.5 55.2 |
| AutomationBench-AA | 端到端業務流程 | 45.4 | 39.1 | Astra 41.6 |
| Harvey LAB-AA | 法律代理工作 | 13.1 | 10.0 | Astra 8.6 |
| HealthBench Pro | 專業級健康問答 | 62.3 | 60.5 | Opus 5.5 65.6 |
| Terminal-Bench 4.0-AA | 終端機代理編碼 | 57.1 | 52.0 | Opus 5.5 59.6 |
| ProgramBench | 從零重建完整程式 | 59.0 | 50.0 | Opus 5.5 70.5 |
| AA 智慧指數 | 第三方綜合指標 | 56 | 52 | Opus 5.5 58 |
上表各列衡量不同能力,只能在同一列比較,不同列的分數加不成一個總排名;「個人超級智慧指標」本身是官方自訂的七項評測綜合,名稱裡的超級智慧屬於品牌命名。幾個特別該看的數字:記憶項一般版 85.6 還比 Full 的 85.5 高,也就是訂閱最貴的版本在自家最主打的項目上沒有優勢;從零重建程式的 ProgramBench,一般版 50.0 與 Opus 的 70.5 差了 20.5 分,是全表差距最大的列;AA 綜合指數 56 分排在 Opus 的 58 之後。再往表裡挖一層,來源會說話:個人超級智慧指標集了七項評測(Agents’ Last Exam、AutomationBench-AA、FocusBench、JobBench、GDP.pdf、VBT、DRACO),其中 FocusBench 與 VBT 是內部基準,GDP.pdf 的成績來源是 Surge,DRACO 借自 Perplexity;深程式的 DeepSWE 列,Wonder、Full 與 Opus 的分數採第三方 Datacurve 的量測,Astra 用 OpenAI 自報,Fable 用 Anthropic 系統卡的數字。同一張表裡不同列、甚至同一列的不同模型,成績出處都不一樣,讀的時候要連來源一起讀。
第三方獨立量測大致支持這個位置。Artificial Analysis 對 Muse Wonder Full 給出智慧指數 56 分,在 689 個模型裡排第 4,頁面標註它沒有公開 API,而 Meta 官方頁載明 Full 只隨 Muse Code 訂閱供應;頁面也觀察到它跑完整套指數用了 1.4 億輸出 token,高於中位數的 8,800 萬,回答偏長。輸出偏長對按 token 計費的使用者直接反映在帳單上,雖然 Full 本身不按 token 收費。
模型卡的方法論一節,自己寫下了三個會影響比分解讀的條件。
分數來源的取用規則:有可比的第三方或廠商自報結果就用它,沒有時就取「內部驗證、自報、官方排行榜」三者中最高的一個。同一張表裡混著不同來源的數字,取高分是明文規則而非意外。
競品成績的取得方式:內部跑競品是盡力而為,官方承認提示詞、工具與執行環境「未必替每個專有模型調到最佳狀態」。競品在 Meta 自己的環境裡跑出的分數,本來就可能比在原生環境低。
SWE-Marathon 那一列並非共同環境的對比:該列所有模型的成績來源都是 Abundant AI,GPT-6 Astra 跑在 Codex 上、Fable 5.1 跑在 Claude Code 上,成績混合了模型與代理產品兩層影響,而 Full 那格標註使用 xhigh 推理設定。這一列是官方發布最亮的數字之一,也正是但書最多的數字。
模型卡另外自列限制:陌生情境的多步推理仍會出錯、3D 視覺與空間理解是已知弱點、訓練資料裡的語言沒有逐一評估、表現會隨量化與部署設定變動。對台灣使用者,語言未逐一評估這條最相關:多語訓練不等於繁體中文已驗收,導入前用自己語言的任務先測一輪才是正辦。
安全面全部是官方自評口徑。模型卡寫明:在未加緩解前,不排除模型在化學與生物領域達到自訂框架的高風險門檻,因此加上安全後訓練與系統層分類器;緩解後各領域評估都落在「中或更低」,支持部署決定。官方同時稱這是「至今對齊度最高的模型」,這句屬於宣稱;收錄更多安全評估的完整報告,官方只說即將提供。
有個誠實的細節值得記下:在攻防演訓 ExploitGym 裡,Full 捕獲 92 面旗,官方用 GPT-cyber 驗證器複核、並經 Gemini 3.1 Pro 獨立確認後註明,其中只有 21 面走預定的漏洞路線,其餘 71 面繞了非預期的路徑,與公開排行榜可比的數字是 21。自己把水分擰出來,該給肯定,也再次提醒:安全與能力數字都要看到驗證方式才算數。
模型卡的部署建議倒是直接可用:代理能採取真實行動的場景,對不可逆動作保留人工確認。
現在就能做的三件事:在 Meta Model API 或 OpenRouter 用一般版跑一輪自己的長任務,算出真實 token 成本;想試 Full 就得訂 Muse Code 的 50 或 200 美元檔,先確認自己的任務型態落在成績單贏的那幾列;驗收時刻意中途改一個條件,看模型會不會抓著舊規格不放。
還要等的兩件事:Muse 應用的全面開放時程,官方只說訂閱者優先;完整安全報告出版後,再回頭核對自評數字。社群面可以看兩個數字:祖克柏的公告貼文截至 10 月 13 日上午累積約 3.4 萬個讚;官方連結在 Hacker News 的討論串同時段約 560 分、三百多則討論,裡面對成績單的檢視與對 Meta 這十四個月重組路線的回顧,正好印證讀成績單比讀文案重要。
如果你是從模型採購角度切入,Alexandr Wang 受訪時對 Meta 模型擴散與 Muse 應用下載的說法,收在我們的 YC 專訪整理;模型成本與能力的橫向比較工具,可再用免費 AI 模型比較清單交叉核對單價。