TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

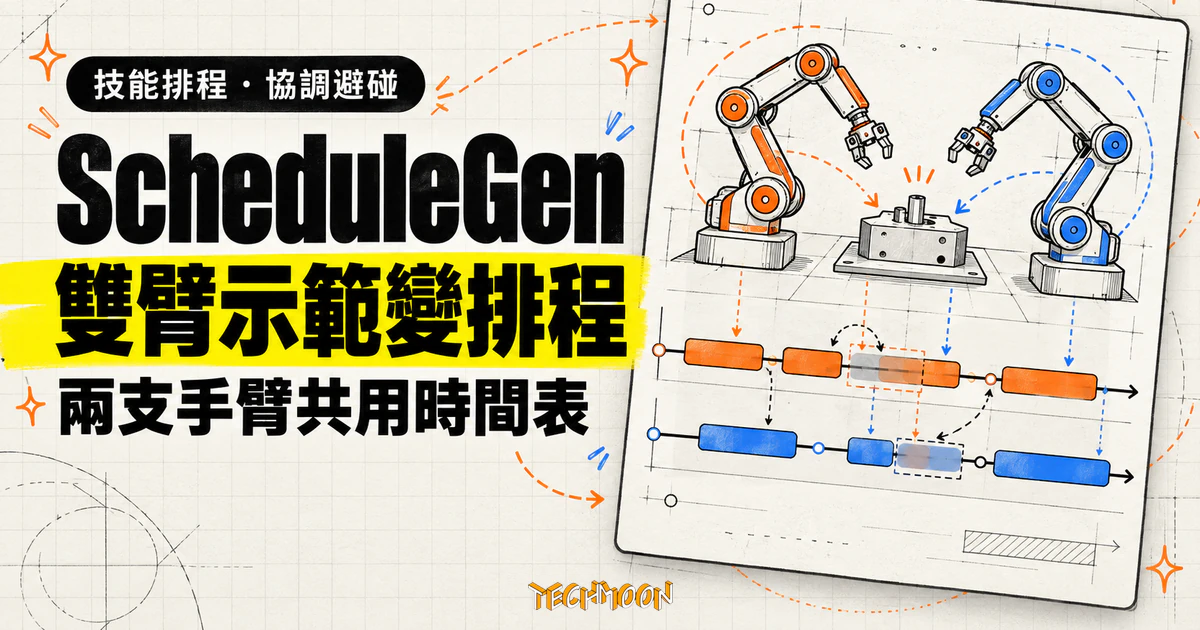
NVIDIA 與德州大學奧斯汀分校的 ScheduleGen 研究把多臂機器人的示範生成拆成兩層:接觸技巧沿用示範、轉場重新規畫,兩手何時等待或重疊交給混合整數線性規劃求解,排程本身也用 700 段固定路徑軌跡單獨驗證。79.6% 生成率、65.5% 策略成功率與真機 50–80% 各自量測不同的階段,直接互比會誤讀;程式碼未公開,是採用前最主要的邊界。
用 AI 摘要這篇文章:
NVIDIA 與德州大學奧斯汀分校的研究團隊,10 月 29 日把一份名為 ScheduleGen 的多臂機器人研究放上 arXiv,作者 Neel Jawale 於 10 月 30 日 18:04(UTC)公開介紹,換算台北時間是 11 月 1 日凌晨。這份研究處理的問題很具體:雙臂、四臂到人形機器人的訓練資料,靠少數人工示範要怎麼長出夠多的協同動作。它的做法是把「兩隻手什麼時候可以一起動、什麼時候必須等」交給整數規劃去排,接觸技巧照舊沿用示範,需要重新規畫的只有轉場路徑與時間。
先講結論。對已經有多臂硬體、也收得到來源示範的團隊,這份研究值得當成資料擴充方法的參考座標,因為它把排程這一層的功勞用乾淨的實驗單獨量了出來。但三組常被並列的成功率(79.6%、65.5%、50–80%)各自量不同的東西,直接相減或互相替換都會誤讀;把物體位置擾動加倍後,七個外部任務的策略平均只剩 25.0%;而且論文與專案頁都沒有提供程式碼,短期內想直接導入的人手上沒有可執行的東西。
作者在宣布貼文裡的一句話把定位講得很白:「多臂機器人合作能做更多事,但要教它們小心協調很難。」研究橫跨 28 個模擬任務變體與 8 個真機變體,涵蓋 YAM 雙臂、DROID 兩臂與四臂、GR1T2 人形機器人,以及 RoboDojo 這個外部基準的 X5 雙臂平台與 robosuite 的四個變體。在它之前,示範生成這條路的兩個代表作 MimicGen 與 DexMimicGen 分別處理單臂與雙臂,把整段示範搬到新初始狀態,不處理碰撞與運動學限制,遇到大幅變動的初始條件就容易失效。

多臂機器人的麻煩不在單手技能。一隻手會抓碗、另一隻手會放餐具,各自成立;一旦兩隻手的工作區重疊,先後順序、等待時機、同步點就會開始干擾結果。操作雙臂有多難,micro1 十月的 Dual-Arm Sim 評測給過一個數字:十個前沿模型在 800 次模擬試驗裡只完成 11 次。ScheduleGen 攻的是另一端,讓專職的機器人策略先在模擬裡看過夠多的協同資料。既有作法(例如 DexMimicGen 這類示範生成方法)把每隻手臂的軌跡各自搬到新場景再拼起來,遇到手臂交叉或碰撞多的佈局,常常拼出不可執行的組合。
ScheduleGen 把生成流程拆成三層。接觸片段以物件相對座標保存,碗換了位置,示範裡怎麼接近、怎麼拿住的關係仍然可用;連接各段技能的轉場動作,依關節限制與碰撞重新規畫;最後兩隻手臂的時間表交給混合整數線性規劃(MILP)求解,碰撞發生時用離散決策變數決定先後,約束的計算由 GPU 加速的碰撞檢查支撐。排好的軌跡要在模擬裡實際重播、通過任務成功檢查,才會進訓練集;若任一手臂的起點或終點本身就處於碰撞狀態,整個求解直接判定不可行,不會硬生出一條看起來合理的時間表。時間表長什麼樣,還可以靠目標函數調整:研究比了完成時間與三種次要成本(速度均勻、連續性、最短活躍區間)四種排法,同一組來源技能都能以 92.08% 到 94.16% 的生成率各做出 500 段資料,策略成功率 40% 到 50%。差別在協調風格,例如連續性成本會把手臂中途的停頓消掉,讓動作更像一氣呵成。
這個設計回答的協調問題,比「路徑不要相交」更細。論文裡的例子:一支手臂要先把杯中的物品倒進碗裡,另一支手臂必須等倒入完成才能去拿碗,太早朝碗移動還會擋住倒入路徑。這種等待是任務的一部分,不能為了衝高同時動作比例被壓掉;反過來說,沒有先後依賴、空間也不衝突的段落就該安排重疊,多餘的等待才會被刪掉。
這份研究最值得看的實驗,不是那些最高的成功率,而是一個把排程單獨隔離出來的對照。研究團隊拿了 RoboDojo 基準釋出的 700 段軌跡,固定每段的幾何路徑與任務順序,只重新安排兩隻手臂沿路徑前進的時間。結果 98.3% 的軌跡找到可行時序,總步數減少 14.98%,平均每段少 16.44%。換句話說,單單把時間排好、路徑完全不動,就已經省下超過一成的執行長度。
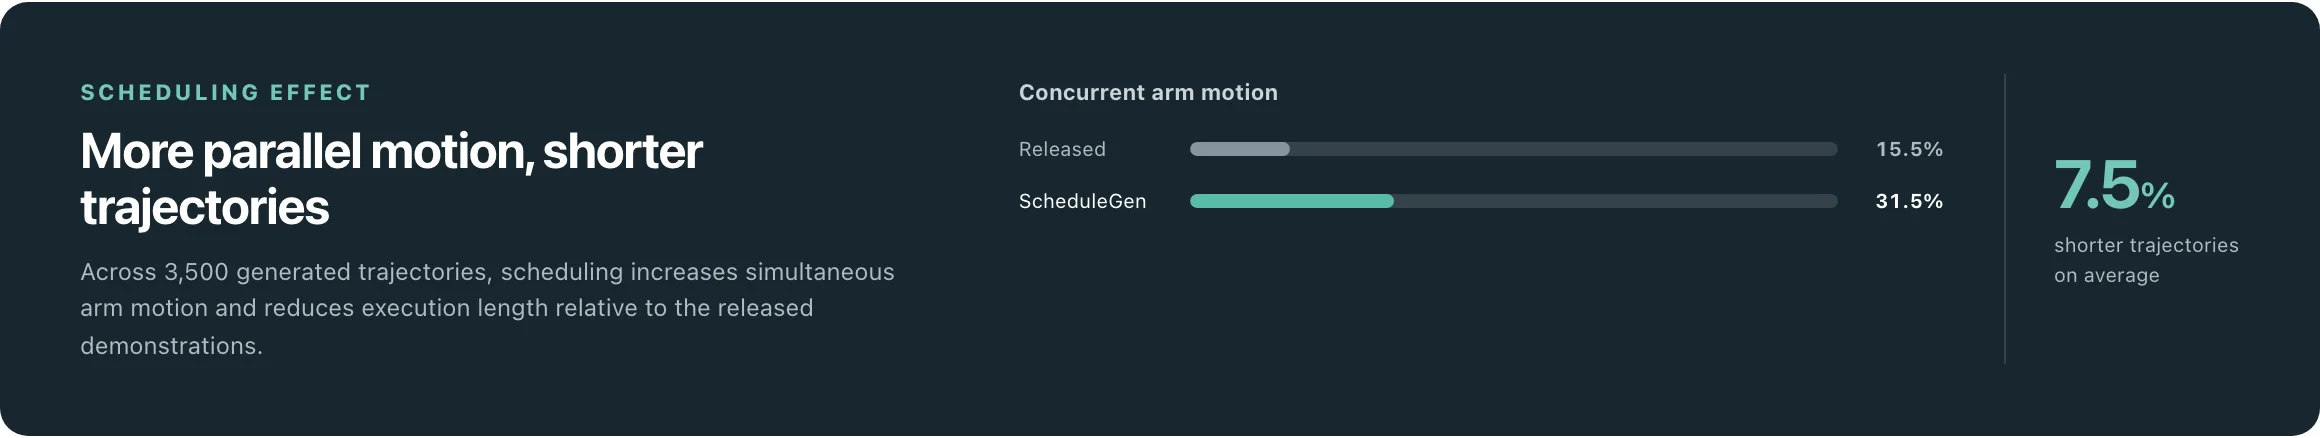
生成流程裡的量測指向同一件事。3,500 段用於訓練的生成軌跡,兩手同時動作的比例從釋出示範的 15.5% 提高到 31.5%,軌跡長度每個任務縮短 2.3% 到 11.1%,平均 7.5%。這組數字也劃出了解讀界線:同時動作比例翻倍,不等於產能翻倍,因為需要接觸、等待與同步的段落本來就壓不掉;7.5% 是執行軌跡的縮短,也不是整條資料管線的成本節省。
| 數字 | 實際量測的東西 | 在哪裡量 |
|---|---|---|
| 79.6% | 生成嘗試裡多少軌跡通過模擬重播、被收進訓練集 | 28 個模擬任務變體平均 |
| 65.5% | 用這些資料訓練出的策略,在模擬評測的成功率 | 同樣 28 個變體平均 |
| 50–80% | 真機上策略的成功率範圍 | 8 個真機變體,每個 20 次硬體試驗 |
79.6% 回答「資料做不做得出來」,65.5% 回答「模型學不學得會」,50–80% 回答「上了硬體還剩多少」。論文自己也寫得直白:兩個比率量測不同階段,排序不必一致。robosuite 的四個變體把這句話演出來了:CubeClose D0 上 DexMimicGen 的生成率 87.6% 高於 ScheduleGen 的 84.0%,策略成功率卻是 98% 對 100%;穿線(Threading)任務兩者策略都是 60%,生成率 24.7% 對 20.7%;TPA 是 39.7% 對 14.0%、策略 80% 對 66%;只有 CubeClose D1 是 DexMimicGen 生成不出任何可用軌跡、連策略都訓不起來的 0% 對 72.3%。
整體模擬成績的分布要分層看。17 個 Isaac Lab 變體的生成率落在 61.1% 到 98.0%,訓練出的策略 30% 到 100%;robosuite 的四個變體用另一種策略架構(BC-RNN-GMM),在 50 個評測試次拿到 60% 到 100%,對應的生成率是 24.7% 到 84%。同一套流程,不同模擬器、不同策略架構、不同任務,三個變因都在動,拿單一數字代表整份研究都會失真。
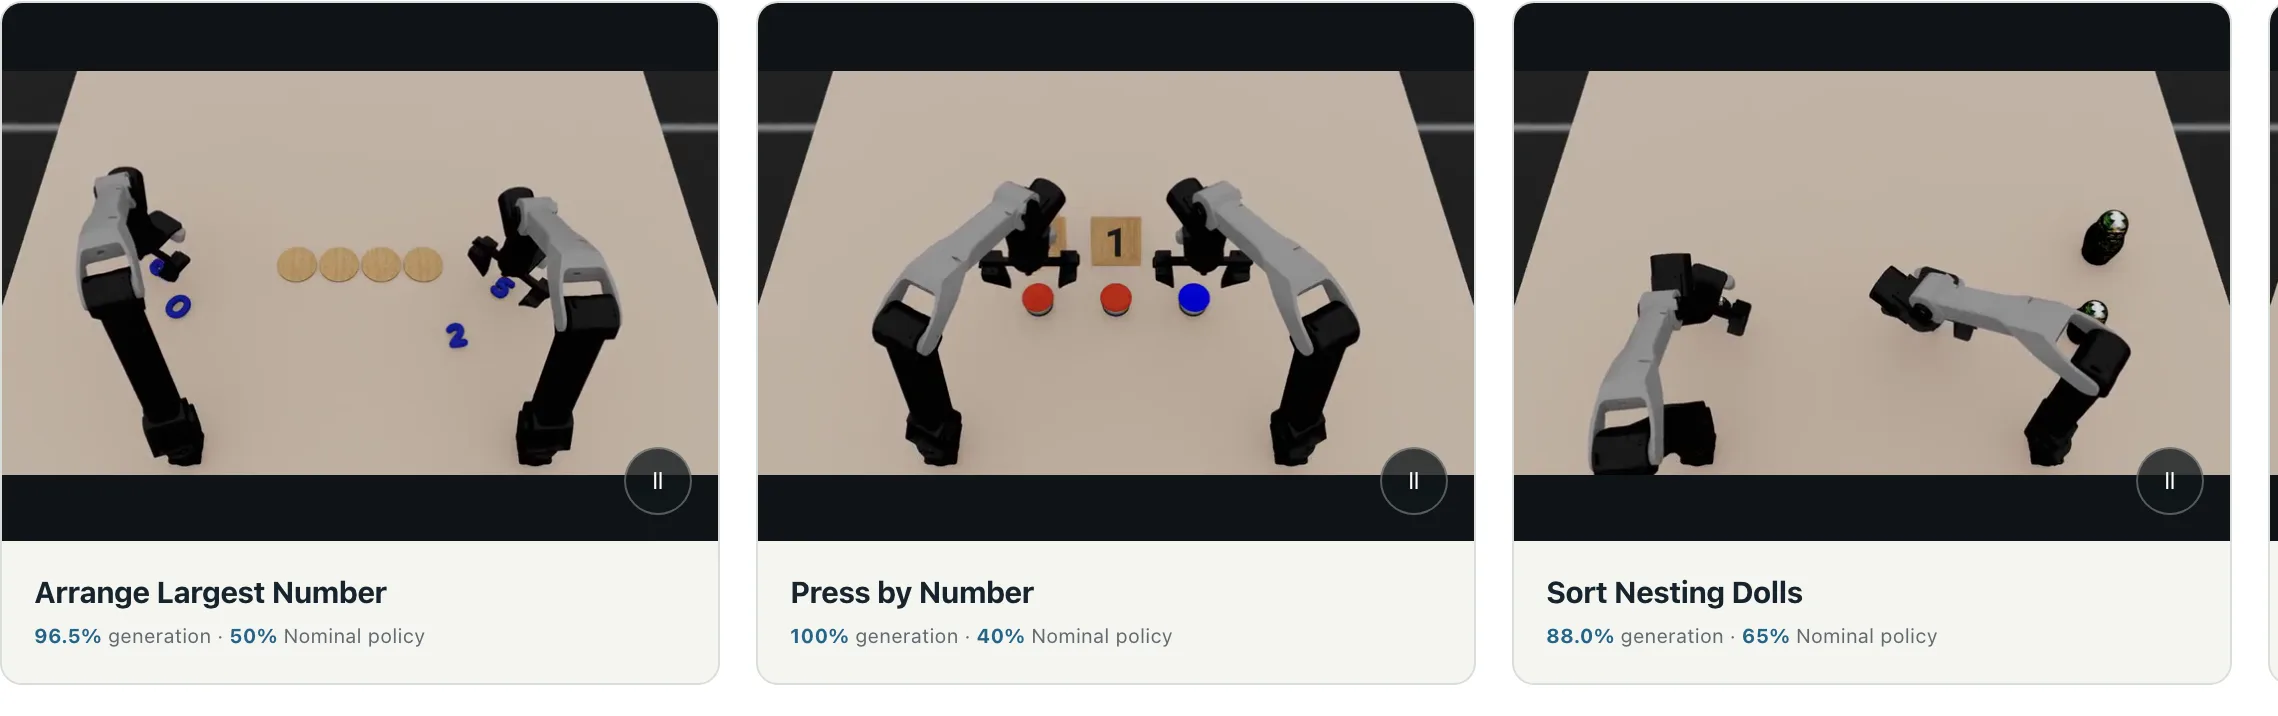
生成容易與學得會脫鉤的極端例子,在 RoboDojo 基準的七個外部任務(X5 雙臂模擬平台)裡。Press by Number 這個任務的資料生成率是完美的 100%,策略在 20 個保留的正常佈局試次裡只有 40%。七個任務的策略成功率落在 25% 到 65%,平均 47.9%;把物體位置擾動加倍再測,平均掉到 25.0%。專案頁的任務卡把這層差距攤得更開:Sort Nesting Dolls 與 Classify Objects 生成率 88.0% 與 75.5%,策略都有 65%;Swap T 生成率 78.0%,策略 25%,是七個任務裡最低的一個。生成的資料再乾淨,學習這一層的差距仍然存在。
在同源示範的比較裡(策略各評 50 個模擬試次),交叉佈局的差距最明顯:交叉雙臂堆碗 80% 對 42% 對 0%,交叉雙臂堆餐具 76% 對 58% 對 0%,兩臂交叉、箱內堆方塊 70% 對 0% 對 0%(依序為 ScheduleGen、調整過的 DexMimicGen、原始 DexMimicGen)。論文自己的總結是九個支援變體裡八個改善、一個打平,幅度要照這個讀。
來源示範的用法是另一個重點。交叉佈局上 DexMimicGen 拿到的是新收的交叉遙操作示範,每組約 20 分鐘,外加標註與停等點調整;ScheduleGen 直接沿用原本五段正常佈局示範,生成率 66.7% 與 68.0%,策略 80% 與 76%。對照組花了額外收資料的工夫仍只有 32.1% 與 11.2% 的生成率、30% 與 20% 的策略成功率。難佈局不必重收資料,是這套排程最實際的賣點。
四臂場景則是另一種情況:DexMimicGen 的介面只支援雙臂,根本不適用。ScheduleGen 在四臂堆塔的八個設定裡,生成率 63.4–95.1%,策略成功率 30–90%,來源技能用的是動作規畫產生的抓放段落而非遙操作。人形機器人 GR1T2 的倒螺帽任務,策略成功率從基準的 20–90% 提到 48–96%,顯示同一套排程換軀體仍然可用;人形機器人模仿學習的訓練成本,SuperMimic 先前已示範可以用單張 GPU 三小時壓下來。
真機評測都在 YAM 雙臂平台上,每個變體 20 次硬體試驗、用 1,000 段生成的模擬資料訓練、沒有真機微調,差別在來源。模擬到真實這條路線完全不用真實示範;真實到模擬再到真實這條路線,先收少量真機示範、重建可重播的模擬環境,再生成隨機化資料訓練,最後回到同一台機器。
| 路線 | 變體 | 模擬生成率 | 真機成功率 |
|---|---|---|---|
| 模擬到真實 | 堆碗(正常) | 96.5% | 75% |
| 模擬到真實 | 堆碗(交叉) | 66.7% | 80% |
| 模擬到真實 | 堆餐具(正常) | 71.2% | 80% |
| 模擬到真實 | 堆餐具(交叉) | 68.0% | 75% |
| 真實到模擬到真實 | 堆方塊 | 64.6% | 65% |
| 真實到模擬到真實 | 丟垃圾(正常) | 74.9% | 75% |
| 真實到模擬到真實 | 丟垃圾(跨杯) | 59.5% | 70% |
| 真實到模擬到真實 | 丟垃圾(跨杯加箱) | 63.6% | 50% |
四個模擬到真實變體平均 77.5%。第二條路線的方塊堆疊只用了五段校準過的真機示範;丟垃圾三種配置的示範都只在正常佈局收過,跨杯與跨杯加箱的資料全靠生成補上。表裡還看得到生成率與真機成績各走各的:堆碗(正常)生成率 96.5% 最高,真機 75%;交叉配置生成率只有 66.7%,真機 80% 與堆餐具(正常)並列四個變體最高。
20 次試次的樣本限制要放在心上:差一次就是 5 個百分點,所以 75% 對 80% 這種差距撐不起「哪種佈局一定比較好」的結論。交叉佈局的堆碗(80%)反而比正常佈局(75%)高,這也提醒真機成績的排序不宜過度解讀。這種先在模擬篩、再到真機量的評測邏輯,和 SO-101 Bench 的做法是同一個方向,差別在 ScheduleGen 的主角是資料生成,評測只是配套。
這套方法不是對著機器人說「幫我收桌子」就能生成資料。場景幾何、每段技能的接觸邊界、物件相對座標、任務先後限制,都要先備齊。RoboDojo 那組實驗的來源示範,用的是代理式標註流程(agentic annotation)把五段釋出示範轉成種子,模糊案例保留人工審查,而且所有標註都要通過重播與任務成功檢查,也就是說人力不是零,只是從收示範移到審標註。換了機器人或工作桌,關節範圍與碰撞關係跟著變,排好的時間表不能直接沿用。
程式碼狀態是目前的硬邊界。論文以 CC BY 4.0 授權公開,專案頁提供論文 PDF 與展示影片(影片以 3 倍速度播放),但兩邊都沒有程式庫連結,也沒有承諾釋出時間。想跟進的團隊,短期內能做的是用論文附錄的規格自己實作,或等後續版本。之後要引用這批數字,以 arXiv 版本與專案頁的現況為準,特別是程式碼釋出與其他機器人平台的再現結果,這兩件事一出現,對這套方法的評價就該重新算一次。
從人力分配的角度讀,這套流程把多臂資料收集的成本從「收很多示範」搬到「把少數示範標註成可轉移的技能」,再加上場景幾何與碰撞模型的準備。已經有遙操作收資料管線的實驗室,要吃進這套方法相對不吃力;還在等一個能直接跑的開源套件的團隊,現在能帶走的是它的驗收方式:生成率與策略成功率分開記、保留基準的調整版對照、真機用固定試次數量測。把這三件事放進自己的評測,比記住 79.6% 這個數字有用。