TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

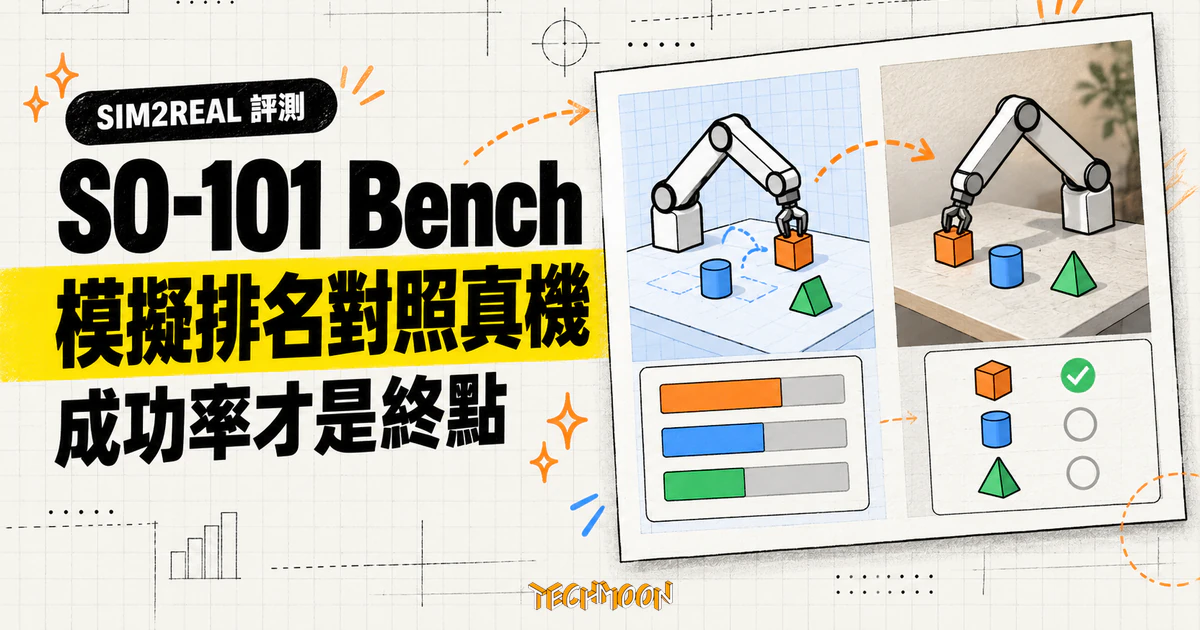
獨立研究者 Truman Hickok 於 10 月 28 日釋出 SO-101 Bench v1,用 Isaac Lab 為約 120 美元的 SO-101 機械手臂建立數位孿生基準:五個只在模擬訓練的政策拿到真機後排名完全不變,但模擬會高估成功率 9 到 31 個百分點,兩種分數不能互相替代。
用 AI 摘要這篇文章:
機器人研究裡有個反覆出現的疑問:政策在模擬裡拿高分,搬到真機還算數嗎?獨立研究者 Truman Hickok 在 10 月 28 日釋出的 SO-101 Bench v1,對這個疑問給了一組可以檢驗的數字:五個只在模擬環境訓練的政策,放到真實機械手臂上,名次一個都沒變;但每一個的分數都縮水,最多的縮了 31 個百分點。名次與分數從此要分開讀,這是這個基準最值得帶走的結論。
先把事件釘穩。SO-101 Bench 是一個跑在 Isaac Lab 數位孿生裡的機器手臂評測基準,主角是低成本的 SO-101 開源手臂。這次 v1 的釋出節奏相當完整:程式碼庫在 10 月 26 日落下 official release 提交,論文 10 月 27 日上傳 arXiv,作者 10 月 28 日在自己的帳號宣告 v1 釋出。釋出內容一次給齊:916 回合的主評測、3,629 段模擬示範加上約 4,400 段真機示範、10 個微調完的檢查點,以及一個會持續更新的官方排行榜。專案頁上的作者署名是獨立研究者,沒有掛任何機構。
對一般讀者,這則新聞沒有可直接使用的東西:沒有服務可訂閱、沒有 App 可安裝。它影響的是做機器人學習研究的人,以及正在猶豫要不要買一支 SO-101 手臂自己玩政策的開發者。以下把兩種讀者各自需要的判斷材料攤開。
整個基準的核心證據,是論文裡一組對照嚴謹的實驗:四個視覺語言動作模型(Galaxea 0.5、GR00T N1.7、pi 0.5、MolmoAct2-SO101)加上一個會寫程式的語言代理,全部只用模擬示範微調、不碰任何真機資料,然後在 45 個配對佈局上,於模擬與真機兩邊各跑一次。配對佈局的意思是桌面擺設與任務目標盡量相同,讓分數差異可以歸給領域差異,而非題目不同。
結果的兩面都值得單獨看。排名那面:五個政策的相對先後在兩邊完全一致,Spearman 排名相關 1.00,排名反轉指標 MMRV 為 0.000(95% 信賴區間上界 0.169)。分數那面:每個政策在模擬的分數都更高,落差從 8.9 到 31.1 個百分點,其中 GR00T N1.7 與 pi 0.5 各被高估超過 31 分。論文給出的使用建議寫得直白:模擬裡的成功率應該當成真機表現的上限來讀,跨政策的比較可以移轉,絕對完成率要回真機重測。
| 政策 | 模擬 | 真機 | 落差 | 逐回合一致率 |
|---|---|---|---|---|
| GPT-6.1 Sol(PyRUA)+ Galaxea 0.5 | 84%(38/45) | 64%(29/45) | +20.0 | 76% |
| Galaxea 0.5 | 67%(30/45) | 53%(24/45) | +13.3 | 64% |
| GR00T N1.7 | 56%(25/45) | 24%(11/45) | +31.1 | 56% |
| pi 0.5 | 49%(22/45) | 18%(8/45) | +31.1 | 64% |
| MolmoAct2-SO101 | 24%(11/45) | 16%(7/45) | +8.9 | 91% |
同組權重在 45 個配對佈局的成績(arXiv 2610.36420 表 6,10 月 27 日提交版)。
逐回合的細節裡藏著一個提醒:配對回合的二元結果只有 56% 到 91% 的比例兩邊相同,論文因此把分析重心放在條件層級的對應,而非單一回合的重現。換句話說,這個基準證明的是模擬能保留「哪些任務難、政策為何失敗」的結構,不是每一次出手都會重演。失敗方式的組成也支持這一點,這組數字出自論文另一個訓練對照實驗:見過物件上,真機與模擬的失敗都以放置不準為主(69% 對 62%);未見過類別上,兩邊都轉為語意或抓取錯誤,失敗混合的總變異距離只有 0.13。
論文裡還有另一組常被混為一談的相關數字,值得拆開:作者另外微調了兩個 GR00T N1.6-3B 政策,一個只用真機示範訓練、在真機上評,一個只用模擬示範訓練、在模擬裡評,跨 906 個配對回合,前者完成 61%(552/906)、後者 45%(409/906),差距 15.8 個百分點,但在 15 個條件層級上 Pearson 0.86、Spearman 0.74。這組實驗同時改了訓練資料與評測領域兩個變因,論文明言它不能把絕對差距歸因給模擬器本身;它回答的問題是難度結構有沒有被保留,答案是有。排名移轉、分數校準、訓練資料移轉,是三個不同的問題,這篇論文把三者分乾淨了,這在機器人評測文獻裡少見。
SO-101 Bench 走的是 real2sim2real 路線,白話講就是三步:把真實的桌面與手臂掃進 NVIDIA Isaac Lab 重建一份數位孿生,訓練與大部分評測都在孿生裡跑,最後把同一組權重放回實體手臂驗收。SO-101 本身是 TheRobotStudio 的開源機械手臂,搭配 LeRobot 生態,已經是機器人學習圈最常見的入門硬體之一;模擬重建的價值在於評測可以重複、便宜、把變因控制住,代價則是保真度永遠要被質疑,這也是上面那組排名實驗存在的理由。
基準測的是語言條件的空間操作:手臂要聽懂「把東西放進箱子」「放在 A 旁邊」「放在 A 和 B 之間」「往指定方向移動」這類指令,並放對位置。放入容器再分成一個物件與四個物件兩種,所以四種任務形成五個計分家族。全部 916 個主評測回合攤在 15 個格子裡(五個任務家族乘上三種物件切分),均等加權計分。
物件切分是設計上最見功夫的地方。138 個物件分成三層:48 個訓練時見過、43 個是見過類別的新實例、47 個是全新類別。新實例與新類別分開,才能追問政策失敗在哪一層:是換個外觀就掉分,還是連見過的東西都放不準。實測結果顯示空間任務加上物件新奇性是最大瓶頸,最強的學習政策從見過物件到未見過類別,平均掉了 30 到 43 個百分點;抓取熟悉的物件則基本過關,最強政策單物件入箱有 90% 以上的成功率,空間擺放任務掉到 34% 到 44%。
另有三個子集合各有用途:178 回合的 ROBUST 換掉背景與手臂顏色、48 回合的 PLAN 要求把物件轉個角度才塞得進去、51 回合的 MEM 在遮擋下記住邊界物件的位置。子集合彼此重疊,回合數不能相加。ROBUST 的結果把政策分成兩群:Galaxea 0.5 與 GR00T N1.7 換外觀後成績幾乎不動,LaWAM 從 39% 掉到 18%,ImageWAM 從 43% 掉到 34%,視覺穩健性與操作能力的強弱是兩件事。MEM 則畫出另一條線:學習政策最高只到 47%,由原生帶記憶機制的 InternW0-Delta 拿下,遮擋下的空間記憶對多數政策仍是難題。
訓練端的帳也公開:3,629 段模擬示範(18.5 小時、30 fps)與約 4,400 段真機示範(約 20 小時)分別釋出;每個學習政策用同一份模擬示範、同一個預算微調:4 張 A100-80GB 跑 36 小時,檢查點用 39 個保留驗證回合挑選。把預算寫死是雙面刃:比較是公平的,但論文也提醒,同樣 36 小時內各政策吃到的訓練樣本數相差 30 倍,分數低的模型可能只是預算內沒吃飽,不能讀成能力上限。排行榜尾部的兩個數字就是這句提醒的註腳:MolmoAct2 從官方的 SO-100/101 檢查點出發(20.9 分)並沒有贏過從一般檢查點出發(23.8 分),先備的肢體經驗沒有轉成任務能力;FLUX 3 Action 只拿到 8.0 分,但它的微調配方只用了官方完整配方十分之一不到的樣本。
排行榜上最醒目的差距,在代理與端到端模型之間。916 回合主評測裡,最強的兩個學習政策 InternW0-Delta(61.4 分)與 Galaxea 0.5(60.8 分)統計上並列;寫程式的語言代理 GPT-6.1 Sol,在 PyRUA-Lean 框架裡把抓取交給 Galaxea 0.5,拿到 83.2 分,還解掉了 75% 的旋轉裝入題,而學習政策在這個子集合沒有一個超過 17%。真機上也有專屬於代理的題目:八個「四個學習政策全數失敗」的回合,只有代理解掉;反過來,代理解掉了 Galaxea 單獨失敗的十個回合,也在 Galaxea 成功的五個回合上失手,兩者是互補關係,代理在真機上也以 64% 對 53% 領先它呼叫的抓取政策。
代理的領先從哪來,論文用一組 60 回合的固定消融拆開了。同一個 Sol 模型直接呼叫工具是 35%,換進 PyRUA-Lean 框架升到 67%,再把抓取環節交給 Galaxea 0.5 到 85%。框架選擇搬動了 50 個百分點,比換模型的幅度更大:固定框架與抓取政策後,Sol 85%、Gemini 4 Argon 77%、DeepSeek V4.1 Flash 65%、MiMo v2.6 Pro 55%。成本帳也列得誠實:60 回合下 Sol 花 14.68 美元,Argon 最貴的 74.25 美元卻沒有贏過 Sol,DeepSeek 只要 1.40 美元拿 65%(這個模型的來歷可參考我們先前的發表報導)。這組數字對選型的人很實用:先選框架與分工,再挑模型,順序錯了花錢也補不回來。
代理的代價在時間。專案頁列出真機回合的中位耗時:Sol 197 秒,Galaxea 0.5 只要 38 秒,GR00T N1.7 同樣是 38 秒。差別在代理每步都要等語言模型推理,模擬器在它思考時是暫停的。要速度的場景,端到端政策仍然有自己的位置。
作者在宣告推文裡給的定位是約 120 美元機器人的基準;論文裡的對照寫法是 SO-101 約為一支 ALOHA 手臂價格的四十分之一。兩個數字都指向硬體便宜,但把它讀成 120 美元就能重現整套評測,會漏掉三筆帳。
硬體之外的帳單:評測環境要 NVIDIA Isaac Sim 5.1 加 Isaac Lab 0.54,配一張 RTX 級顯示卡,另下載約 2GB 的場景資產;政策以 HTTP 服務的方式受評,評測器把影像與關節狀態丟給政策伺服器、取回動作序列,相容既有生態。訓練的帳更大,4 張 A100 跑 36 小時不是多數人桌上的配備,好在 10 個微調檢查點全部放在 Hugging Face 上可以直接下載,想比較政策的人可以跳過訓練這關(想在自己機器上省著訓的思路,可參考我們介紹過的單卡訓練案例)。授權的帳最容易被忽略:repo 根目錄沒有 LICENSE 檔,GitHub 的授權偵測顯示為 None;pyproject.toml 檔頭雖有一行 BSD-3-Clause 的 SPDX 宣告,那段版權塊的聲明人是 Isaac Lab 專案開發者,屬承接上游模板的痕跡,對這套評測程式本身沒有構成授權。程式碼公開不等於取得重用授權,想在商業專案裡搬這套評測程式的人,需要先向作者確認授權意圖;訓練資料與示範集則依 Hugging Face 上的各自授權頁為準。
這次釋出改變的位置,要對照既有作法才看得清楚。論文盤點的四個 2026 年 SO-101 基準,全部在實體硬體上評測、用真機示範做任務適應:有的分析四個任務上的失敗與復原,VLA-REPLICA 用 1,100 美元以下的套件跨站重現,ArmnetBench 在手臂農場上評了 2,518 次出手、覆蓋七個政策,Spa-Bench 測熟悉物件與空間概念的重新組合。實體評測直接,但每一次出手都要時間與人力,大規模篩政策很貴。
SO-101 Bench 補上的是另一個位置:評測主體搬進模擬,真機只留給驗收。依作者的盤點(原文用語是就其所知),這是第一個語言條件、帶保留物件切分、且模擬排名經真機驗證的 SO-101 基準。這個 first 宣稱的邊界也寫得清楚:它沒有說自己是第一個 SO-101 基準,也沒有說模擬評測就此取代實體評測;搭配前一節的入口成本看,比較務實的讀法是政策篩選的成本被壓低了,驗收這一步仍然留在真機上。把訓練素材與評測環境標準化,也是這一年機器人圈共同的走向,NVIDIA 的SimReady 模擬素材庫與把真實工作影片煉成訓練資料的Maxinsights,都在解同一條鏈上的不同環節。
做機器人學習研究的人,這次釋出值得立刻動手:45 回合的公開驗證集(15 個格子每格 3 回合)、評測腳本、10 個檢查點、兩份示範資料集與排行榜結果的 CSV 檔都在,可以先把自己的政策在驗證集上對齊,再決定要不要進主評測;有 SO-101 手臂與一張 RTX 卡的人,2GB 資產下載完就能在公開驗證集上重現評測流程;主評測的未見過類別物件、背景與手臂配色刻意不釋出,測試集才會保持乾淨。只想知道結論的讀者不用動:記住排名可移轉、成功率會被高估這組對比,日後看到任何模擬分數就多一層警覺。
未確認的事項也要放在桌上。官方排行榜是動態的,會隨新政策進榜更新,榜上分數以 10 月 27 日論文版為準,之後引用任何榜上數字都該附日期;論文未標註投稿去向,同儕審查狀態未知;v1 之後的版本節奏也沒有公布,從 Hugging Face 資料集的迭代紀錄看,這套基準在正式釋出前已經演進過多個內部版本,未來再改版不意外。這組結論的保存期限跟著排行榜走,下次大改版或重磅政策進榜時,結論需要回查。