TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Phonic 於 10 月 29 日發表語音對語音模型 Phonic-1,主打來電者說話期間就先呼叫工具查資料,同日宣布 2,750 萬美元 A 輪。AA 綜合指數 87.1 分排第一,任務成功率與延遲兩欄另有對手在前;每分鐘 0.07 美元起、Pro 月最低 200 美元,繁中表現尚未確認。
用 AI 摘要這篇文章:
Phonic 在 10 月 29 日發表第一款自有模型 Phonic-1,同一天宣布 2,750 萬美元 A 輪募資,由 First Round 領投,Lux Capital、Felicis、Definition 與 Essence VC 參投,累計募資 3,150 萬美元;創辦人 Moin Nadeem 的宣布貼文落在台北時間當天 23 時 39 分。公司把自己定位成「語音對語音模型公司」,成立兩年多只做這一條路線,團隊背景標註來自 MIT、Stanford 與 CMU,天使輪投資人名單上有幾張熟悉的面孔:Hugging Face 的 Clement Delangue、Vercel 的 Guillermo Rauch、Dropbox 的 Arash Ferdowsi、Replit 的 Amjad Masad 與 Naval Ravikant 等。客戶名單上有 Ashby、Maven AGI、Rho 與一家不具名的財富 50 大 IT 基礎設施公司,官方稱通話已涵蓋六大洲;Ashby 共同創辦人暨工程副總裁 Abhik Pramanik 在公告裡的說法是「為了模型而來,找到的是合作夥伴」,該公司的 AI 面試服務用 Phonic 跑了 25 個國家。要判斷這次發表跟自己的專案有沒有關係,其實只需要回答三個問題:它在時間軸上到底改了什麼;「榜單第一」的宣稱放回榜單逐欄核對後剩下多少;真的要接,每分鐘計費與語言條件構成什麼樣的門檻。
目前多數語音代理走的是三段接力:一套系統先把來電者的話聽寫成文字,另一個模型決定怎麼回應,最後再用語音合成把答案念出來。這條級聯路線的問題,官方在公告裡講得很直白:逐字稿是一份有損的複本,來電者聲音裡的挫折感、回答前的長停頓、說自己名字的語氣,都在轉成文字的過程中不見了。這也是 Tazo 之前提出的論點:只讀逐字稿的語音代理,等於放棄了聲音裡的決策訊號。Phonic-1 走語音進、語音出的路線,音訊直接進模型,中間不經過聽寫轉文字這一步。
在這個基礎上,官方宣稱的差異化才是這次發表真正值得記的部分:Phonic-1 可以在來電者還在說話的回合內就呼叫工具。傳統做法要等對方說完、說一句「我查一下」、然後才開始查資料;Phonic 的設計是聽到旅行地點就先發查詢,等輪到回答時資料已經備妥。用官方自己的句子說,它是「唯一能在來電者說話期間就行動的模型,答案在對方停下來時已經準備好」。這句話裡的「唯一」屬於公司行銷用語,沒有第三方能替排他性背書;但「把查詢搬進說話時間」這個方向本身,確實是等待體驗的結構性改變,Heartbeat 先前讓語音代理邊聽邊查、把回答等待壓低 36.4% 的實驗,已經從另一條路驗證過這個時間軸的價值。
官方給了一通約 44 分鐘、包含 123 次工具呼叫的示範電話當證據:伴娘打電話到巴西一家飯店,請 AI 協助安排單身派對的預訂,整段對話連逐輪延遲與每次工具呼叫都攤在平台介面上。這是官方挑選的展示,不代表每一通長電話都這麼穩,但它至少把「邊聽邊做」攤成了可以逐輪檢視的紀錄。
電話對話的另一個現實是雙方不會乖乖輪流講話:來電者會插話、會附和、會在你講到一半時打斷。Phonic 針對這種全雙工情境做了後訓練,官方說法是能聽懂語氣、在吵雜環境裡處理換手發言,並用接近真人的方式回應;Cekura 的獨立測試給了它的插話處理 5 分制裡的 4.88 分,p90 回應時間 1.81 秒。這些分數量的是互動品質,與答案正確與否是兩件事,驗收時要分開看。
不過「語音對語音」不等於整包服務只有一顆模型,這是官方文件自己畫出來的邊界。產品頁明寫 Phonic 用前沿模型作為監督代理,協助工具呼叫與推理;換句話說,音訊互動層是 Phonic-1 自己,推理與工具編排這層還有其他模型在分工。開發文件裡的代理設定也反映了這種取捨:model 欄位在官方範例填 phonic-1,說明只寫省略時採用目前的預設模型,沒有指明型號,intelligence_level 有 standard 與 high 兩檔,官方說明寫 high 用更強的模型處理複雜推理,standard 針對低延遲最佳化。同一個產品名下,深度與速度是要自己選的,串接前得先想清楚每一通電話要的是哪一邊。
公告開頭的成績句是「Phonic-1 拿下 Artificial Analysis 語音對語音指數第一,並以最低延遲交付代理任務的最高成功率」。截至 10 月 30 日,把這句話放回各榜單逐欄核對,會得到一幅比行銷句更有用的圖。
先看組成。Artificial Analysis 的語音對語音指數由四個部分加權組成:語音推理(Big Bench Audio 資料集)、代理表現(τ-Voice 客服情境的解決比例)、競技場偏好(真人在同一情境各用兩個匿名模型後的偏好積分,只收有工具呼叫能力的模型)、任務成功率(最後完成任務的正確工具呼叫比例)。照這個組合,Phonic-1(High 設定)以 87.1 分排第一,領先 Grok Voice 3.0 的 86.9 與 GPT-Live-1(Astra, medium)的 83.2,綜合第一確實成立。拆到單欄,代理表現欄 79.9% 是全表最高。但任務成功率欄 Phonic 是 92.3%,排在 Grok Voice 3.0 的 94.8%、Grok Voice 2.0 的 94.6% 與 Gemini 3.8 Live 的 93.2% 之後,名列第四;首次出聲平均 0.61 秒,也慢於 Eleven Realtime v1 Max 的 0.57 秒。行銷句裡的「最高成功率」對得上的其實只有代理表現那一欄,「最低延遲」在同表的首次出聲欄也站不住。競技場偏好積分也一樣:Phonic 拿 1012,Gemini 3.8 Live 的 1074 與 Gemini 3.1 Flash Live High 的 1062 都更高,人類評審的偏好顯然不只看答題。不過 Phonic 的語音推理拿到 99%,與 Eleven Realtime v1 Max、Grok Voice 3.0、Qwen Audio 3.0 Realtime Plus 並列全表最高;AA 另量到它的 Big Bench Audio 子集輸入音訊成本是每小時 4.20 美元,落在中間地帶。產品首頁另一句「600 毫秒內回應」與 AA 量到的 0.61 秒方向一致,口徑不同,倒是沒有膨風。
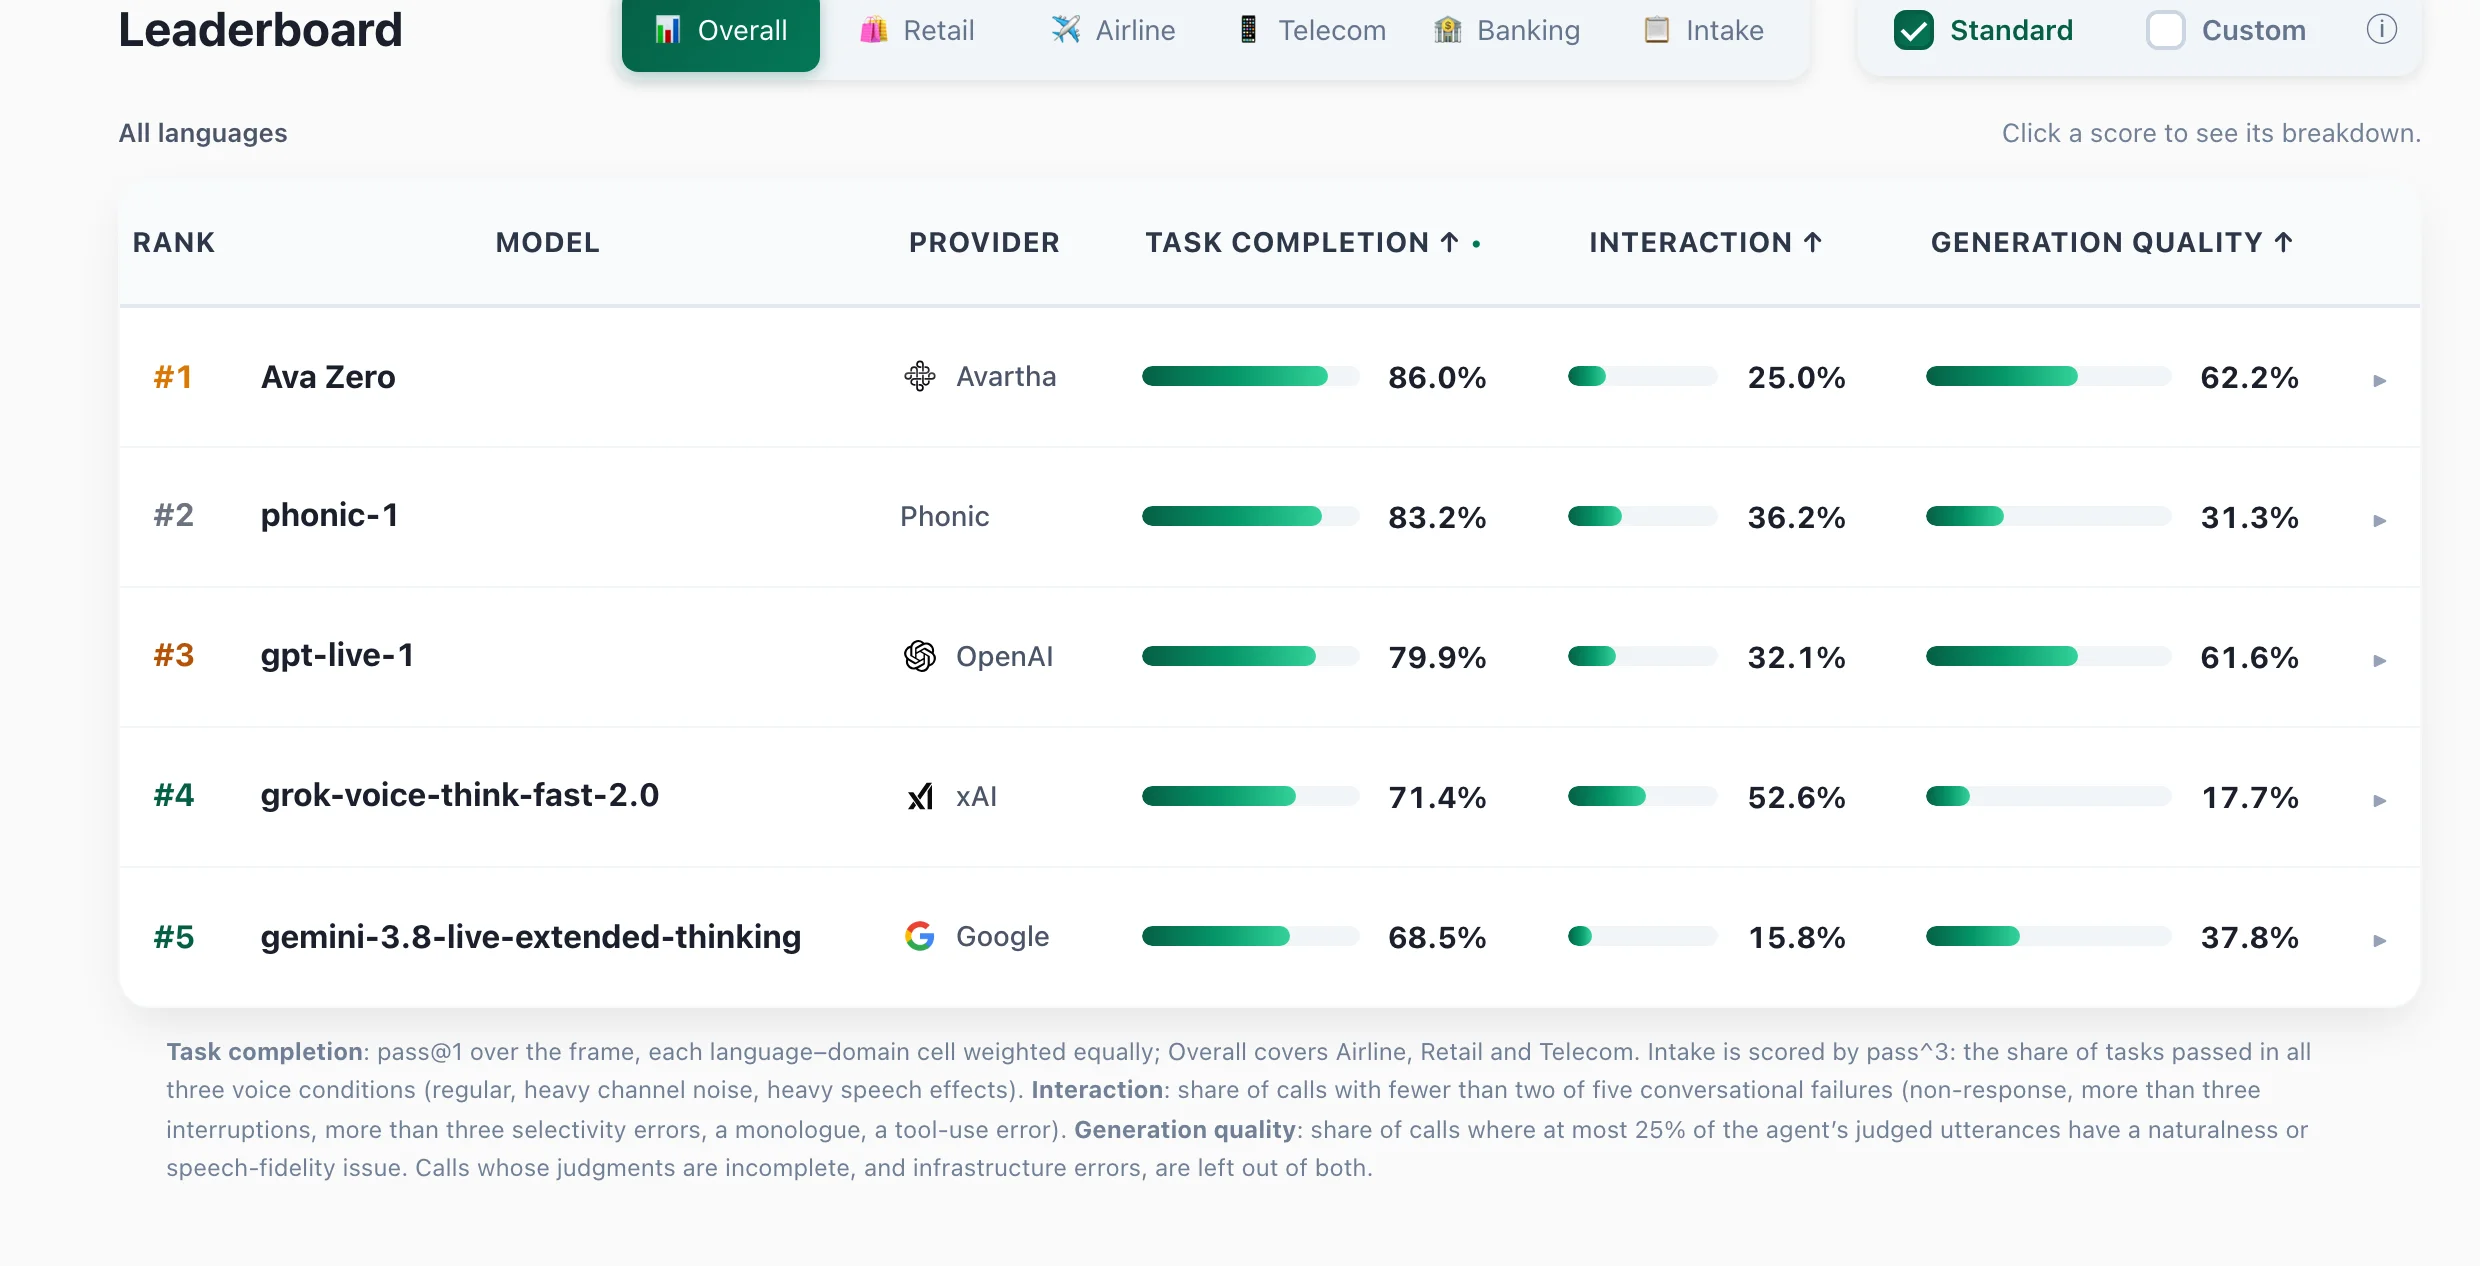
第二份榜單是 Sierra 的 τ³-Voice,公告引用了它的多語任務完成率:Phonic-1 得 83.2,高於 GPT-Live-1 的 79.9 與 Gemini 3.8 Live Extended Thinking 的 68.5。數字全部正確,但公告沒提的是:這份榜的第一名是 Avartha 的 Ava Zero,86.0%,比 Phonic-1 高了將近 3 分,Phonic 在這份榜上其實排第二。
第三份是 Cekura 的語音代理基準,頁面標示最後更新於 10 月 22 日,也就是公告前一週,Phonic-1 已在榜上。這份測試讓各模型透過 WebRTC 實際接聽 82 個客服情境、每種跑三次:Phonic-1 以三次全過率(PASS³)90.2% 排第一,預訂類通話成功率 97.7%,沒有一通讓來電者懸在電話上等不到回應,回應時間中位數 1.63 秒,量到的每分鐘成本 0.060 美元。同一份獨立測試也記了兩筆缺點:來電者說「晚點再打」時,它會直接掛斷而沒有先回應對方;Medicare 移交備註或路由細節偶爾存錯。第三方測試的價值就在這裡,優點與毛病一起給。
| 榜單與欄位 | Phonic-1 | 該欄最高 | 讀法 |
|---|---|---|---|
| Artificial Analysis 語音對語音指數 | 87.1,第一 | 就是它自己 | 綜合加權成立 |
| AA 代理表現(τ-Voice 情境解決率) | 79.9%,第一 | 就是它自己 | 行銷句的真實依據 |
| AA 任務成功率 | 92.3%,第四 | Grok Voice 3.0 的 94.8% | 「最高成功率」對不齊這欄 |
| AA 首次出聲(秒) | 0.61,第二 | Eleven Realtime v1 Max 的 0.57 | 「最低延遲」在這欄也非第一 |
| Sierra τ³-Voice 多語任務完成率 | 83.2%,第二 | Ava Zero 的 86.0 | 公告未提第一名是誰 |
| Cekura PASS³ 三次全過率 | 90.2%,第一 | 就是它自己 | 公告前一週已上榜 |
表中數字以 10 月 30 日各榜單頁面為準,榜單會隨新模型與新對測滾動,名次是快照不是身分證。
自然度方面,官方引用第三方盲評:評審聽各模型對同一段來電音訊的回應,多數時候偏好 Phonic-1。但同一批測試拉真人對照時,真人約贏六成,官方自己也承認自然度還有很大改善空間,並列為下一個研究重心。敢把「還輸真人四六波」寫進公告,算是誠實的自我標註,也提醒了採購方:自然度競賽還沒有終點。
計費結構很單純:按對話分鐘數計價,定價頁明言不另收語言模型逐 token 轉嫁費。Starter 每分鐘 0.07 美元、無最低消費,附 10 路並發通話、10 個代理與 3 個工作區席位;Pro 每分鐘 0.065 美元,但掛每月 200 美元最低消費,官方換算約當 3,100 分鐘,附 50 路並發、50 個代理、30 個席位與私人 Slack 支援;企業方案客製,含自架或 VPC 部署、HIPAA 的 BAA、稽核日誌與前進部署工程師。分水嶺在算式裡:月通話量低於約 2,860 分鐘(200 美元除以 Starter 單價,約 48 小時)時 Starter 較省,官方換算的 3,100 分鐘只是把最低消費按 Pro 單價折抵的另一種說法。拿一個每月 5,000 分鐘的客服專案算,Starter 是 350 美元,Pro 帳面 325 美元、最低消費已經覆蓋,確實略省;但每月只有 1,000 分鐘的小專案,Starter 付 70 美元就好,Pro 仍要吞下 200 美元最低消費,單價優勢要量夠大才吃得到。這與 GPT-Live-1 API 把語音分鐘與後端模型分開計費是兩種計費哲學:一種把推理成本包進每分鐘單價,一種讓你自己選後端、自己算帳,成本模型完全不同,比較時要拿同一種口徑。
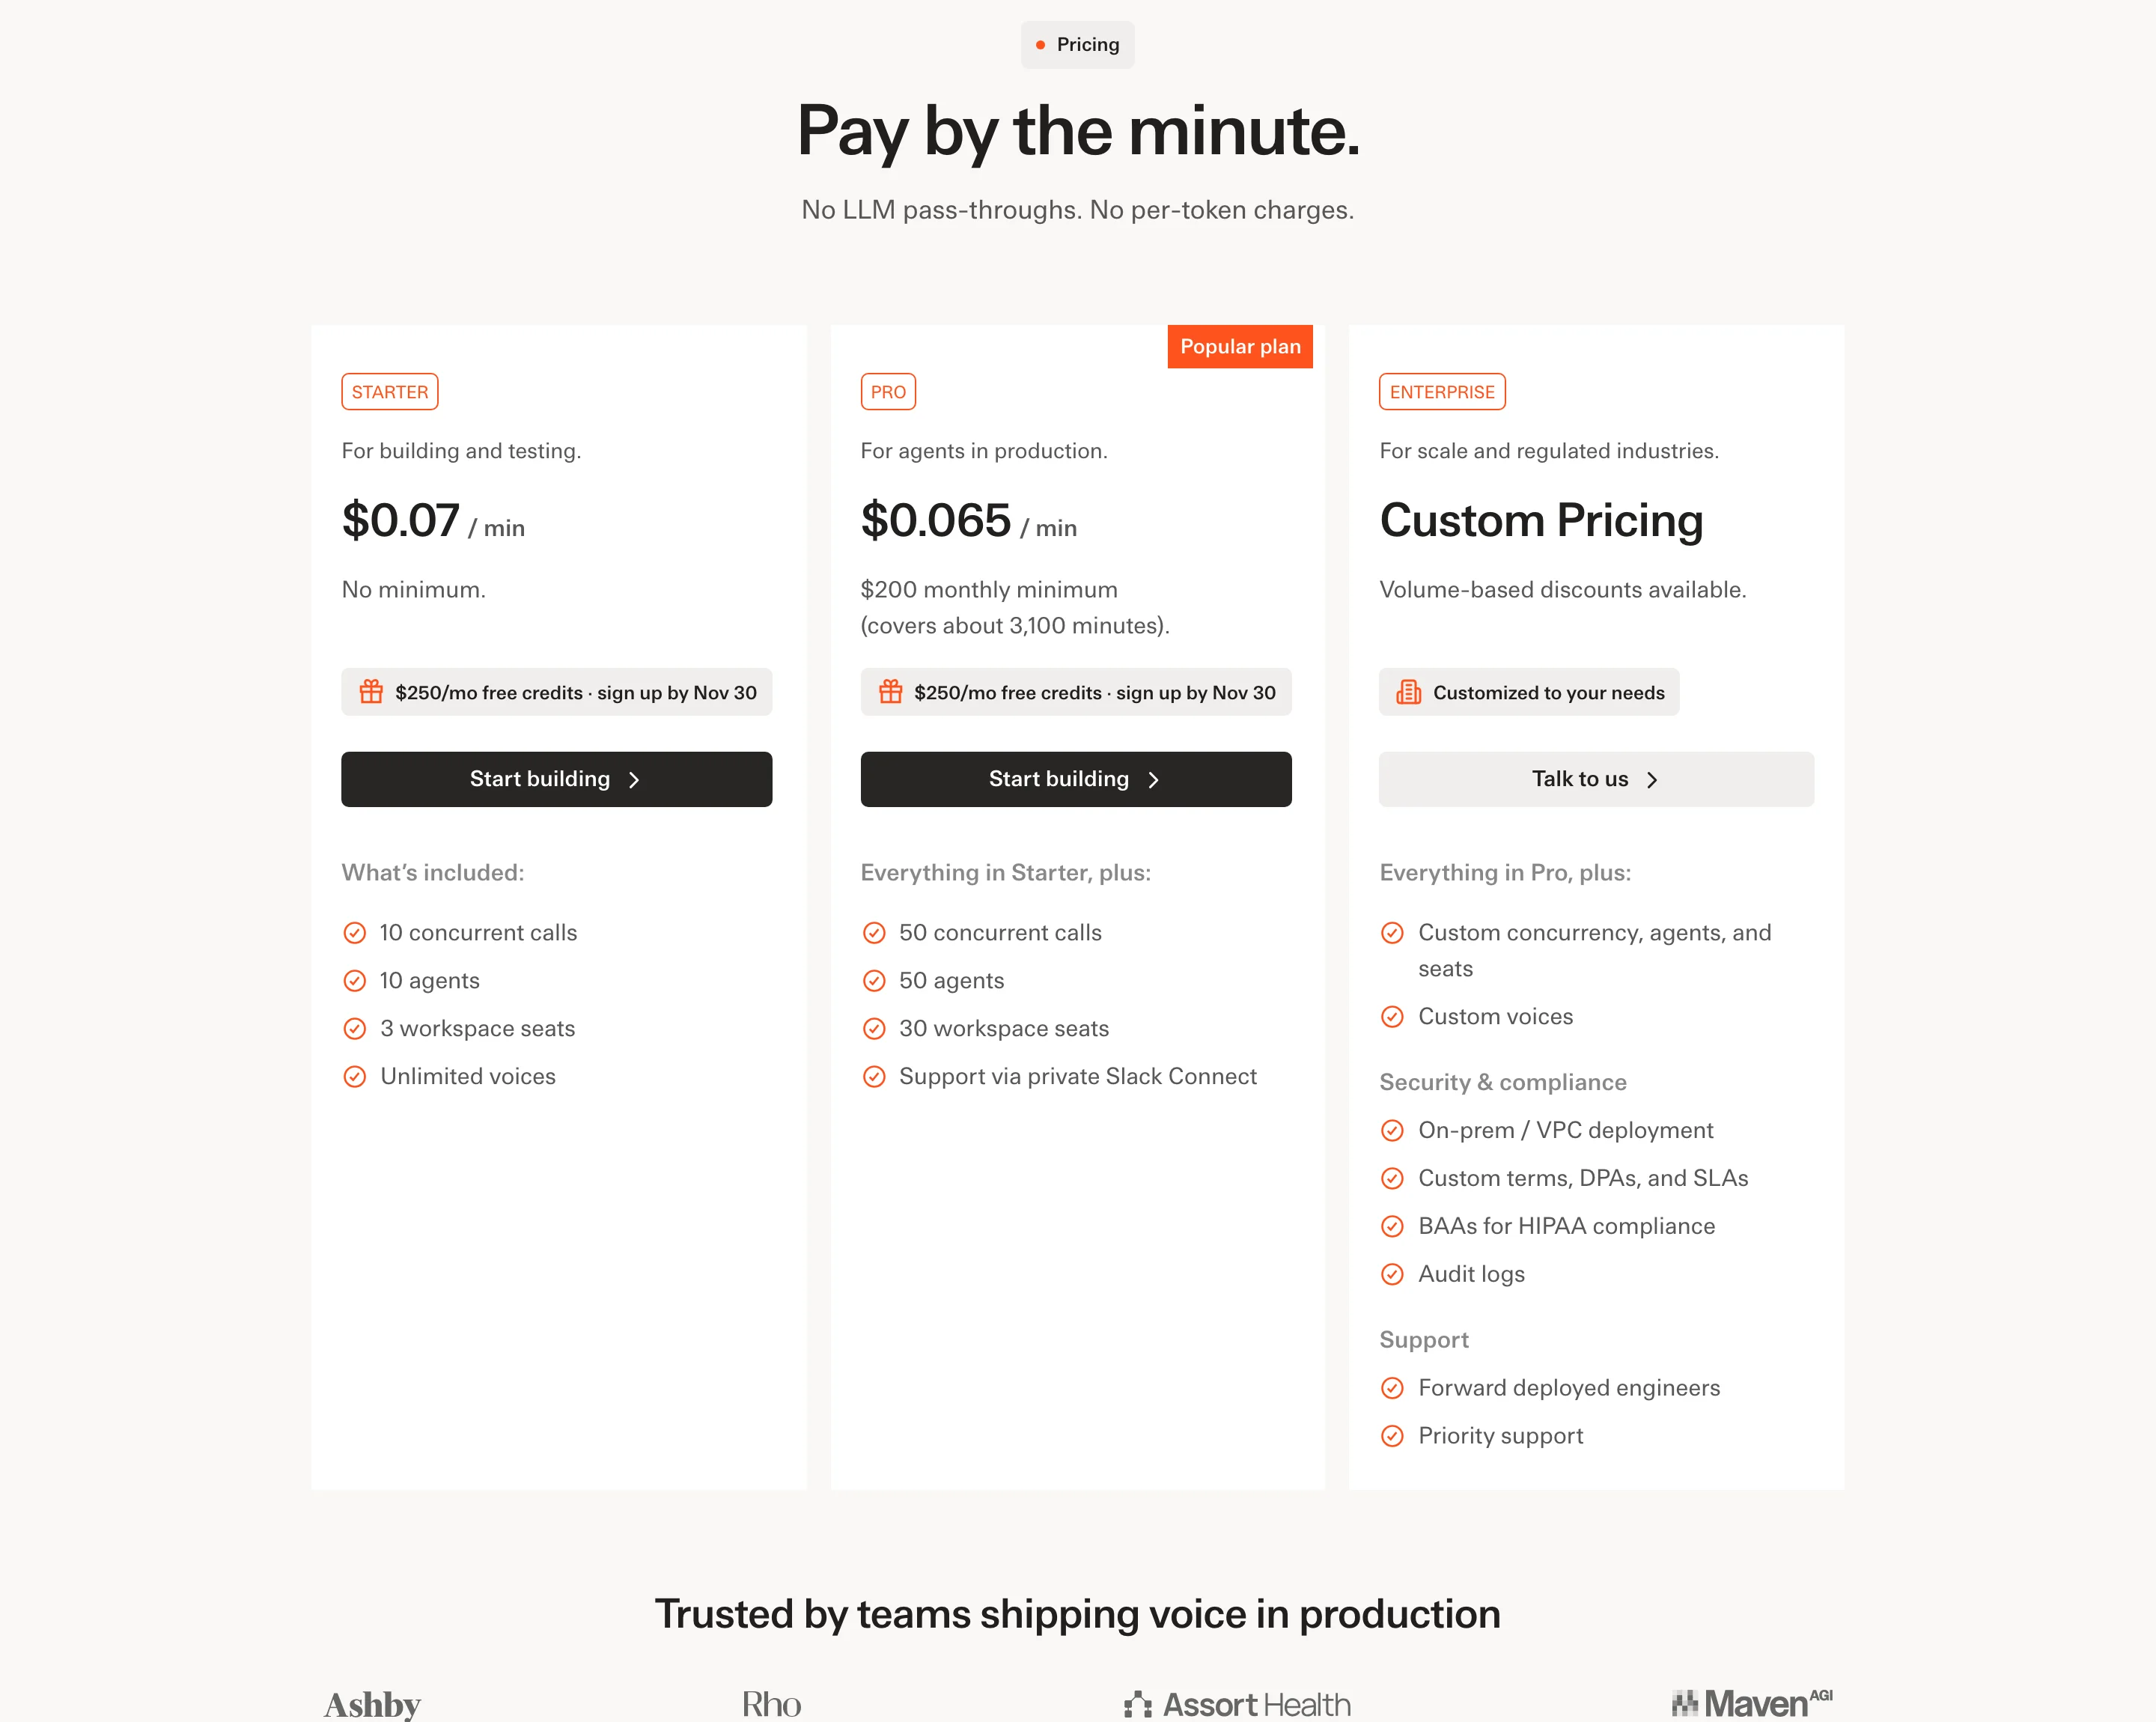
兩個期限要注意。11 月 30 日前註冊的帳號每月有 250 美元額度,這是有條件的註冊活動,不是永久免費;已經在 ElevenLabs、Bland 這類級聯堆疊上跑的團隊若切換過來,官方送三個月,等於把遷移風險的嘗試成本壓到零。並發是另一個容易漏看的硬上限:Starter 同時 10 路通話、Pro 同時 50 路,客服尖峰時段會排隊的團隊要先把這個數字放進容量規劃。整合介面提供 webhooks、保持連線的 WebSocket 與 LiveKit 三種接法,也支援電話號碼直撥,首頁還放了一支美國號碼讓任何人打給 Phonic 代理試聽;企業信任條款有 SOC 2 Type II 與 99.99% 可用率承諾。對照 Eleven Realtime 把組裝責任收走的路線,兩邊其實在同一個方向上競爭:都想把級聯時代「自己拼三家模型」的複雜度收走。
台灣團隊最該先驗的是語言。官方宣稱訓練涵蓋 50 種以上語言,對話中可以切換語言並維持同一個說話者的聲音,但文件沒有附各語言的品質成績,語言設定只以列舉值形式存在,範例也只見預設英語與額外語言欄位,繁體中文的實際表現屬於未確認事項。語言總數從來不等於每一種語言的品質。開發介面倒是給了兩個專名校正的工具:發音字典欄可以把常聽錯的地名手動標音(官方範例把普吉島 Phuket 標成 Poo-ket),關鍵詞加強欄能把產業用語加進辨識優先序(範例是貨運術語 Load ID 與 dispatch)。有工具可用是一回事,產品名、地址格式、金額數字的聽讀正確率,還是要用自家的真實語料去打一輪測試電話才算數。
把未確認事項列清楚,比急著下結論有用。「唯一能邊聽邊做」的排他性宣稱只有公司自己的說法;44 分鐘 123 次工具呼叫是挑過的示範通話;三份榜單的名次都是快照,會隨新對手浮動;繁中表現無文件可查;監督代理用的是哪些前沿模型、成本怎麼反映在單價裡,官方都沒有揭露。
現在能做的判斷是這個:把「第一」兩個字放一邊,看它有沒有辦法把你最長的那通電話變短。準備一通包含改口與查詢的測試對話,例如先說訂週五、後面改成下週五,讓它在自家工具環境跑一次。時間軸要分四個點記:首次出聲、查詢開始、資料回傳、工作確認,只記第一個點會把「快但答錯」誤判成改善;更正之後,還要核對口頭摘要與工具紀錄指向同一個日期,兩者對得起來,提早查詢才算真的接成了正確的工作。能用註冊額度在 11 月 30 日前完成這一輪驗收,成本是零;答案對得起來,再談每分鐘單價與最低消費的帳。