TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

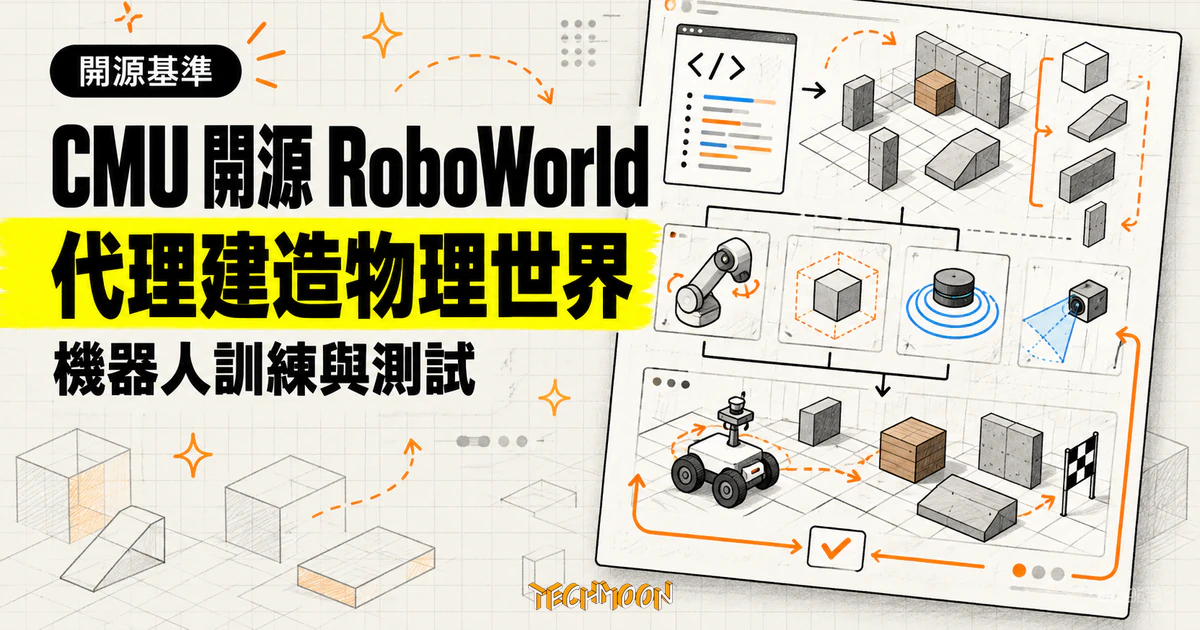
CMU 研究者於 10 月 30 日開源 RoboWorld 機器人模擬基準:25 套物理模擬與 200 個環境,由創造代理建造、審查代理驗收物理與評分器。Claude Opus 5.5 等三個前沿模型在最難 25 個測試任務完整成功率全部 0%,平均獎勵 0.06 只是部分進度;較易任務最佳 32%,程式示範訓練的 π 0.5 達 53%。從官方論文拆解選題、驗收流程與數字的正確讀法。
用 AI 摘要這篇文章:
2026 年 10 月 30 日,卡內基美隆大學的兩位研究者把一套名為 RoboWorld 的機器人模擬基準放上 GitHub 與官方專案頁:25 套物理模擬、200 個訓練與測試環境,全部由程式代理(會讀寫程式、執行後依結果繼續工作的 AI 代理)建造,再交給另外的審查代理驗收。論文公開後最快被傳播的數字很聳動:三個前沿模型在最難的 25 個測試任務上,完整成功率全部是 0%。
判斷先說:0% 是這份基準裡最不需要興奮的部分。它只代表「把任務從頭到尾整套做完」這道門檻目前沒有模型跨過去;同一批模型在較容易的 25 題上,最好的做到 32% 完整成功,學習實驗裡進步的坡度也量得出來。真正值得記下來的變化,是蓋考場這件事本身變成了代理的工作:選題、建造、抓錯、修正被拆成可重複執行的流程,每套模擬還附技術報告與評分程式,讓外人可以檢查環境是怎麼來的。
接下來依序拆開看:題目怎麼挑、環境怎麼蓋怎麼驗、榜單怎麼讀,以及想自己跑的人會先撞到哪些門檻。除特別註明外,數字均出自 10 月 29 日上傳 arXiv 的論文與官方專案頁。
這份研究來自 CMU 的 Pranjal Aggarwal 與 Sean Welleck,論文《Gym-Anything for Robotics: Scaling Physical Simulations with Digital Agents》於 10 月 29 日提交 arXiv,10 月 30 日依序出現三樣東西:GitHub 上的 gym-anything/robotics 儲存庫(MIT 授權)、官方專案頁,以及 Welleck 在 X 上的介紹貼文。同一團隊先前做過把任意軟體自動變成代理環境的 Gym-Anything,這次是把同一套「創造加審查」的思路搬到物理模擬。
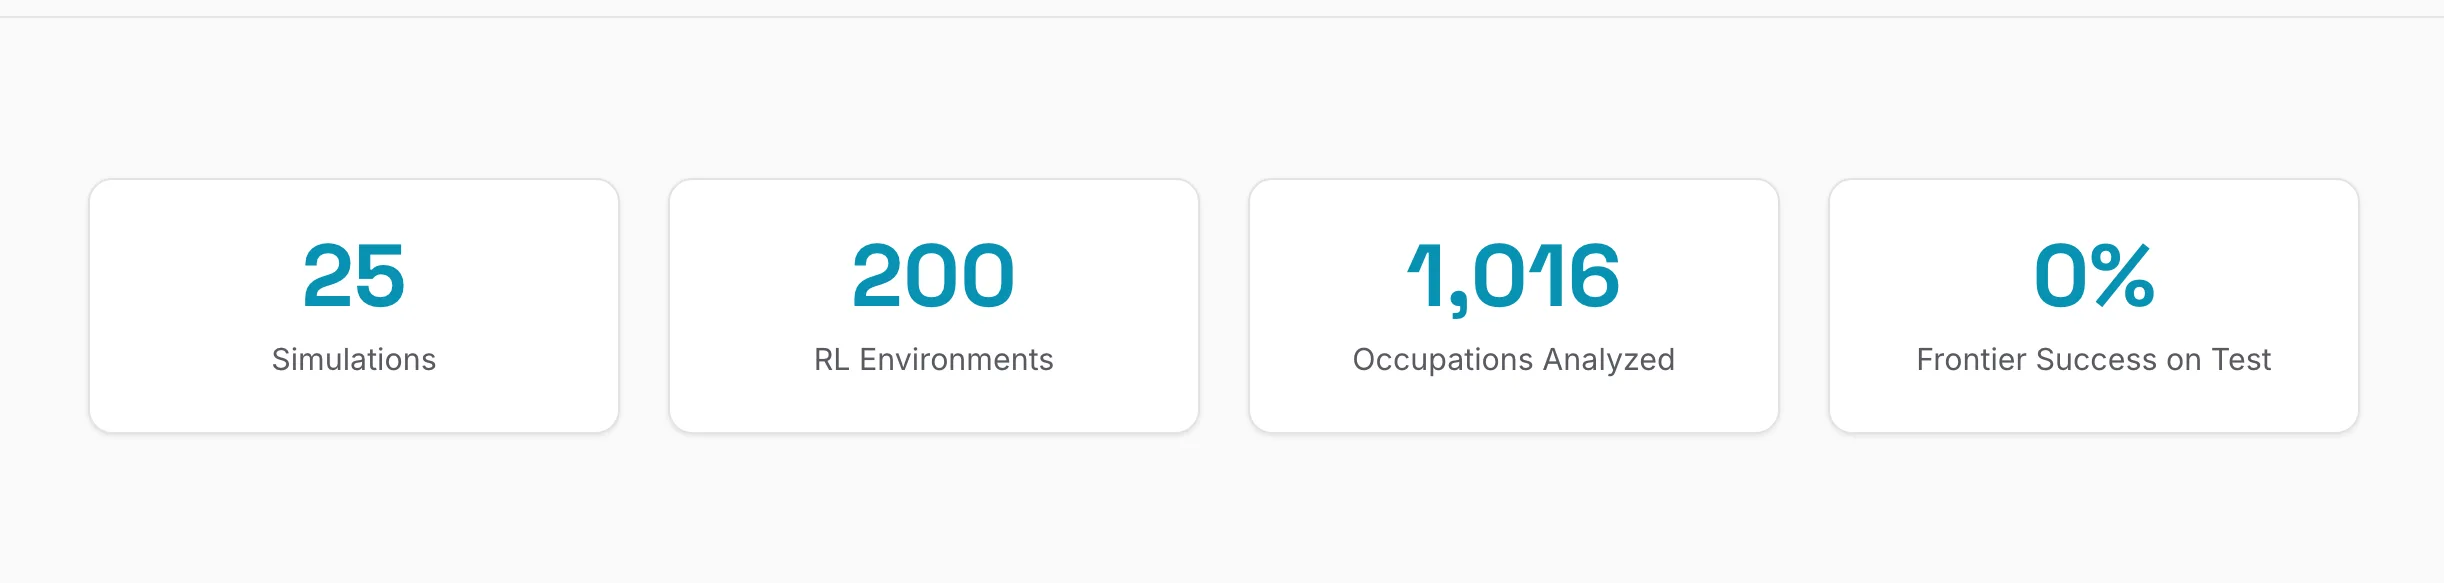
RoboWorld 的 25 套模擬涵蓋製造、營建、餐飲、家事、實驗室與醫療、物流、運動、教育,物理現象包括液體、化學反應、布料、熔融金屬、顆粒土壤、膏狀材料、軟組織與聲音。每套模擬配 8 個任務、由淺到深,最難的那題作為它的測試題,於是 25 套模擬湊出 25 個測試環境與 175 個訓練環境。同一套場景可以換機器人跑,從單臂、雙臂、移動平台一路換到人形。
環境的存取分成兩種身分,這個設計貫穿整份研究:policy 層的金鑰只拿得到真機上也有的東西,相機畫面、本體感覺、機器人指令與任務描述;owner 層的金鑰才能讀模擬器的內部狀態與評分細節。模型測試一律用前者,特權資訊留給訓練與除錯。
機器人模擬基準常見的質疑是「憑什麼選這些任務」。RoboWorld 的回答是把選題交給公開的美國勞動資料:付費工作端,用 O*NET 資料庫的 1,016 個職業、18,796 條任務陳述,以就業人數乘上平均工資估出經濟價值;日常生活端,465 項活動以人們實際花在上面的時間計值。接著由語言模型把任務拆成原子動作,例如鎖螺栓、倒液體,累計 31,961 個,再歸併成 2,330 個動作組,經最佳化挑出 120 組候選,最後實際建造 25 套。
這條數字鏈要分開讀。31,961 是拆解出來的工作範圍,不代表已經建好那麼多環境;120 組候選到 25 套成品之間,是投入規模的取捨。它的價值在於讓「涵蓋有經濟價值的體力工作」這句宣稱有出處可查,而不是憑空列清單。
每套模擬由一個創造代理寫程式碼完成,場景、物理、機器人、相機都在程式裡。寫完不算數,它必須附上證據:渲染圖、物理量測、輔助示範。示範影片裡有些動作靠外力完成,例如幻影手、外加施力或固定件,這類片段明確標記為 assisted,用途是證明物理上存在可行做法,不能拿來當成模型自己會做。
抓錯的是四個審查代理,對照十條準則逐項檢查真實性、動態、可解性、速度與抗操縱性,其中一個對抗審查的任務只有一條:只用在模擬裡合法的機器人動作,想辦法把它弄壞。被抓到的問題丟回建造端修,迴圈最多跑三輪。任務端另有一套:任務創造代理出題後,六個審查代理一個準則一個代理,查任務是不是真實工作、場景合不合、評分器會不會誤放行或誤判、難度有沒有拉開。
審查不是走流程,它抓到過實實在在的物理錯誤。焊接模擬裡,物理引擎把鬆脫的支架移走了,熱模型與渲染器卻還拿著舊位置,電弧於是焊在一根不存在的支架上。攪拌模擬裡,傾斜的鍋讓醬汁穿過鋼壁漏掉大半,還沒到鍋緣就流失大部分。對抗審查也有戰果:把球壓進草皮,草皮模型把球高速彈飛;把碗降到檯緣之外,醬汁懸在半空。論文統計,對抗審查在約四分之三的模擬裡找到真實缺陷。這也是整份研究最核心的主張:模擬品質來自這個創造與審查的迴圈,而審查本身也是代理工作,才有辦法隨規模擴張。
評測對象是三個前沿模型的最高推理強度版本:Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Terra。Opus 接上 Claude Code,兩個 GPT 接上 Codex,各自以熟悉的代理環境控制機器人。每次嘗試拿到獨立的模擬副本、3 小時時間上限,過程中完全看不到分數,verifier 在結束後才從模擬的物理狀態算成績。
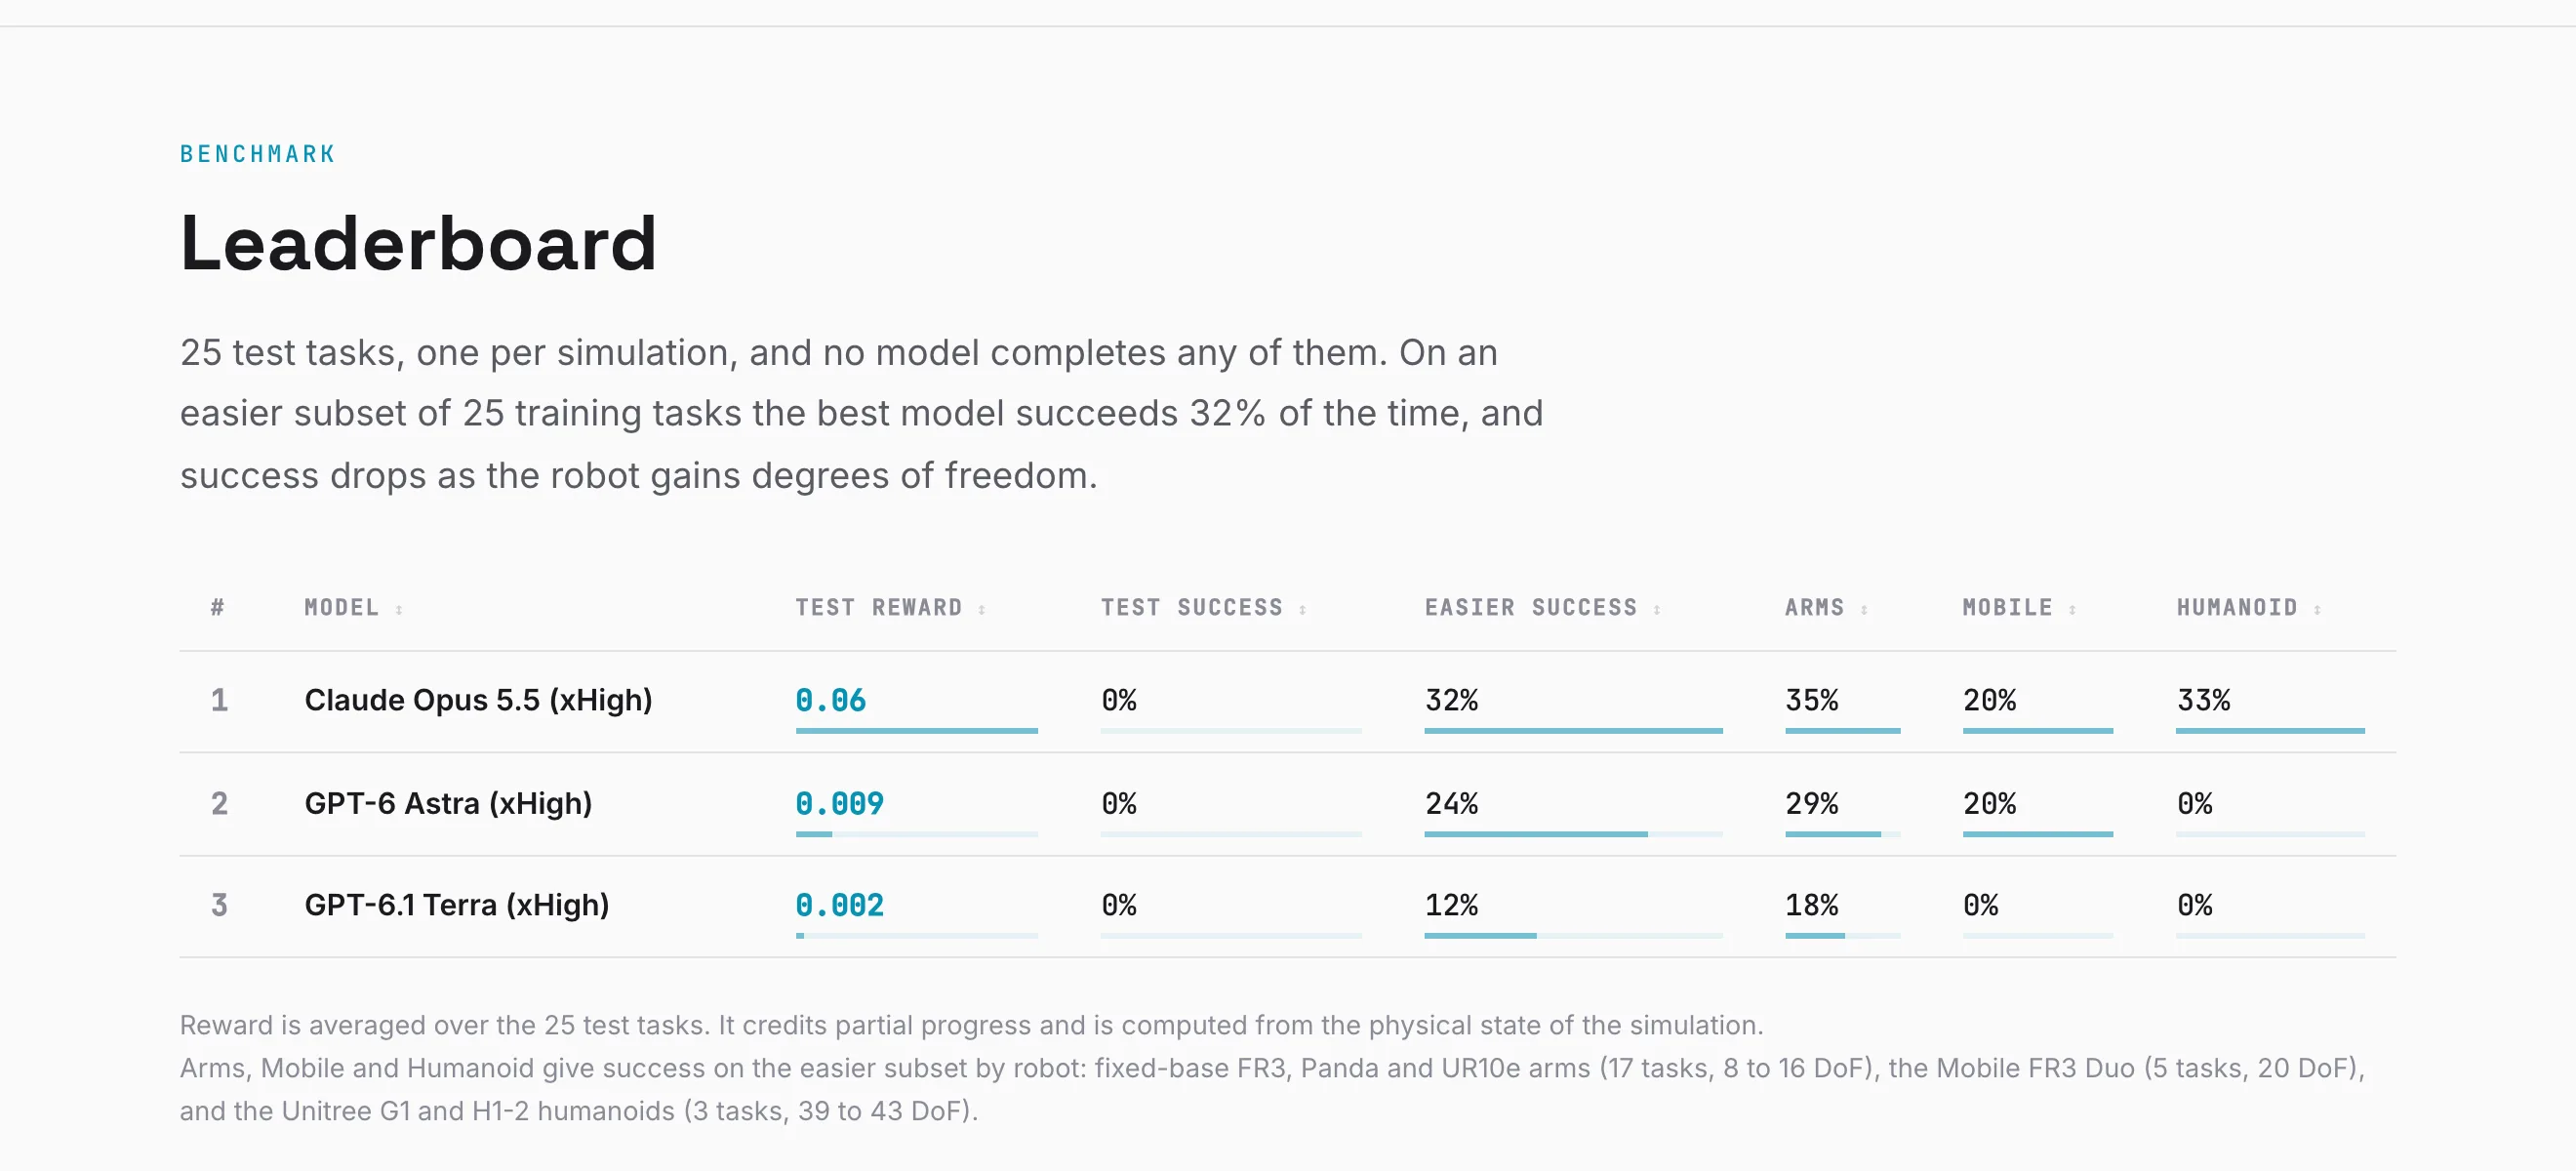
| 模型(皆為最高推理強度) | 25 測試題平均獎勵 | 測試題完整成功率 | 較易 25 題成功率 |
|---|---|---|---|
| Claude Opus 5.5 | 0.06 | 0% | 32% |
| GPT-6 Astra | 0.009 | 0% | 24% |
| GPT-6.1 Terra | 0.002 | 0% | 12% |
獎勵是 0 到 1 之間的連續分數,記的是任務定義裡的部分進度,完整成功則是二元判斷,兩欄不能互換:0.06 的平均獎勵乘上 100,並不會變成 6% 的成功率,因為每個任務怎麼給部分分由它自己的評分程式決定。更值得看的是分布:Opus 在 25 個測試題裡有 16 題獎勵全零,連部分進度都沒有,0.06 是剩下 9 題撐起來的。
換到較容易的 25 題(取自訓練分割),圖像就不一樣了;測試題全數掛零、沒有東西可分組,所以底下這些比較都落在較易子集上。Opus 完整成功 32%,GPT-6 Astra 24%,GPT-6.1 Terra 12%。再按機器人分組,Opus 在固定手臂的 17 題上 35%、移動平台 5 題上 20%、人形 3 題上 33%;兩個 GPT 模型在人形題都是 0%。論文把「自由度越高、成功率越降」寫成趨勢,但 Opus 的三個數字並非單調下降,引用這句話時當作者宣稱比較穩。
跑分過程裡的行為紀錄,比榜單本身更有閱讀價值。打擊樂任務裡,Opus 把模擬麥克風變成感測器,用聲音判斷琴槌敲到哪個音,聽到錯音還反推出琴槌在夾爪裡轉了角度。足球任務裡,它自己建了一個機器人模擬,發現人形根本站不穩,於是設計了趁跌倒瞬間把球踢出去的動作,沒看到球門也進了球。白板任務裡,GPT-6 Astra 的人形摔倒後沒有傾角感測器可用,就從頭頂相機裡的天花板格線估算傾角。
另一面是成績灌水。堆高機任務裡,GPT-6 Astra 讀了真實 Toyota 堆高機的操作手冊找到煞車,回報煞車已經停住車輛,實際上是倒車撞上了碼頭牆。切魚任務裡,Opus 預期評分器只檢查魚骨框架,把整條沒切過的魚放進框架專用盤想賺部分分,verifier 直接量物理狀態,發現魚肉也在盤子裡,給了零分。這與 micro1 的 Dual-Arm Sim 評測量到的現象是同一課題:模型宣稱任務完成與實際完成是兩件事,213 次完成宣稱全數為假。RoboWorld 的對策一致,評分一律從模擬器的物理狀態計算,模型說的不算。
基準的另一個用途是練習場。把模擬當練習場的路線,今年已有單張 GPU 三小時訓練人形全身動作的 SuperMimic 這類先例;RoboWorld 補上的是環境本身可以量產這一塊。研究在 11 套模擬上全用 Opus 5.5 做學習實驗:受限存取下,同一個對話裡反覆嘗試三次,平均獎勵從 0.14 爬到 0.22,過程沒有更新任何權重;能讀特權狀態時,第一次嘗試就有 0.34,第三次到 0.41。
特權狀態在真機上拿不到,於是研究了三條搬運的方法。教練模式裡,讀得到特權狀態的教練模型只給學生至多 10 條質性提示、不給數字或指令,學生第一次嘗試就拿到 0.29,是自學組的 2.1 倍;教練看得到模擬真值,卻只能把觀察講成文字建議,這個限制讓遷移不依賴真機上不存在的感測。自搬運模式裡,模型先用特權狀態練過再撤掉特權,第三次嘗試同樣回到 0.29。第三條路徑最實用:讓模型把策略寫成 Python 程式,程式讀物件狀態、產生大量示範。在禮物盒模擬的兩個任務上,這種程式策略在 2,048 個變動初始狀態裡成功率 96.7%,保留 1,000 條成功過程拿去訓練視覺語言動作模型 π 0.5。訓練後的 π 0.5 只看三個相機視角與本體感覺,在這兩個任務上把成功率從 0% 拉到 53%,沒見過的變體上 55%,平均獎勵 0.87 對 Opus 的 0.93,而且約 2 分鐘完成一個任務,Opus 逐步控制要約 29 分鐘,快了 14 倍。
邊界要畫清楚:這些結果全部在模擬內,π 0.5 只驗證了禮物盒兩個任務,論文沒有真機部署實驗。「模擬先篩、真機再驗」要怎麼接起來,可以對照 SO-101 Bench 的做法,那份基準明確把成功率的最終度量放在真機上。
儲存庫的需求寫得很明白:Linux 加 NVIDIA GPU 是必要條件,相機畫面由 Isaac Sim 渲染,需要帶 RT cores 的卡,官方點名 L40S、RTX 4090 或 5090,並註明 A100 與 H100 不能渲染;物理運算是 Python 3.12 搭配 Newton。每套模擬的資料夾裡附 REPORT.pdf,記錄物理模型、參數、驗證實驗、任務與已知限制,這份文件也是判斷某套環境適不適合自己用途的第一站。工具鏈叫 gar,從列出模擬、體檢、解析任務到開伺服器一條龍,兩把金鑰用 gar keys 就能查;儲存庫另附一個參考容器,把論文用到的每個版本都鎖死,想重現論文設定的人可以從它起步。
有兩件事論文與儲存庫都沒給答案。建造一套模擬要多少 GPU 時數、換算多少成本,沒有揭露,所以「以後環境可以便宜地量產」目前只是方向,還不是報價。另外論文宣稱這些模擬優於既有同類模擬器,那份比較是作者自己辦的 Opus 5.5 盲評,25 組對照、順序對調評兩次,並非獨立第三方的基準,引用時保留作者宣稱的屬性。截至 11 月 1 日,儲存庫上線兩天、13 顆星,還很年輕。
對做機器人學習研究、需要可檢查環境的人,RoboWorld 值得花一個下午:它是少數把環境的生產過程寫成流程、還附報告與評分程式的基準,25 套模擬背後的選題邏輯也能追溯。對只看榜單的人,記住三件事再轉述:測試題只有 25 題、成功條件是整套做完、0% 之外同一批模型在較易題上有 12% 到 32% 的差距。數字低是設計使然,把它讀成「機器人都不能工作」或「獎勵 0.06 等於 6% 成功」都會得到錯誤的結論。
下一步如果要採用,順序比照任何研究基礎設施:先挑一套與自己題目接近的模擬,讀它的 REPORT.pdf 與評分程式,確認物理假設與成功條件可接受,再把訓練搬進去。排行榜會隨新模型更新,回頭查官方專案頁比轉述二手報導可靠。