TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

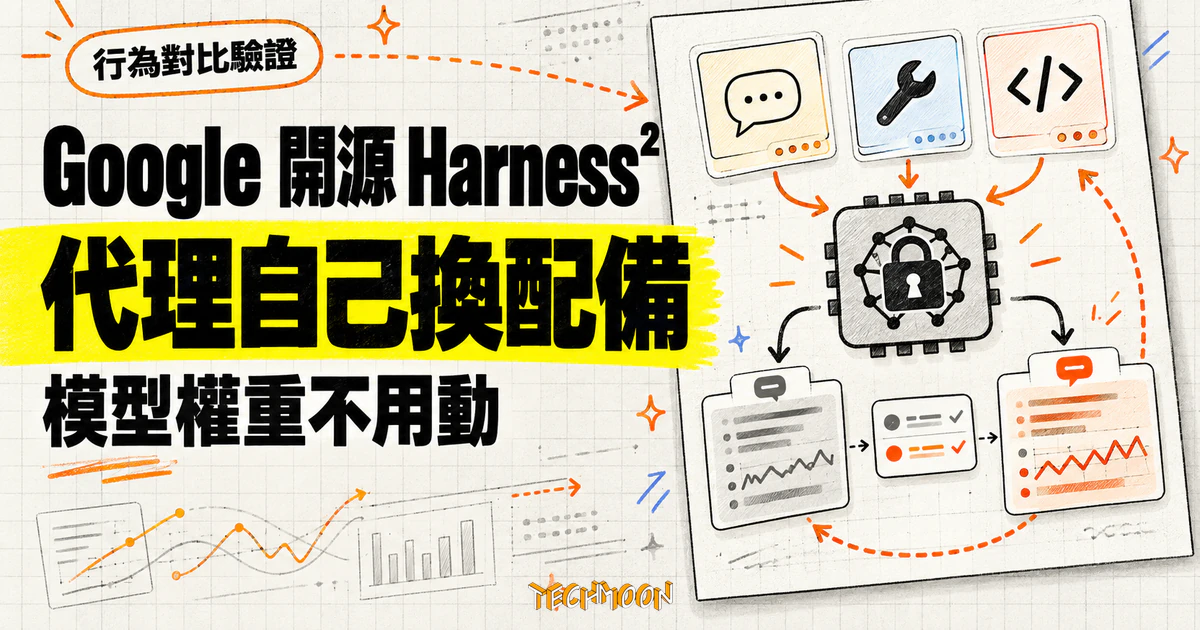
Google Research 開源 Harness² 研究框架:固定模型權重,讓 AI 代理用行為對比自己調整系統提示、工具與腳本等八項執行配備。論文在法律、專業與辦公三類基準報告單步改良全面勝過原始配備,GLM-5 改良後 75.7 分更超過 Gemini 3.5 Flash 的原始 72.4 分。
用 AI 摘要這篇文章:
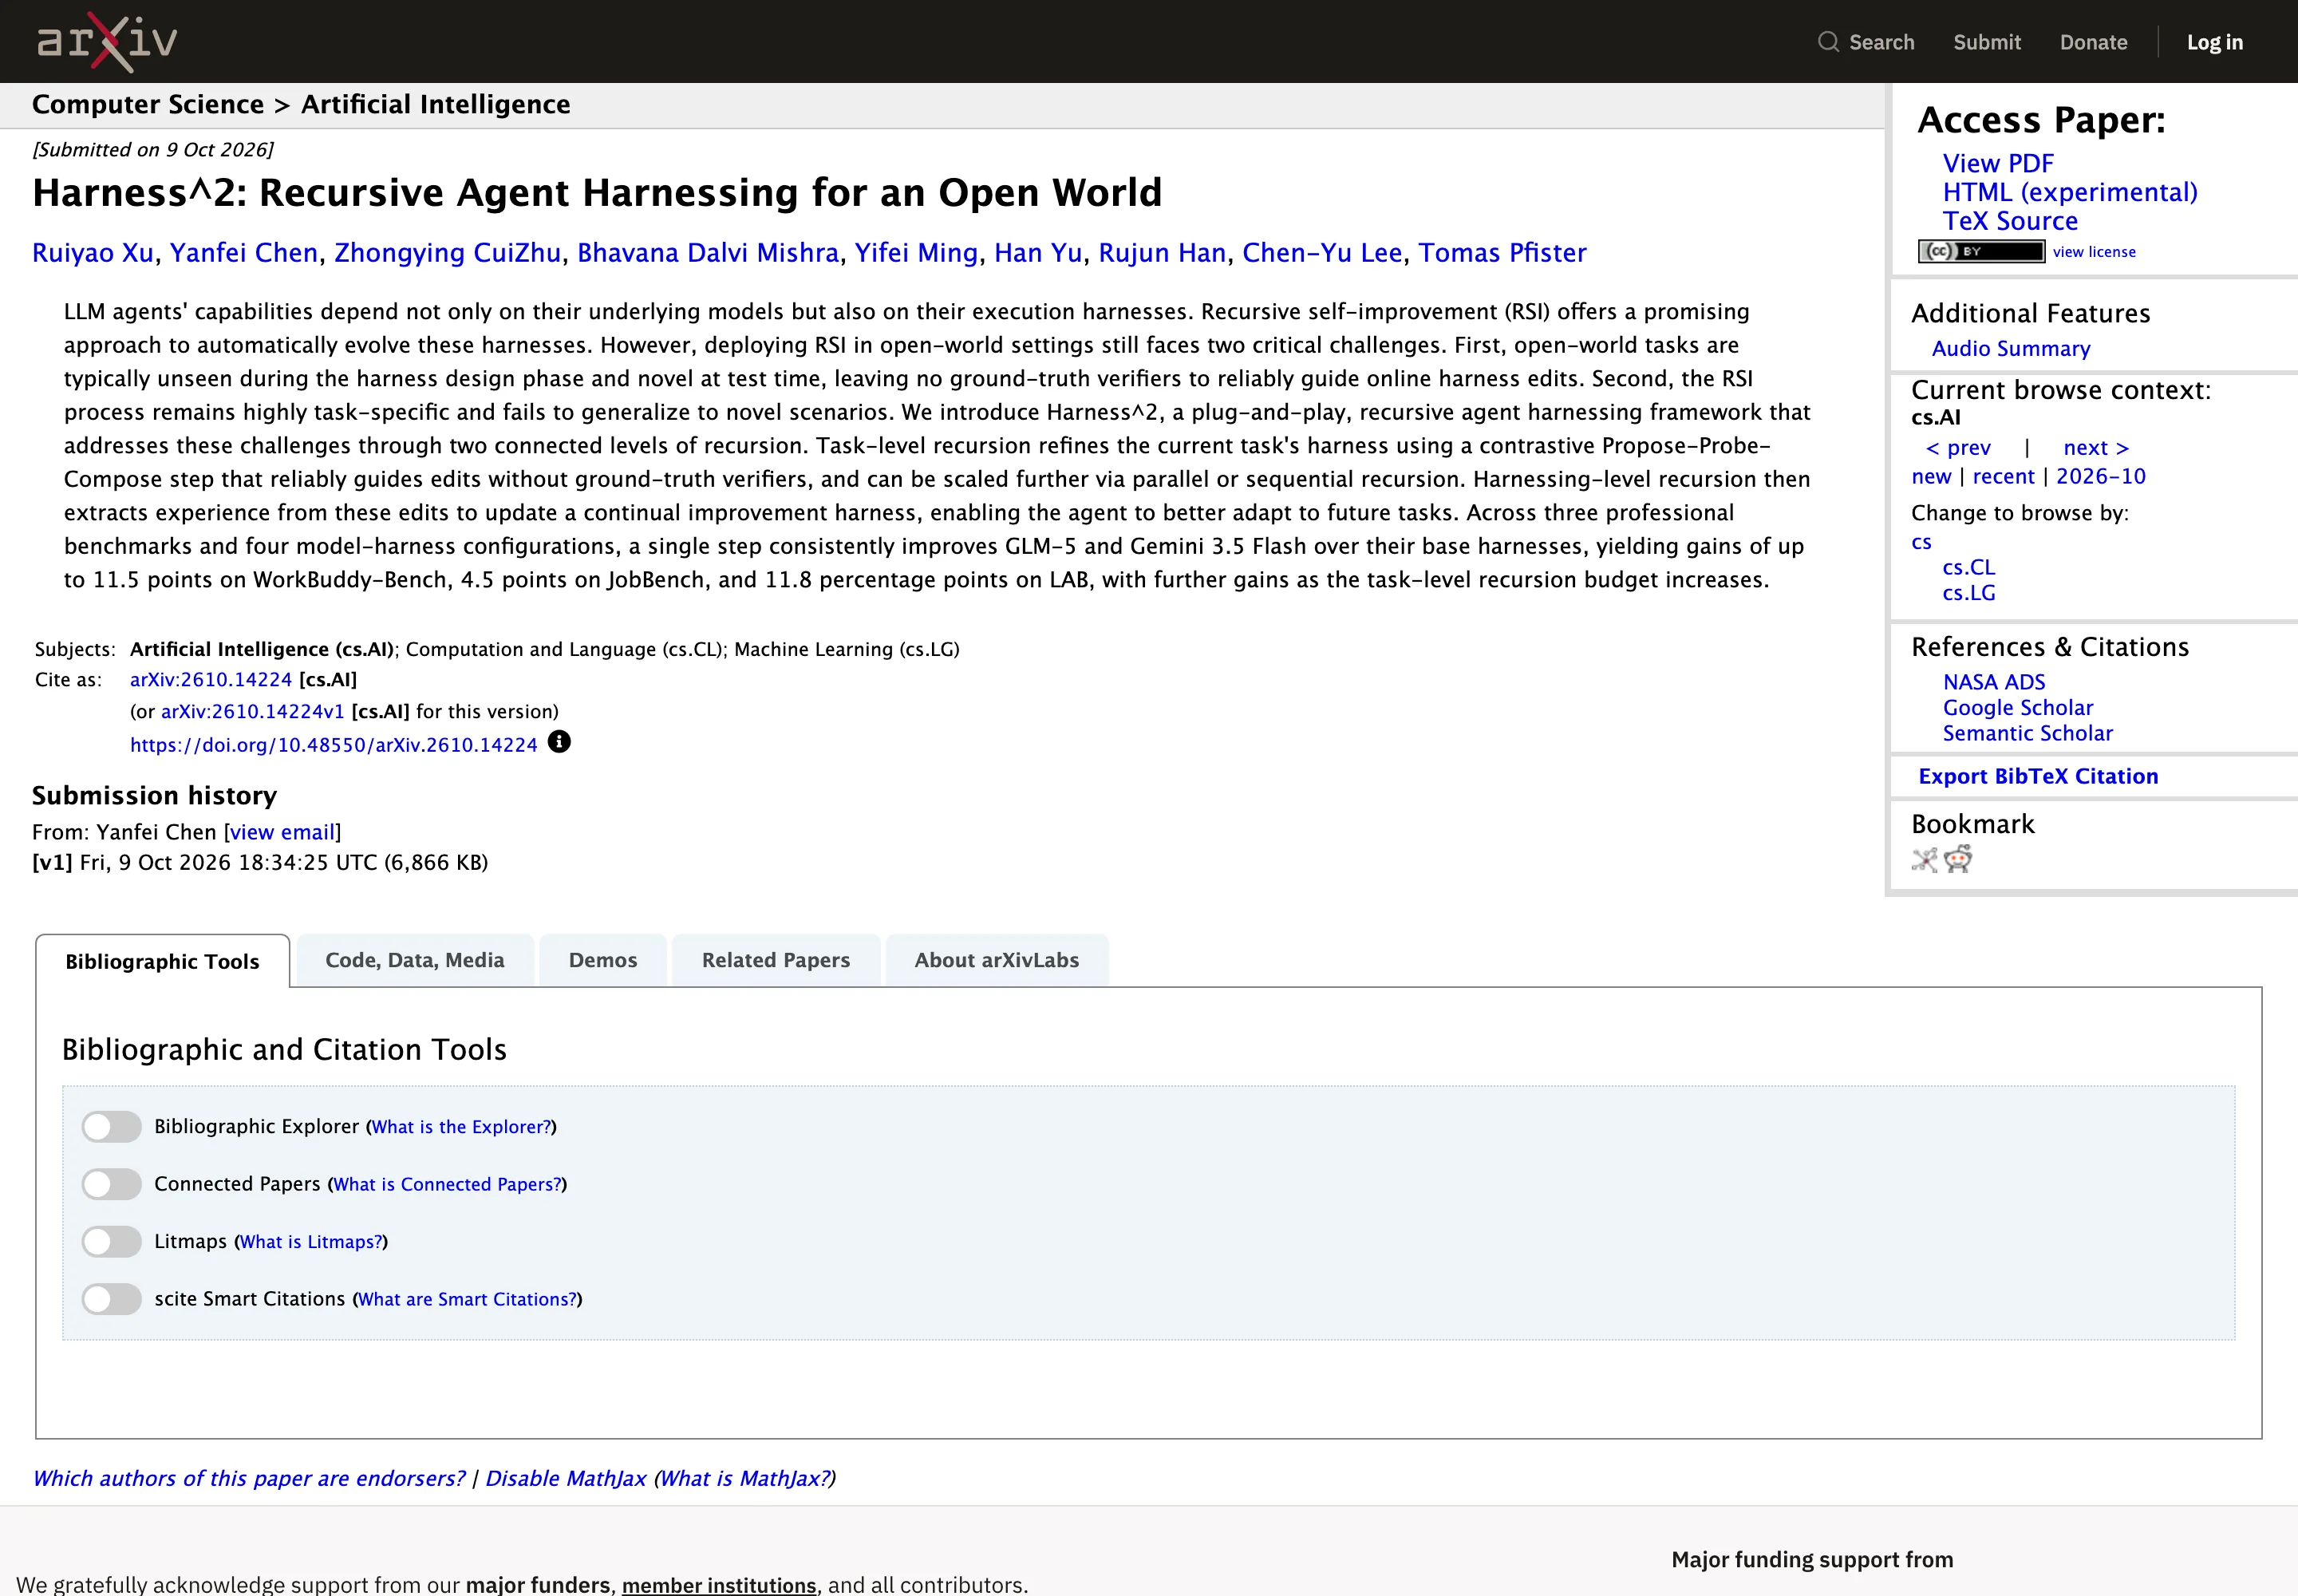
Google Research 底下的雲端 AI 研究團隊,在 2026 年 10 月 8 日把一套名為 Harness² 的研究框架放上 GitHub,隔天論文就掛上 arXiv(編號 2610.14224)。論文九位作者裡,第一位隸屬美國西北大學,其餘八位都掛 Google Cloud AI Research,通訊信箱一路從西北大學通到 Google。到 10 月 20 日為止,這個儲存庫已累積超過一萬顆星。它處理的問題很具體:代理(會用工具、按步驟做事的 AI 系統)表現不好時,問題往往不在模型本身,而在圍繞模型的執行配備。Harness² 讓代理在不更動模型權重的前提下,自己修改這些配備,再用實際執行結果回頭驗證修改有沒有用。
我在 Mac 上用 uv 建了 Python 3.13 環境、安裝 0.1.0 版,跑完它內建的離線示範。整個過程不需要任何模型金鑰、沒有產生半毛 API 費用,卻能把這套框架的核心機制完整看一遍。
裝好套件後,一條 harness2-demo --output runs/demo --k 2 指令就會執行內建示範。它準備了兩個記帳任務,第一個任務的流水帳只有三筆數字:100.25、-20.10、5.00,第二個任務是另一組同樣三筆的帳。基準配備裡的加總腳本藏了一個缺陷,只把正數列入計算,所以跑出來的總額是 105.25。
接著框架進入它稱為「提出、探測、組合」(Propose、Probe、Compose)的循環:先讓編輯器提出候選修改,再讓候選版本實際執行同一個任務,最後比較執行軌跡,挑出有證據支持的修改。候選有兩種範圍,一種是跨任務通用的不變式修改,一種是針對當前領域的修改,執行目錄裡兩類候選的軌跡檔並排存放。其中一個候選把腳本裡「只加正數」的過濾條件拿掉,總額就從 105.25 變成 85.15,正是三筆數字含正負號的正確答案。整個判斷不需要標準答案,靠的是兩個版本行為上的對比:一個漏掉了貸方金額、一個沒有。
有趣的是它怎麼記住這件事。任務結束後,框架把採用的配備連同一份經驗紀錄寫進跨任務庫,檔案裡有四個欄位:適用情境(cue,例如「當流水帳同時含借貸方時」)、可搬來用的做法、支持這個做法的執行證據、信心等級。庫的入口是一份索引,開頭就寫明使用方式:先瀏覽索引、再打開看起來相關的條目,也就是下一個任務的改良器是自己決定要翻哪些舊經驗。第二個任務開跑時,紀錄檔明確顯示它帶著第一個任務留下的庫藏出發。這就是論文說的兩層遞迴:任務層改良眼前的配備,改良層把經驗沉積成庫,供下一個任務取用;專案頁把這一步稱為經驗反思器,反思的對象是整輪改良過程,不是只有最終答案。
兩個任務、兩種遞迴模式跑完,累積 28 次執行、32 次編輯器呼叫。輸出目錄裡兩份執行紀錄正好對應兩種模式:並行模式在同一輪裡讓多個候選各自探測,再從共用證據組合出改良版;逐次模式則把上一輪採用的配備連同累積證據帶進下一輪。以指令參數來說,k 值就是任務層預算,並行模式會探測 k 個通用候選與 k 個領域候選,再產出 k 個組合版本;逐次模式則是連續 k 步、一步咬著一步。官方文件的比喻很直白,並行探索得更寬、逐次修正得更深。這個執行乘數先記著,後面談成本時會再回到它。
輸出的檔案結構本身就是這套方法的帳本。每次執行留下一份軌跡檔與答案檔,軌跡以行動與觀察兩欄記錄代理做過什麼、看到什麼;每個任務另有摘要檔登記採用了哪個候選。論文的結果目錄規格也一樣:任務摘要、交付物、採用的配備、反思筆記與評估結果全部落檔,重跑同一條指令可以續跑未完成的部分。
論文把 harness 定義成讓模型能夠行動的整套周邊系統。Harness² 打開八個可編輯的組件:系統提示、防護規則、記憶、工具說明、分工代理、技能、腳本、外掛。照專案頁的分組,系統提示與防護規則、記憶、技能負責建構脈絡,工具說明與腳本定義工具介面,分工代理處理委派,外掛控制中介層行為。其中記憶是後續工作讀得到的資訊,技能是「用到才載入」的程序知識,腳本則是可執行的程式,改它可能直接改變代理的實際行動,影響比改一句提示詞更大。示範裡被修改的加總腳本就是一例:編輯器直接動了一段真的會被執行的 Python。
八個組件的上下文成本並不相同。系統提示、工具說明與長期記憶是全程載入、每次呼叫都在場;技能只在被叫用時進入脈絡,論文特別註明這讓用不到它的任務不必付任何成本。論文附錄裡給編輯器的指示也相當節制:追蹤工作流程、修正最早觀察到的偏差、把每個失敗對應到最便宜而有效的組件;如果說不出某個編輯會改變哪個執行時刻,這個編輯就只是猜測,白佔上下文。
論文對「開放世界」的定義藏在問題設定裡:真實任務在配備設計階段沒見過、上場時是新的,身邊又沒有標準答案驗證器可以依靠。固定配備容易在新文件、新工具、新限制面前出現盲點,這正是它把改良搬到執行當下的理由。
這個視角近半年越來越常見。九月上旬 OpenAI 把 Codex 同款的代理配備做成代管服務上線,賣的也是「模型之外的這一層」;九月中,把論文與產品一起攤開的 JEV 框架同樣用固定模型、只改配備的內層循環換分數。Harness² 的差別在於把整條改良迴圈開源成可安裝的套件,而且明確處理「沒有標準答案回饋」的開放世界情境:既然找不到驗證器告訴你對錯,就用行為對比當替代訊號。
行為對比是雙面刃,論文自己也承認。兩個候選版本可能引用同一份錯的資料,比較只能幫你挑流程,不能證明答案是對的。這也是為什麼評測設計裡,評分標準被隔離在改良器的證據之外,評審模型只在代理選完之後才讀取產出。
接下來的數字全部來自論文與官方文件,我沒有重現任何一組。論文在三套專業基準上測了四種組合(GLM-5 與 Gemini 3.5 Flash 兩個引擎,OpenCode 與 Codex 兩種執行配備)。結果是單次改良就讓四種組合全部優於各自的原始配備:WorkBuddy-Bench(辦公、網頁與程式工作)最高進步 11.5 分,出現在 GLM-5 搭 OpenCode 的組合;JobBench(專業工作任務)最高 4.5 分,是 Gemini 3.5 Flash 搭 OpenCode;LAB(法律工作)的部分通過率最高增加 11.8 個百分點。把任務層預算拉到 k 等於 5 的並行模式,還能再往上加。
論文裡最值得停下來看的一句話是:GLM-5 單步改良後在 WorkBuddy-Bench 拿到 75.7 分(OpenCode)與 75.3 分(Codex),超過 Gemini 3.5 Flash 原始配備的 72.4 與 74.5。換句話說,較弱的引擎配上改良過的配備,贏過較強引擎的出廠設定。這是「先改配備再換模型」路線最有力的證據點。另一個佐證是執行器之間的差距被拉近:JobBench 上 OpenCode 與 Codex 兩種執行配備的原始分差(Gemini 2.4 分、GLM-5 3.0 分),改良後都縮到 0.5 分。這裡說的四種組合,就是兩個模型引擎乘上兩種開源執行配備;同一個模型換上不同的執行配備,成績本來就會不同,這正是整個研究的前提。
論文附的 JobBench 案例也把改良的樣貌講得很具體:基準配備下的代理把來源檔案整理到一半就收工,寫完的產出從沒回頭打開檢查;改良後的配備加上了驗證用的防護規則、一個對帳技能與更精確的工具說明,重跑後對照參考答案,分數從 43.1 升到 77.8。改良的不是模型的理解力,是工作紀律。論文另外還有跨模型轉移、工具使用可靠性與失敗分析的實驗段落,同樣值得在動手前讀過一輪。
但對照組的失敗同樣是論文自己寫的:名為 ReasoningBank 的基線在程式類任務最多比原始配備低 6.6 分;Harness Scaling 基線在十二種基準與組合的配對裡有七種輸給原始配備;而在 LAB 部分通過率上,Meta-Harness 基線在 Gemini 3.5 Flash 搭 Codex 的組合裡反而領先 Harness²。改良配備有效,不代表任何改良方法都有效。
讀這些分數時還要記得量尺的定義:LAB 的「部分通過率」是每項評分標準各自通過的比例,WorkBuddy 的平均分是程式、網頁、辦公三個子域分別計分後取平均。論文的預算研究則顯示,並行與逐次兩種模式都會隨著任務層預算增加繼續拿分,只是每一分都用更多執行換來的。
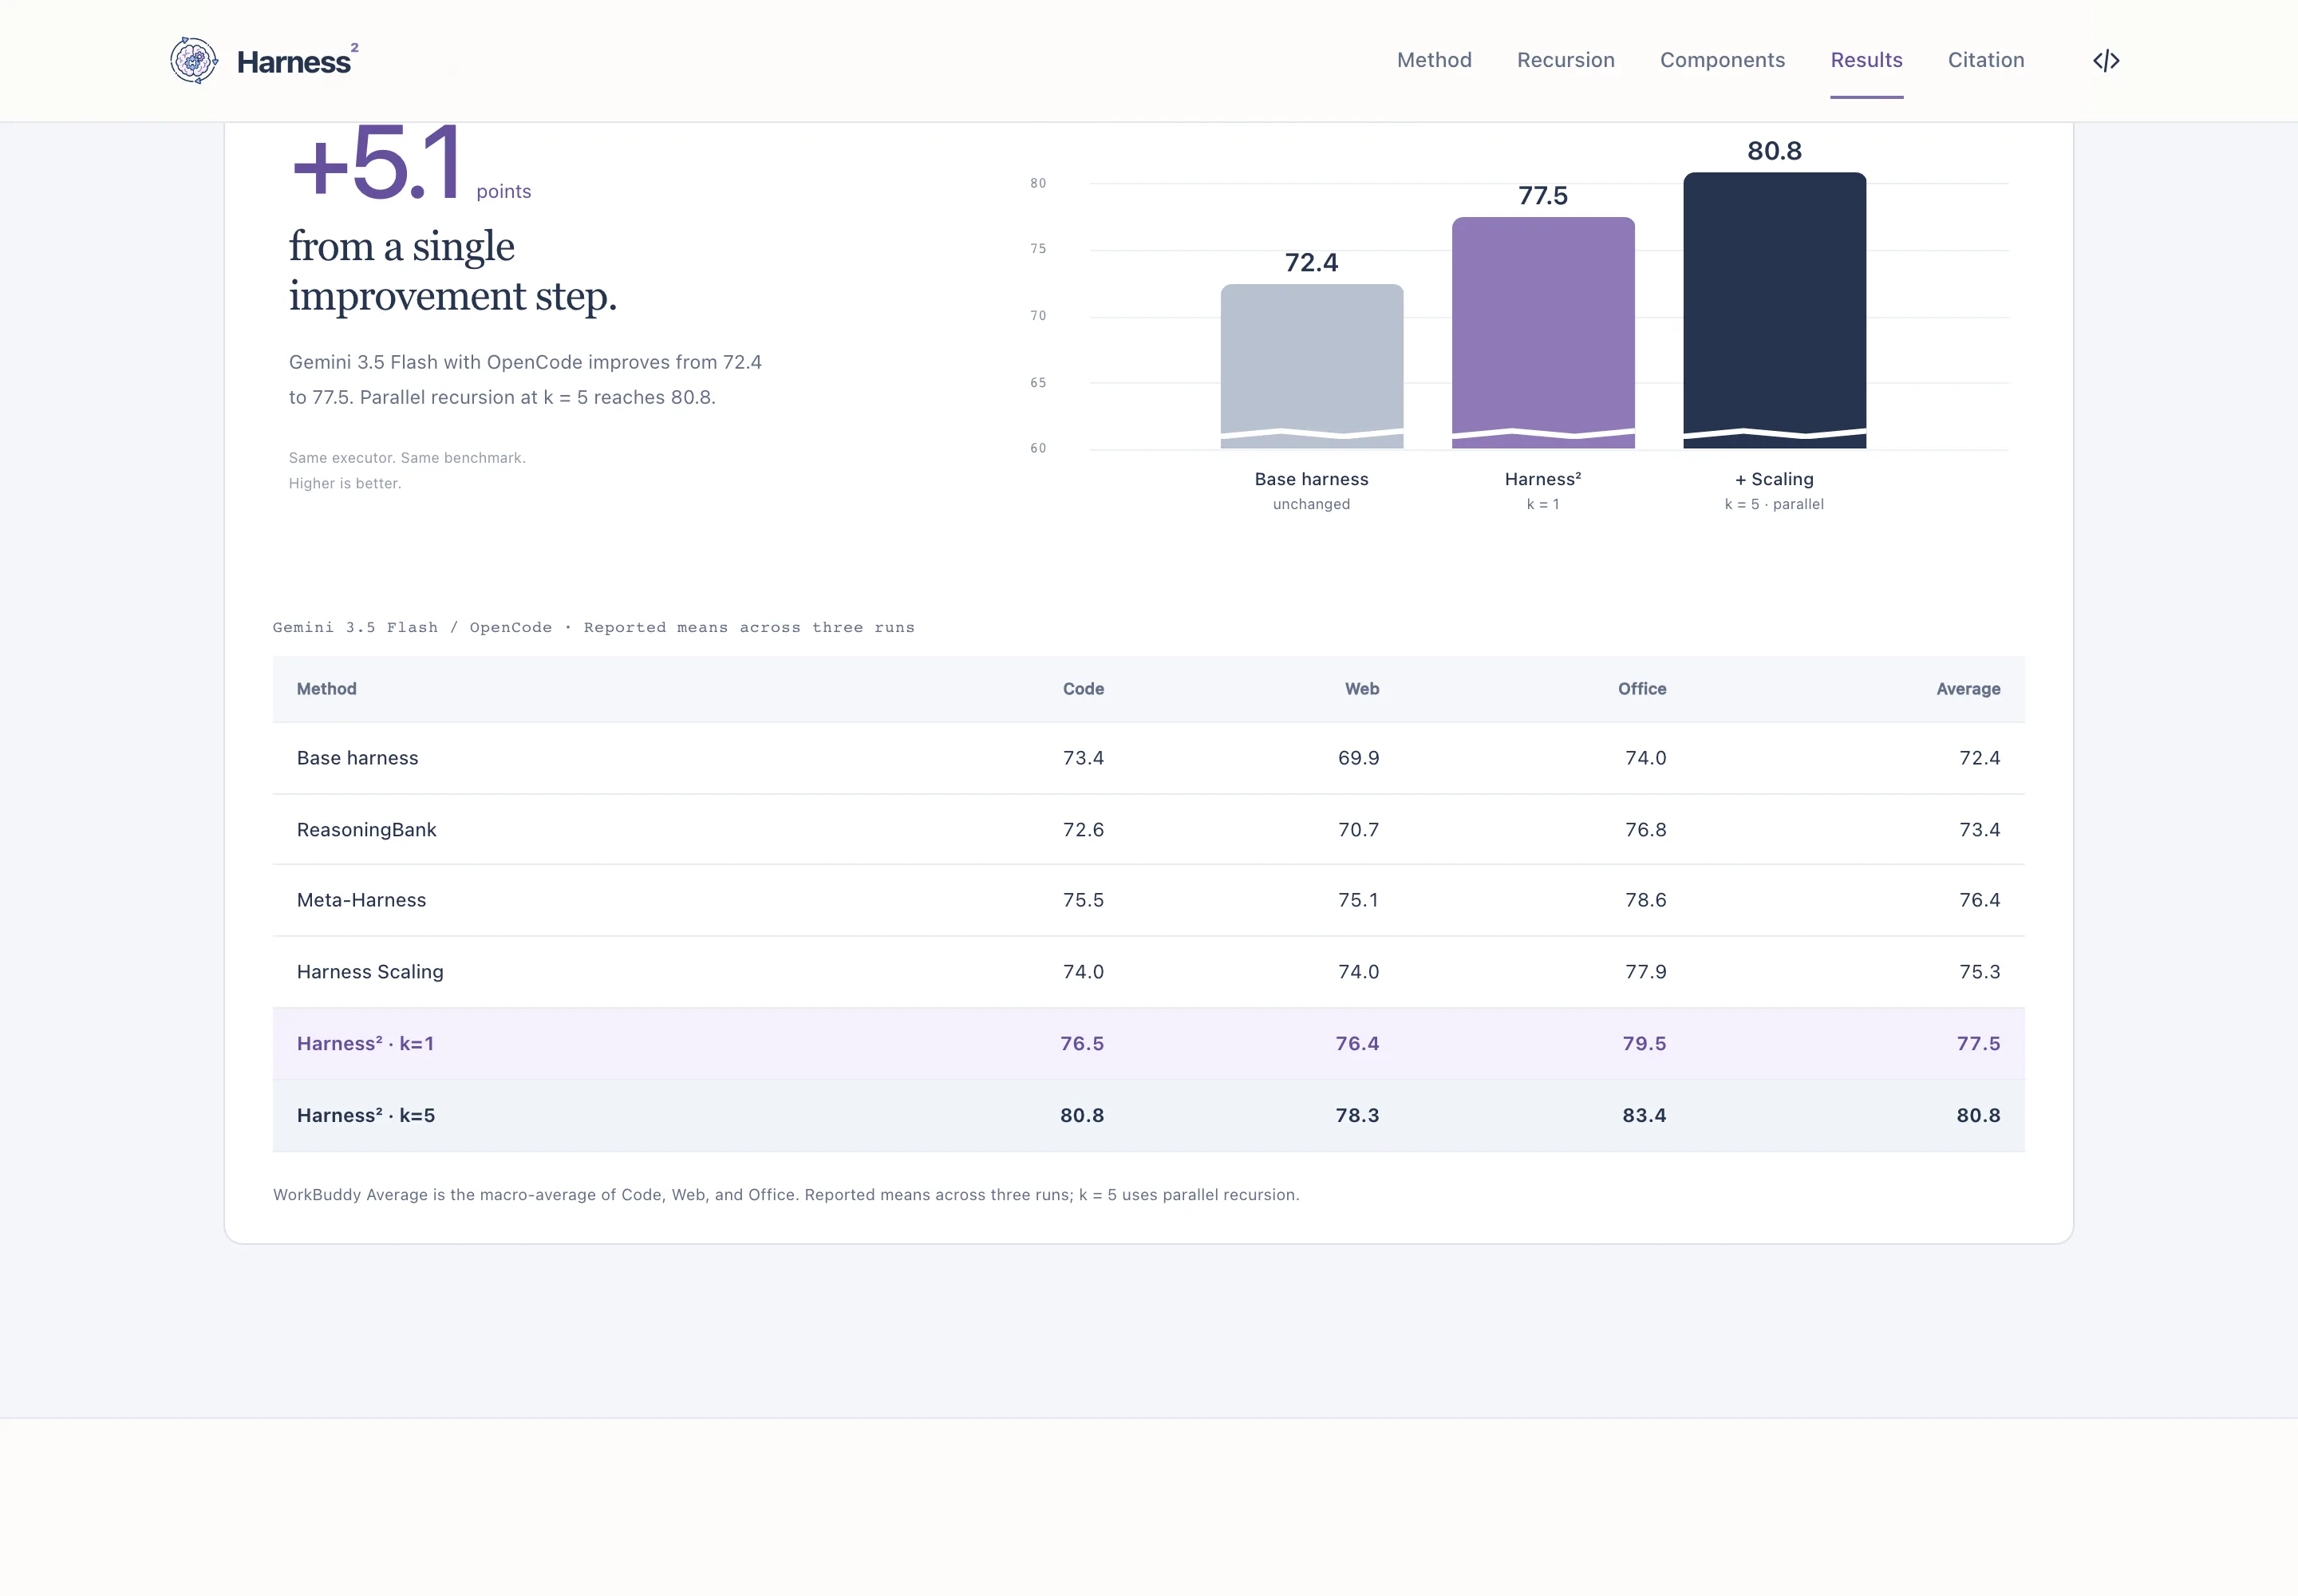
把 Gemini 3.5 Flash 搭 OpenCode 這組的完整數列攤開,更能看出各方法的差距。專案頁公布的三次執行平均值顯示:WorkBuddy-Bench 平均分從原始配備的 72.4,到 ReasoningBank 的 73.4、Meta-Harness 的 76.4、Harness Scaling 的 75.3,Harness² 單步來到 77.5,k 等於 5 的並行模式再推到 80.8。三個子域(程式、網頁、辦公)都呈現同一方向,其中辦公類從 74.0 一路升到 83.4。在這組數列裡,三個對照基線都贏過原始配備,只是幅度從 1.0 到 4.0 分不等,Harness² 單步的 77.5 仍高於全部;對照前一段十二組配對的整體戰績,方法之間的差異比「有沒有做自我改良」這件事更大。
還有一層容易漏看:這三套基準都不是 Google 自家的。LAB 的上游是 Harvey AI 的法律任務庫,JobBench 來自 Job-Bench 團隊,WorkBuddy-Bench 來自騰訊。Google 提供的是框架與轉接器,量測鏈的另一半是 Vertex 上的評審模型。論文也提醒,換評審模型等於換量尺,重現成績必須對齊模型、執行器、任務子集、預算與評分設定,就連評審與結報指令都要沿用和改良執行時相同的基準、子集、k 值、模式與亂數種子,否則量出來的不是同一場考試;官方文件甚至註明,評審遇到 Vertex 配額錯誤時該次不計分、晚點重跑評審指令即可。
離線示範的門檻很低,模型基準是另一回事。官方安裝文件要求 Linux 加 Python 3.12(套件相容 3.13)、Node.js 20 以上、uv、Google Cloud CLI,WorkBuddy-Bench 還要 Docker。模型端的設定走 Vertex AI:複製 .env 範本、填入專案與模型 ID、gcloud 登入;評審模型是另一個獨立欄位,文件建議從小任務子集開始跑,因為每一次模型執行都要錢。WorkBuddy 的安裝程序會驗證資料集的 SHA256 加總,驗不過就拒絕解包,並以工作內的本地代理刷新憑證、保留 Gemini 工具呼叫的思考簽章;LAB 另外要 Pandoc 與 Poppler,逐次執行則是在同一套指令上加一個模式參數。
環境變數集中在同一份 .env 檔,幾個欄位值得認得:解算與評審模型分開設定,WorkBuddy 要求解算模型帶 Vertex 前綴、評審模型用裸型號 ID;想換評審供應商,改 base URL 與 API 金鑰即可。JobBench 的資料集在 Hugging Face 上公開且不設閘門,不必註冊帳號或同意條款,安裝程序會記下資料集版本供重現。同一條指令重跑可以續跑;換模型或換任務子集時,官方建議換一個輸出目錄,避免新舊結果混在一起。
資安上有兩件事必須自己動手。執行器的網路存取預設不設限,Codex 執行器更直接以沙盒停用的模式跑,官方文件明說評測前要自行設限,否則代理連得上基準答案;而 JobBench 的評分標準在 Hugging Face 上公開,任何有網路能力的執行器都抓得到,文件建議跑分時封鎖相關網域。這不是理論風險:一個會自己改配備的代理,配上不受限的網路,等於把考卷放在它伸手可及的地方。
回到前面記下的 28 次執行。離線示範跑的是確定性編輯器,成本只是電費;換成模型任務,每一次探測都是真實的 API 呼叫。論文附錄 F 把這條寫得很白:遞迴改良需要額外的執行與編輯器會話,預算增加就是推理成本增加,並行只能降低延遲、省不了算力。
儲存庫的 issue 清單印證了這一點。10 月中以來討論度最高的三個議題,一個是回報工具會漏計中斷後重跑的改良器支出(八則留言),一個是提案給執行加上美元計價的花費上限,一個是要求支援更多執行器。用一套會自己多跑好幾輪的系統,錢包管控先於效能調整,這個順序社群已經替你排好了。
生態的變形速度也值得看一眼。開源後不到兩週,GitHub 上已經出現一票第三方改作:有人把「提出、探測、組合」的循環做成 DeepSeek Harness 的外掛(dsh-plugin-harness2,10 月 19 日建立),有人用它養紅隊攻擊代理、跑在 OpenRouter 的模型上(harness2-redteam,10 月 18 日),也有標榜人工回饋與可重現評測的社群分支(harness2-local),還有接到另一套 rdsh 執行器的實驗性轉接器。這些專案都還很小,但方向一致:把這套改良循環搬進自己慣用的執行環境。
兩個誠實邊界值得抄下來。無標準答案下的行為對比對執行變異與共同的模型偏誤都敏感,不保證正確性,也不保證單一任務上採用的修改能遷移到別的任務。另一個注意點出在實務層:配備裡的記憶與經驗庫會跨任務累積,多人共用的代理得自己畫出資料與權限邊界,某個專案的客戶資料不該因為被寫進心得就變成通則;這層治理論文只在未來方向帶過,邊界要由部署團隊自己定義。
專案狀態方面:Apache-2.0 授權,論文採 CC BY 4.0,third_party 目錄與三套基準資料各自沿用上游授權,WorkBuddy 的資料集掛的是騰訊自訂授權條款,商業使用前要分層檢查。README 的免責段寫明這不是正式支援的 Google 產品,也不在 Google 開源漏洞獎勵計畫內;目前沒有 tagged release,版本停在 0.1.0,最後一次提交停在 10 月 14 日修正 arXiv 連結。尚未確認的還有三件事:GLM-5 在 Vertex 上的實際接法、LAB 那個 11.8 個百分點出自哪個組合(論文摘要句未指明)、以及 Pi 與 Claude Code 執行器會不會收進官方支援。論文目前是 arXiv 預印本,尚未見同儕審查版本;星數與議題走勢值得在一個月後回頭看一次。
如果你所在團隊已經有測試與執行紀錄,這套框架值得花一個下午:先跑免金鑰的離線示範理解機制,再挑一個成本可控的單一任務試一輪,把遞迴預算與花費上限設好,成敗都用執行軌跡留證。如果只是想按一個按鈕就得到更強的代理,現在還不是進場時機,等生態系把執行器、花費管控與記憶治理整理成更完整的產品再說。