TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Gemini Search 是 MIT 開源的 Perplexity 風格 AI 搜尋引擎,一支 Google API 金鑰就能啟動。290 行後端零遙測、引用來源直接對應答案段落,但寫死的 2.0 Flash 實驗模型已被 Google 關閉:fork 前先改模型字串、補額度護欄,接地搜尋費率與 Vercel 部署地雷一併算清楚。
用 AI 摘要這篇文章:
Perplexity 每天給你的免費查詢次數有限,搜尋紀錄也得經過別人的伺服器;如果想自己架一台同樣「問一句話、拿一組附引用來源的答案」的搜尋引擎,工程量有多大?開發者 Ammaar Reshi 在 2025 年 1 月交出的答案是一天:他用現成的全端範本加上 290 行後端程式,拼出了 Gemini Search,丟上 GitHub 後累積 2,070 顆星、411 個 fork。它到今天仍然是一份乾淨好讀的自架教材,但寫死的模型字串指向 Google 已經關閉的服務,2026 年要 fork 它,第一個動作是改一行程式碼,第二個動作是補上額度護欄。
Gemini Search 是 MIT 授權的開源專案,定位是 Perplexity 風格的 AI 搜尋介面:一個提問框、一段 AI 整理出來的答案、答案上方一列來源卡片,還能在同一個對話裡繼續追問。前後端都在同一個 repo 裡,前端是 React 加 Vite,後端是一支 Express 檔案,核心邏輯集中在 server/routes.ts 這 290 行裡。
它真正的搜尋機制值得說清楚,因為 README 的寫法容易讓人誤會。README 把搜尋來源寫成「Google Search API integration」,看起來像要另外申請 Google Custom Search Engine。實際打開原始碼,後端是把 Google 官方的接地搜尋工具(grounding with Google Search)掛給 Gemini 模型:模型在生成答案時自己去查 Google,再把用到的網頁連結列出來。整個專案需要的環境變數只有一個 GOOGLE_API_KEY,到 Google AI Studio 申請一支金鑰填進 .env 就能啟動,不需要任何其他服務的帳號。
這個設計也決定了它的成本與上限:每次搜尋都是一次帶接地工具的 Gemini API 呼叫,答案品質跟著 Google 當前提供的模型走,引用來源則是模型自己挑的,沒有傳統搜尋引擎那種排序規則可以調。
引用清單的產生方式藏在細節裡:模型的每個答案都附一份詮釋資料,裡面列出這次接地查詢用到的網頁,以及「答案的哪一段文字對應哪一個來源」的支持關係。後端把這份詮釋資料攤開,每個來源配上一段引自答案本文的摘要,再整批送給前端顯示。換句話說,你在答案旁看到的來源卡,對應關係是模型生成的產物,不是搜尋引擎算出來的權重。對需要嚴格查證的場合,這一層還是要自己點開來源核對。
還有個只影響中文用戶的小細節:後端拿到模型輸出的純文字後,會用一組正規表示式把它加工成 Markdown,把「英文單字加冒號」開頭的行當成小標題處理。這套規則只認英文字母開頭,遇到中文答案幾乎原樣放行。實際效果是英文查詢的答案會被整理出明顯的標題層次,中文查詢的答案則保持模型原本的段落樣貌,兩種語言拿到的排版細膩度不太一樣。
實際把 repo clone 下來,第一個發現是它的體積:519MB、23,762 個檔案。原因很直接,前作者把整包 node_modules 和 macOS 的 .DS_Store 都提交進了版本庫。這對下載速度是小麻煩,對想部署到 Vercel 的人是大坑,後面會看到社群為此付出過的代價。
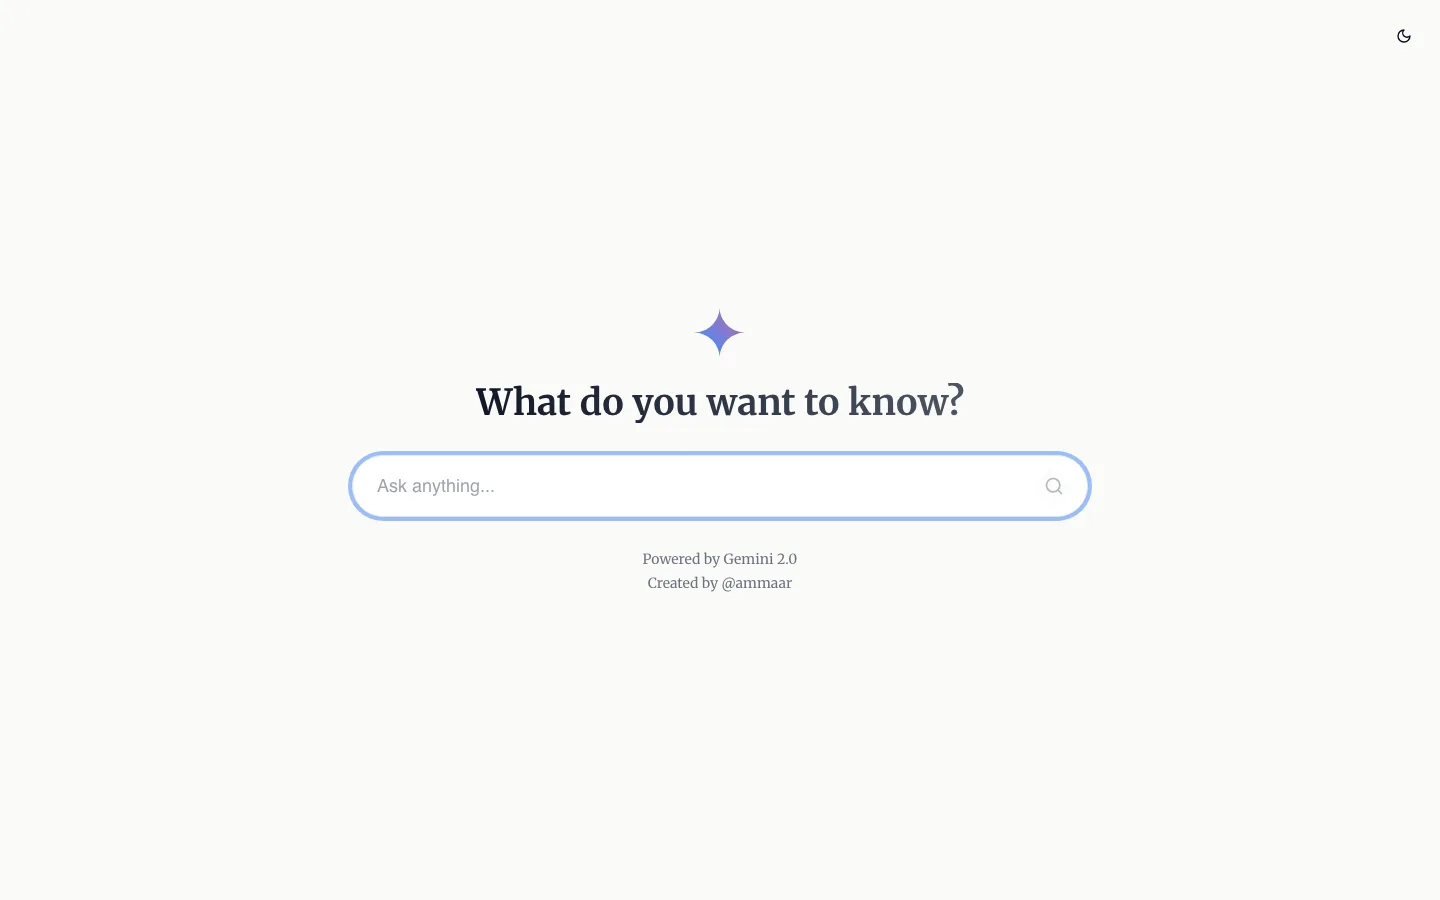
照 README 的步驟裝好依賴、填入金鑰、執行 npm run dev,伺服器會在本機 3000 埠起來。首頁是一片米白的極簡介面:中央一個紫色星芒圖示,大標題寫著 “What do you want to know?”,輸入框的提示文字是 “Ask anything…”,右上角可以切換深色模式,字體用的是 Google 的 Merriweather 襯線字。整體視覺確實有 Perplexity 的影子,完成度對一個單人單日專案來說相當高。
搜尋結果頁的結構也照著 Perplexity 的路數走:查詢文字下方先是一列橫向捲動的來源卡片,每張卡帶標題、連結與一小段對應本文的摘要,點開會用新分頁開啟來源網頁;主要版面留給 AI 整理的答案本文,照介面的設計,答案跑完後下方會多出一個追問框,沿用同一個對話繼續問下去。這條「搜尋、看來源、追問」的動線在 290 行後端加幾個 React 元件的組合下就完成了,是這個專案最值得參考的部分。
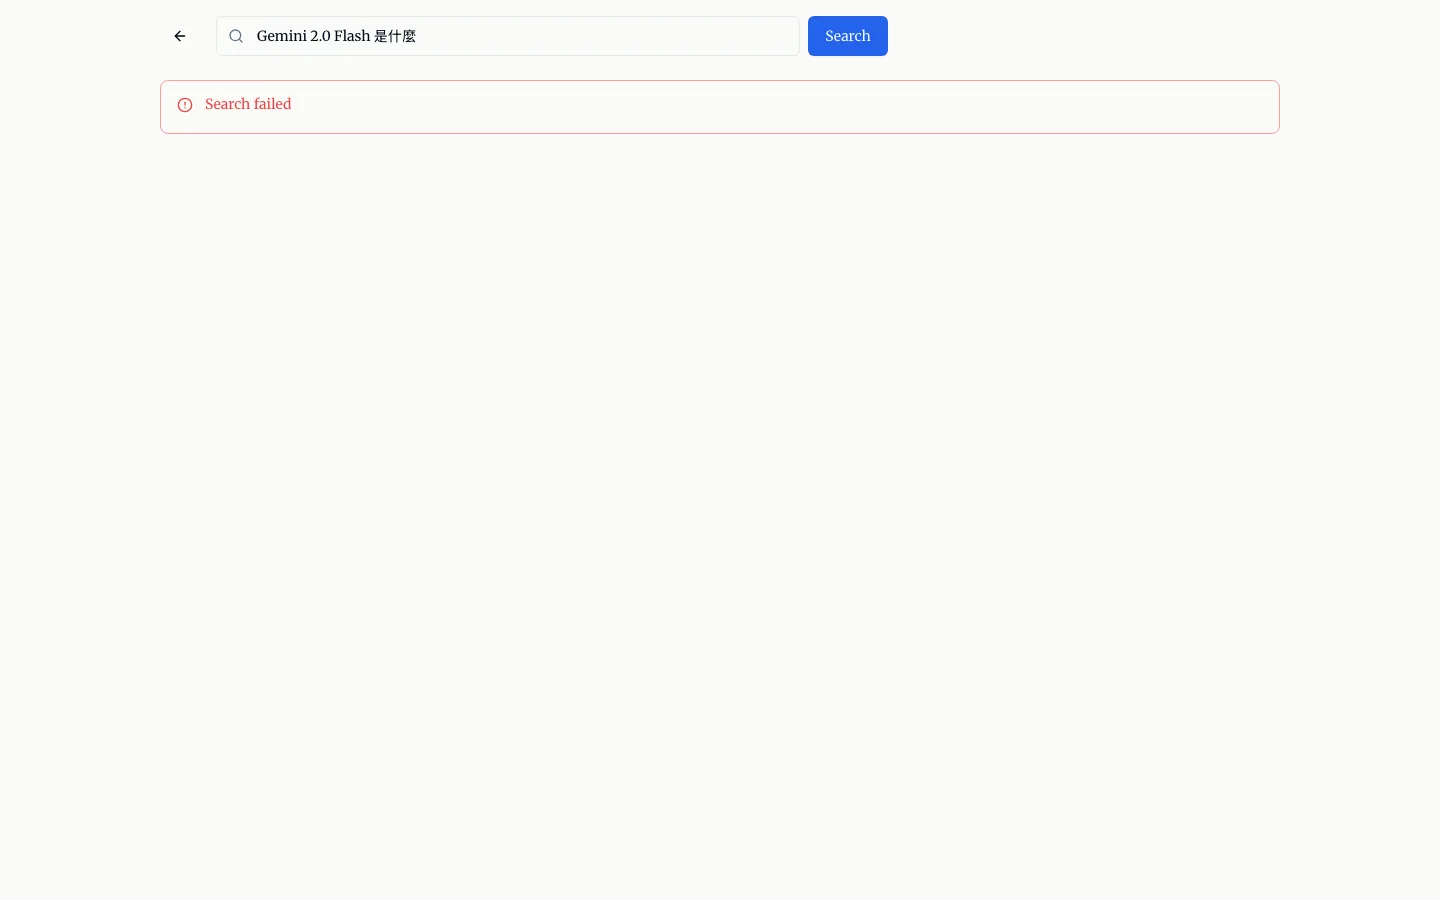
有兩個行為層的觀察值得記下來。第一,整個專案沒有任何遙測:從首頁載入到送出查詢的完整過程,對外請求只有載入 Google Fonts 字體的兩筆,沒有分析服務或錯誤追蹤,也沒有指紋腳本,搜尋內容不會經過第三方的手。第二,它的錯誤處理很陽春:用無效金鑰送出查詢時,畫面只會跳一行 “Search failed”,而伺服器端把 Google 傳來的完整錯誤訊息原樣透傳給前端,除錯時資訊很足,但如果你打算給別人用,這種把後端錯誤攤開的行為就需要再包一層。
這個專案在 2025 年 1 月 4 日之後就沒有再改過一行程式碼,近兩年下來,有三個地方已經跟現實脫節,fork 之後要自己處理:
| 要動的地方 | 為什麼 | 怎麼動 |
|---|---|---|
| 模型字串 | 程式寫死 gemini-2.0-flash-exp,這個實驗版別名所屬的 2.0 Flash 全家族,在 Google 現行模型文件裡已列為已關閉 | 把 routes.ts 裡的模型 ID 換成文件建議的現行版本,例如 3.5 Flash-Lite 或 3.8 Flash |
| 額度護欄 | 後端沒有帳號驗證、沒有速率限制,而且監聽所有網路介面;對話 session 存在伺服器記憶體裡,只進不出 | 部署後加一層反向代理的驗證與限流,或至少鎖在內網使用 |
| 部署目標 | Express 常駐伺服器加上記憶體 session 的架構,跟無伺服器平台天生不合 | 選 VPS、Docker 或自家機器這類常駐環境 |
模型字串這項是最關鍵也最容易被忽略的。原始碼第 14 行寫死了 gemini-2.0-flash-exp,這是 2024 年底 Gemini 2.0 Flash 還在實驗階段時的別名。對照 Google 目前的官方模型頁,gemini-2.0-flash 與 gemini-2.0-flash-lite 都已標注為已關閉的舊模型,新專案被引導到 3.5 Flash-Lite 與 3.8 Flash。也就是說,GitHub 首頁那段 2025 年 1 月的示範影片記錄的是當時的可用狀態,現在照原樣啟動,程式本身跑得起來、介面也正常,但送出查詢後會直接撞上已關閉的端點。幸運的是這個專案的模型名只出現在一個地方,改一行字串就能接上現行模型,這也是它作為改造底盤的優勢:可動的零件很少,每個都看得見。
額度護欄是安全與帳單問題。後端對 /api/search 沒有任何驗證與限流,任何人拿到你的網址就能用你的金鑰搜尋。issue #12 有人直接引 Google 官方定價提醒:接地搜尋在付費層是每 1,000 次查詢計費的。另外對話 session 用一個 Map 存在記憶體裡,每搜尋一次就多一筆、永不清除,伺服器跑得越久吃越多記憶體;session 編號用的只是 Math.random(),談不上密碼學等級的隨機。自用沒差,公開服務就是把自己的 Google 帳單交給陌生人。
部署目標則是社群踩過的坑。issue #2 底下 12 則留言記錄了一波 Vercel 部署失敗潮:先是 node_modules 入庫導致 build 直接失敗,有人建議刪掉重來;接著有人部署成功、首頁能開,搜尋端卻吐 404;最後連嘗試補設定檔的人也放棄了。根據伺服器的寫法,它固定監聽 3000 埠並把狀態放在記憶體,這種常駐架構放到無伺服器平台上,本身就對不上拍。結論很簡單:找一台能長時間跑 node 的機器,比跟平台設定纏鬥省事。
自架 AI 搜尋的成本幾乎全部落在接地查詢的計費上,這也是它跟「免費」之間真正的距離。以 Google 目前的定價頁為準,Gemini 3 系列的接地搜尋是每月 5,000 次免費(所有 Gemini 3 系列模型共用這個額度),超過之後每 1,000 次 14 美元;如果是 2.5 世代的模型,免費層是每日 500 次(與 Flash-Lite 共享),超過後每 1,000 次 35 美元。issue #12 引用的 35 美元費率屬於 2.5 世代,現在換到 3 系列模型反而更便宜。
換算成使用情境:一個人每天查個一二十次,一個月三五百次,落在免費額度內,等於零成本;再重一點,每天 50 次、一個月 1,500 次,仍只用掉三分之一的月額度。但要注意 3 系列的每月 5,000 次是所有 Gemini 3 系列模型共用的,如果你的 Google 帳號同時還跑其他 Gemini 3 系列應用,額度會互相排擠。真正會超出額度的情境是公開服務:架起來給一個班級、一間公司用,5,000 次的月額度很快見底,之後每 1,000 次 14 美元的帳單會隨著人數上升。這也是前一段強調額度護欄的原因:這個專案原生沒有任何擋量的設計,成本控制完全依賴你加的那一層。
把 GitHub 的提交紀錄攤開,這個專案的時間軸異常乾淨:三個 commit 全部落在 2025 年 1 月 4 日同一個小時裡,之後就沒有下文,沒有任何正式版發布。作者的 GitHub 個人頁現在的自我介紹是產品與設計負責人,這個 repo 對他來說更像一次被大量關注的實驗,長期維護的承諾從來沒有給過。
停止維護的直接後果,是使用者的需求全部沉在 issue 列表裡等答案:有人想換成 Qwen 模型、有人要搜尋結果的複製按鈕、有人想要查詢歷史記錄、有人問能不能出 Python 版、有人問怎麼部署到 Cloudflare Workers,這些都沒有被採納。十個開著的 issue 裡,最後一篇新開的停在 2025 年 8 月,之後就是純粹的靜默。但換個角度看,411 個 fork 正是大家自己動手的證據,這類薄而清楚的小專案,改造的成本遠低於等待維護。
原始碼裡還有一些範本殘骸可以佐證它的出身:package.json 的專案名還叫 rest-express,依賴裡躺著 Replit 平台的專屬套件、從未被伺服器引用的資料庫套件與帳號驗證套件,db/ 目錄裡的 users 資料表沒有任何程式使用。想清理的人可以放心拔掉這些,不影響任何功能。真正被用到的依賴屈指可數:Gemini 的官方 SDK、Express、marked(把模型輸出轉成 HTML)、以及一大包只用了少數元件的 shadcn UI 庫。
想理解 Perplexity 這類產品骨架的開發者,會在這 290 行裡看到最完整的縮影:一個提問如何變成一次帶接地工具的模型呼叫、引用來源如何從模型的詮釋資料裡抽出來、追問如何在同一個 session 裡延續。想把 AI 搜尋收進自己基礎設施的人,拿到的是一個零遙測、MIT 授權、一小時能讀完的底盤。已經有 Google AI Studio 金鑰的台灣讀者還有一個額外優勢:issue 裡中國大陸使用者反映的連線失敗與代理參數需求,在直連 Google API 的網路環境裡根本不會遇到。
不適合的情境也一樣明確:想要一個開箱即用、不用碰程式碼的搜尋服務,這裡沒有官方線上版可用(repo 沒有部署任何示範站),自己架又要改模型又要顧額度,直接用 Perplexity 或 Google 自家的 AI 模式省事得多;想要多人共用、有查詢歷史、有權限管理的團隊工具,這個底盤要補的工比找現成方案更多。
如果你決定 fork,順序建議是:先把模型字串換成現行版本並在本機驗證搜尋真的動了,再決定要加額度護欄還是鎖內網,最後才挑部署環境。想比較其他開源 AI 檢索路線的,可以看我們之前寫過的 Local Deep Research 自架深度研究工具 與 開源 AI 資源總整理;想看 3.8 Flash 世代模型的第一手介紹,Gemini 3.8 Flash TTS 語音模型的實測 有更多細節。