TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

研究者 Sophia Xu 公開 OpenTTD-Bench,讓語言模型代理在開源運輸遊戲裡即時經營運輸公司:三場平均規則程式 AAAHogEx 賺 1,780 萬美元、GPT-6 Astra 421 萬美元;五世代單挑從 37 分鐘棄局爬到 991 萬美元,仍輸手寫規則。回到官方研究頁拆解計分方式、慢時鐘對照與這場比較還不對稱的地方。
用 AI 摘要這篇文章:
讓 AI 代理回答一道難題,和讓它把一家公司連續經營十年,考的是兩種能力。研究者 Sophia Xu 在 10 月 29 日公開的 OpenTTD-Bench,就是把這兩件事拆開來量的新評測:開源運輸模擬遊戲 OpenTTD 裡,四個代理同場經營互相競爭的運輸公司,遊戲時鐘以真實時間前進,不會因為哪個代理還在想而暫停,十年遊戲時間跑完(實際約兩小時四十分),以累計營運利潤論輸贏。三場平均的結果很直接:規則程式 AAAHogEx 賺進 1,780 萬美元,表現最好的語言模型代理 GPT-6 Astra 賺 421 萬美元,差距超過四倍。但同一份研究裡另一組數字更值得停下來看:三月上市的 GPT-5.4 上場 37 分鐘就棄局、終場小虧;九月底上市的 GPT-6.1 Sol 撐完全場、賺進 991 萬美元。我的判斷是,這份評測真正量到的是持續管理與事前準備兩件事,而它的作者也明白標出了這場比較還不對稱的地方。
先看遊戲規則,因為規則決定了這個評測和一般問答型基準的差別。OpenTTD 是一款經營運輸公司的開源模擬遊戲,這次評測用 15.3 版,一張地圖上四個席位:兩個語言模型代理,加上兩個 AAAHogEx v115 原生 AI 公司。所有人拿同樣的 80 萬美元起始資金、不能借貸、只能蓋鐵路與公路。遊戲從 1950 年跑到 1960 年,以 0.75 倍速連續前進;依任務說明,整局約兩小時四十分。
計分方式由兩個成分構成:營運利潤達到 300 萬美元目標的進度佔 60%,四家公司裡的名次佔 40%(每贏過一家得三分之一)。利潤看的是公司帳本上的累計營運利潤,運輸收入減去車輛維護、財產開支與利息,蓋車站和買賣車輛的錢不計入。想把利潤做起來,代理要做的事環環相扣:依供給、需求、距離與競爭挑路線,考量地形把車站、道路與軌道蓋在對的位置,買車、排班、設號誌讓列車不對撞,還要盯著既有路線的財務表現,隨城鎮成長與對手動作調整,並在整段時間裡分配有限的資金。最關鍵的一條規則寫在任務說明的規則區:時鐘以真實時間運行,當你在思考、勘察或除錯時,遊戲不會暫停(引句為本文翻譯)。代理必須在世界持續變動的情況下分配資金、蓋路線、盯既有服務,而不是給出一次最佳答案就交卷。
代理透過 ottd 命令列工具與 Python 客戶端程式庫操作遊戲,每個席位用獨立的系統使用者隔離,只能用授權過的 HTTP 呼叫行動,碰不到評分器與遊戲原生控制。所有代理收到同一份初始任務說明,但各代理框架自帶的系統提示詞未做修改,這點後面還會回來。介面本身有兩道節流:批次查詢一次最多 100 個要求、伺服器每秒約 120 個呼叫;規則基準不受這兩道限制,反過來受遊戲引擎每秒約 7 個建設指令的上限約束。代理可以寫自己的工具、派子代理分工,任務說明裡也提示了這個選項,實驗沒有另設並發或花費上限。
主要結果來自三場種子不同的完成局,四個席位同場。圖表上三條曲線:AAAHogEx 兩個席位先在每場內平均、再將三場等權平均,得 1,780 萬美元;GPT-6 Astra(用 OpenCode 框架、座位 1)421 萬美元;Claude Opus 5.5(同樣 OpenCode、座位 2)23 萬美元。Astra 越過了 300 萬美元的目標線,但仍落後規則程式超過四倍;研究頁的結論用一句話總結,大意是:截至 2026 年 10 月底,前沿語言代理已有顯著進步,GPT-6.1 Sol 與 GPT-6 Astra 領先,但仍未超過規則基準。
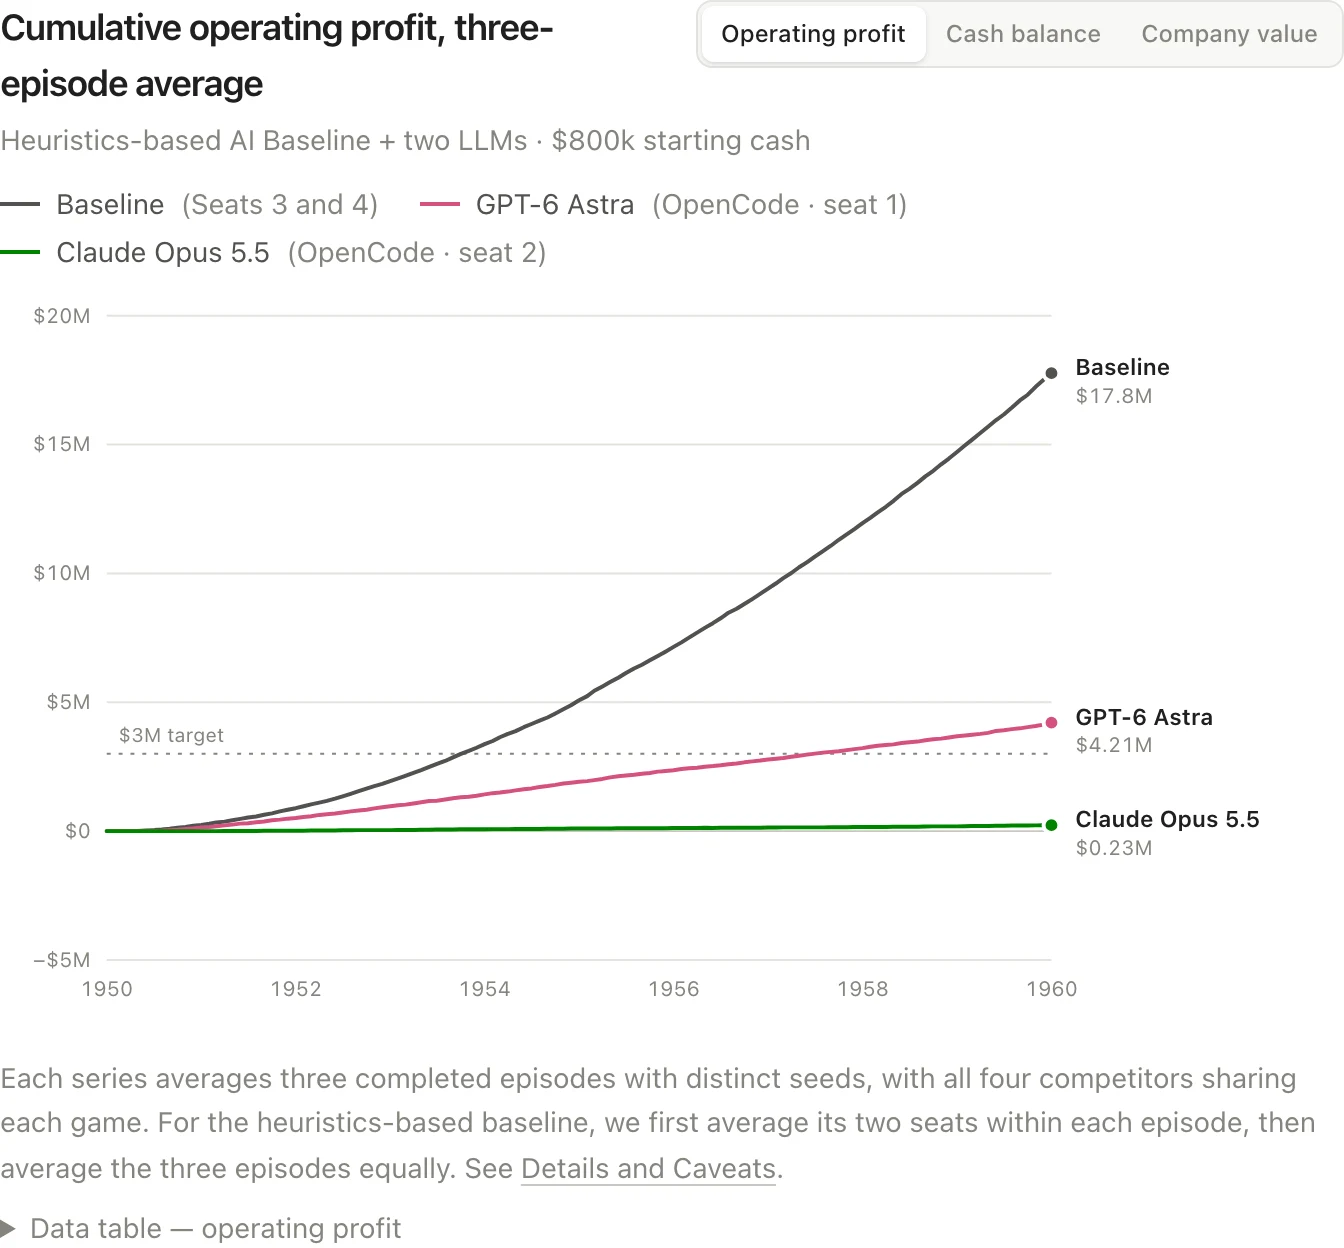
值得認識一下贏家。AAAHogEx 是 OpenTTD 社群裡一套符號邏輯 AI,社群多項評比公認是「最會賺錢的 AI」,以 GPLv3 授權釋出。它的作者自述的大意是:這個 AI 理解地圖上的供應鏈,建造最佳運輸路線,為此它有完整的接駁系統與估算能力。換句話說,它對這個遊戲的判斷是人寫死在程式裡的,出場自帶整套輔助程式;語言代理卻要在三小時內自己理解環境、把反覆要做的事寫成工具、再一邊營運。勝負不能全部記在推理能力頭上,這也是研究頁自己承認的但書。
還有一個容易讀漏的細節:GPT-6.1 Sol 並沒有參加這三場四強局。它只出現在另一組單挑實驗裡,也就是下一節的主角。把兩組數字混著比,會以為 991 萬美元是在同場擊敗基準,實際上不是。
附錄裡的模型世代對照,是我認為這份研究最有價值的部分。實驗設計:五個 GPT 模型各自與一個 AAAHogEx v115 單挑,同一張世界種子、同樣 0.75 倍速、同樣 80 萬美元起始,五場全部用 Codex 0.162.1 框架搭配高強度推理設定。結果按模型上市日排開:三月上市的 GPT-5.4 虧損 46,780 美元,上場 37 分鐘就棄局,公司放著沒人管到期限;四月上市的 GPT-5.5 賺 153 萬美元,60 分鐘後同樣棄局;七月上市的 GPT-5.6 Sol 賺 219 萬美元,撐到 1960 年;九月上市的 GPT-6 Astra 賺 862 萬美元;九月底上市的 GPT-6.1 Sol 賺 991 萬美元,是五代裡最高的一代;即使對上五場中獲利最低的基準對手(2,639 萬美元),差距仍約 2.7 倍。
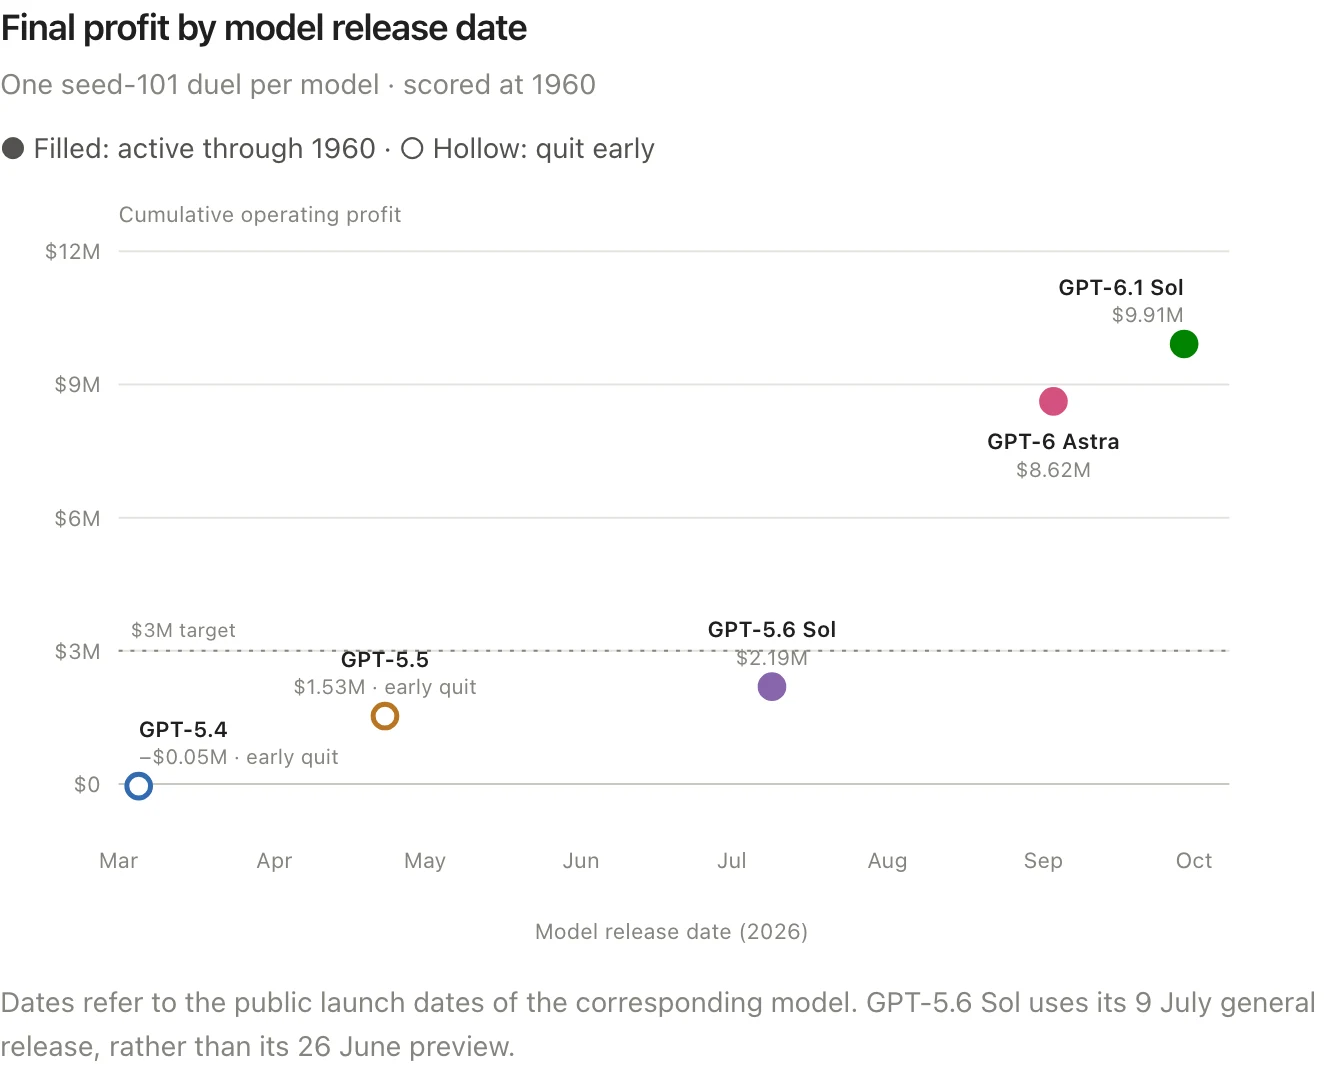
棄局本身是一種失效樣態,形式有兩種:直接結束對話不再呼叫工具,或用等待指令一路等到終局。公司還在,但從那一刻起沒有人看管。對照組的 AAAHogEx 在這五場單挑裡的獲利從 2,639 萬到 5,175 萬美元不等,遠高於四強局三場平均的 1,780 萬,這說明基準自己的成績也隨著座位組合大幅變動,任何單一數字都不該當成它的固定實力值。
另一個必須畫底線的地方:同一個模型換框架、換座位組合,數字就變。GPT-6 Astra 在 OpenCode 四強局三場平均 421 萬美元,在 Codex 單挑局是 862 萬美元。研究頁把主要比較、慢時鐘與世代對照列為不同設定;在我讀來,這等於提醒讀者這些曲線不能當成只換了模型名稱的受控實驗。要談進步從哪裡來,得回到每一條曲線自己的執行條件。
如果懷疑代理輸在時間不夠想,直覺的檢驗是把時鐘放慢。研究附了一場這樣的對照:同樣的陣容、種子 101,速度從 0.75 倍降到 0.25 倍,一局從約三小時拉長到約八小時,代理每遊戲年多出約三倍的實際思考時間。結果 GPT-6 Astra 賺 642 萬美元,高於同一種子在 0.75 倍速的 498 萬美元,但兩場的名次都是第三。時間變多,錢有變多,名次沒有變。
這場慢時鐘局還有一個插曲:Claude Opus 5.5 開局約 65 分鐘後因為內容過濾的結束理由停止運作,公司從此無人看管繼續跑到終場,最後結算 39 萬美元;基準則是 1,350 萬美元。研究頁明載這是種子 101 的單場對照;單一種子的結果不能推成普遍結論,但它至少示範了怎麼把時間壓力這個變因單獨拆出來檢驗。
公平性的但書也在此。研究頁明言:時間壓力可能有利於啟發式基準,因為相關的輔助程式已經為它寫好,語言代理則沒有。作者構想的緩解方案是給代理一個準備階段,先在不洩漏正式測試資訊的訓練地圖上把工具寫好,再進入正式比賽;但這個安排因為時間限制並未執行。所以在讀「仍輸規則程式」這個結論時,要記得這場比賽一方自帶軍火庫,另一方是臨場寫裝備。
數字之外,這份評測最有可讀性的是官方釋出的逐字軌跡:六場實驗、16 個語言模型席位、131 個被捕獲的子代理,全部放進互動檢視器。幾個案例值得單獨看,因為它們示範了長任務裡真正難的地方。
頭牌代理的共同做法是把重複工作寫成程式再共享。GPT-6 Astra 寫了 rail_builder.py 負責選站址、規劃並驗證軌道,派工時直接叫子代理讀這支程式與既有的路線紀錄,指示寫得像一份工單:只做研究與規劃,不做任何遊戲修改。Claude Opus 5.5 則寫了 util.py,把遊戲客戶端與批次查詢包成共享介面,讓後續的站點調查與施工檢查都叫同一套函式。先寫工具、再按預算派工,這套流程與用共同獎勵練出分工的 Avalon-M1 多代理研究面對的是同類問題:多個執行者怎麼共享狀態、不互相踩腳。派工有明確的預算與轄區:Astra 給東區煤運子代理 17.5 萬美元上限與明確座標邊界,Opus 給施工子代理 15 萬美元上限並禁止動既有鐵路與車站。
競爭意識也有實例。一場四強局裡,Astra 的偵察子代理比較各公司收入後估計:自家年獲利約 65 萬美元,領先者約 135 萬美元,缺口約 100 萬美元,接著把目標翻譯成具體數字:盡快達到每年至少 150 萬到 160 萬美元的營運利潤,不能只求列車數量。同一份報告裡有一句判斷很有味道:爭取未來的產出,對手排隊等運的貨我們收不到。Opus 則在發現煤礦已被對手卡位後,改做還沒有服務的林場到鋸木廠路線。
管理既有路線的案例更微妙。一場四個 Opus 同場的局(Claude Code 框架)裡,代理在獲利稽查時發現兩列較新的長程煤車虧錢,追回去看礦場:前一個月只產出 189 噸煤,自家四列車加對手的線一起分,兩家車站都沒有煤可運。它的處置是賣掉 132 號車,那列車當年其實還賺 4,219 美元,賣出回收 22,402 美元,理由是減少對同一座礦的爭搶。砍掉還在賺錢的資產來保護整體供給,這是單次問答考不出來的取捨。
失效案例同樣值得看。一場四個 Astra 同場的局(Codex CLI 0.154.0 框架)裡,代理回報前八輛公車都在跑,但遊戲裡的 running 狀態只代表車輛通著電,公車其實停在沒有道路連接的車庫裡,零速、零乘客,賠了一陣子錢才在檢查時發現,補上車庫聯外道路後才真正開出去載客,後續檢查裡也看得到車上出現乘客。同一個代理到後段還學會了收縮:長程公車路的車比需求多,它決定退掉空置的多餘公車、讓載客中的車跑完配送,每條路保留小一點的服務規模。把系統狀態的字面意思當成營運事實,這種錯誤在真實的自動化系統裡也似曾相識;發現之後能不能自己修回來,才是長任務真正考的東西。
評測程式以 CC0 釋出,放在 GitHub 上,八月十三日就建立,10 月 29 日是研究頁與公告貼文的公開日,不是專案開工日。不過重現一局不是抓下來就能跑:OpenTTD 本體、圖像音效素材、AAAHogEx 等依賴各有授權,多數是 GPL 系列;推論預設透過 Prime Intellect 計費;官方只支援 Claude Code、Codex 與 OpenCode 三種代理框架,其他框架要自己寫接頭。執行環境每席有 600 萬輸出 token 的保險絲(推理 token 也計入)與 12 小時閒置逾時。
研究頁列的後續方向有兩個值得記住:一是改用 CargoDist 模式,讓每個乘客與貨物帶有指定目的地,運輸網必須真的成網,策略深度會高一大截;二是開放代理之間的通訊與合約,讓它們有合作競爭的空間。這兩個方向都還沒實作,現在的成績都是在「貨物送到任何收貨站都算」的淺層規則下量出來的。
最後把這份結果的邊界說清楚。這是遊戲,需求、資訊與規則都是封閉的,遊戲裡的獲利不能推成真實企業的營運能力,研究頁自己對它的定位,也是真實世界代理能力的間接訊號與質性行為素材。所有數字都是 2026 年 10 月底這個時點的快照,模型每個月都在換代,這些曲線很快就會被新一代重畫。如果說有什麼結論可以帶走:前沿代理在「世界不停下來等它」的長任務裡,已經會寫工具、會派工、會看對手,但持續經營的成績仍然輸給一套手寫規則;差距的結構(準備時間、介面對稱性、框架工程)比「模型還不夠聰明」這個籠統答案有用得多。同樣想把代理放上真實環境檢驗的讀者,可以對照SO-101 Bench 用模擬篩選、真機驗收的機器人基準,以及VibeVideoBench 讓 AI 代理實際交出影片作品的評測,三個評測量的是不同層次的執行力。