TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

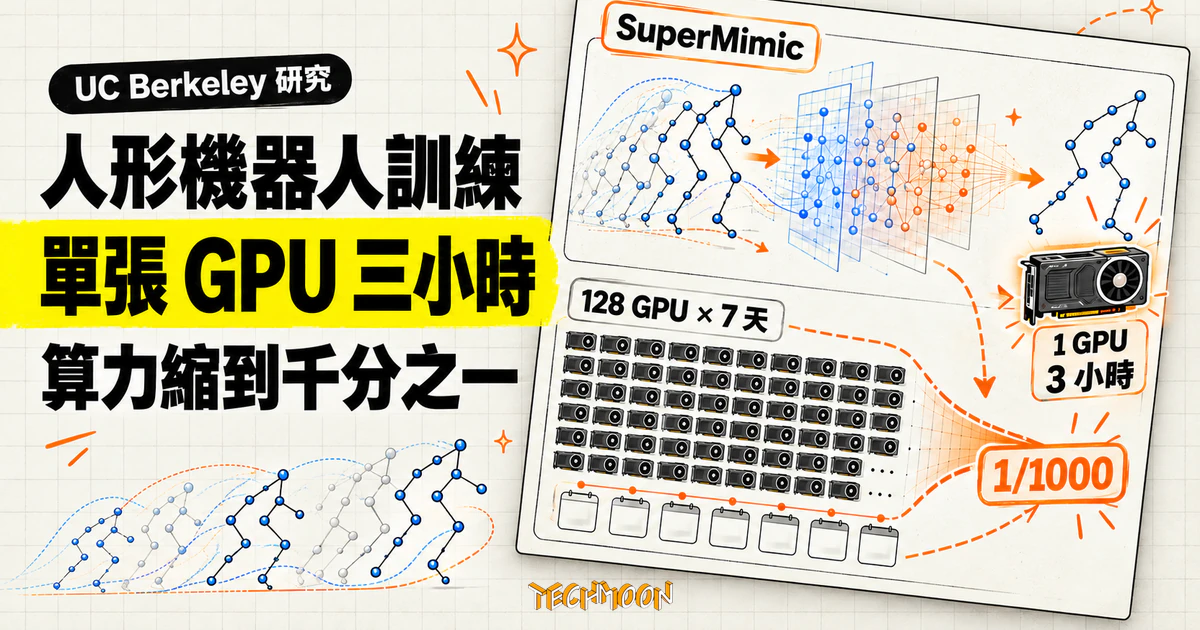
UC Berkeley 團隊 2026 年 10 月發表 SuperMimic:用一個可微分的世界模型,單張 H100 訓練三小時,正規化回報超過 128 張 L40 訓練七天的 SONIC 公開版本,GPU 時數縮減超過千倍。官方對照條件、129,514 個動作的失敗統計與真機 G1 示範的證據界線,一併攤開。
用 AI 摘要這篇文章:
2026 年 10 月 20 日,UC Berkeley 的七位研究者把 SuperMimic 論文送上 arXiv,隔天公開研究網站,第一作者 Qiayuan Liao 同日在 X 發文介紹,論文並獲 CoRL 2026 接受為口頭報告。變動本體一句話就能講完:人形機器人全身動作追蹤的訓練,原本要 128 張 GPU 跑 7 天,SuperMimic 用一張 H100 跑 3 小時,正規化回報就超過對照模型 SONIC 的公開版本,論文宣稱 GPU 時數縮減超過一千倍。官方材料裡,這組數字的對照條件、失敗統計與真機示範都寫得相當清楚,連對自己口號不利的差異,作者都主動算了帳。需要先記住的分界是:被改寫的是訓練的成本帳本,機器人會做什麼的能力帳本還停在原處。
SONIC 是發表在 Science Robotics 的動作追蹤研究,訓練方式是在模擬器裡跑無模型強化學習(PPO),論文報告動用了 128 張 NVIDIA L40、連續訓練 7 天。SuperMimic 走另一條路,讓控制策略透過一個學出來的可微分世界模型取得調整方向,硬體只有一張 H100。兩邊的帳本在研究網站上並列:
| 項目 | SONIC | SuperMimic |
|---|---|---|
| 訓練方法 | 模擬器內的無模型強化學習(PPO) | 透過學出來的可微分世界模型做梯度回傳 |
| 硬體 | 128 張 NVIDIA L40 | 1 張 NVIDIA H100 |
| 訓練時間 | 168 小時(7 天) | 3 小時,回報即超過 SONIC 公開版本 |
| GPU 時數 | 約 21,000 | 3 |
| 動作資料 | 611 小時全資料集 | 264.56 小時的 BONES-SEED 公開子集 |
| 正規化回報 | 0.90(公開版本) | 超過 0.90 |
正規化回報是把一段動作拿到的獎勵總和除以理論最大值,換算成 0 到 1 的分數,提早跌倒或中斷的動作分數會偏低,所以它同時量了追蹤品質與能否撐完整段。研究網站也把這條比較畫成曲線:橫軸是 GPU 時數、縱軸是正規化回報,SuperMimic 單卡與雙卡兩條學習曲線都越過 SONIC 公開版本 0.90 的虛線,圖上標記的時間點正是 3 小時與 9.8 小時,三條線都在同一批 129,514 個動作上計分。另一個容易漏掉的細節是,SONIC 的 0.90 是研究團隊把它的公開版本放到 H100 上重新計分得到的,不是對方論文自己回報的數字。
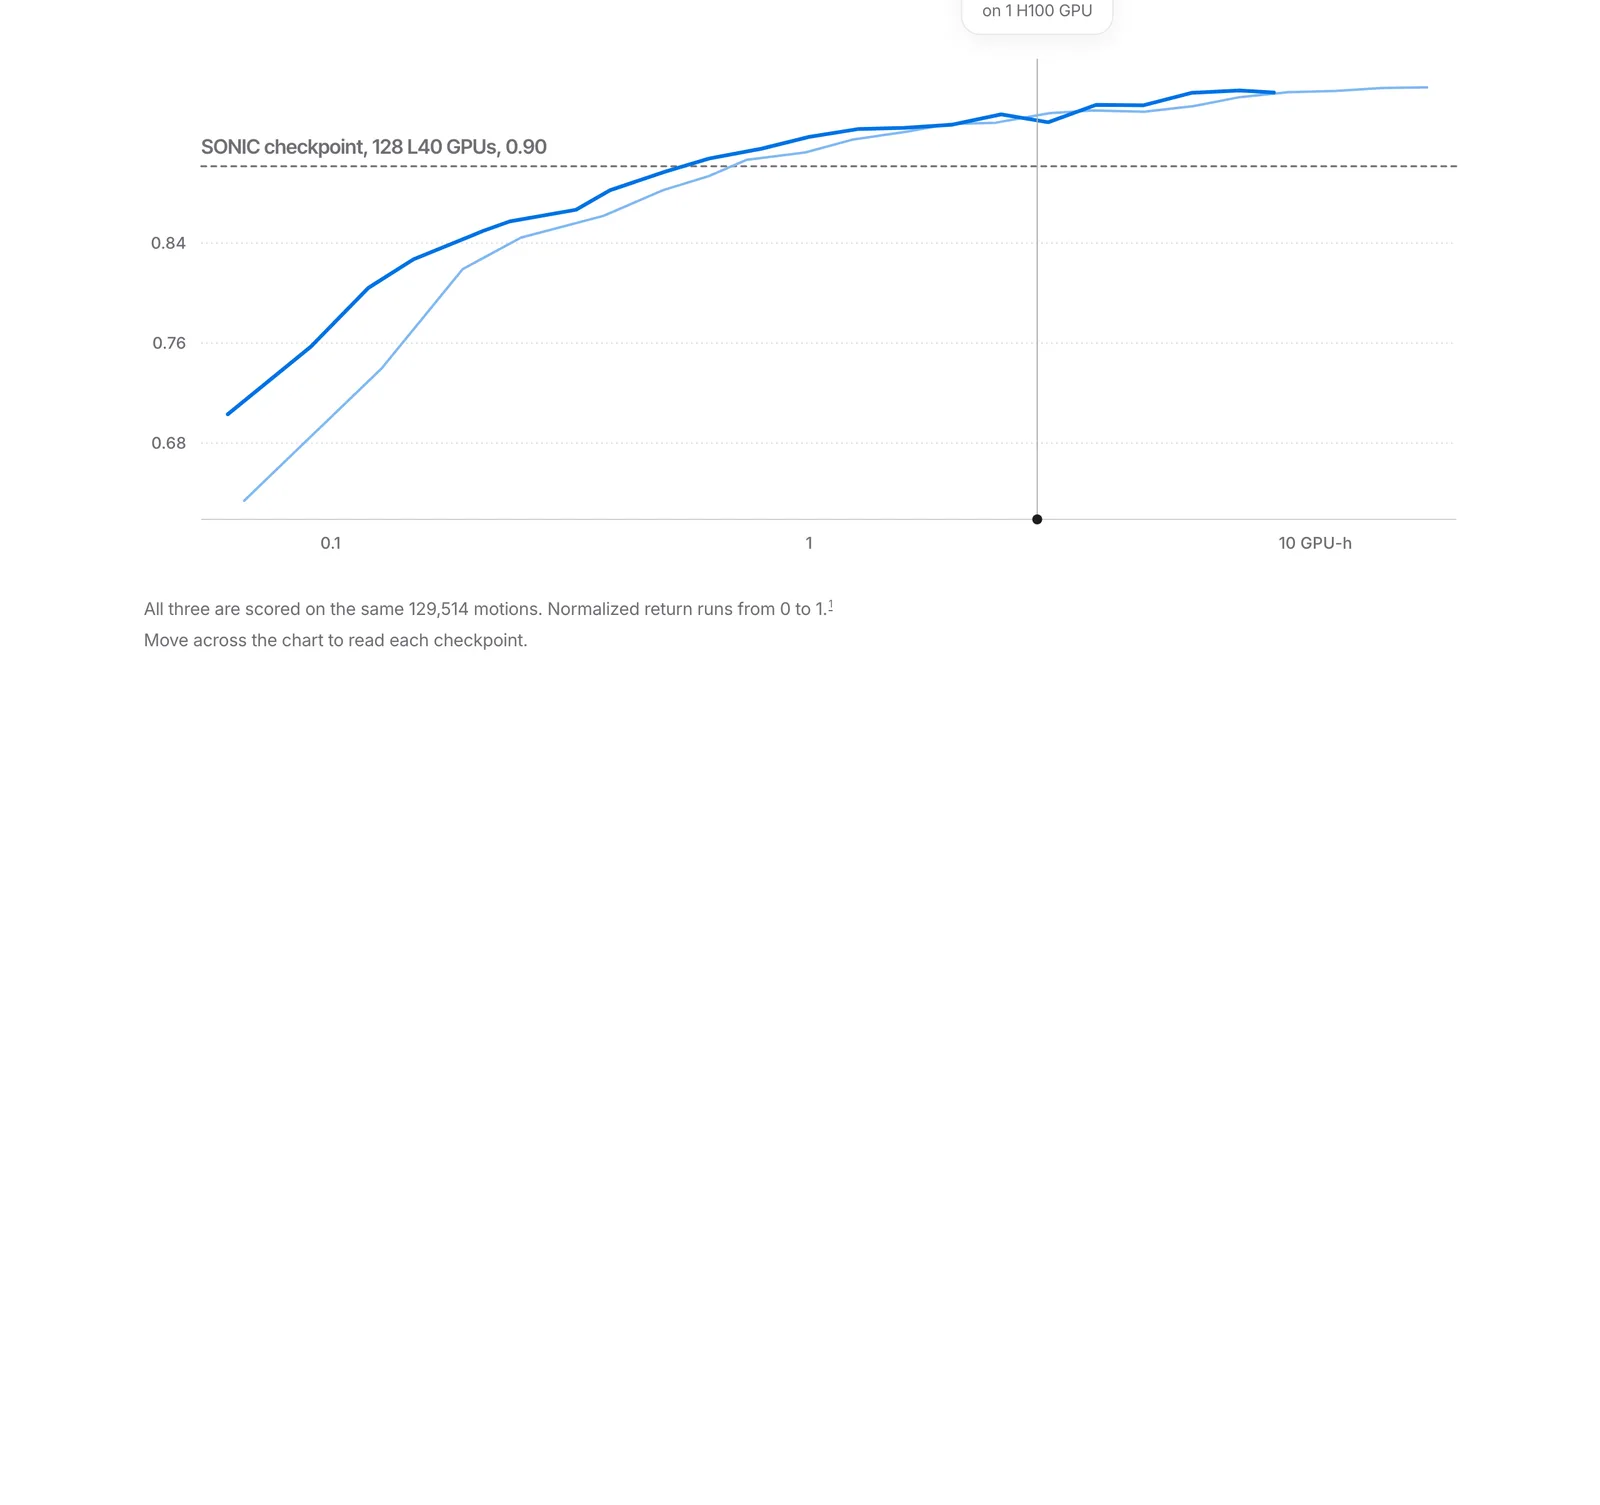
值得注意的是數字的寫法。研究網站的精算比值是 GPU 時數約 7,200 倍、實際等待時間約 56 倍,但官方宣稱保守寫成超過 1,000 倍與超過 50 倍。作者也主動交代了兩處對自己不利的差異:訓練資料用的是 SONIC 資料集的公開子集,只有 264.56 小時,約是對方 611 小時的百分之四十三;兩邊 GPU 型號不同,H100 的 fp32 峰值約為 L40 的 0.74 倍、tensor core 峰值約 5.5 倍,而兩邊各用了多少峰值效能都沒有量測。官網 FAQ 的結論是:資料量差 2.3 倍、峰值吞吐至多差 5.5 倍,解釋不了 GPU 時數上的一千倍差距。
這裡要留意換算的邊界。GPU 時數把卡數與時間一起計入,量的是訓練規模,也就是完成這次訓練動用的累積運算資源。它不等於相同硬體上的演算法加速倍數(兩邊卡不同、峰值使用率未知),也不能直接換成省電倍數或租用成本。三小時這個數字則涵蓋完整訓練循環:收集模擬經驗、更新世界模型、更新策略;訓練後另跑的檢查點評估不計入,官網還補了一句,三小時是保守講法,之後每個檢查點都領先 SONIC 至少一半的差距。
平均分數之外,論文把成敗攤在同一個基準上:129,514 個動作,每個都從第一格開始播放一次,所有策略面對相同的物理設定,包括地面摩擦固定、沒有環境隨機化、沒有觀察雜訊、物理是完全確定性的。一段動作只要觸發訓練時設定的終止條件,就記為失敗,不是看影片主觀打分。結果是 SONIC 公開版本失敗 179 個,SuperMimic 單卡 3 小時失敗 25 個,兩張卡 9.8 小時後全部通過。
分組數字比總數更有資訊量,因為 SONIC 的缺口集中在特定類別:
| 動作分組(數量) | SONIC | 單卡 3 小時 | 兩卡 9.8 小時 |
|---|---|---|---|
| 側滾(22) | 22 | 2 | 0 |
| 翻轉:360/180/90 度(44) | 44 | 1 | 0 |
| 翹腳(10) | 9 | 0 | 0 |
| 躺臥、休息與起身(99) | 28 | 8 | 0 |
| 跳遠類動作(24) | 15 | 0 | 0 |
| 舞蹈組合(8) | 8 | 0 | 0 |
| 其他動作(129,307) | 53 | 14 | 0 |
| 合計(129,514) | 179 | 25 | 0 |
SONIC 在翻轉、側滾與舞蹈組合上是整類全滅,SuperMimic 補上的正是這些劇烈變換身體姿態的動作。另一個細節是 SONIC 還有一個 v1.1 版本,論文附錄量到它在同一基準失敗 239 個,主要比較用的是發布版。
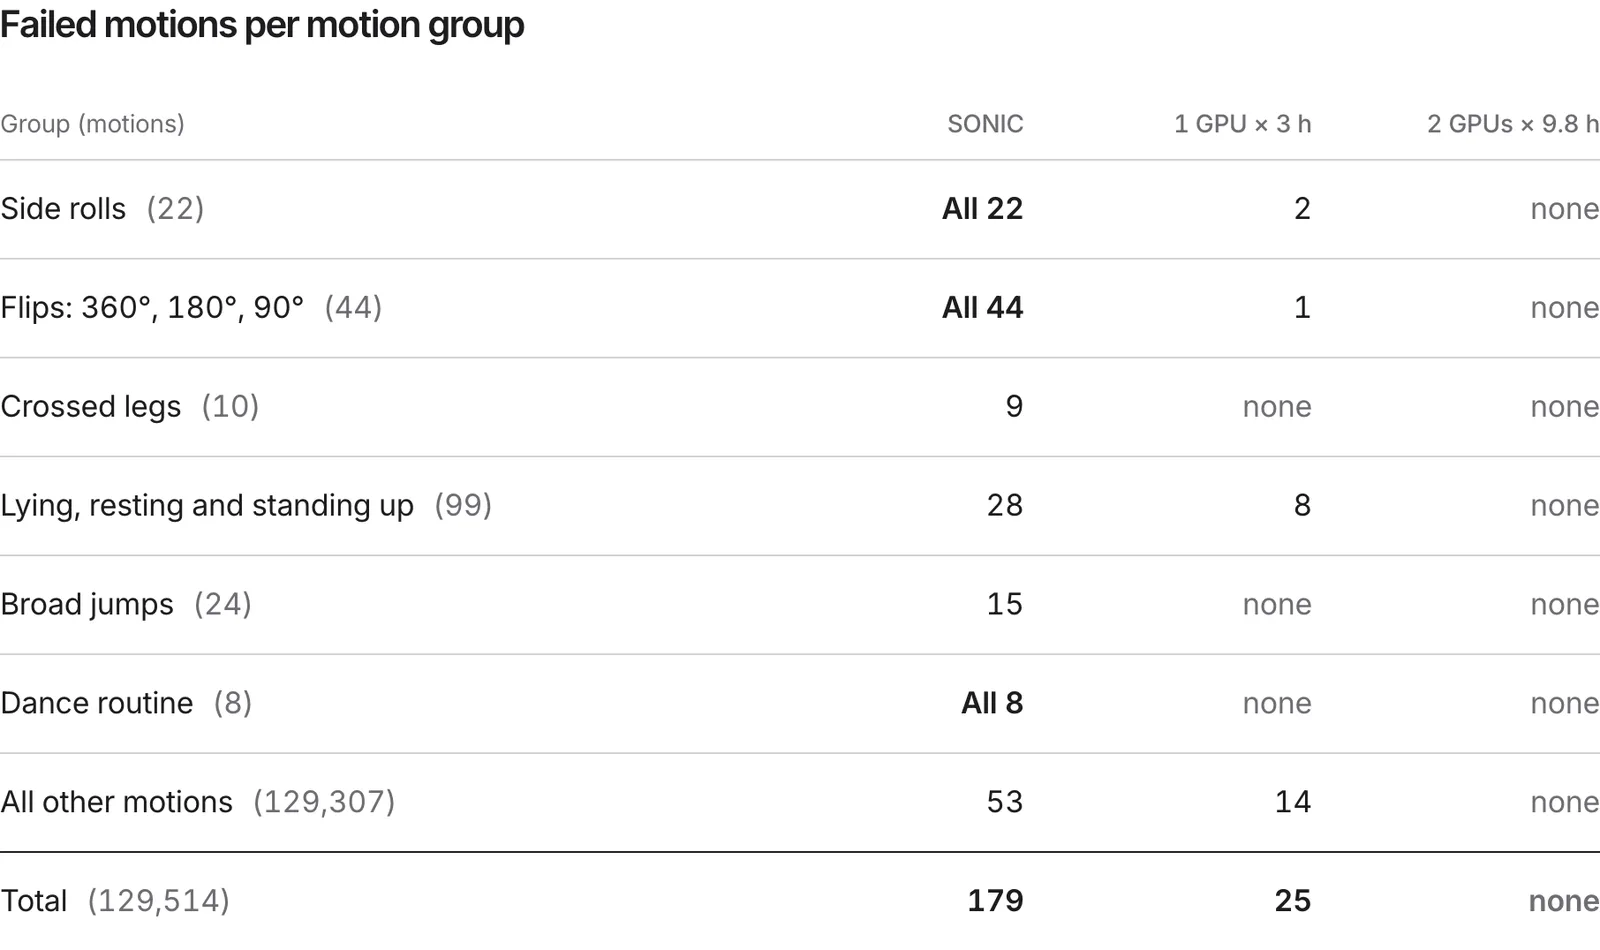
零失敗的解讀有明確邊界,而且作者是自己標出來的:基準動作同時是兩邊的訓練動作,這些數字量的是對既有動作庫的覆蓋範圍,不是機器人面對沒見過的新動作還能成功的能力。固定且無干擾的評測條件,也意味著濕滑地面、感測器失準或外力碰撞都不在這次成績單裡。
便宜的理由藏在訓練結構裡。SuperMimic 沒有丟掉物理模擬器,它用 MuJoCo Warp 記下某個狀態下做出某個動作之後會發生什麼,累積成經驗庫;世界模型再從這些紀錄學會預測動作後果;控制策略改在這個學出來的模型裡練習,沿著模型算出的調整方向更新,也就是解析梯度。關鍵在於梯度從頭到尾不穿過模擬器,所以模擬器本身可不可微分根本無關緊要,帶有碰撞與接觸的標準模擬器直接照用。
這個設計背後的直覺是:走路、蹲下、側滾看起來是不同動作,執行它們的都是同一個機器人身體,受同一組關節限制與接觸條件約束。與其每換一個動作就在模擬器裡從零試誤,不如把這些共用身體特性學進一個模型,讓整個動作庫分攤學習成本。世界模型也不是一次訓練好就凍結,它每一輪都跟著策略更新,只在單次策略更新內保持固定,好追上策略正在探索的新行為。
研究網站用三段動畫把這件事演給讀者看。把策略關掉,機器人倒下,世界模型照樣預測出機器人會倒下;把策略打開,模型預測的軌跡就貼著模擬器的實際結果走;再讓地板在剎車時變滑,只要把摩擦係數告訴模型,它也能預測腳會往哪裡滑。世界模型在這裡要做的事很單純:把身體如何運動算得夠準,準到策略可以直接拿它來練。
策略在模型裡的練習是往後想 32 個控制步,更遠的回報由一個價值估計器補上。官網的力學拆解顯示,有這個估計器時,16 步的想像長度就抵得上沒有它時的 32 步,拿掉它、想像長度壓到 16 步以下訓練就會失敗。論文把省算力歸納成三個性質:世界模型的預測誤差在資料量從 1 小時成長到 264 小時的過程中,穩定維持在 0.007 到 0.011;想像推演在實際訓練使用的批次範圍內,比 MuJoCo Warp 快 10 倍以上,最多到 62 倍;有了解析梯度,策略達到相同訓練回報所需的想像步數,約是在世界模型上跑 PPO 的 64 分之 1。
不依賴跨論文硬體數字的驗證也做了。團隊另外在 LAFAN1 的 40 段動作(合計 2.45 小時)上,固定動作、觀察與獎勵條件做對照:SuperMimic 單卡約 1.2 小時在評估達到 0.82 回報;直接在模擬器裡訓練的 PPO 對照組,18 小時預算內始終沒有達到,最終回報在 1、4、8 張卡上分別是 0.60、0.70、0.72。這組數字量級雖小,條件卻是固定的,可以單獨引用。想看世界模型路線的其他進展,可以參考先前介紹過的 Odyssey-3 用同一個世界模型驅動汽車與人形機器人。
模擬裡的成績要連到實體機器人,需要另一種證據。研究團隊讓同一個通用動作追蹤策略,直接在實體 Unitree G1 上完成四種動作:跳步、側滾、90 度翻轉與原地 360 度翻轉,每支影片都用同一個策略,沒有為個別動作另外調參。官網給這一步的說法是在想像裡訓練、上機零調校(zero-shot),也就是策略從模擬側的練習直接搬到真機,中間沒有為實體另外加一輪適應。這四種動作涵蓋移動、身體貼地與劇烈翻轉,說明策略確實離得開模擬器,而且通用性沒有只在單一動作上兌現。
但示範影片與前述評測是兩回事。129,514 個動作沒有在實體機器人上重跑,真機證據是四個選定動作。論文第 6 節自己列出邊界:訓練只在平地進行,地形與物件互動是進行中的工作;世界模型只從模擬器紀錄學習,加入真機資料是後續方向;下游控制介面的訓練方式也還在初步階段。換句話說,側滾能做起來,與伸手拿起易碎物品、在斜坡上行走是不同的控制問題,後兩者這篇論文沒有處理。想讓機器人進工廠搬料箱的進度,可以對照 AGCO 把人形機器人請進牧草設備廠的案例,那是另一條應用線。
受影響最直接的是做全身動作控制研究的團隊。作者在論文裡的宣稱是:運算資源不再是規模化人形全身控制的瓶頸,量測動作追蹤的 scaling law(資料量與效能的關係曲線)變成一張 GPU 跑一次實驗就做得起的事。這是作者觀點,但對照前面的帳本,至少在動作追蹤這個題目上,單卡做規模化實驗的門檻確實降下來了,資源有限的小實驗室不再需要先排到多卡叢集,才有資格問規模化的問題。同一條路線的成本故事,可以和 Maxinsights 把真實工作影片煉成機器人訓練資料對照著看:一邊壓訓練的算力帳單,一邊壓資料的品質帳單。
開發者與一般讀者現在手上有研究網站的瀏覽器示範,可以挑動作、看策略即時跑起來;訓練用的 BONES-SEED 動作子集也放在 Hugging Face 上公開取用。要留意的是,研究網站目前提供論文、影片與瀏覽器示範,沒有看到公開的訓練程式碼或模型權重下載連結,想完整重現訓練還要等官方釋出。需要機器人做地形穿越、搬運或家事的應用團隊,這次沒有拿到新能力,先放著追蹤即可。
三件事還沒有答案。訓練程式碼與權重的釋出時程未公布;論文獲 CoRL 2026 口頭報告,會議版與 camera-ready 的數字仍有微調空間;SONIC 端也可能推出新的版本,讓 179 對 25 的對照翻頁。這些數字對應的是 10 月 20 日送上 arXiv 的論文版本與目前的研究網站,值得回頭再查的時點是 CoRL 2026 會期前後,或官方釋出程式碼那天。在那之前,把千倍理解成訓練規模的改變,而不是機器人能力的跳升,就不會讀錯這篇論文。