TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

dmis-lab 團隊 10 月 10 日同步公開 UltraBERT 論文與三個 Apache-2.0 模型,150M 與 380M 兩種尺寸宣稱在 GLUE 分類與 BEIR 檢索同時拿下同級第一,並原生支援 32K 上下文。榜單數字全部來自逐任務微調,模型卡明言釋出的是預訓練權重,現成可用的只有另發的 Embed-150M,而且僅支援英文。
用 AI 摘要這篇文章:
2026 年 10 月 10 日是 UltraBERT 的公開日。HuggingFace 上的 dmis-lab 帳號在當天上午(UTC)先後建立了 UltraBERT-150M、UltraBERT-380M 與 UltraBERT-Embed-150M 三個模型倉庫;五個多小時後,同名論文《UltraBERT: Beyond the Limit of BERT Pre-Training》以預印本掛上 arXiv,編號 2610.15028,提交時間 UTC 10 月 10 日 16:11,換算台北時間是 10 月 11 日凌晨 0 點 11 分。三個 checkpoint 全部以 Apache-2.0 授權釋出,模型卡的語言欄位只標了英文。
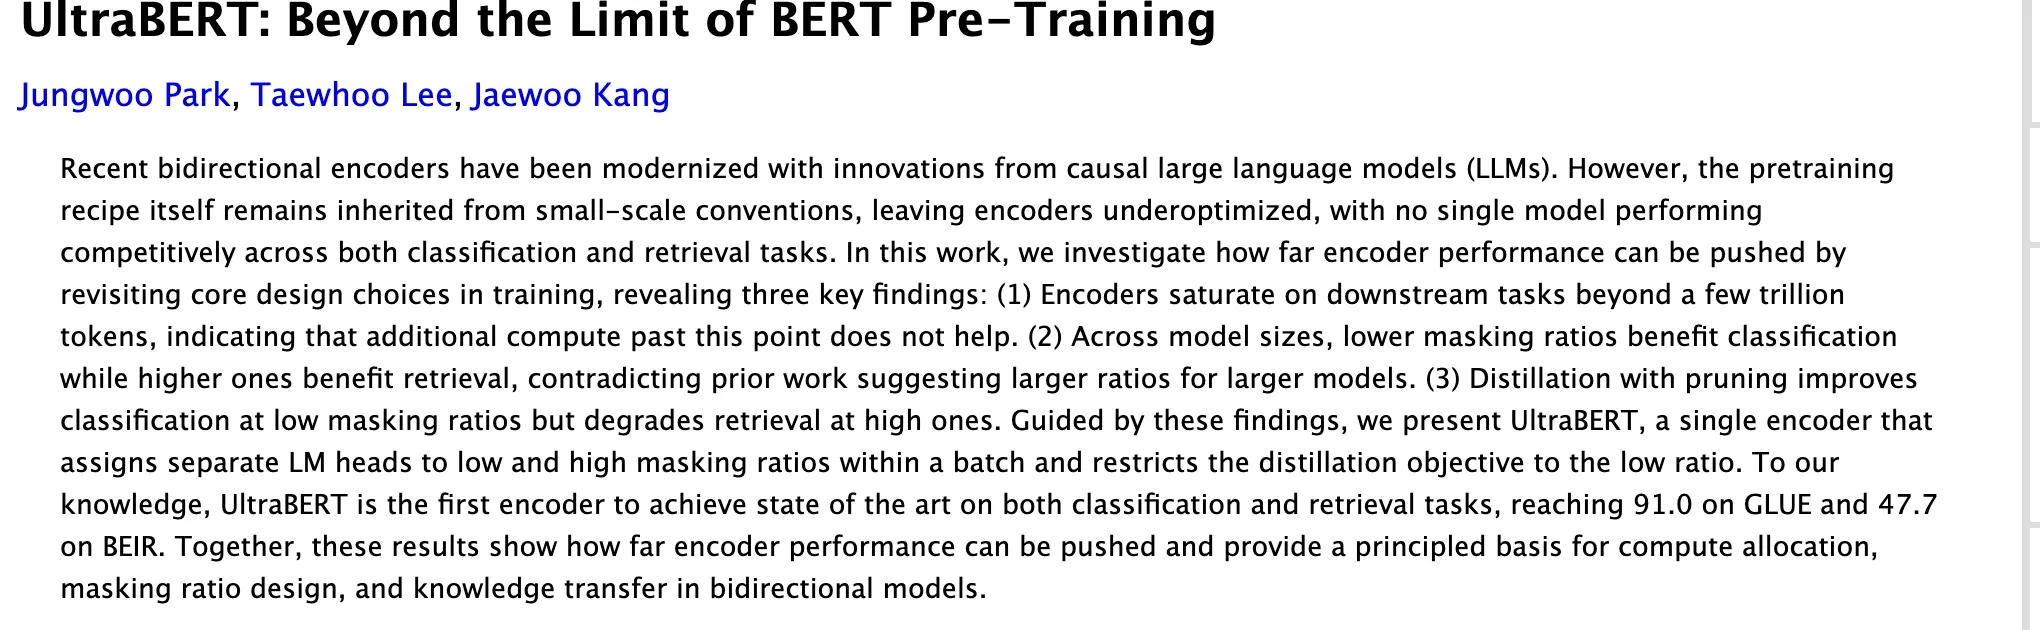
論文給出的頭條數字有兩個:380M 版在 GLUE 拿 91.0、在 BEIR 拿 47.7,作者並在摘要寫下「據我們所知,這是第一個在分類與檢索任務上同時達到頂尖水準的 encoder」。三位作者署名 Jungwoo Park、Taewhoo Lee 與 Jaewoo Kang;dmis-lab 隸屬 Data Mining and Information Systems Lab,這個帳號在 HuggingFace 上同時維護生醫領域知名的 BioBERT,並非第一次發布模型。
判斷可以先講:在兩億參數級挑基礎模型的開發者,值得把它加進候選清單,與 Ettin、ModernBERT、LFM2.5-Encoder 放在一起比;但模型卡把界線寫得很清楚,這是預訓練權重,榜單上的每個數字都來自逐任務微調加上同一組參數搜尋,下載之後直接丟進專案,那些分數不會自己出現。
encoder 與聊天模型做的是兩種工作。聊天模型負責生成一段一段的文字,encoder 把輸入文字壓成一組向量,下游的分類器、搜尋引擎與 RAG 系統靠這組向量運作。具體的任務長相很日常:來信是帳務問題還是技術問題、這則留言要不要標成垃圾訊息,屬於分類;丟一個問題進去,從幾萬份文件裡挑出最相關的幾段,屬於檢索。兩種任務都不需要模型把答案「講」出來,要的是判斷與比對。
這次發布影響的,是在 200M 到 500M 這個區間挑英文基礎模型的開發者。一條檢索工作流會用到好幾種角色:前端把網頁整理成機器可讀資料有 專門的爬蟲工具 處理,末端檢索品質的評估也 自成一套方法,而中間把文字變成向量的那一層,正是這類 encoder 的戰場。換掉一層底座,整條工作流的分數都要重測,這也是它值得先當候選、再談替換的原因。
以下情況可以先略過:需要中文或多語能力的人,訓練資料與模型卡都標明只有英文;需要生成能力的人,encoder 不產出文字;以及只想呼叫現成 API、不打算碰微調的人,這次釋出的是權重檔案,並非服務。三個倉庫剛好對應三種身分:兩個預訓練底座留給要微調的人,一個嵌入成品留給要直接用的人,入門時先認清自己要哪一種。
先交代兩個榜的名字。GLUE 是一組英文理解任務的綜合測試,分數代表分類與推論類工作的水準;BEIR 則量跨領域的檢索能力。一個 encoder 通常只在其中一邊突出,這正是這篇論文想解的問題。
模型卡的評測表把「之前」攤得很明白。基礎尺寸(200M 參數以下)裡,GLUE 分類榜由 Ettin Encoder 的 88.9 領先,BEIR 檢索榜由 ModernBERT 的 42.6 領先,沒有一個模型兩邊同時是第一。中型尺寸(500M 以下)同樣如此:Ettin 395M 的 GLUE 90.8 是分類標竿,LFM2.5-Encoder 355M 的 BEIR 47.3 是檢索標竿,想兼顧兩種任務就得養兩套底座。
| 尺寸 | 模型 | 參數 | GLUE | BEIR |
|---|---|---|---|---|
| 基礎 | Ettin Encoder | 149M | 88.9 | 42.4 |
| 基礎 | ModernBERT | 149M | 88.4 | 42.6 |
| 基礎 | UltraBERT | 152M | 89.5 | 45.2 |
| 中型 | Ettin Encoder | 395M | 90.8 | 45.9 |
| 中型 | LFM2.5-Encoder | 355M | 89.2 | 47.3 |
| 中型 | UltraBERT | 380M | 91.0 | 47.7 |
表內數字取自 dmis-lab 模型卡的評測表(HuggingFace,2026 年 10 月的模型卡),所有模型都以逐任務微調加同一組參數搜尋評分。
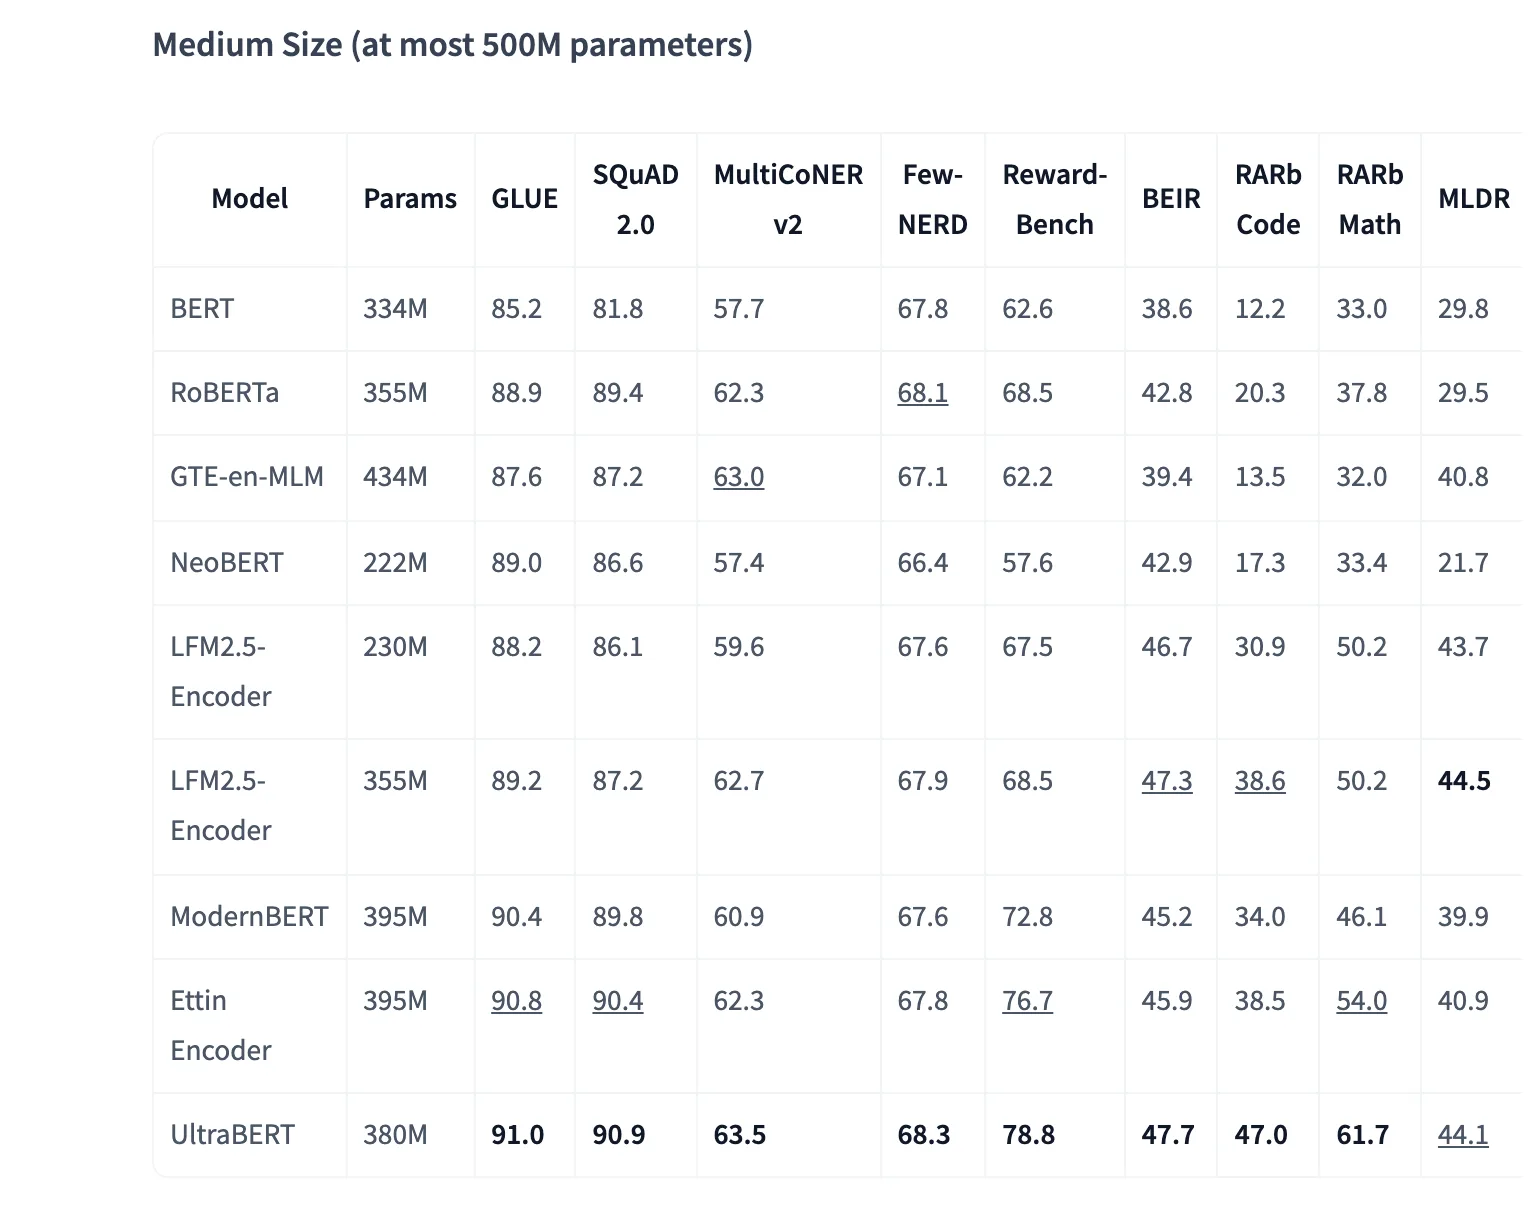
UltraBERT 的兩個尺寸在這張表上同時越過兩條線:基礎版拿 89.5 與 45.2,中型版拿 91.0 與 47.7,檢索端的差距尤其明顯,基礎版 BEIR 領先前一名 2.6 分。「第一個兩邊同時第一」的宣稱,具體內容就是這幾個數字。
有兩個但書要跟著讀。其一,成績出自作者自己的評測:每個模型逐任務微調、共用同一組學習率網格,檢索類是在 MS MARCO 或 MLDR 的子集上微調後量得的,模型卡原文說這反映的是檢索潛力,專職嵌入模型通常還要在數億配對上繼續訓練。其二,它沒有每項全贏:中型 MLDR(長文件檢索)一欄,UltraBERT 的 44.1 落給 LFM2.5-Encoder 355M 的 44.5,長文件檢索這一格還在別人手裡。
BERT 這類模型的預訓練叫遮罩學習:把句子裡的部分文字蓋住,讓模型猜被蓋住的是什麼。過去的共識偏向「模型越大、遮罩比例該越高」,這篇論文量出的方向卻是左右開弓:低遮罩(5%)有利分類,高遮罩(50%)有利檢索,兩種好處不會只靠單一設定自動齊全。論文同時量出一個上限訊號:encoder 在數兆 token 之後趨於飽和,再倒算力進去幫助有限。對資源規劃的意義是,與其把預算堆在更多 token 上,不如花在遮罩比例與知識轉移的設計;作者的摘要也把算力分配、遮罩設計、知識轉移列為這份研究實際回報的三件事。
UltraBERT 的做法是在同一批訓練資料裡混兩種遮罩比例,序列數 4:1,並各配一個輸出頭(LM head),讓兩種學習訊號不必擠在同一個出口互相干擾。蒸餾也是不對稱的:作者發現剪枝後再蒸餾在低遮罩時對分類有幫助,在高遮罩時反而傷檢索,於是把 KL 蒸餾損失限制在 5% 那個頭,50% 的頭用標準遮罩損失。
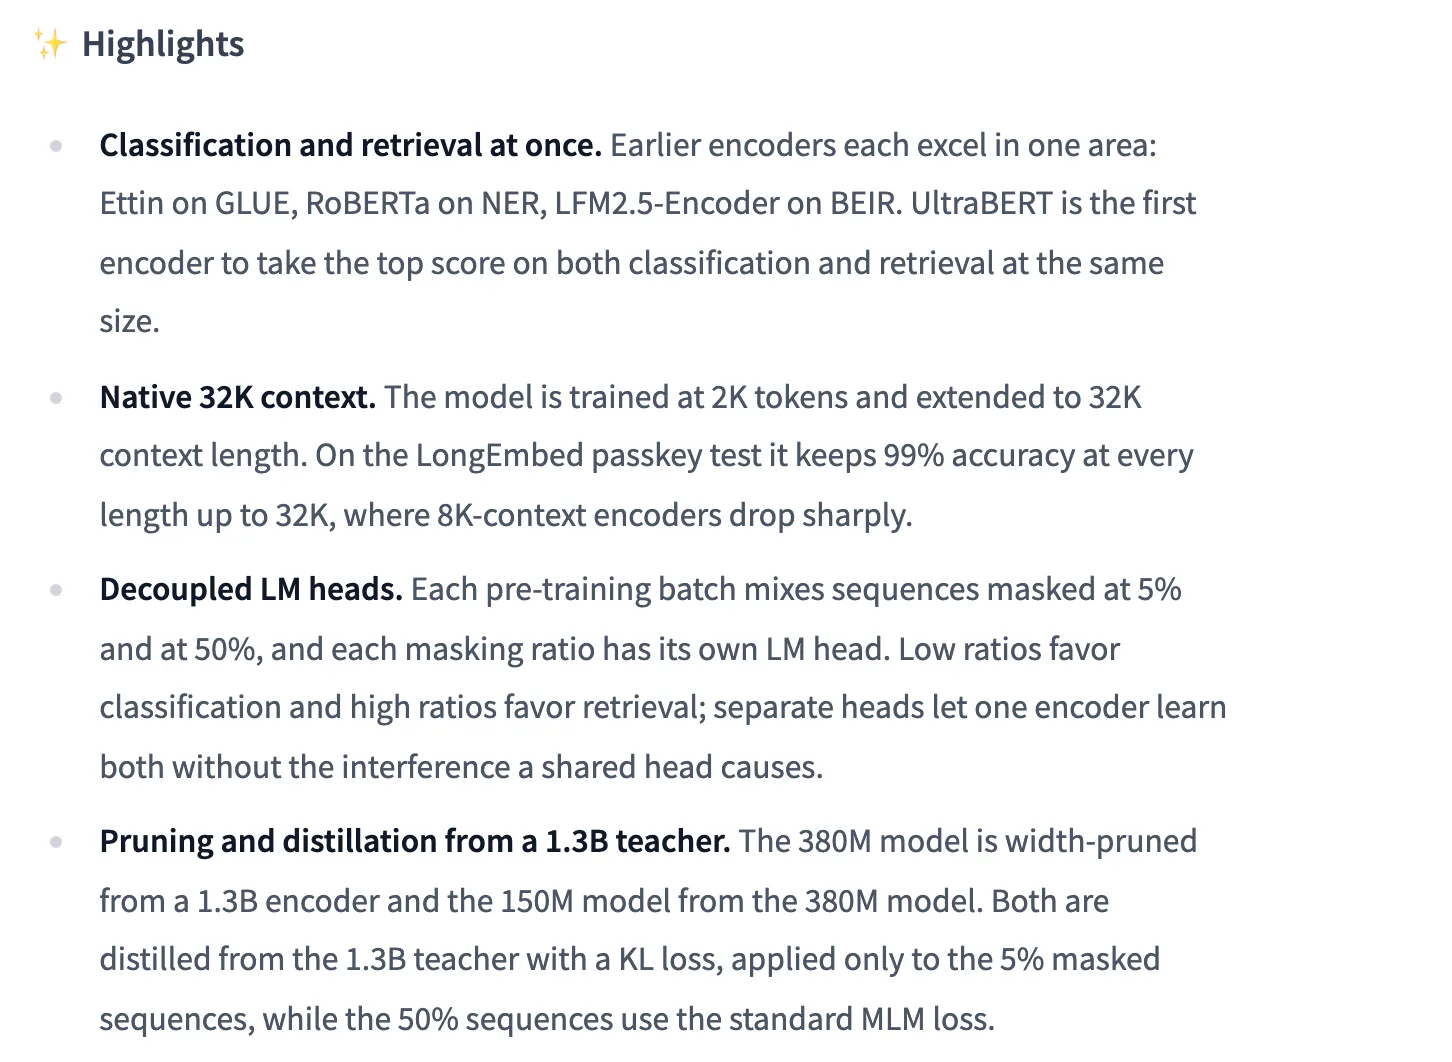
模型是從一個 1.3B 的教師模型層層剪出來的:先寬度剪枝到 380M,再剪到 150M,剪哪些單位由 2,000 份校準文件上的活化值決定,兩個尺寸都直接向 1.3B 教師蒸餾。訓練總量 2T tokens,資料以網頁為主(DCLM 佔 44.1%),加上程式碼、學術、數學與指令類語料,算力由 Google 的 TPU Research Cloud 計畫支援。
架構本身是把這兩年大型語言模型的零件搬進 encoder:前置正規化、RoPE 位置編碼、SwiGLU 前饋層、RMSNorm,而且全部不留偏置項。注意力做了分層安排,每三層裡有兩層只看左右各 128 個 token 的局部視窗,第三層才做全域注意力;兩個尺寸都固定 24 層,只把寬度從 768 拉到 1,024,詞表 49,152,輸出頭與輸入嵌入也不共用權重。對部署的人來說,這套設計換來的是長輸入下比較省的注意力成本;模型倉庫附了給 transformers 5.x 用的遠端程式碼(UltrabertModel 等類別),因此載入時要開 trust_remote_code。
下載檔案裡有個容易錯過的細節:checkpoint 內建的遮罩頭是 5%(蒸餾)那一個,50% 的頭另存成 head_50%.pth,要用得手動載入。對分類或檢索的微調場景來說這個頭多半派不上用場,但要做遮罩率相關實驗的人,得知道兩個頭是分家的。
UltraBERT 的上下文長度給到 32,768。作法是先在 2K 長度訓練,再延伸到 32K,全域注意力的 RoPE 基底跟著從 64 萬調到 256 萬。
模型卡引用的 passkey 測試(在長文裡找特定記號)中,UltraBERT 在 32K 以內的每個長度都維持 99% 準確率;對照組裡,512 上下文的舊模型超過 1K 就失效,8K 上下文的模型在 16K 與 32K 明顯掉落。不過 passkey 屬於針對性的長度測試,加上前面 MLDR 那一格沒有贏,長文件的實際檢索表現仍要放在自己的資料上驗證。
對檢索系統的意義比較直接:32K 大約是一份長報告或一個章節的量,整篇送進去編索引,就不用為了遷就模型而先把文件切碎。Embed 版的模型卡也明講,文件以 32K 全長編入,不截斷。切段策略一直是 RAG 工程裡的取捨點,上下文拉長之後,「整篇直接送」多了一個成立的選項,至於整篇編索引與切段編索引哪種召回更好,仍要實測。
模型卡的反覆提醒值得抄下來:這是預訓練 encoder,需要針對任務微調。倉庫裡放的是 float32 的預訓練主權重,搭配遠端程式碼,使用條件是 transformers 5 以上(作者以 5.16.1 測試)並開啟 trust_remote_code,長輸入建議 FlashAttention 2。遠端程式碼附的類別涵蓋序列分類、問答與 token 分類,常見的微調接法都有現成入口,從 AutoModelForSequenceClassification 載入即可開始。
微調有一個會踩坑的地方:最佳學習率比其他 encoder 低到約十分之一。模型卡給的數字是 150M 用 5e-5、380M 用 3e-5,而同尺寸模型常見的設定落在 3e-4 到 5e-4 之間,照舊習慣設學習率,結果可能不如預期。作者附上的掃描範圍可以直接照抄:分類從 5e-6 一路掃到 8e-5,檢索掃到 1e-3,最佳化器用 AdamW 搭線性衰減與 5% 暖機,檢索微調搭配平均池化與對比損失。模型卡另有提醒:這個模型會重現網路訓練資料裡的偏見,要用在敏感場景,先自己做一輪評估。
不想自己微調、只想要現成嵌入模型的人,入口是同日發布的 UltraBERT-Embed-150M。它輸出 768 維向量、同樣吃 32K 輸入,模型卡標示在 MTEB(eng, v2) 拿 67.24,是 200M 以下密集模型的最高分(2026 年 10 月 11 日的快照),查詢端照 E5-mistral 的風格帶任務指令,使用需要 sentence-transformers 6 以上。換句話說,基礎模型與成品模型在這次發布裡是分開的兩個倉庫,選錯入口會以為模型不能直接用。
多數團隊不需要立刻動。合理的下一步是把 UltraBERT 放進候選清單,在自家任務上微調一輪,與目前使用的 Ettin、ModernBERT 或 LFM2.5-Encoder 對比,比較時固定同一份驗證集,比追逐榜單排名可靠;特別是同一個專案同時需要分類與檢索的場景,單一底座省掉的是維護兩套模型的人力。
資源有限時,152M 與 380M 的取捨可以對照上面的評測表再決定;對部署體積敏感的專案, 模型壓縮工具 是另一條路,而需要直接跑在手機上的場景,那又是另一個量級的賽局,例如 Google 才把 Gemma 防詐模型 搬進裝置端。供應鏈角度還有一點值得留意:trust_remote_code 表示模型倉庫裡的程式碼會進入你的執行環境,正式採用前把它當成依賴審一遍,是使用開源模型的基本動作。
中文場景這次明確不在範圍內。模型卡把「僅英文」列在限制的第一位,訓練語料裡沒有中文,要做中文檢索或分類,等社群的微調版本或另尋多語模型比較實際。
這篇論文是未經同儕審查的預印本,所有榜單數字出自作者自己的評測條件。發布後六天,兩個基礎模型在 HuggingFace 的下載量分別是 1,032 與 982 次(10 月 16 日的數字),Embed 版 376 次,有初步關注,還談不上社群重現。
值得回查的有三件事:論文是否通過同儕審查或被會議接受;第三方團隊能否在相同條件下重現 91.0 與 47.7;MTEB 與各榜單的排位變化。與其記住 91.0 這個數字,不如記住它的量測條件:逐任務微調、同一組參數搜尋、檢索類先在 MS MARCO 或 MLDR 子集上練過。同樣的條件換到自己的資料上,數字一定不同,差多少才是候選清單真正要回答的問題。在重現結果出現之前,把「兩邊同時第一」當成作者的宣稱來引用,是比較穩的讀法,也是這則新聞目前的保存期限。