TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA 在技術部落格正式發表 CUDA Rust,一次推出兩條用 Rust 原生編寫 GPU 核心的路線:SIMT 編譯器專案 cuda-oxide 與 Tile 程式庫 cutile-rs。兩者把記憶體安全檢查從執行期搬進編譯期,同一個別名錯誤分別以 E0502 與 E0382 在編譯期被擋下。官方同時明說兩個專案都還不是 production-ready,而 mistral.rs 與 Hugging Face Grout 已把 cutile 釘進依賴清單。
用 AI 摘要這篇文章:
NVIDIA 在 9 月 8 日晚間 8 點(台北時間)於官方技術部落格發表 CUDA Rust,一次端出兩條用 Rust 原生編寫 GPU 核心的路線:走 SIMT 模型的編譯器專案 cuda-oxide,以及走 Tile 模型的程式庫 cutile-rs。兩者的共通點,是把 GPU 核心的記憶體安全檢查從執行期搬進編譯期,讓「輸入大家共享、輸出只有一個寫入者」這件事變成型別系統能驗證的主張。同一週,共同作者 Melih Elibol 也在蒙特婁舉行的 RustConf 2026 上發表同名演講。
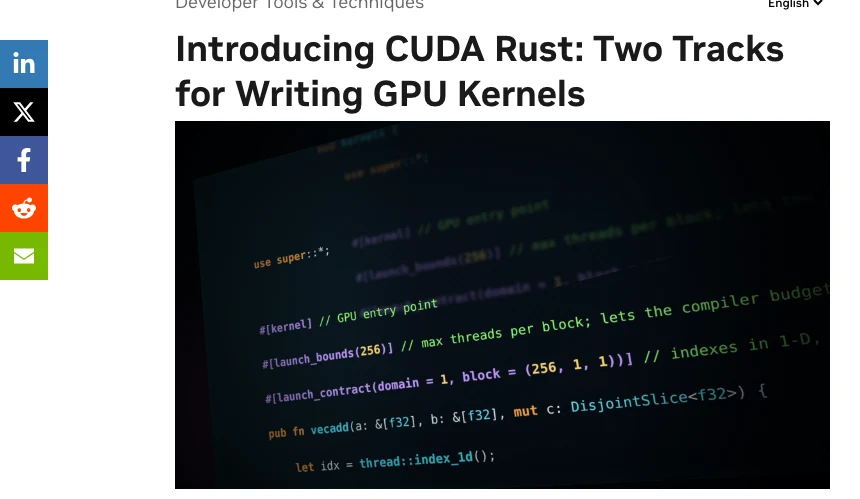
先講最需要知道的結論:NVIDIA 在公告裡自己寫得明白,兩個專案都處於早期階段,都不是 production-ready,cuda-oxide 還掛著 early alpha 的標籤,覆蓋不完整、API 會變動。這篇公告的意義不在「CUDA Rust 已經可以上生產線」,而在 NVIDIA 官方資源正式進場,把 GPU 核心這塊 Rust 一直搆不到的最後一塊拼圖,納入了自己承諾會持續投入的範圍。
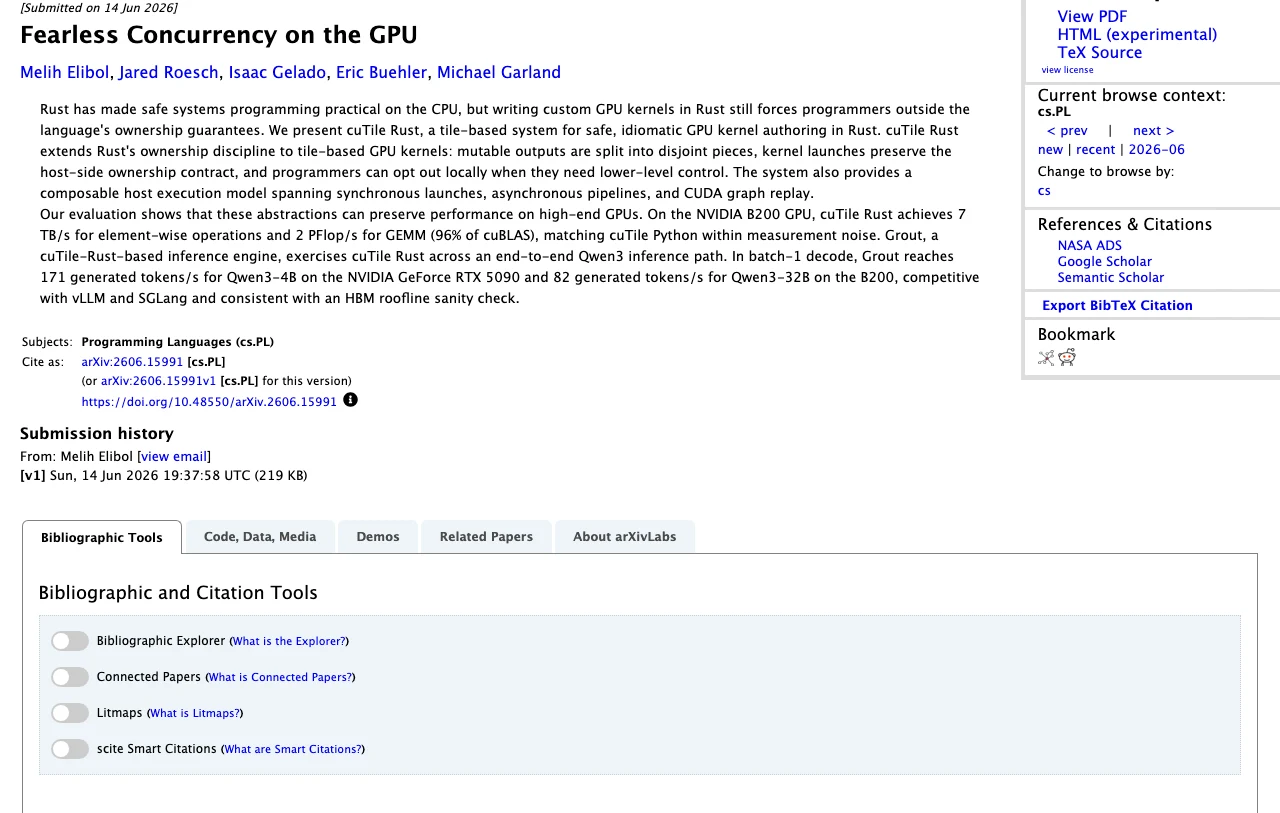
GitHub 的建立時間戳顯示,這不是兩個剛出生的專案。cutile-rs 的儲存庫建於 2026 年 3 月 12 日,對應的 cutile crate 隔天就上了 crates.io 的 alpha 版本;cuda-oxide 的儲存庫建於 4 月 22 日。5 月上旬 cuda-oxide 已經在技術社群引起第一波關注,Hacker News 上 5 月 7 日起出現多則討論,Phoronix 也在 5 月 8 日報導過它的 0.1 版本。6 月 14 日,團隊把學術論文 Fearless Concurrency on the GPU 送上 arXiv(編號 2606.15991,作者為 Melih Elibol、Jared Roesch、Isaac Gelado、Eric Buehler 與 Michael Garland)。9 月 4 日 cutile 更新到 0.3.1,四天後公告刊出。
所以 9 月 8 日這份公告的實質內容,是把既有的兩個開源專案正式掛進 CUDA 的正門,並給出一個明確的訊號:NVIDIA 打算把 CUDA Rust「一路養到 2027 年以後」。公告開頭的原文是 leaning into native GPU programming in Rust,並說 CUDA C++ 與 CUDA Python 是成熟的企業級工具鏈,而 Rust 是第三條會被官方持續投入的路。對照官方自述的脈絡,這個決定有跡可循:NVIDIA 說自家的 Nova Linux GPU 驅動用 Rust 寫、Dynamo 分散式推論架構建於 Rust 核心、NVTX 也有官方 Rust 綁定,系統層一路 Rust 化之後,GPU 核心成了僅存的缺口(OpenAI 也為了類似的工程理由,把自家儲存平臺從 Python 重寫成 Rust,那份拆解可以對照著看)。
值得放在背景裡的一點是,公告也向既有社群致意:rust-cuda、rust-gpu、cudarc 這些先驅專案被點名,NVIDIA 說自己與 rust-cuda 的維護者持續合作中,cuda-oxide 的官方手冊還附了一篇生態對照附錄,把自家位置和這些專案並排。那張表值得看一眼:rust-gpu 走 rustc 編到 SPIR-V、面向 Vulkan/Metal/DX 的圖形與通用運算;rust-cuda 同樣是 rustc 後端但目標放在把 Rust 語言模型帶上 NVIDIA GPU;CubeCL 是內嵌 DSL 加 JIT、跨 NVIDIA/ROCm/WGPU 三家;cudarc 則是宿主端的驅動綁定。手冊特別挑出 rust-cuda 當「最近鄰」,說兩者遠看像可互換,近看設計重心指向不同方向。換句話說,官方資源進場的同時,至少在文字上沒有擺出取代社群的姿態。
這次公告最值得細讀的部分,是 NVIDIA 怎麼把記憶體安全寫進型別系統。官方用了同一個例子貫穿兩條軌:對 1,024 個 float 做逐元素加法。兩份程式都是完整可執行的程式,都會印出同一行 PASSED 訊息,差別全在簽名的形狀。
cuda-oxide 這邊的核心是三個設計。輸入切片 a 與 b 維持普通的共用切片,每個執行緒都能讀;輸出 c 則包成 DisjointSlice 型別,這是一個「已保證互斥切分」的連續記憶體,每個執行緒經由 get_mut 拿到自己那一份,拿不到就是 None,邊界檢查變成必須處理的分支而不是事後才發現的記憶體錯誤。公告對這件事有個直白的說法:&mut [f32] 的形狀本來就不對,每個執行緒都需要同一個可變借用,而 Rust 正確地拒絕了這件事,DisjointSlice 做的就是把那一條可變借用切給每個執行緒各自一份。索引不是裸的整數,而是 thread::index_1d() 回傳的專屬索引型別,c.get_mut 只收這種型別。最後是啟動契約:#[launch_contract] 在核心上宣告維度與區塊大小,宿主端啟動前必須先過 prepare 階段的校驗,拿到證明權杖才能呼叫安全版本的啟動方法,維度或共享記憶體量與宣告不符時,錯誤在指令送進驅動前就會以 Result::Err 回來;反過來說,沒掛契約的核心只會露出原始的 unsafe 啟動方法,因為一個光禿禿的啟動設定對核心的真實需求什麼也沒說。
cutile-rs 拉高一個層級,整個核心函數在邏輯上只有一個執行緒,操作的基本單位從純量變成 Tile(子張量)。#[cutile::module] 巨集把核心的語法樹嵌進宿主二進位檔,第一次啟動時才經 CUDA Tile IR 即時編譯,編譯器自己決定背後要用多少真實執行緒。安全論證改走所有權:宿主端要變更一個張量,必須先呼叫 partition 把它切成互斥的子張量,這一步同時固定了啟動幾何、推導出編譯期常數 B,每個 tile 拿到別人碰不到的寫入範圍。核心呼叫會取走三個張量的所有權,GPU 做完再還回來,同步完成前宿主端程式碼碰不到那塊記憶體。官方範例裡整支程式是惰性的:ones、zeros、核心呼叫、拷回主機,全都只是先記錄下來,直到最後一個 sync_on 才真正送進 GPU,全程只有一個同步點。對應的論文摘要也把這套宿主端執行模型列為重點,宣稱涵蓋同步啟動、非同步管線與 CUDA graph 回放三種模式。
官方特別示範了同一個經典錯誤在兩條軌上怎麼死。把輸出緩衝區同時當成輸入傳進去,在 cuda-oxide 會被編譯器以 E0502 拒絕(cannot borrow c_dev as mutable because it is also borrowed as immutable),在 cutile-rs 則是 E0382(use of moved value: z)。兩個都是 Rust 使用者熟悉的標準借用檢查錯誤,差別在檢查發生的位置:cuda-oxide 逐次檢查啟動呼叫,cutile-rs 的所有權跟著張量跨過啟動邊界走。公告原文直接說,後者是兩者中較強的主張。
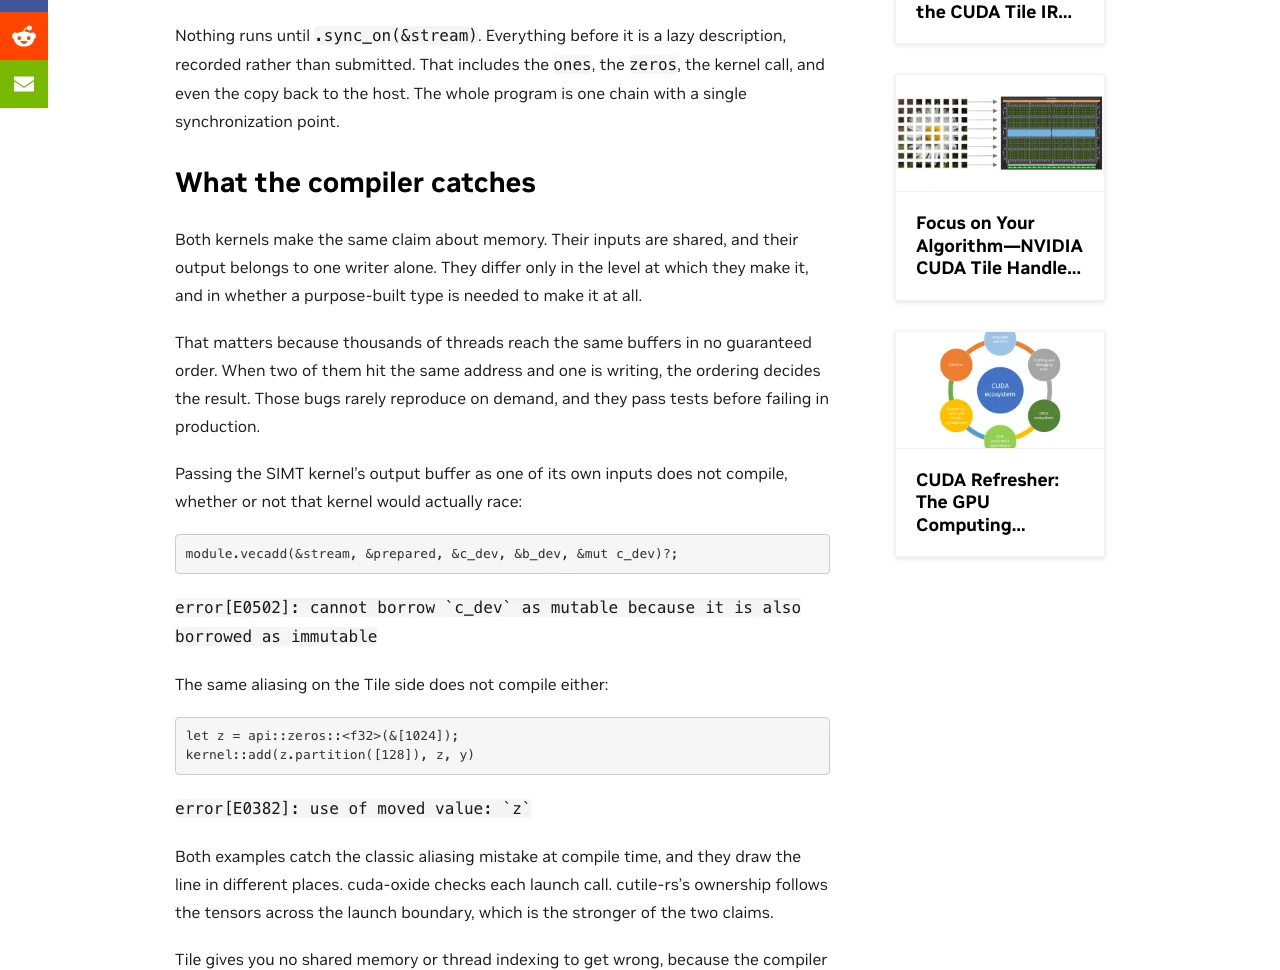
這個設計對映的痛點也很具體:數千個執行緒以不保證的順序碰同一批緩衝區,當兩個執行緒打中同一個位址而且其中一個在寫,結果由誰先誰後決定。這類錯誤的麻煩之處是幾乎無法按需重現,測試的時候通過、上了生產才爆開。把別名檢查搬進編譯期,等於是把這整類問題從「祈禱它不要發生」變成「編譯不過就修」。
兩條軌的系統需求落差,直接決定大多數人該從哪裡入門。cuda-oxide 的需求清單相當重:Linux、Compute Capability 8.0 以上的 GPU、CUDA Toolkit 12.x 以上、clang 與 libclang 標頭檔,外加一個釘死日期的 nightly 工具鏈(nightly-2026-04-03)。原因是它本身是 rustc 的客製化程式碼產生後端,#[kernel] 函數經 Rust MIR、Pliron IR、LLVM IR 一路編到 PTX,其餘程式碼走標準後端,這種介入深度目前離不開 nightly。官方也老實說了,SIMT 軌還需要釘死的 nightly 這件事,正是他們想擺脫的東西。
cutile-rs 那邊輕得多:Linux、Compute Capability 8.0 以上、CUDA 13.3、穩定版 Rust 1.89 以上,不用自備 LLVM。cutile 已經發布在 crates.io,cargo add cutile 之後把官方範例貼進 src/main.rs 就能跑。Tile 模型還有一個換得掉的負擔:原始碼不編碼特定架構的選擇,對應到不同 GPU 時由編譯器重新調度,這也是官方建議預設選 Tile、需要直接控制執行緒與記憶體時才降到 SIMT 的理由。
如果你手上沒有符合條件的卡,這兩條路暫時都與你無緣。Compute Capability 8.0 的門檻對應 Ampere 之後的世代,也就是說近年買的卡多半過關,但更舊的 Turing 卡就出局了。許多本機 AI 工具對顯卡世代的要求也是同一套邏輯,像用顯卡跑本地 AI 助手這類應用,硬體門檻向來是第一道篩子。
公告裡提到 cutile-rs 已在 NVIDIA 之外被使用,點名了兩個名字:Hugging Face 的 Grout 推論引擎,以及 Eric Buehler 的 mistral.rs。這兩點都可以直接翻依賴清單驗證:mistral.rs 主分支的 Cargo.toml 寫著 cutile = “=0.3.0″,等號釘死版本;Hugging Face Grout 主分支用的是 cutile 0.2.0 與 cutile-compiler 0.2.0。這裡有個交叉點:Buehler 同時是那篇 arXiv 論文的五位共同作者之一,也就是說最早把 cutile 用起來的下游,作者本身就參與了這套系統的設計,採用與研究在這裡是同一批人。
mistral.rs 的說明文件裡有個容易被忽略的細節:cuTile 加速在 mistral.rs 裡是可選項,不是預設路徑,而且要另外裝 NVIDIA 的 tileiras 工具才動得起來;預設的下載版本在 Linux 上走 CUDA 或 CPU、Apple Silicon 走 Metal,標準加速不需要 Rust 工具鏈。換句話說,「已整合」的實際意思是「存在一條可選的加速軌」,距離全面替換還很遠。對照 crates.io 上最新的 0.3.1,兩個下游也都還在追 0.x 版本的狀態。這是「不是實驗室玩具」的證據,同時也是「還在 0.x 世界」的證據,兩面都該看到。
儲存庫本身的熱度可以當參考:cuda-oxide 在目前累積超過 3,400 顆星,cutile-rs 接近一千顆,兩者都以 Apache-2.0 授權開源,提交活動到 9 月中旬都還很活躍。Hacker News 上這份公告在 9 月 8 日首度被提交,9 月 16 日的第二波討論串衝上約 770 分、三百多則留言,討論主力集中在 CUDA 的私有綁定疑慮與 Rust 安全保證的實際強度,也就是說,社群的熱度是真的,質疑也是真的。
這份公告的可信度,很大一部分來自官方把界線畫得很清楚。兩個專案都被明確標為早期階段而非成品;重申開頭那組界線:cuda-oxide 是 early alpha,覆蓋與 API 穩定性都還在路上。Tile 模型拿掉了共享記憶體與執行緒索引這兩個容易出錯的東西,因為編譯器接管了它們,但代價是你放棄了那層控制,而 SIMT 軌今天要用共享記憶體仍然得寫 unsafe,官方把這條路的安全化列為進行中的工作,共享記憶體恰恰是高效能 SIMT 核心的基石,這一點值得任何考慮深度使用的人先看清楚。
跨語言互通也是計畫層級而非現成品:公告的說法是 plan to support inter-language interop,目標是 Rust 寫的核心能與 CUDA C++、CUDA Python 生態互通,但在這成真之前,選 Rust 軌就是在賭一份路線圖。好消息是公告同時給出了期限感的措辭,NVIDIA 會持續投入跨過 2027 年,而不是發一篇部落格就收工。
另一個容易誤讀的地方:有些人把這次公告讀成「Rust 從此可以直接寫 CUDA 核心了,所以過去的做法都作廢」。實際上,用 Rust 啟動 CUDA 核心的綁定早就存在,社群的 cudarc、cust 都是,公告自己也說 Rust 在 GPU 上不是新鮮事。新的東西是核心本身可以用純 Rust 寫、原生編到 PTX,不必再退回 CUDA C++ 或 Python DSL,以及 NVIDIA 願意把工程資源押在這條路上。
現在就能做的:兩個官方範例都是完整程式,cuda-oxide 走 cargo oxide new 起 Template 再 cargo oxide run(第一次要編後端,會等一段時間),cutile-rs 照前一節的安裝步驟就能跑範例。官方手冊、cuTile Rust 文件、論文與兩個儲存庫的 Discussions 和 Discord 頻道都開著,公告還邀社群回報粗邊緣。如果你的工作本來就貼著 GPU 核心與 Rust,現在跑通範例、把兩條軌的安全模型讀懂,成本很低,報酬是未來半年的演進你會看得懂。
還不能做的:把生產程式碼遷上去。API 會動、覆蓋不完整、cuda-oxide 鎖 nightly、共享記憶體還在 unsafe,這四條任何一條都足以讓謹慎的團隊再觀望一兩個版本週期。比較務實的定位,是把它當成 CUDA C++ 之外的新選項來追蹤:先用 Tile 軌的小專案練手感,看 mistral.rs 與 Grout 這些先驅使用者的升級節奏,等 API 穩定訊號出現再認真評估。
對只想在瀏覽器或桌面工具裡用 AI 的多數讀者來說,這則新聞的直接影響要等一段時間才會浮現:推論引擎把核心換成更安全的實作,受惠的是穩定性與長期的維護成本,而不是下個月的速度。但對寫 Rust、碰 GPU 的人,9 月 8 日這份公告值得從頭到尾讀一次,它是 CUDA 二十年歷史裡,官方第一次把 Rust 放進第一線寫 GPU 核心的位置。如果你平常的工作比較接近拿現成工具疊本機 AI 應用的那一端,像把換臉與對嘴留在自己顯卡上的那類工具短期內不會有感覺,但這條線往上走的每一層,最後都會沉進你每天用的東西裡。