TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

2026 年 9 月 28 日凌晨,我在瀏覽器裡打開 PaSa 的官方網站,前後送出七次查詢。兩次點它首頁內建的範例題,一次拿到 76 筆長影片理解論文、一次拿到 18 筆 in-context learning 論文,清單裡全是這個領域繞不開的真文獻;另外五次我自己輸入新題目,得到的是同一句話:Sorry, there are no papers in arXiv that meet your
用 AI 摘要這篇文章:
2026 年 9 月 28 日凌晨,我在瀏覽器裡打開 PaSa 的官方網站,前後送出七次查詢。兩次點它首頁內建的範例題,一次拿到 76 筆長影片理解論文、一次拿到 18 筆 in-context learning 論文,清單裡全是這個領域繞不開的真文獻;另外五次我自己輸入新題目,得到的是同一句話:Sorry, there are no papers in arXiv that meet your query.(抱歉,arXiv 裡沒有符合你查詢的論文)。
同一個網站、相差兩分鐘的兩種結局,就是想用 PaSa 之前該知道的核心事實。PaSa 是 ByteDance(字節跳動)Seed 團隊開源的論文搜尋代理,論文登上 ACL 2025 主議程,作者群裡有 Hang Li 與 Weinan E 兩個在機器學習圈重量級的名字;程式碼、模型權重、訓練資料集全部公開,網頁版免費、免註冊,打開就能用。問題在於,這個「能用」目前有很大的但書:我的實測裡,它穩定答得出來的,只有它自己放在首頁的那三個範例題。
PaSa 這個名字取自 Paper Search Agent。它不是又一個搜尋引擎,底層照樣打 Google 搜尋與 arXiv,差別在它把「怎麼找」交給兩個語言模型自己去決定。
第一個叫 Crawler,負責擴散。它讀完你的查詢後,自己決定要產生哪些搜尋字串、讀到某篇論文後要不要沿著它的引用往下游再挖一層、什麼時候停手。第二個叫 Selector,負責把關,對 Crawler 收集到的每篇論文讀標題與摘要,判斷符不符合你開的條件。整個流程等於把研究生做文獻探討時「搜一輪、讀一輪、再搜一輪」的迭代苦工,交給兩個 7B 模型接力,而這兩個模型都是以 Qwen2.5-7B-Instruct 為底座微調出來的。
訓練方式在論文裡寫得很明白:團隊先用 AutoScholarQuery 這套合成資料集做監督式微調,內容是 3.5 萬筆從頂級 AI 會議論文反推製造的條件具體的細部查詢與對應文獻;之後再用 PPO 強化學習繼續調,讓 Crawler 學會在「多搜一次」與「收工」之間做取捨。為了測真實場景,團隊另收集了 RealScholarQuery 基準:50 題由 AI 研究者實際提出的查詢,答案由專業標註者盡可能找齊。
作者在論文裡宣稱,在 RealScholarQuery 上,PaSa-7B 的 recall@20 比最強的 Google 基線(Google 加 GPT-4o 改寫查詢)高 37.78%,比用 GPT-4o 提示詞實作的 PaSa 版本高出 30.36% recall、4.25% precision;推論時把 Crawler 跑兩次再合併結果,recall 還能再往上推。recall@20 白話說就是「它給你的前 20 筆裡,涵蓋了多少本來就該找到的文獻」,對要把清單搜齊的人,這是比精確度更關鍵的指標。這些是作者宣稱的數字,我沒有重現;但 GitHub 上的公開討論提供了一個對照點:有使用者照著文件走完重現流程,RealScholarQuery 的 recall 只有 0.32 上下,與論文數字有一段距離,這則討論至今沒有作者答覆。
網站位在 pasa-agent.ai,打開不需要任何帳號。首頁一條輸入框,placeholder 寫著 Please enter the academic query you want to search. Only English input is supported.(請輸入你想搜尋的學術查詢,僅支援英文輸入),下方橫幅自述目前對電腦科學領域的查詢支援較好,其他領域之後再說。輸入框底下排著三個膠囊狀的範例查詢,點下去就會直接開跑。
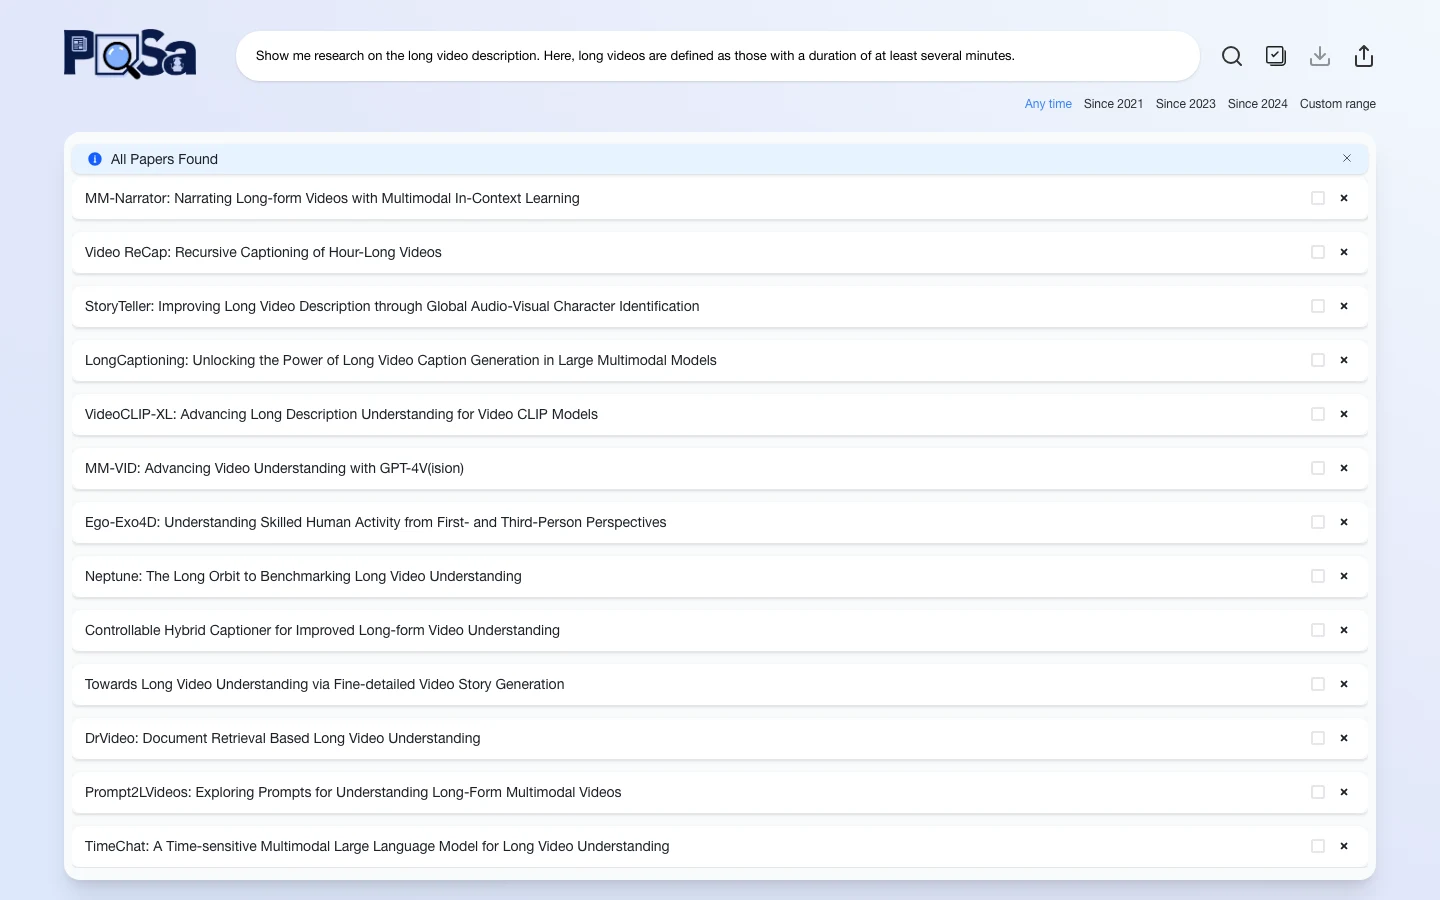
範例題的表現確實漂亮。我點了「長影片描述」那題,一分鐘上下頁面就列出 76 筆論文,從 MM-Narrator、Video ReCap 到 LongVideoBench 這類基準、再到 InternVideo2 與 Qwen2.5-VL 的技術報告,做長影片理解的人一眼就認得這些名字,篩選品質沒話說。另一題 in-context learning 半分鐘左右給滿 18 筆,清單裡有 Induction Heads、Language Models are Few-Shot Learners 這種該領域的地基文獻。跑的過程中論文是一筆一筆長出來的,看得出代理真的在搜尋、讀、再搜尋,不是一次吐出靜態清單。結果頁還附時間篩選(任何時間、2021 年起、2023 年起、2024 年起、自訂區間),右上角有下載與分享按鈕。
自訂題就沒這種待遇。我在同一天、前後三個瀏覽器工作階段裡,陸續輸入了四種英文新題目,主題涵蓋多語言模型的參數高效微調、檢索增強生成與幻覺、視覺語言模型的文件理解、混合專家模型的推理效率。這些都是 arXiv 上論文以千計的熱門主題,任何一題丟進 Google Scholar 都是整頁結果;而 PaSa 給我的五次答案(四題英文加一題中文)全部是同一句零結果訊息。中文那題的結果本來就不令人意外,輸入框的提示文字已經言明僅支援英文,但它連「看不懂你的語言」這類專屬訊息都沒有,中文與英文自訂題拿到的是同一句制式道歉,看不出背後有沒有真的處理過查詢。最刺眼的是那兩分鐘的對照:凌晨 01:28 範例題成功給出 76 筆文獻,01:30 我輸入混合專家模型那題,零結果。相差兩分鐘、同一個工作階段,一個天上一個地下。
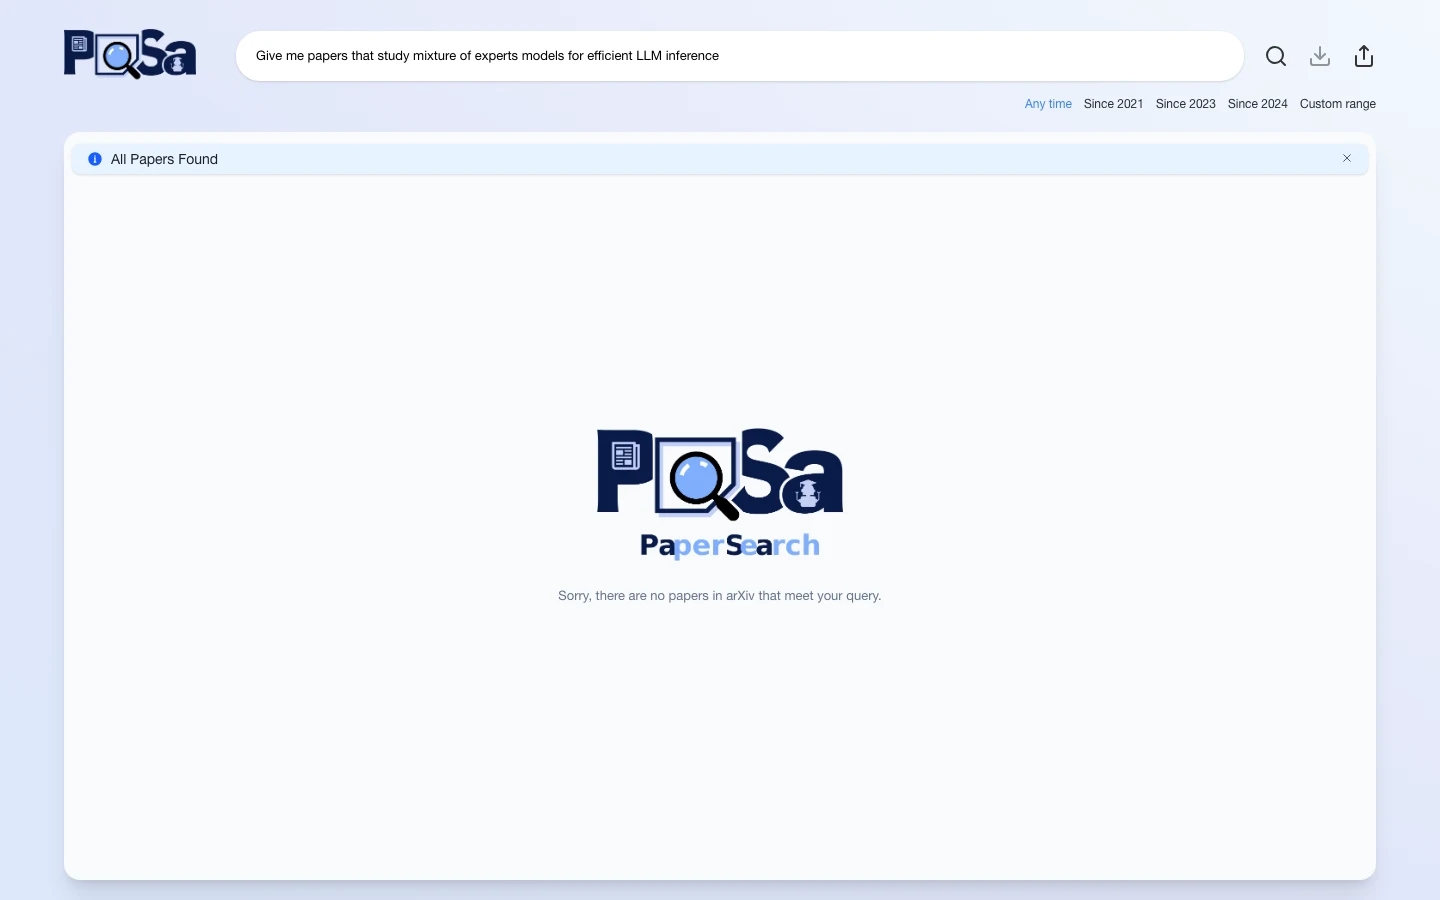
頁面上還有個耐人尋味的細節:零結果的時候,結果區上方的橫幅仍然寫著 All Papers Found(所有論文已找到),下面才接抱歉句。字面上「全找到了」與「找不到任何一篇」同框出現,這個 UI 措辭多少透露了它的完成度。
如果只是我倒楣一天,事情還小。翻開 GitHub issues,這個狀況有清晰的公開紀錄。2025 年 11 月 2 日有人開 issue 問「為什麼突然搜不出文章了」,十天內十個人加一表示同樣遇到,11 月 7 日有人反映恢復正常;2026 年 3 月 31 日另一則留言寫得更精確:還是偶爾搜不出文章,顯示 All Papers Found 但一篇都沒有,過一陣子又可以搜。同一天,另一個人也開 issue 問網站服務是不是掛了,附了截圖,無人答覆。
把時間線排開:2025 年 11 月大規模失效、之後恢復、2026 年 3 月仍偶發、2026 年 9 月我實測時自訂題全滅。這是斷斷續續至少十個月的間歇性故障,單日運氣解釋不了,也還沒死透。同期間還有零星討論停在沒有下文的狀態,像有人問論文裡 PaSa-GPT-4o 版本的程式碼在哪裡,也一直沒有答案。對讀者的意義很實際:重要的文獻探討別押在它身上,因為你不知道打開的那天是哪一種狀態;至於故障原因,站方從頭到尾沒有公開說明,我也不替它猜。
既然網頁版不穩,自己架總行吧?畢竟是開源專案。現實是把倉庫打開看完之後,門檻比想像高好幾層。
自架之前,先看專案現在的樣子。倉庫 2024 年 12 月建立,main 分支最後一次更新停在 2025 年 5 月 27 日,內容是改 README,至今一年四個月沒有新程式碼,也從未發過任何正式 release。整個專案只有十來個檔案,論文、代理邏輯、評測腳本各一點,是典型的論文附件型程式碼。有使用者反映 run_paper_agent.py 把參數傳錯(search_queries 拿到的是 expand_papers 的值),2026 年 6 月有人提交修復的 pull request,到現在還掛著沒併入;甚至有外部貢獻者主動補上程式碼風格檢查的 CI 設定,同樣無人處理。自架者拿到手的,是一份帶著已知缺陷的研究快照。
裝環境這關也有個性。文件要你先 clone 第一作者的個人 transformers 與 trl fork(不是 PyPI 上能裝的正式版,作者改過這兩個庫的原始碼),requirements 裡還有 flash-attn 這類需要編譯的套件;接著要從 Hugging Face 把兩個模型權重拉下來放進指定資料夾,重現論文數字的人還得再下載整包論文資料庫與資料集。金鑰則完全是自己的事:Crawler 的搜尋能力建立在 Google 搜尋 API 之上,你要自己去 serper.dev 申請金鑰,手動貼進 utils.py 的占位字串裡。順帶一提,README 寫 serper.dev、程式註解寫 serpapi.com、實際端點是 google.serper.dev,三處各說各話,自架前值得先對清楚。
授權是另一道更硬的門,下一節單獨講。至於硬體,倉庫裡沒有給推理等級的官方建議,有人開 issue 問兩個模型同時跑需要多少 VRAM、單卡行不行,至今零答覆;訓練組態倒是寫得很完整,DeepSpeed Zero3、八張卡起跳。一個旁證是兩個模型在 Hugging Face 上的下載數,2026 年 9 月時近三十天分別只有 55 次與 211 次,真正把它架起來跑的人,比倉庫 2026 年 9 月的 1,661 顆星少得多。
授權要分開看兩層。程式碼放在 Apache-2.0 下,商用友好;但兩個模型的權重在 Hugging Face 上標的是 CC-BY-NC-SA-4.0,姓名標示、非商業、相同方式分享。換句話說,你想拿 PaSa 的模型做產品或商業服務,會直接卡在權重授權這關,Apache-2.0 救不了你。對多數只是想試試的人這不構成問題,對認真考慮導入的團隊是必須先想清楚的一筆帳。
隱私這邊有個更微妙的發現。網頁載入與每次查詢,瀏覽器都會往站方 API 送一筆使用日誌,端點名稱就叫 send_user_log,網站本身也架在 ByteDance 的內容傳遞網路(CDN)上,這些都是中性的工程事實。但規範這些行為的條款頁很奇怪:網站上沒有任何連結指向它(頁尾只有 arXiv 與 GitHub),兩個網址 /static/terms 與 /static/privacy-policy 藏在前端路由設定裡,直接輸入完整網址才讀得到內容。讀到之後更妙:條款寫的服務名稱是 PixelDance,ByteDance 的 AI 影音生成平台;資料控制者是新加坡的 SPRING (SG) PTE. LTD.;版本日期 2024 年 1 月 31 日,比 PaSa 專案出現還早十個多月;條款裡甚至寫明服務僅供私人非商業用途。一份替另一個產品寫的範本條款,就這樣掛在論文搜尋工具上。你的查詢內容(很可能包含你正在研究的方向)會進 ByteDance 的基礎設施,而這些資料由誰保管、留多久、誰能看,PaSa 自己沒有交代。
網站還有幾處同樣氣質的細節:分享用的 og:image 圖片中繼資料填的是佔位符 xxx.com,完全沒換過。這些單獨看都是小瑕疵,疊起來指向同一個結論:把它當實驗室展示櫃看待,比當營運產品線看待更接近實情。
值得,但心態要對。把它當研究展示看:兩個強化學習訓練的 7B 代理怎麼分工做檢索迭代、論文宣稱的能力上限在哪裡,這些對做資訊檢索或 LLM 代理研究的人仍有閱讀價值,模型與資料集也都下載得到,就算網頁版哪天真的收掉,研究材料都還在;想先看流程再動手,倉庫 README 附了官方示範影片與架構圖。真要用它找電腦科學領域的英文文獻,可以先試,範例題證明它跑通時品質是真的;但送出前要有零結果的心理準備,重要的清單別只靠它一份,拿到結果也建議逐筆與 Google Scholar 對照。
中文查詢與非電腦科學領域,現階段直接另尋出路。穩定的替代不缺:需要讓 AI 代理替你做多輪調查研究,可以看本機跑的深度研究工具與u14 深度研究;想要現成的 AI 研究助理,ScienceBuddy 是另一種形態;論文讀完想把重點做成海報,Paper2Poster 接手後製。PaSa 這邊,追著 GitHub issue 看站方哪天把自訂查詢修穩,比現在硬依賴它聰明。