TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

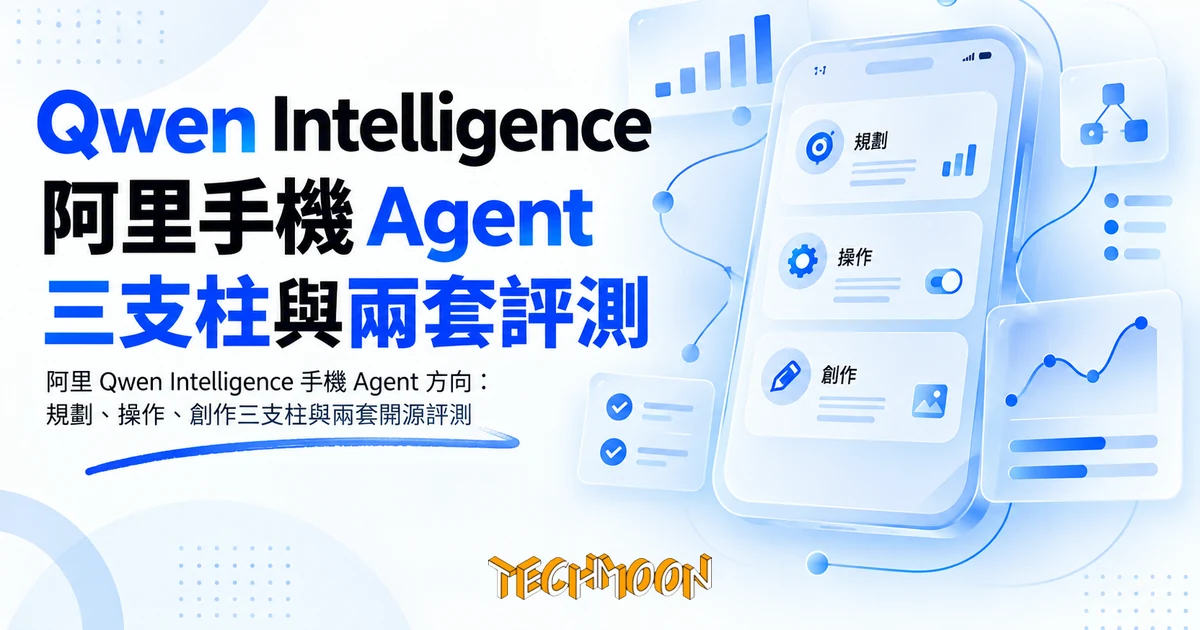
阿里巴巴在雲棲大會宣布手機端 Qwen Intelligence,官方入口網把它拆成規劃、操作、創作三支柱,背後是 Qwen-UI-Agent 技術報告與 MobileWorld、MobilePA-Bench 兩套開源評測。本文對照官方專案頁與論文,整理 82.1% 等分數的測試條件、權重未開放與廠商整合未公告的現況。
用 AI 摘要這篇文章:
2026 年 9 月 22 日阿里巴巴雲棲大會的主論壇上,Qwen4 家族名稱首次曝光之外,官方還宣布了手機端的人工智慧方案 Qwen Intelligence。截至 9 月 24 日查驗,這個名稱已經有實體可核對:官方入口網 qwenintelligence.com 上線,頁面把能力拆成規劃、操作、創作三個方向,底下掛著技術報告與兩套開源評測專案。值得先記住的結論是:這次真正公開的是一套把手機代理能力拆開測量的研究基礎設施,外加一張自評成績單,還沒有可以直接裝進手機的產品,也沒有任何硬體廠商整合的官方公告。
先講清楚這裡說的手機代理在做什麼。官方展示的示範任務長這樣:從抖音找出最多人收藏的百香果酸湯牛肉食譜,記下食材,到盒馬把食材全部加入購物車、排除調味料,指定當天 18:45 送達並下單;或者查 12306 最早抵達杭州西站的高鐵班次,算出轉地鐵到辦公室的時間,再自動在釘釘排一小時會議、標題與提醒都設好。這類任務難的地方在於跨 App、有條件、有順序,付款或下單前還要停下來讓人確認,跟聊天問答是兩回事。跨 App 手機代理並不是新概念,本站先前介紹過開源的 OpenCyvis與雲端方案的 AutoGLM,差別在阿里這次把操作、規劃與創作包成同一個對外方向。
對一般手機使用者來說,未來幾個月內手機不會因為這場發布多出任何新功能,暫時不需要做任何事。這波公開真正影響的族群是開發者與 AI 觀察者:評測程式碼以 Apache-2.0 開源,任何人都可以拿同一份考卷去測自己的模型。以下把官方一手材料裡可核對的內容攤開,包括三份報告各講什麼、82.1% 這類分數的測試條件,以及哪些部分官方一個字都還沒說。
Qwen Intelligence 的官方入口網是這次正式發布後最直接的可核對實體。頁面底部的聯絡信箱是 [email protected],網域註冊商是阿里雲,頁面文字為簡體中文,口號大意是讓每個人都用得到的個人化人工智慧。首頁列出五個訴求維度:手機場景的模型能力、複雜任務的穩定交付、任務執行的完整鏈路、全端模組化交付,以及裝置與雲端的協同。
整個站其實是一個研究聚合頁。它把 Qwen Intelligence 分成三根支柱:Mobile Planner Agent 負責任務規劃,Mobile-Use Agent 負責操作介面,Creative Agent 負責創作生成。每根支柱底下掛的連結不是產品頁,而是 arXiv 論文、GitHub 儲存庫與專案部落格,例如規劃側的 MobilePA-Bench 與 Qwen-Planner-Agent、操作側的 Qwen-UI-Agent 與 MobileWorld、創作側的像素空間生圖研究與 Z-Reward 等論文。
頁面上的「前往控制台」按鈕指向 qwenintelligence.aliyun.com,也就是阿里雲的網域。整個入口網看不到任何手機品牌合作、上市時間或裝置清單,消費者端的產品形態,官方完全沒有交代。這是解讀後續新聞時的基本盤:名字與方向宣布了,硬體整合屬於未確認事項。
把公開件的時間線排開,也能看出這場發布的節奏:Qwen-UI-Agent 報告 7 月 30 日上 arXiv,像素空間生圖研究 8 月 17 日、MobilePA-Bench 論文 8 月 24 日跟進,MobilePA-Bench 與 MobileWorld 的儲存庫分別在 8 月初與 2025 年 12 月就建立;網域紀錄顯示 qwenintelligence.com 在 9 月 10 日有過一輪更新,Qwen-Planner-Agent 儲存庫 9 月 18 日開張,9 月 22 日雲棲主論壇宣布當天 MobileWorld 儲存庫還在推更新。換句話說,Qwen Intelligence 這個名字是把已經進行大半年的手機代理研究,在雲棲包裝成一個統一的對外方向。
三根支柱裡材料最完整的是 Qwen-UI-Agent,出自阿里 MAI-UI 團隊,技術報告 2026 年 7 月 30 日送上 arXiv(編號 2607.28227)。官方專案頁列出三個手機端基準成績:MobileWorld 82.1%、MobileWorld-Real 92.2%、AndroidDaily 97.5%。這三個數字經常被並排引用,但它們測的難度差很多,分開看才知道在講什麼。
| 基準 | Qwen-UI-Agent | 次高 | 官方頁對比組 |
|---|---|---|---|
| MobileWorld(跨 App 長程) | 82.1% | Seed 2.1 Pro 73.2% | GPT-5.6 Sol 70.1%、Claude Opus 4.8 67.5%、Gemini 3.1 Pro 58.1% |
| MobileWorld-Real(實機測試) | 92.2% | Seed 2.1 Pro 88.7% | Gemini 3.1 Pro 86.2%、GPT-5.6 Sol 85.4%、Claude Opus 4.8 84.7% |
| AndroidDaily(日常高頻任務) | 97.5% | Seed 2.1 Pro 95.2% | Gemini 3.1 Pro 93.8%、Claude Opus 4.8 93.0%、GPT-5.6 Sol 92.6% |
報告裡撐起這些分數的基礎設施有具體數字:超過 100 台實體 Android 裝置、支援超過 150 個 App 的真機訓練與評測環境,線上強化學習跑到超過 100 步的軌跡,並用大約 10,000 個並行模擬環境加速取樣。MobileWorld-Real 那套實機評測本身也超過 400 個任務、涵蓋超過 100 個 App。報告花了不少篇幅解釋為什麼非用真機不可:真實手機上有中斷、權限與驗證碼、彈窗與網路波動,報告也點出中國的行動 App 生態以超級 App、密集介面與頻繁彈窗著稱,這些執行路徑在沙盒裡重現不了;團隊甚至為每支手機建健康調度,任務會被派到當下可用的裝置與帳號,壞掉的環境先隔離修復再上線。
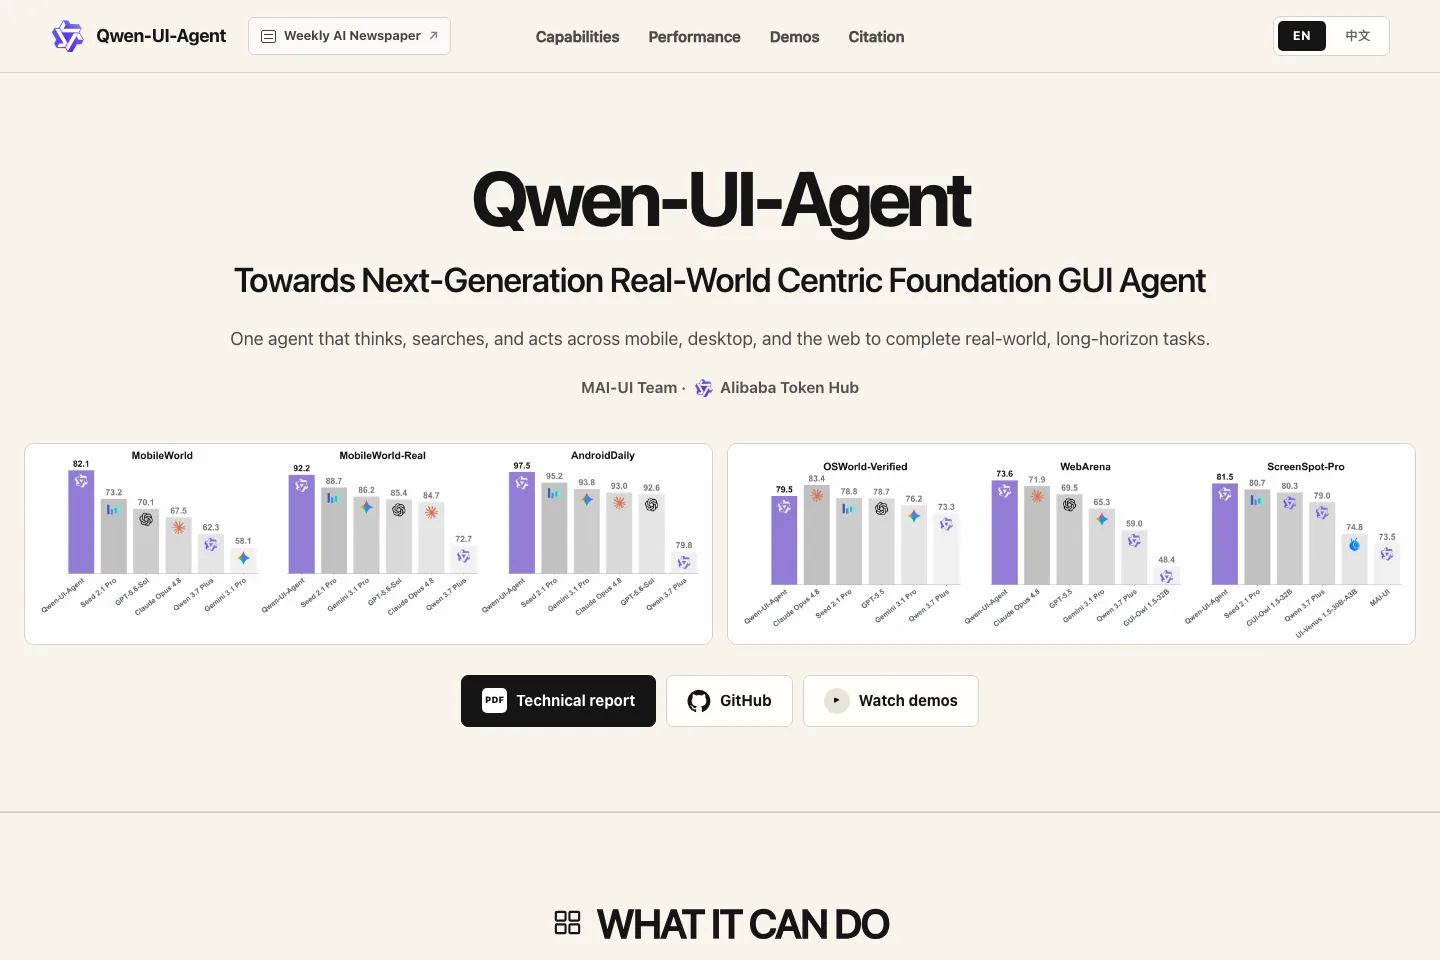
另外兩個面向的分數可以對照著看。桌面端 OSWorld-Verified 拿 79.5%,瀏覽器端 WebArena 拿 73.6%,都屬於有競爭力、還不到碾壓的區間;GUI 定位(ScreenSpot-Pro 允許放大檢視時 81.5%)與通用能力也保留了,官方比較表裡 MMMU-Pro 72.4%、Tau2-Bench 89.9%,對照的 UI-Venus 30B 只有 32.4% 與 22.7%。團隊的說法是 Qwen-UI-Agent 沒有為了點介面犧牲基礎模型的推理與工具使用,也就是還能拿來做一般模型的工作,這點對之後要把它塞進手機當系統級助理的場景很關鍵。
不過這張成績單有兩個必須一起讀的但書,都寫在官方頁面上。評測說明欄寫明所有分數都在作者自己的評測環境重現,部分對手基線還掛著符號註記,表示基線數字出自作者環境,各廠官方沒有背書;這等於阿里自己出的考卷、自己監考。另外,Qwen-UI-Agent 的模型權重至今沒有開放,Hugging Face 上 Tongyi-MAI 組織只有 Z-Image 與 MAI-UI 系列,查不到 Qwen-UI-Agent 這個名字,開放的只有報告文件(CC BY 4.0 授權)與評測專案。分數可以先記著,第三方能不能重現,要等權重或外部提交出現。
Qwen Intelligence 底下兩套評測專案解決的問題不同,混為一談會誤讀分數。
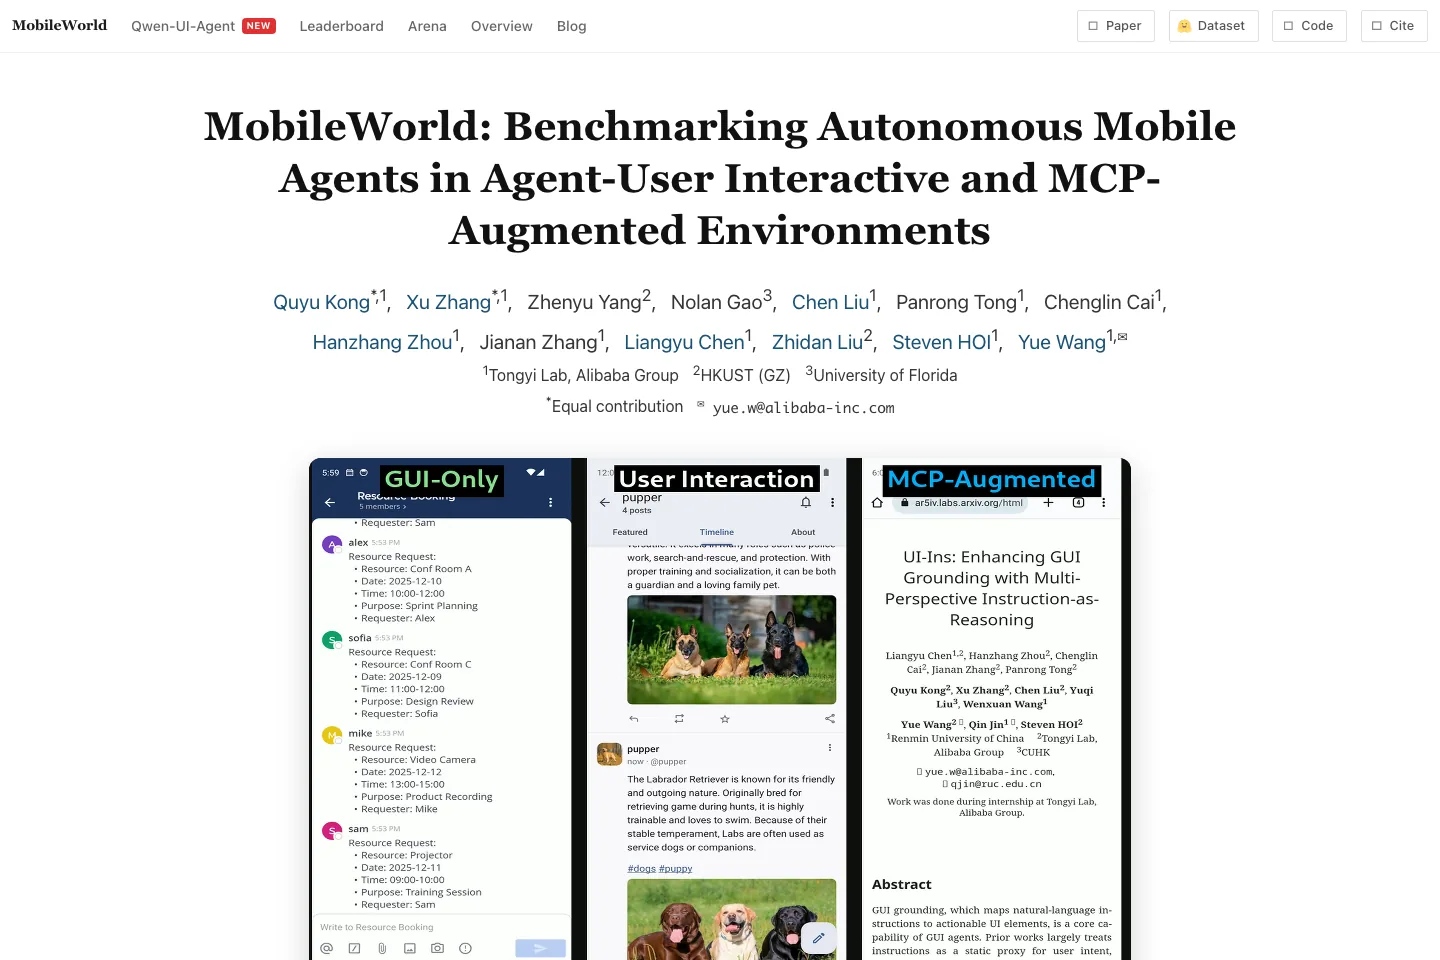
MobileWorld(論文獲 ACL 2026 收錄)量的是跨 App 長程操作。它的 201 個任務橫跨 20 個 App,其中 117 個純 GUI 操作、44 個需要主動向使用者提問釐清、40 個要混用 MCP 工具呼叫(MCP 是讓模型以標準格式呼叫外部工具的開放協定)。難度刻意拉高:任務平均要 27.8 個步驟才完成,接近 AndroidWorld 基準 14.3 步的兩倍;62.2% 的任務要跨 App 協作,AndroidWorld 只有 9.5%。論文團隊強調約 95% 任務用第三方 App,並靠自架後端資料庫與本地儲存檢查做確定性驗證,讓「任務到底有沒有完成」交給機器判讀,其中 47.3% 的任務靠資料庫驗證、36.8% 靠本地儲存檢查。官方比較表把 MobileWorld 與 AndroidArena、A3、AndroidLab 等八套線上基準並列,同場出現的 AndroidDaily 是 48 個 App、235 個任務的基準,兩者成績不能互換著讀。儲存庫 2025 年 12 月建立,9 月 22 日還有推送,授權 Apache-2.0,並新上線了 Arena 功能,可以把兩個代理在同一任務上的執行軌跡並排回放,直接看懂一個代理為什麼成功、另一個為什麼失敗。82.1% 就是在 MobileWorld 這份考卷上、上限 50 步的設定下測出來的。
MobilePA-Bench(arXiv 2608.23035)量的則是規劃能力:模型能不能在有狀態的環境裡選對工具、傳對參數、記住使用者偏好、把工作拆給子代理。規模是 1,705 個任務、212 個工具、13 個功能領域,四個維度的任務量分別是工具使用 1,040、記憶 376、技能 200、子代理協作 89,總分按 50%、20%、20%、10% 加權。沙盒會維持活的應用資料庫、每一步回傳結構化回饋,讓模型真的把呼叫執行下去,字串相似度比對不算過關;任務同時設有候選工具與步數上限(各 15),猜中工具名不代表過關。13 個領域從音訊娛樂、系統設定到旅行生活都涵蓋,貼近真實手機會用到的工具組合。論文摘要裡有一句對讀者很有價值的誠實結論:前沿模型在嚴格的工具順序、權限限制與執行期錯誤下,表現會明顯下滑。這句話等於官方自己承認,聊天很強的模型不等於手機上任務做得完。
兩套評測都接受外部提交成績,MobilePA-Bench 還提供閉門評測服務,模型廠商交出 OpenAI 相容端點,三個工作天內拿到報告,隱藏任務與答案不外洩。考卷開放給所有人,是這波公開件裡含金量最高的部分。
規劃支柱的最新實體是 Qwen-Planner-Agent,一個 27B 模型搭配工具、記憶與技能的執行框架,官方頁寫的數字是在 MobilePA-Bench 拿到 77.05% 總分,每千次任務成本 2.41 美元(只計輸出 token)。它的 GitHub 儲存庫 2026 年 9 月 18 日才建立,9 月 23 日仍有推送,時間點就在雲棲發布前後,是這波公開件裡最新的成員。技術報告提出一套 AI-for-AI 的自動循環:用代理來生任務與環境、用能力自適應的獎勵來訓練、再用執行證據回頭改框架。
創作支柱目前距離產品最遠。入口網掛的代表論文是像素空間文字生圖擴散模型的經驗研究(arXiv 2608.16887,8 月 17 日提交),核心發現是先在壓縮的潛空間預訓練、後訓練階段再轉到像素空間,可以在研究條件下把端到端推論加速 3.18 到 4.75 倍。這個倍數指的是特定實驗設定下的相對加速,論文沒有承諾任何手機上的絕對秒數,把它讀成每支手機三秒出圖是過度延伸。阿里在生圖這條線上另有已經開放權重的Qwen-Image-2.1,與這篇訓練方法研究屬於不同層次的成果。創作側列表裡還有 Z-Reward(把視覺偏好的單一獎勵分數改成分數分布來學)、D-OPSD、OMG-Avatar、StreamTalk 等項目,全都還在論文與程式碼階段,官方用「輕鬆創作、自主決策、輕應用開發、長程任務交付」四個場景把這些研究包起來,但每個場景對應的可用產品都還沒有時間表。
總結到目前為止的官方件:Qwen Intelligence 已經公開的是三份技術報告、兩套開源評測與一個研究聚合入口網;還沒公開的也一樣清楚。模型權重方面,Qwen-UI-Agent 查無開放版本,外界無法獨立重現那三個分數;廠商整合方面,沒有任何手機品牌、型號或系統層級的公告,入口網的控制台只在阿里雲網域;消費者產品形態方面,收費方式、上市地區、何時可用,官方全部未提。
接下來追蹤這條線,三個訊號比新聞稿可靠:Hugging Face 的 Tongyi-MAI 組織出現 Qwen-UI-Agent 或 Qwen-Planner-Agent 權重;MobileWorld 排行榜出現非阿里體系的第三方提交;任何手機廠商的整合公告掛上 qwenintelligence.com。任何一個出現,都值得重新檢視上述判斷。
開發者現在就能做的事相當具體:MobileWorld 儲存庫照 Apache-2.0 授權可自行部署評測環境,官方文件給了完整的提交路徑,用一條指令跑完全部任務、把軌跡連同截圖打包寄給團隊,審核後就能上排行榜;想測規劃能力可以走 MobilePA-Bench 的閉門評測。一般讀者把這篇的判斷框架帶走就好:之後再看到「阿里手機代理擊敗 GPT-5.6」這類標題,先問分數出自哪份考卷、誰監考、權重開放了沒。這三問比任何單一排行榜名次都更能看出一個手機代理離你的口袋有多遠。