TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Particle 在 10 月 28 日發表 Particle-1,以 DeepSeek V4.1 Flash 後訓練,把省token訓練進模型:四項基準輸出減少 28.4% 到 52.2%,每任務成本降 34.4% 到 51.6%。評測單價、95% 快取命中與壓縮取捨要一起讀,帳單省多少得用自己用量重算。
用 AI 摘要這篇文章:
美國新創 Particle 在 10 月 28 日發表第一款自有模型 Particle-1,先給結論:團隊若已經有固定、可驗收的程式工作與測試,這個模型值得放進比較清單;若任務沒有明確的完成標準,只憑「平均少用約 45% token」就換模型,帳單和交付內容都可能不如預期。這個模型以 DeepSeek V4.1 Flash 為基礎做後訓練,首發聚焦軟體工程,目前只透過 API 供應,權重沒有開放下載,同一天也上架了 OpenRouter。文中數字以 Particle 官方公告與 API 文件為準。
先看事件本身的時間軸。官方部落格文章的日期是 10 月 28 日;OpenRouter 的模型條目建立於同日 17 時 18 分(UTC,台北時間 29 日凌晨 1 時 18 分);創辦人 Suhail Doshi 的宣布貼文落在同日 22 時 26 分(UTC,台北時間 29 日上午 6 時 26 分),文中同時確認了與 OpenRouter 的合作。Doshi 先前創辦分析工具公司 Mixpanel,這次創業的投資人名單包含 Y Combinator、Caffeinated Capital、8VC,以及 Stripe 的 Patrick Collison、Box 的 Aaron Levie、Quora 共同創辦人與 OpenAI 董事會成員 Adam D’Angelo 等天使,公司登記在舊金山。
Particle-1 的核心宣稱是token效率:在 Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1 四項基準上,輸出token比基礎模型減少 28.4% 至 52.2%,每任務平均成本下降 34.4% 至 51.6%,首次嘗試成功率則落在基礎模型的信賴區間內。這四項測試分工明確:Terminal-Bench 2.1 考終端機工作(編譯、除錯、系統設定),ReactBench 考 React 應用的建立與修正(含功能、效能與無障礙),ADE Bench 用真實 dbt 專案與資料庫考資料工程,DeepSWE 1.1 則是需要理解整個程式庫的較長任務。對照組的選擇也有看頭:同一張圖表同時放了 GLM 5.3 Flash,在 DeepSWE 1.1 分頁上,Particle-1 每任務成本 0.2211 美元、平均輸出 59,580 tokens、通過率 72.57%;DeepSeek V4.1 Flash 是 0.3368 美元、83,246 tokens、71.15%;GLM 5.3 Flash 則是 0.6523 美元、98,155 tokens、66.82%。
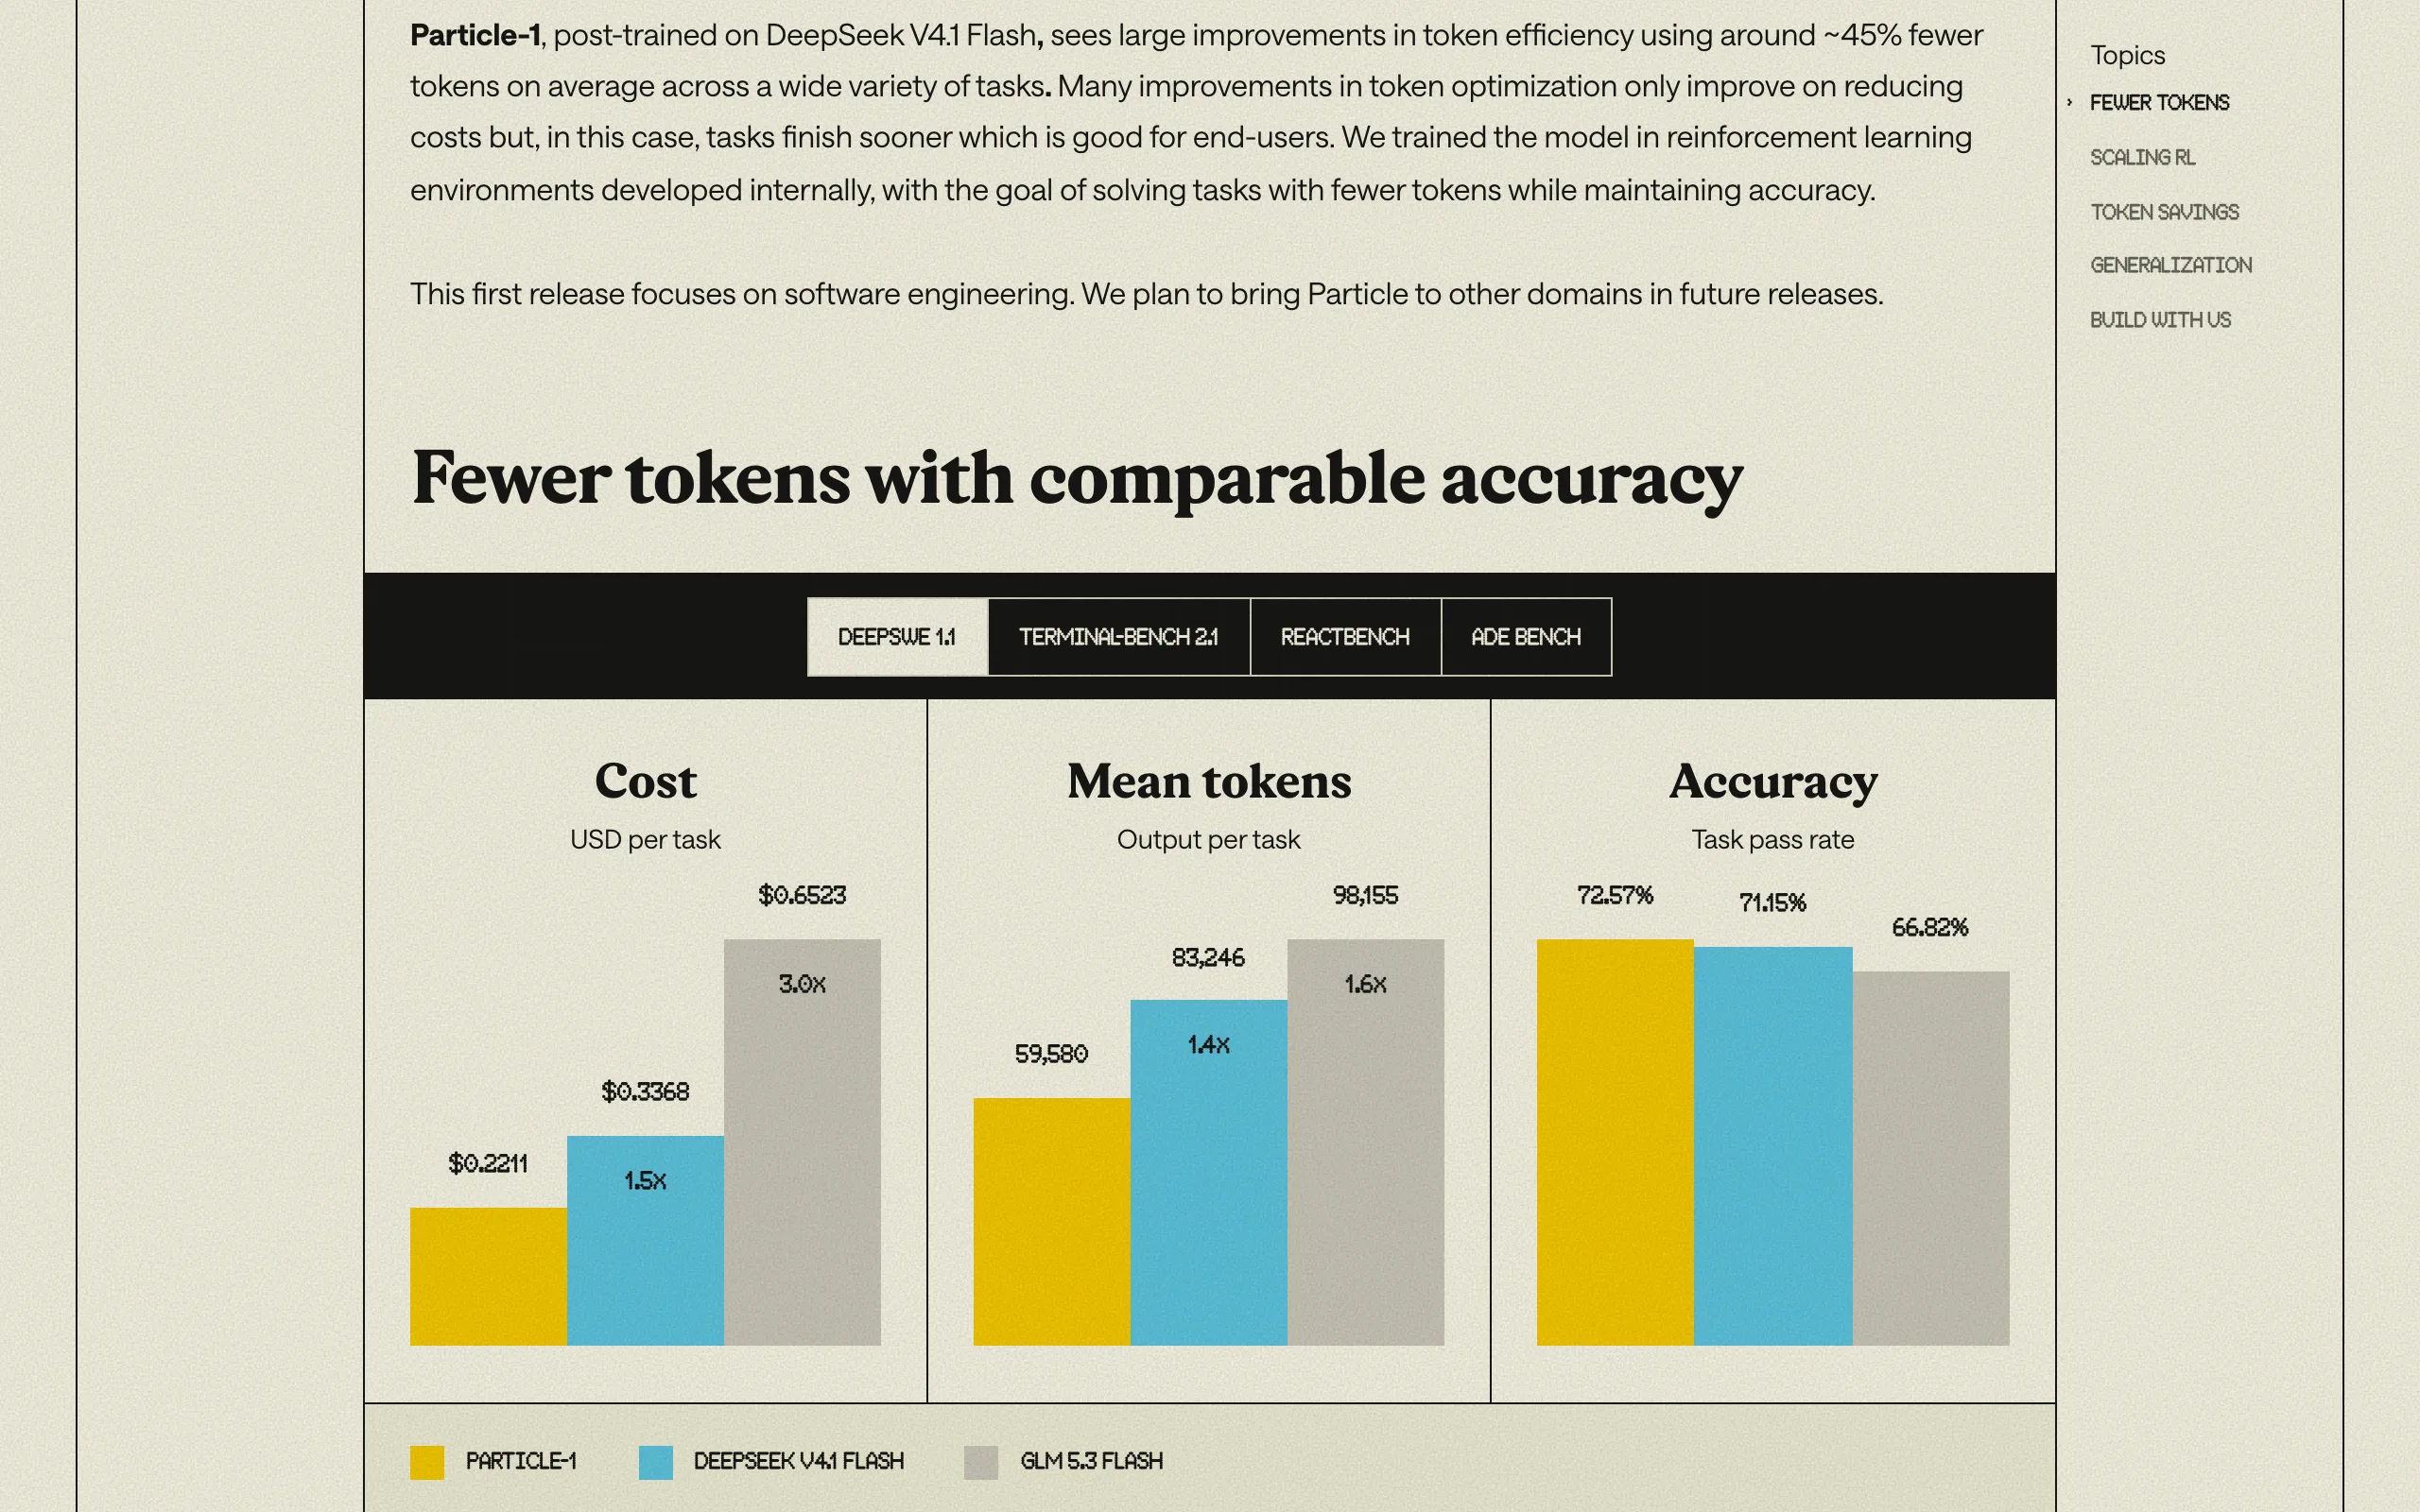
更值得拆開看的,是節省從哪裡來。公告分析顯示,在三項基準上約 90% 的節省來自推理文字(模型「想」的部分),DeepSWE 1.1 另有約 30% 來自工具呼叫文字。兩個官方案例把這件事講得很清楚:行事曆排程任務中,兩款模型都用了四次模型呼叫與六個命令完成正確結果,約 94% 的節省發生在正確檔案已經寫好之後,收尾確認從 5,193 tokens 縮到 1,078;而 pMARS 編譯任務中,Particle-1 先查看 Makefile 再選參數執行,模型往返從 18 次降到 12 次。前者是「想得更少」,後者是「做得更少」。如果你的工作需要詳細的交接紀錄與逐項檢查清單,收尾確認變短未必符合期待,這點官方在案例說明裡也自己承認了。
逐案攤開的紀錄裡還有第三種情況:省下的有一部分來自選了不同的解法。ADE Bench 的一個主鍵任務中,Particle-1 直接沿用專案裡現成的代理鍵巨集,基礎模型則自己實作遞增鍵並補上驗證,兩邊做出來的鍵產生語義並不相同,官方也明說這份節省反映的是不同的解法,與單純把說明寫短是兩回事。反過來的案例同樣值得看:Git 部署任務裡 Particle-1 的模型呼叫次數其實略多於基礎模型,輸出照樣從 43,907 降到 14,840 tokens,最後兩次確認從 11,445 縮到 1,765;go-git 合併衝突任務裡,基礎模型把同一套手動測試重複跑了 20 次,往返 118 次對 86 次。這些紀錄共同說明一件事:token 總量與動作數量會脫鉤,單看其中一個,都推不出另一個。
離開訓練領域後的掉分也有限:GPQA Diamond 90.40%(基礎模型 90.91%)、Tau Airlines 86.00%(88.00%)、Standard MMLU 86.08%(85.98%)、帶工具的 BabyVision 89.18%(89.60%)。這組數字支持「效率提升沒有明顯犧牲通用準確度」的說法,但都是單次發布的量測,屬於作者宣稱,尚無第三方覆核。
公告腳註把測試條件寫得比多數模型發布完整:四項基準統一使用 Terminus 2 代理、512k token 上限、溫度 1、top_p 0.95、最強推理設定,Terminal-Bench 2.1 排除了 fastText 題目;每題產生 16 次嘗試,成本平均把失敗也算進去;快取命中率固定假設 95%。評測採用的單價是每百萬token輸入 0.30 美元、快取輸入 0.006 美元、輸出 1.20 美元,而且 Particle-1 與 DeepSeek 同價,所以成本差確實來自用量,不是價差。
把失敗嘗試一起平均,是這份測試少見的誠實做法。模型每題跑 16 次取出全部結果,平均token數計的是所有有效回合(被基礎設施中斷的排除),不是只挑成功那一輪;真實工作也會重試,只看成功回合的成本比較容易高估省費。代價是這些數字離「你的任務」更遠了一步:16 次取樣的變異、代理環境的固定設定,都會讓單一任務的實際數字偏離平均。
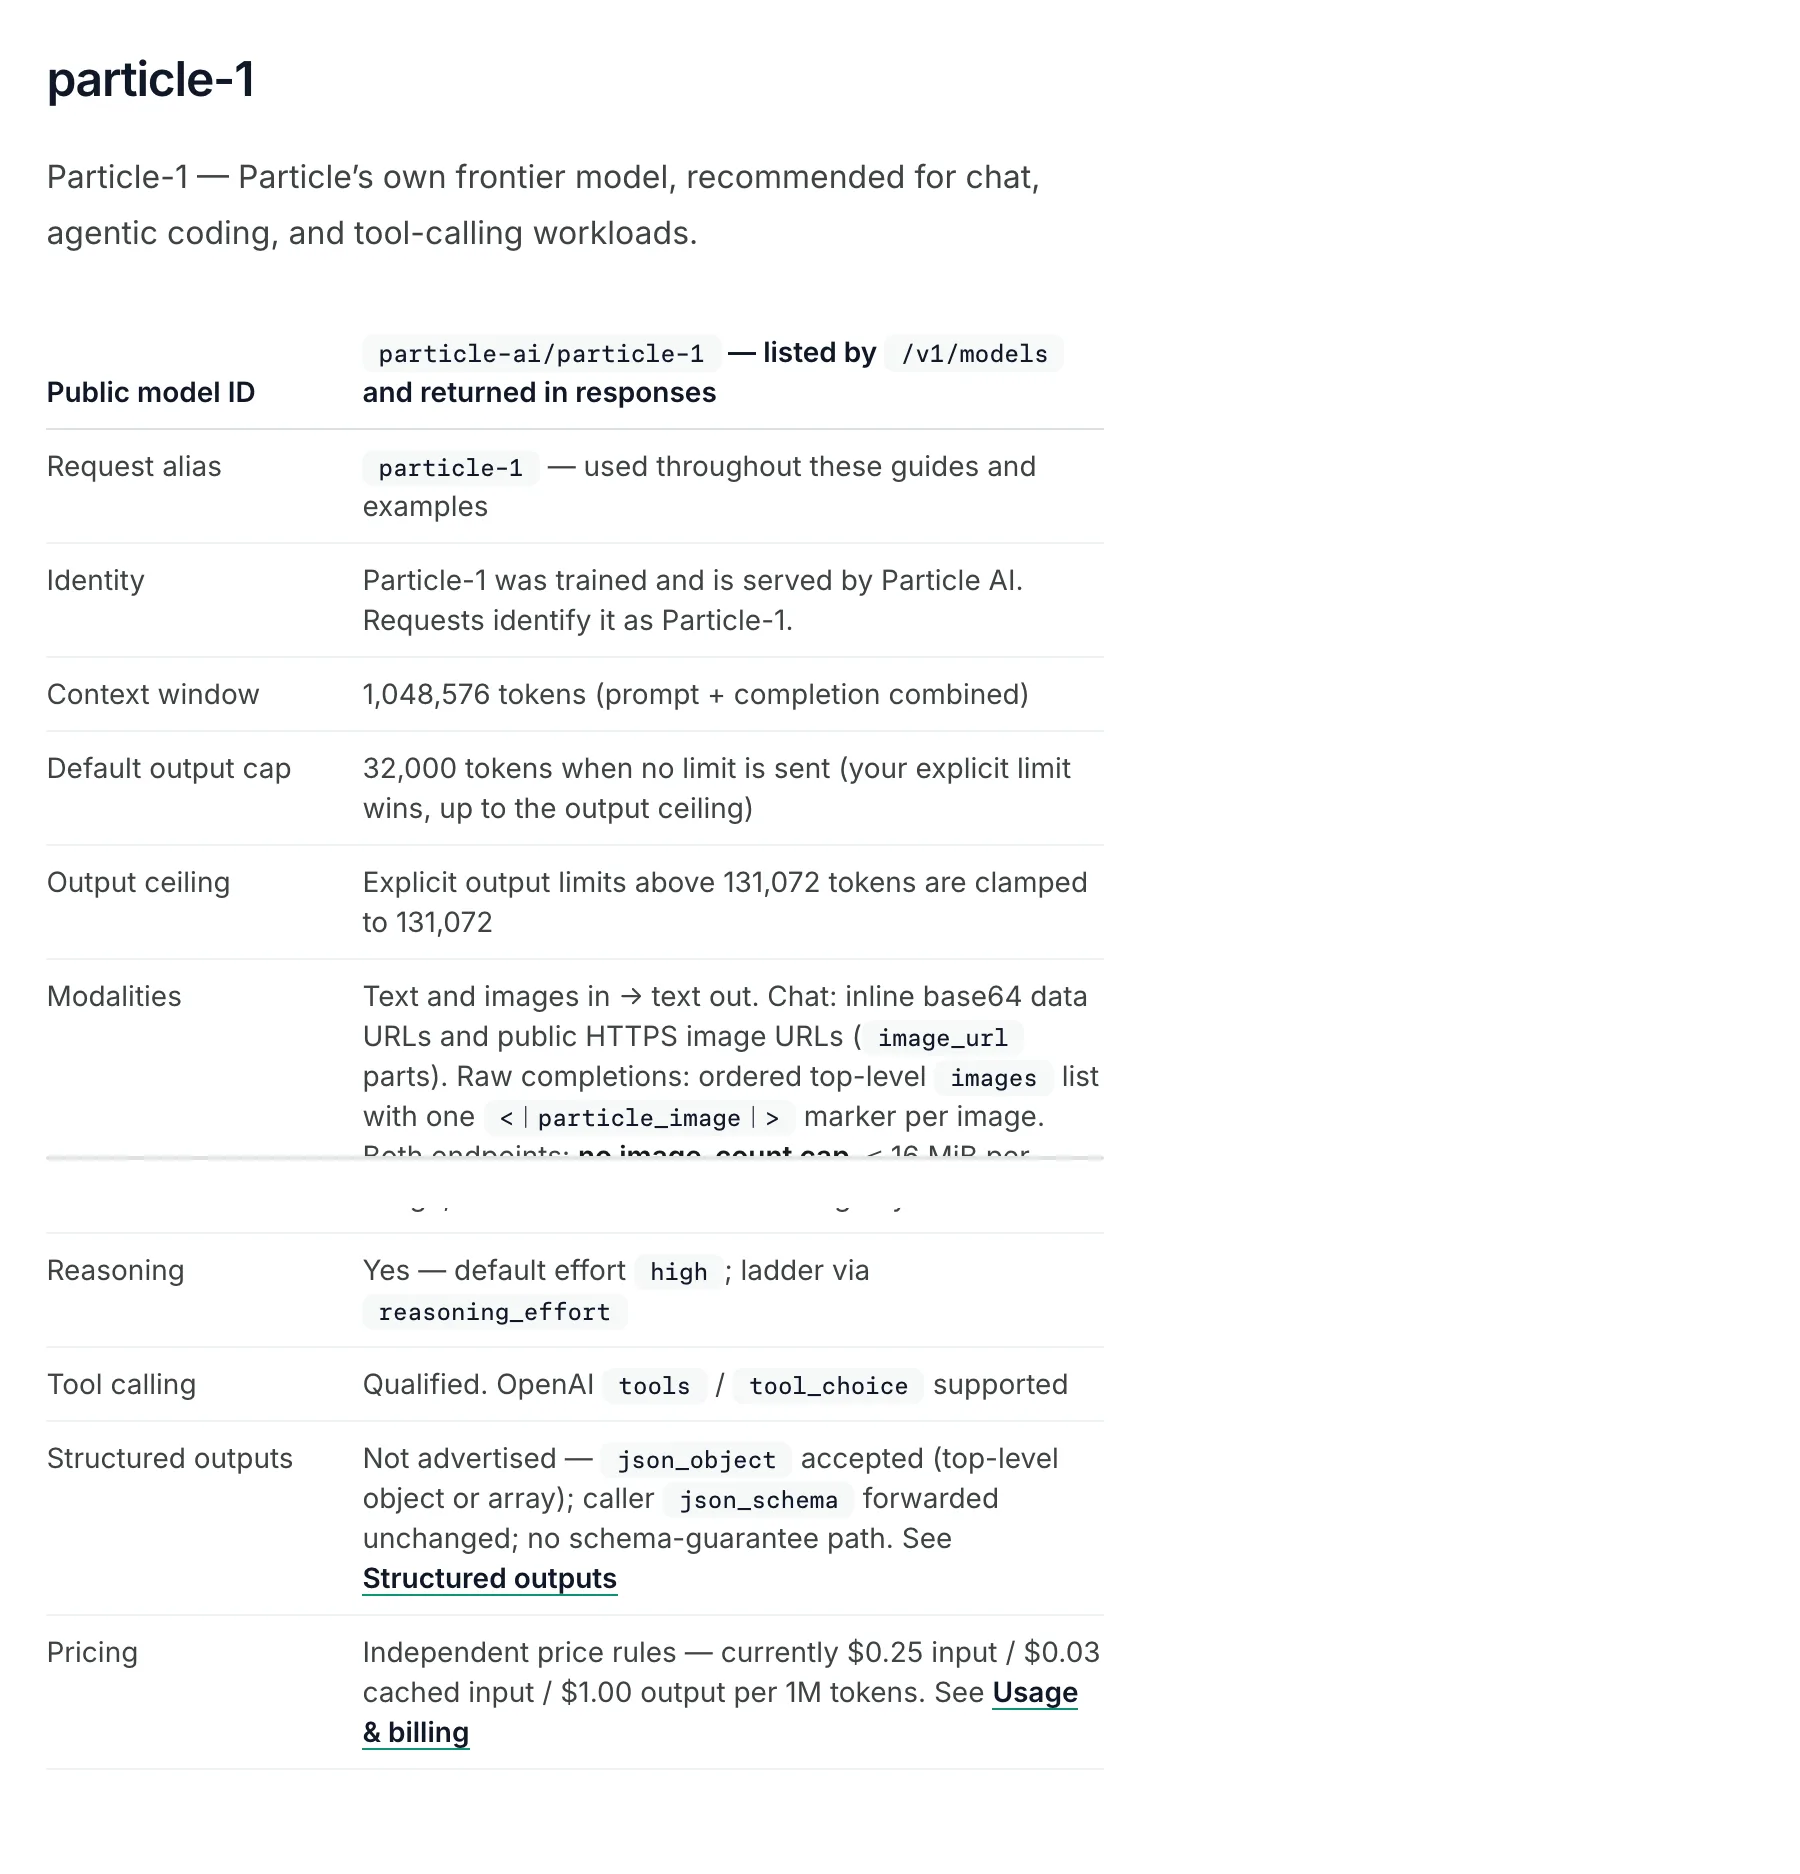
問題在於,這組單價與現行價目不同,而且現行價目本身就有兩個版本。官方模型目錄現在列的是輸入 0.25 美元、快取輸入 0.03 美元、輸出 1.00 美元;OpenRouter 條目上快取讀取價卻是 0.003 美元,與官方文件的 0.03 美元相差十倍。兩個都是官方供應面,下單前請以結帳頁實際數字為準。
| 每百萬token,美元 | 輸入 | 快取輸入 | 輸出 |
|---|---|---|---|
| 官方模型目錄(10-30) | 0.25 | 0.03 | 1.00 |
| OpenRouter 條目(10-30) | 0.25 | 0.003 | 1.00 |
| 公告評測估價 | 0.30 | 0.006 | 1.20 |
表中三列回答三個不同問題:目錄與 OpenRouter 是今天下單的價格基準,公告那一列只說明研究如何算出每題成本。換算到自己的帳單還有兩道:你的快取命中率未必是 95%,若每次都帶入大量新檔案,命中低於假設,省費幅度就會縮水;輸入與輸出的比例也決定你受哪一端影響,短輸入長推理的工作對輸出價格敏感,大量新程式碼進場的工作則要先看輸入與快取。公告在 95% 命中假設下算出的混合輸入單價是每百萬token 0.0207 美元(GLM 為 0.0360 美元),這個數字方便對照,卻綁著同樣的命中假設。實際採用時把同一件工作從開始到可交付的總用量記下來,分開輸入與輸出,再對上當時單價,才算得出屬於自己的節省。Windows 上想盯用量的人可以搭配DeepSeek API 用量監控工具的思路自建。
這篇公告最不尋常的地方,是官方連壓縮的副作用都自己量化了。研究團隊拿 Harvey LAB 的一個合約審閱任務做實驗:代理要讀四份法律文件,檢查仲裁條款是否符合仲裁機構規則,並寫出標註偏離項目、嚴重度與建議的報告,再把後訓練用的 LoRA 適配器強度從 0.25 倍一路拉到 8 倍。結果呈現一條清楚的取捨曲線:標準 1 倍強度下,Particle-1 用少 24.6% 的輸出寫完八份報告,全部通過兩位評審的所有條件,基礎模型通過率只有 62.5%,這也是全文唯一準確率明顯反超的地方;2 倍強度省 47.8%,開始有一兩份各漏掉單一條件;8 倍強度省 78.7%,八份只剩三份通過嚴格檢查。
換句話說,激進壓縮省掉的不只有冗餘分析,還包括有用的限定與說明。要注意這顆旋鈕目前拿不到:適配器強度只出現在研究文章裡,API 上的推理控制是 reasoning_effort 階梯(none 到 max、ultra,預設 high)加上可直通引擎的整數 effort(1 到 100,是強度刻度不是 token 預算),文件裡找不到 adapter 或 alpha 參數。
訓練方法本身也有幾個可核對的細節。獎勵函數同時看「任務是否解開」與「用了多少token」;任務集以 Harbor 格式自建,搭配名為 Datamaker 的合成資料系統;訓練分成兩個階段(Cascade RL),第一階段只練 coding,就已經讓資料工程任務的用量下降約 20%,第二階段才把重心轉向資料工程;訓練基礎設施用 RadixArk 的開源 RL 框架 Miles;實際調整的是覆蓋全部層專家的 rank-64 LoRA,可訓練參數約當模型的 1.25%,最佳化方法用序列級的 GSPO。這條路線對中小團隊的意義在於:在開放權重的基礎模型上,用很小比例的參數做後訓練就能改變用量行為,不過 Particle-1 本身的權重並未開放,想重現只能走它的 API。
模型目錄列出的硬限制一目瞭然:上下文 1,048,576 tokens(提示與生成合計);請求未指定輸出限制時預設上限 32,000 tokens,明確要求的上限再高也會被夾到 131,072。輸入接受文字與圖片、輸出只有文字,圖片單張上限 16 MiB、合計 100 MiB,私有網路位址、本機路徑、純 HTTP、音訊與影片輸入一律以 400 錯誤拒絕。工具呼叫支援 OpenAI 規格的 tools 與 tool_choice;結構化輸出則明寫「未宣稱支援」,json_object 可用、json_schema 會照轉,但沒有 schema 保證路徑,流程若依賴固定欄位,解析與驗證要自己保留。
資料面是這家公司的另一個賣點:推理流量採零資料保留,提示與回應只在記憶體內處理、不落地;用量紀錄只含每請求的token數、模型、金鑰歸屬與成本,沒有內容;上傳檔案保存到刪除為止、綁定單一金鑰、不用於訓練;前綴快取是短暫的效能快取,不會外傳;WebSocket 串流介面明確拒絕持久化儲存選項,連線中斷後對話紀錄不保留,需要恢復機制的應用得自存工作狀態。對要把程式碼送進模型的企業來說,這幾條寫進文件承諾,比行銷頁的口號可用。
計費面也有幾條文件寫清楚、新聞稿通常不提的規則。輸出按「模型生成的一切」計費,推理token包含在輸出價裡、沒有另立名目,這對一個以推理文字為主要節省來源的模型特別實際;輸入是提示扣掉快取前綴後的部分,快取前綴走較低的快取價。帳務走預儲值,餘額歸零時請求會直接回 402、不處理也不收費,可開自動儲值。另外有一個 Flex 服務層:願意讓工作在忙碌時段排隊的請求,token價格打對折,事後可用回應標頭確認該次跑在哪一層;託管網頁搜尋按每千次搜尋另外計費,空結果照收,且不適用 Flex 折扣。推理控制上,三款模型預設都是 high,Particle-1 與 DeepSeek 可用 reasoning_effort 設 none 關掉思考,GLM 5.3 Flash 則沒有關閉選項。
現在就能做的:在 Particle 平台申請 API 金鑰直接接(OpenAI 相容介面,模型 ID 為 particle-ai/particle-1),或從 OpenRouter 呼叫同一個模型,後者也方便放進既有的模型路由器做 A/B 對照;文件另提供 LiteLLM 整合頁,團隊現有的閘道設定可以照搬。對照時沿用公告自己的方法學最不容易踩坑:固定任務、固定驗收條件、把失敗重試的成本一起算,讀法可以參考AI 代理評測的兩軸讀法,品質與交件分開看。
還不確定的部分也要說清楚:公告提過法律與資安領域有早期跡象、其他領域要等後續版本,時間未定;價格已經在兩個官方表面之間不一致,日後調整不意外;文件沒有提繁體中文或任何語言涵蓋的保證;服務上線才兩天,穩定性與服務水準尚無紀錄可查。這幾項就是採用前值得回查的清單,價格與模型清單以官方目錄與 OpenRouter 頁面為準。
回到開頭的判斷。Particle-1 把「用更少token把事做完」寫進訓練目標,連失敗成本與壓縮副作用都攤在公告裡,這讓它的省費主張比一般發布扎實;但「平均少用約 45% token」是被評測條件框住的數字,能不能變成你帳單上的省費,取決於你帶進去的任務有沒有可以核對的終點,以及你願意留下多少收尾說明。任務有測試與驗收清單、工作以短輸入長推理為主的團隊,最有可能先把這 45% 換成真錢;工作以大量新輸入進場、或交付需要完整推理紀錄的團隊,先跑一輪自己的對照再決定,會比直接換模型穩。