TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

小米於 9 月 22 日發布 MiMo-V2.6 系列,Pro 在 AutomationBench 等代理評測擠進 Claude Opus 5 與 GPT-5.6 Sol 同一區間,程式與資安多項仍落後;三份權重走 MIT 授權,技術報告一併公開約 350 萬美元的 RL 訓練帳目與 7,000 個訓練環境。
用 AI 摘要這篇文章:
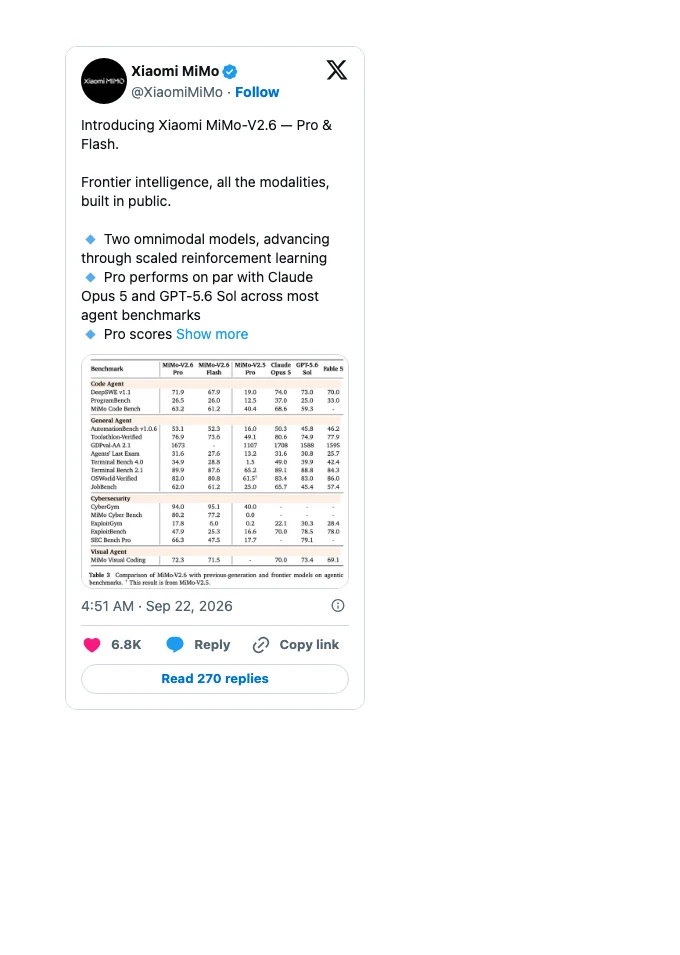
小米 MiMo 團隊在 2026 年 9 月 22 日清晨(台北時間 4 點 51 分)於 X 官方宣布 MiMo-V2.6 系列,一次推出 Pro、Flash 兩個開放權重模型,外加只在 API 提供的 Pro-UltraSpeed。官方貼文的開頭把重點講得很白:全模態、走規模化強化學習,Pro 在多數代理評測與 Claude Opus 5、GPT-5.6 Sol 同級。這句「同級」經得起核對,但要兩面一起讀:自動化代理項目確實擠進第一區間,程式與資安多項仍明顯落後。而這次發布真正少見的地方在別處,官方把約 350 萬美元等級的強化學習訓練帳目、失敗紀錄與約 7,000 個訓練環境一起公開,三份權重全走 MIT 授權。
先把時間軸釘穩。Hugging Face 上的 Pro 與 Flash 權重早在 9 月 21 日 15:39 UTC 就上傳,9B 蒸餾版晚兩個多小時跟進,OpenRouter 在 20:07 UTC 上架三個模型,X 官方貼文落在 20:51 UTC,官方更新日誌記載的發布日是 9 月 22 日。也就是說,權重比官方宣布早了五個多小時就放在那裡。
MiMo-V2.6 的架構是稀疏混合專家(MoE)。Pro 的總參數 1.02 兆、每次推理啟動 420 億;Flash 是 3,090 億與 150 億。兩個模型都能吃文字、圖片、影片與音訊,上下文視窗 100 萬 token,視覺端用 681M 參數的自家 ViT,音訊端是 308M 的 AudioTokenizer 加 127M 的 patch 編碼器,輸出端另有 5 層投機解碼器加速生成。
「全模態」四個字容易讓人期待過頭,模型卡寫的其實是輸入側的全模態:它能讀懂四種內容,但輸出只有文字。想拿它生成圖片、影片或語音,現在都做不到,那是另一批模型的工作。對要把它接進代理工作流的團隊,這個邊界反而單純:輸入什麼都行,產出就是文字與工具呼叫。
上下文 100 萬 token 是書面規格,實際長文件檢索與多輪工具往返的穩定度,模型卡不背書,要用自己的工作負載測。
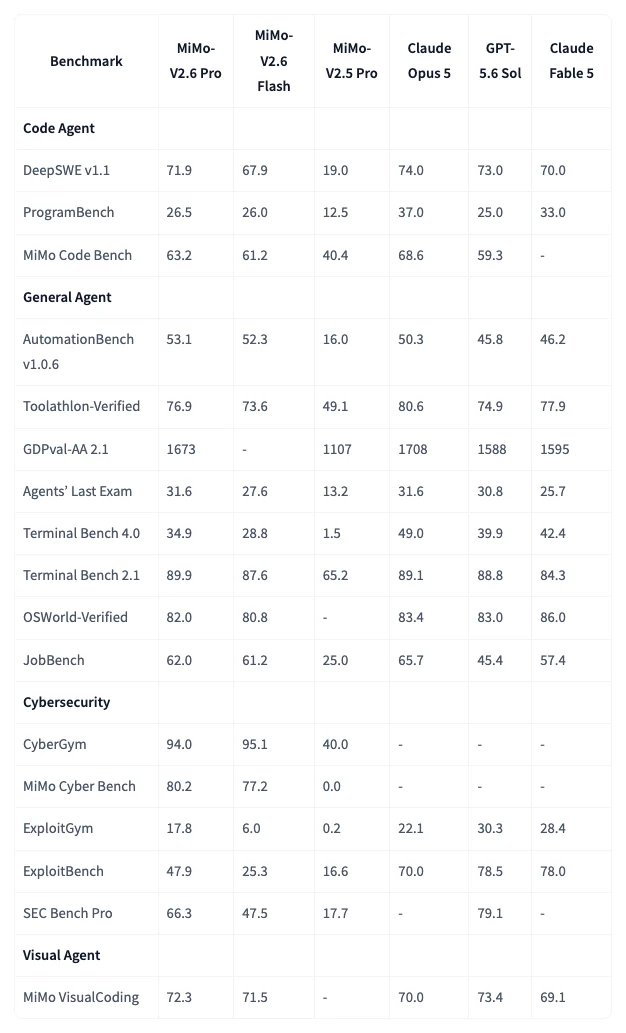
官方比較表把 MiMo-V2.6 Pro、Flash、前代 V2.5 Pro 與 Claude Opus 5、GPT-5.6 Sol、Claude Fable 5 並列,所有可調推理強度的對照模型都設在最高檔,這個設定官方在技術報告的表下註明。節錄重點如下:
| 評測項目 | Pro | Flash | V2.5 Pro | Opus 5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|---|---|
| AutomationBench v1.0.6(辦公流程自動化) | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Terminal Bench 2.1(終端機任務) | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Agents’ Last Exam(代理綜合) | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| OSWorld-Verified(桌面操作) | 82.0 | 80.8 | – | 83.4 | 83.0 | 86.0 |
| JobBench(知識工作) | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| DeepSWE v1.1(軟體工程) | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| ProgramBench(程式重建) | 26.5 | 26.0 | 12.5 | 37.0 | 25.0 | 33.0 |
| Terminal Bench 4.0(進階終端機) | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| ExploitBench(資安利用) | 47.9 | 25.3 | 16.6 | 70.0 | 78.5 | 78.0 |
| SEC Bench Pro(漏洞重現) | 66.3 | 47.5 | 17.7 | – | 79.1 | – |
高於全部對照模型的項目有兩個:AutomationBench 的 53.1,以及 Terminal Bench 2.1 的 89.9;Agents’ Last Exam 與 Opus 5 同分。介於中間的項目各有歸屬:專業知識工作的 GDPval-AA 拿 1,673,高於 Sol 的 1,588 與 Fable 5 的 1,595,仍低於 Opus 5 的 1,708;JobBench 62.0 高於 Sol 的 45.4 與 Fable 5 的 57.4,低於 Opus 5 的 65.7;OSWorld 桌面操作 82.0 與 Opus 5 的 83.4、Sol 的 83.0 都在誤差距離內,Fable 5 的 86.0 則明顯在前。往下看落差也很具體:DeepSWE 71.9 對 Opus 5 的 74.0,ProgramBench 26.5 對 37.0,Terminal Bench 4.0 的 34.9 對 49.0,資安類的差距最大,ExploitBench 47.9 對 Sol 的 78.5,SEC Bench Pro 66.3 對 79.1。所以官方那句「多數代理評測同級」是仔細挑過的說法,自動化與終端機基礎任務確實到了那個區間,複雜終端機與資安利用還有一段路。
跟前代比起來,這一版的進步幅度才是新聞本體。V2.5 Pro 今年 4 月 23 日發布,當時小米定位是代理場景媲美 Claude Opus 4.6;五個月後的這張表裡,AutomationBench 從 16.0 到 53.1,DeepSWE 從 19.0 到 71.9,CyberGym 從 40.0 到 94.0,MiMo Cyber Bench 從 0.0 到 80.2,Terminal Bench 4.0 從 1.5 到 34.9。幾乎每一項都是數倍級的跳升,這也是官方敢把對照欄直接換成 Opus 5 與 Sol 的原因。
表裡有三個項目要特別標註:MiMo Code Bench、MiMo Cyber Bench 與 MiMo VisualCoding 是小米內部評測集,外界拿不到題目,無法獨立重現,分數參考價值比公開評測低一級。另外 Flash 在 CyberGym 反而以 95.1 高過 Pro 的 94.0,小模型不見得每項都輸。
Artificial Analysis 在發布當天就把 MiMo-V2.6 Pro 排進獨立評測。Intelligence Index v4.3.2 給它 46 分,這個綜合指數涵蓋十項評測。排名要看清楚口徑:AA 的模型頁標的是同級比較第一名,那個「級」是開放權重、總參數大於 1,500 億的模型,共 114 個。它的比較摘要寫得客氣:「智慧表現居前、與同級開放權重模型相比價格合理,速度顯著快,但輸出偏冗長」。閉源前沿模型不在這一級裡,46 分也不該解讀成超越 Claude 或 GPT。
速度那欄有實測數字:基於小米 API 的輸出速度是每秒 124.5 個 token,同級開放權重模型的中位數是 74.8。時間到第一個 token 2.34 秒,與同級中位數 2.33 秒基本持平。冗長度是代價,跑完整套 Intelligence Index 用掉 1.4 億個輸出 token,與同級中位數持平,AA 給的評語是 somewhat verbose,這些都是 9 月 22 日的讀值。對按 token 計費的使用者,話多就是帳單長,這點在下面的價格段一起算。
小米開放平台的海外隨用隨付價(美元,每百萬 token,定價頁更新時間 9 月 21 日):
| 模型 | 快取命中輸入 | 輸入 | 輸出 |
|---|---|---|---|
| mimo-v2.6-pro | $0.0036 | $0.435 | $0.87 |
| mimo-v2.6-flash | $0.0028 | $0.14 | $0.28 |
| mimo-v2.6-pro-ultraspeed | $0.036 | $4.35 | $8.70 |
三層結構一目了然。Flash 的輸入輸出約為 Pro 的三分之一,官方表格裡 Flash 在多數日常代理項目與 Pro 差距只有幾個百分點,高頻呼叫的工作負載幾乎沒有理由不從 Flash 開始。批次 API 再打對折,Pro 與 Flash 都適用,不急著要結果的離線任務成本再省一半。UltraSpeed 是另一門生意:十倍於 Pro 的單價,買的是原廠宣稱的「最高 20 倍速度」,它不支援批次 API,Hugging Face 上也沒有它的權重,延遲敏感的即時場景才用得上。
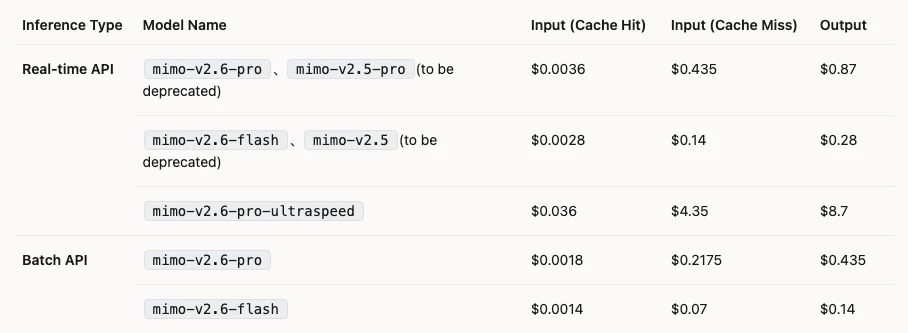
定價頁上有兩件事寫了但容易漏掉。其一是價格:v2.6 從 v2.5 原封沿襲,表上 v2.6-pro 與待除役的 v2.5-pro 列在同一行同一價,談不上降價。其二是除役時程:mimo-v2.5-pro 與 mimo-v2.5 將在 2026 年 10 月 21 日上午 10 點(北京時間)正式除役,還在用前代的團隊有一個月的遷移期。中國境內另以人民幣計價(Pro 為 ¥3/¥6),快取寫入限時免費,網頁搜尋外掛海外每千次 5 美元另計。
串接管道目前有:小米開放平台的 OpenAI 相容 API、AI Studio 線上試用、MiMo Desktop 與 MiMo Code 桌面產品,以及 OpenRouter。OpenRouter 上架的三個模型價格與小米海外牌價完全相同,沒有加價,對已經把閘道接好的團隊等於零改動就能試。
多數模型發布給你一張成績單,這次小米給的是整本帳。技術報告第四章寫明:Pro 的強化學習後訓練花費 260 萬美元,Flash 是 90 萬美元。訓練批次每步 1,568 個提示、每個提示 16 條 rollout,合計約 2.5 萬條軌跡、27 億到 37 億個 token。成本拆分也攤開:rollout 佔 43.8%、訓練佔 43.5%、評分器佔 12.7%。這種等級的透明度在閉源前沿實驗室那邊通常連提都不提,官方部落格的標語「built in public」至少在帳目層面兌現了。
更少見的是失敗紀錄。報告第五章第五節列出訓練中斷的原因:GPU 記憶體雙位元錯誤是主要基礎設施故障;Flash 因 Kubernetes 故障在 Cyber 任務叢集上重啟過一次;Pro 因評分器網路斷線在第十四步後重啟。工程決策也有交代,凍結路由器讓專家負載在整個 RL 過程保持穩定,這段有圖有對照組;Pro 那輪訓練前後跑了約 123 小時。訓練方法上,小米把這套取名「You Only RL Once」:程式、通用代理、視覺、資安四類任務混進同一輪強化學習,任務混合比例是程式 68%、工具使用 12%、美學設計 13%、上下文遵循 3%、資安 4%。評分機制是報告裡最有意思的一段:傳統的通過或失敗訊號分不出兩個都通過測試的解法哪個更好,MiMo 在每組 16 條 rollout 之間另加代理評分器,離線先從成對對照的解法歸納出各任務的評分規則,線上再把優勢權重往品質較高的路徑移,模型因此學到用更少的步數與 token 完成任務,而不是只把答對率推高。
跟著作為開放內容一起釋出的還有:約 7,000 個 RL 訓練環境(程式 3k、資安 1k、通用 1k、視覺 2k,外加約 1k 音樂生成)、端到端 RL 訓練框架,以及訓練動態的執行紀錄。小米自己在部落格把這次發布定位成探索 RSI 路徑的一步;RSI(自我改進式智慧)這個詞最近的討論脈絡,可以對照 Google 的 Dream-RSI 研究與 Anthropic 執行長談放慢前沿 AI的長文。小米沒有宣稱已經做到 RSI,模型仍在設計好的環境、評分器與訓練流程裡更新,這個分寸拿捏得比多數行銷文案準確。
開放權重不等於一般電腦能跑,這次的硬體門檻寫得很明白。Pro 的權重下載量約 0.57 TB,官方 SGLang 部署範例用兩台節點、全域 16 路張量平行加 16 路專家平行,等於每台八卡 GPU 機器;Flash 約 0.18 TB,單機八卡。想在消費級電腦上碰這個系列,現實的入口是 9B 蒸餾版。
MiMo-V2.6-Distill-Qwen-9B 的基礎模型是 Qwen3.5-9B,用 MiMo 產生的 774 億 token 資料(其中 272 億計入損失)做監督式微調,權重僅約 20 GB,MIT 授權。技術報告的表格顯示,這個 9B 模型再經領域強化學習後,11 項評測全數進步,例如 Terminal Bench 2.1 從 37.1 到 52.8,MiMo Cyber Bench(mini)從 31.3 到 47.0。另一組程式實驗在四種代理框架上共同訓練,再跨七種框架(其中三種訓練時沒見過)評三項程式評測,21 個組合全數進步;官方在藝術創作方向的內部音樂評測上,分數也從 45.7 提升到 52.5。蒸餾的意義在於把大模型摸索出的代理經驗換個容器裝,對研究代理強化學習的團隊,這份起點加 7,000 個環境與框架,是這次發布裡最能實際上手的組合。
授權面順便定位一下。三份權重都是 MIT,商用條件寬鬆,對照近期 Qwen-Image-2.1 從 Apache-2.0 轉向自訂研究授權的產業趨勢,小米這次選了保守但友善的一邊。「開放權重」的範圍也畫清楚:權重、RL 環境、訓練框架與訓練動態公開了,預訓練資料沒有隨權重釋出,所以自稱開放權重模型比自稱全開源來得誠實,官方文件也是這樣用詞。
UltraSpeed 的「最高 20 倍」是官方宣稱,比較基準沒有載明,也沒有第三方數字,把它當規格書看之前先當行銷句看。內部評測集無法重現,所有 MiMo 自家 benchmark 分數都屬於廠商自評等級,AA 的 46 分與排名則是 9 月 22 日的讀值,榜單會隨時間變動。至於台灣專屬的條款與資料落地安排,開放平台文件沒有特別載明,海外計價與 OpenRouter 管道都可用,但區域合規需求要自己向官方確認。
這次發布對不同讀者的意義很分流。要選代理模型的團隊,Flash 的價格與 AA 同級第一的位置值得放進候選清單跑自己的任務,程式與資安重的場景先看官方表的落後欄再決定。要研究訓練方法的人,技術報告、7,000 個環境、框架與 9B 蒸餾版是實質可重現的素材,這在開放權重社群近年收緊授權的背景下已不多見。已經在用 v2.5 的,記得 10 月 21 日的除役時限,價格不變的 v2.6 是平滑的遷移目標。