TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 發表 Gemini 4 Carbon,資安評測三項領先、AA 綜合指數第一,但先只開放給部分資安防禦團隊,API 優惠價每百萬 token 輸入 2 美元、輸出 10 美元,優惠結束後翻倍。本文核對官方公告與第三方榜單,整理誰先用、價格怎麼算、幻覺率上升怎麼讀。
用 AI 摘要這篇文章:
Google 在 2026 年 10 月 28 日(台北時間 29 日凌晨 1 點)於官方部落格發表 Gemini 4 Carbon,文章由 Google DeepMind 資深副總裁、Google 首席 AI 架構師 Koray Kavukcuoglu 掛名。官方給它的定位是下一個前沿模型,強調兩件事:最先進的資安能力,以及可以長時間推進的工程任務處理。但這次發表真正值得停下來看的,是分數之外的開放順序:這個模型本週起先交給一部分資安防禦團隊使用,之後經過 Fairwind Program 逐步擴大,開發者、企業與一般消費者的產品入口,公告只承諾「盡快」。換句話說,規格與價格現在都攤在檯面上,模型本身大多數人還拿不到。
Carbon 建立在 Gemini 4 Argon 之上。官方公告稱 Argon 是「兩週前發表」的模型;Argon 開放所有人使用的公告落在 10 月 13 日,兩週後再推一代,是 Google 目前推進前沿的節奏。先前 Argon 把一張照片變成 3D 場景的官方示範,可以搭配這篇逐幀整理看前一個世代實際交出的表現。
Google 這次把部署步調寫得相當明確。公告指出,公司正參與美國政府自願性的預發布模型測試機制,也就是模型在對外發布前,先經過政府端的測試這一關。接著開放順序分三步走:本週起 Carbon 先開放給一部分資安防禦團隊(cyber defenders),之後透過 Fairwind Program 分階段提供給更多可信任的合作夥伴,持續收集回饋、調整護欄,最後才是「盡快」透過產品入口提供給開發者、企業與消費者。把防禦團隊放在最前面,配合的是這次模型的主打能力:找漏洞與修補如果真的有效,先拿到的人就能先補自己的系統。
Fairwind Program 的官方頁面把這套邏輯講得更白:讓高優先度的防禦者比新威脅早一步用到先進模型。頁面開頭直說了風險假設,同樣的模型能力,在防禦方手裡是快速發現並修補漏洞的工具,落到攻擊方手裡就是同等強大的威脅。頁面載明目前全球有超過 650 個合作夥伴,優先開放的對象是政府與國家資安主管機關、關鍵基礎設施營運者、醫療與電信這類單位;用途限於防禦與研究,夥伴只能進行授權的威脅模擬、逆向工程與惡意軟體分析等任務,不得分享、轉售或再散布模型存取權,申請組織要通過背景審查,組織內部也只能把存取權交給資安、事件應變或滲透測試團隊並留存使用紀錄。一個細節是,Fairwind 頁面的技術段目前列的仍是 Gemini 4 Argon 與程式安全代理 CodeMender,Carbon 尚未出現在該頁,公告與頁面之間有一段落差,之後可以回來看它何時補上。
對台灣讀者來說,直接的答案暫時是「等」。公告沒有給消費端與開發者入口的開放日期,也沒有提及任何個別市場的方案資格。現在的訂閱方案上有 Gemini 品牌、先前能用 Argon,都不代表已經取得 Carbon;要等到自己的方案與入口明確列出這個模型,才算是真的用到。
公告的核心成績單是三個資安評測,分別對應防禦流程的三個階段:
| 評測 | Google 公布成績 | 對應的工作 |
|---|---|---|
| SEC-bench Pro | 88.2% | 在真實軟體中找出安全漏洞 |
| ExploitGym | 54.8% | 驗證漏洞實際可被利用 |
| CWE-bench | 71.0% | 從找到的問題寫出根本修補 |
這三個測驗的題目來源都不便宜。SEC-bench Pro 自我定位為會持續進化的資安基準,題目取自關鍵軟體系統裡的真實安全缺陷,V8、Firefox 這類瀏覽器引擎都在涵蓋範圍;ExploitGym 的題目來自使用者程式、Google 的 V8 引擎與 Linux 核心的真實漏洞,專門測代理能不能把找到的漏洞實際利用出來;CWE-bench 則測修補。找漏洞、驗證利用、修補成因是三件不同的工作,三個分數各記各的帳;防禦團隊要知道哪些漏洞真的有風險,靠的是中間那一步,找到的問題若無法被利用,修補的優先順序就可以往後排。
公告同時在括號裡寫明:這些外部評測是在沒有安全護欄的條件下執行的。安全護欄是限制濫用與不當操作的機制,正式服務會帶著護欄上線,所以這三個數字代表能力上限的證據,不能直接當成一般帳號可以執行的功能清單。
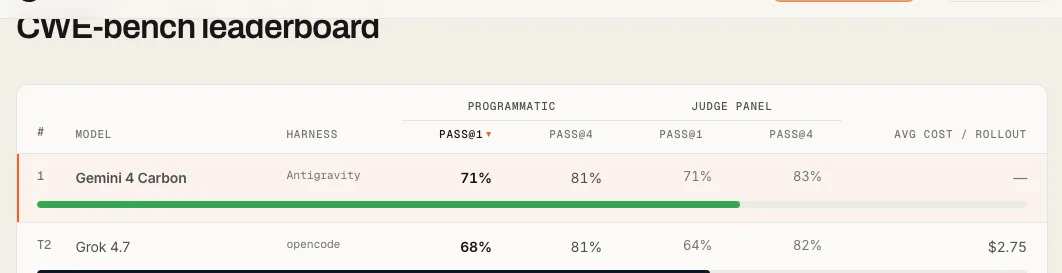
其中 CWE-bench 的公開榜單可以獨立核對。該測驗由 Collinear 維護,榜單目前把搭配 Antigravity 開發工具的 Gemini 4 Carbon 列在第 1 名,程式化驗證的單次通過率 71%,允許多次嘗試的欄位到 81%;第 2 名由三個組合以 68% 並列,榜單首列是搭配 opencode 的 Grok 4.7。榜單對分數的定義寫得很嚴格:每個任務的分數是通過確定性驗證器的比例,且既有測試必須全部照舊通過,等於修補不能修好一個漏洞、弄壞兩個功能。即便如此,它仍是 120 個限定任務上的表現,不能解讀成真實世界七成的漏洞都能交給它修。
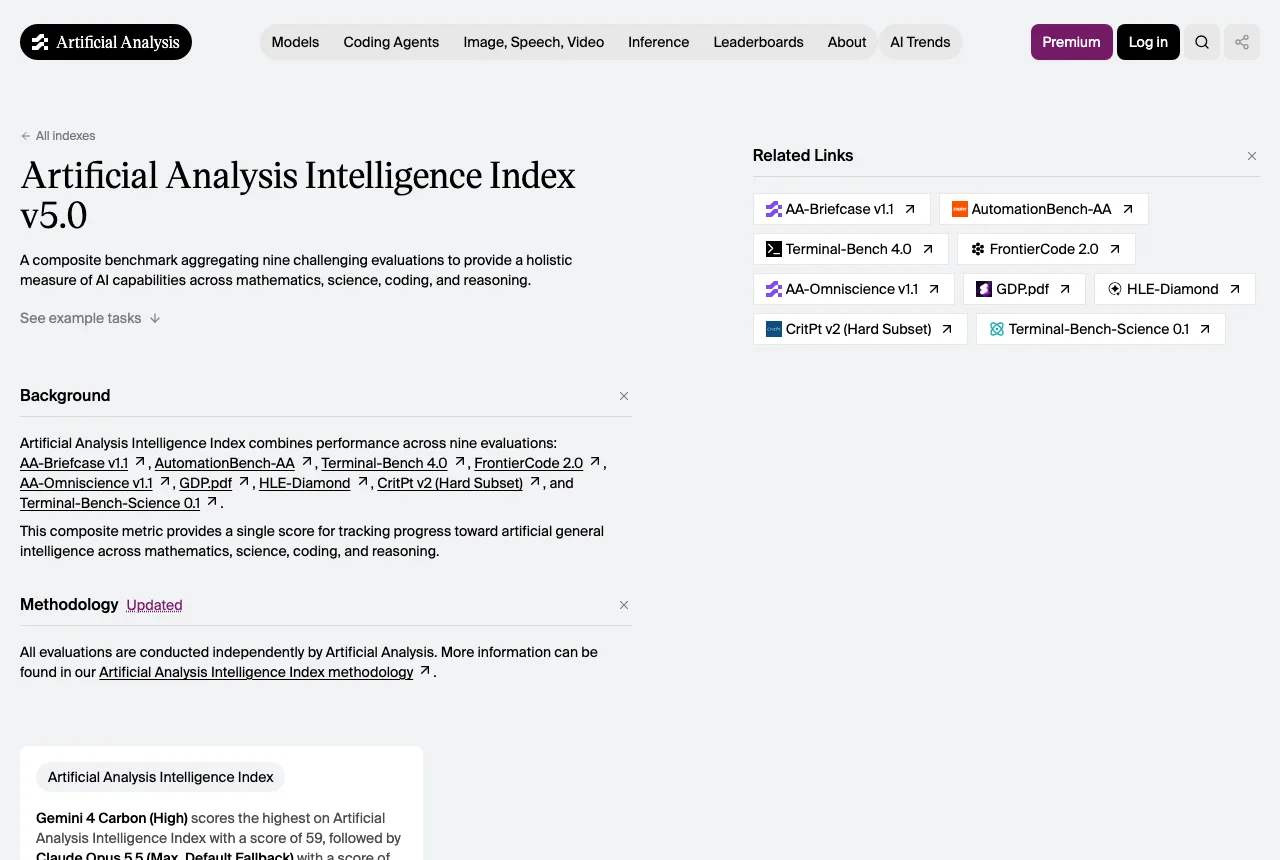
第三方評測機構 Artificial Analysis 的綜合指標給了 Carbon 第一名:在 10 月底剛更新到 v5.0 的 Intelligence Index 上,Carbon 拿 59 分,領先 Claude Opus 5.5 的 58 分與 GPT-6 Astra 的 57 分。這個指數由九項評測加權組成,涵蓋推理、寫程式、知識與多步驟代理任務;它是綜合分,不是正確率,59 分也不能換算成「答對率五成九」。第一名與第二名只差 1 分,這是特定榜單上的領先,不是斷層式的差距;OpenAI 10 月底剛推出的 GPT-6.1 Terra 也已經進榜(可參考先前對 GPT-6.1 Terra 上線與計價的整理),前十名的組成會隨新模型持續變動。
同一個機構的知識與幻覺評測(AA-Omniscience v1.1)則給出方向相反的訊號。Carbon 的答對率從 Argon 的 48% 升到 58%,但該測驗定義的幻覺率,也從 Argon 的 4% 升到 11%。榜單上的相對位置沒有變:Argon 是受測模型中最低的 4%,Carbon 的 11% 是第二低,第三名 Command A+ 為 14%。答對更多題,與答錯時更常選擇硬答,兩件事會同時發生;模型整體知識變強,不等於每一句輸出都更可靠。Google 自己在公告裡也有對應的內部說法:內部測試中缺乏依據的說法較 Argon 減少約一半,且模型會把方法學上的限制直接寫進交付成果,或在受阻時明確列出還缺什麼,而不是憑空補一段看起來完成的內容。兩個數字出自不同的測試體系,方向並不衝突,但都提醒同一件事:能力與可靠度是兩本帳,涉及引文查核、事實把關的工作,要用自己的題目驗收。
寫程式那一側也一樣要看清楚。綜合指數第一,不等於程式代理第一:在 Artificial Analysis 的程式代理指標上,前三名依序是 Claude Code 搭配 Claude Opus 5.5(61.7 分)、Devin Fusion(61.5 分)與 GitHub Copilot Fusion(59.9 分),Carbon 搭配 Antigravity CLI 以 59.4 分排在後面;公告自己引用的網頁開發競技場 WebDev Arena,Carbon 升 89 分積分後也只排在第 4 名。把「綜合第一」直接換寫成「寫程式最強」,這幾個榜單都不支持。
公告裡另一批數字談的是模型會不會「走捷徑」。在 Terminal-Bench 4.0 裡,Google 公布 Carbon 的成功作弊比例為 0.0%,嘗試作弊的比例降到 0.4%,且整體正確率同時提升;在 Gray Swan 的間接提示注入評測(外部文件夾帶指令、試圖改變模型原有行為的攻擊)中,Carbon 的攻擊成功率從 Argon 的 0.7% 降到 0.0%。內部的即時編碼環境裡,高嚴重度的行為不對齊警示減少近 80%;同系列內部測試的另一組指標顯示,越權行為減少 26%,該做而沒做的漏項減少 29%。
作弊比例對長任務的意義,比對單輪問答大得多。多步驟工程工作的中間結果會互相影響,模型若在某一輪把走不通的步驟寫成已完成,後面的決策就會建立在假前提上,人要接手時得整條鏈重查一遍;成功作弊壓到 0.0% 這個數字,針對的正是這種「交差式完成」的傾向。這批數字仍要放在同一個框架下讀:它們是 Google 的內部測試與指定評測結果,沒有第三方複核。0.0% 的意思是該評測涵蓋的攻擊嘗試全部被擋下,不是對所有未來攻擊方式的保證;提示注入防住了榜單上的題目,也不代表代理可以無限制地讀取任何外部文件。實際採用時,資料存取範圍、工具權限與重要變更的審查仍然要自己把關。
長任務的定位也是同一性質。公告說內部團隊看過 Carbon 連續運行數天,穿過死路完成多步驟工程任務,例如在大型程式庫與底層系統裡追查細微錯誤的根因並修補;這是公司內部觀察,沒有公開的任務細節、成功率或人工介入程度。對工程團隊來說,「跑得久」要換成可核對的交付才有意義:修改了哪些檔案、測試重跑的結果、哪些檢查因環境限制而沒有執行,這些才是把工作交出去前後對得上帳的證據。同段的內部比較還包括:生成安全程式碼的成功率達到 Argon 的 2 倍以上、Chrome 團隊稱其產出高品質修補比另一家實驗室的前沿模型好 10 倍以上、雲端安全平台 Wiz 觀察它在網頁滲透測試基準領先。Chrome 與 Wiz 都屬於 Google 體系,這些都是官方內部資料等級的宣稱,等模型真的進到產品入口,才有機會用自己的任務對帳。
API 計費公告分成兩個階段。推出時沿用與 Argon 相同的優惠價:輸入每百萬 token 2 美元、輸出每百萬 token 10 美元,符合快取條件的輸入單價再省 95%,推出期相當於每百萬 0.1 美元。公告的附註寫明:優惠期結束後,輸入與輸出單價調為 4 與 20 美元。優惠何時結束,公告沒有給日期。token 是模型計費與計量的單位,一段文字會先被切成 token 再送進模型,中文一個字大約對應一到兩個 token,長文件與反覆讀取的代理工作,帳單會比單輪問答高一個量級。
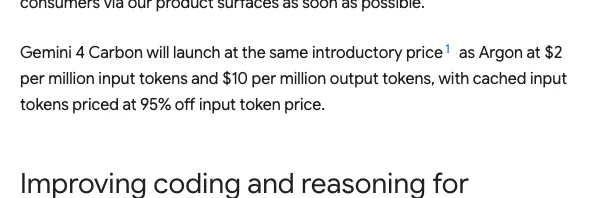
用一個純算術的例子換算:假設一次工作累積 100 萬個未快取輸入 token、10 萬個輸出 token,推出期費用是 2 加 1 等於 3 美元;優惠結束後變成 4 加 2 等於 6 美元,剛好翻倍。長任務會反覆讀取資料、重試與產出,規劃長期使用的預算時,直接用優惠後的價格估比較安全。Gemini 系列 API 先前把語音與推理拆開計價的脈絡,可參考先前對 Gemini 3.8 Live API 計費結構的整理。
截至發布當下,這些問題沒有答案:優惠價何時結束、開發者與消費者入口何時開放、台灣各方案有沒有資格、「連續運行數天」的任務內容與成功率、Terminal-Bench 上「整體正確率提升」的具體幅度。網路上流傳的 Carbon 程式代理「第二名」說法,也與 Artificial Analysis 頁面目前列出的榜單對不上,引用前值得自己再核一次。
可以盯著回查的節點有四個:Google API 定價頁何時列出 Carbon、Gemini App 的功能列表何時出現它、Fairwind 頁面的技術段何時從 Argon 換成 Carbon,以及 Artificial Analysis 頁面上那個 1 分差的榜首會不會易主。等模型真的進到自己常用的入口,再用同一套標準回來對帳:一件可回復的小任務、留下修改紀錄與測試證據,比追著榜單換模型更能回答它適不適合你的工作。