TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

GitHub 專案 instagram-agent-skill 用 13 個免費、MIT 授權的 Claude Skills 協助經營 Instagram:寫 Reel 腳本、貼文文案、輪播與留言回覆,上線 48 天累積 3,971 顆星。作者自測開場打分數程式擋掉刻意寫爛的開場達 AUC 0.83,挑出爆款的命中率卻只有 0.56。六支 Python 程式只用內建模組、零網路連線,每個 Skill 以可複製內容收尾,發文動作留給使用者,對應 Instagram 條款 4.2 的自動化紅線。
用 AI 摘要這篇文章:
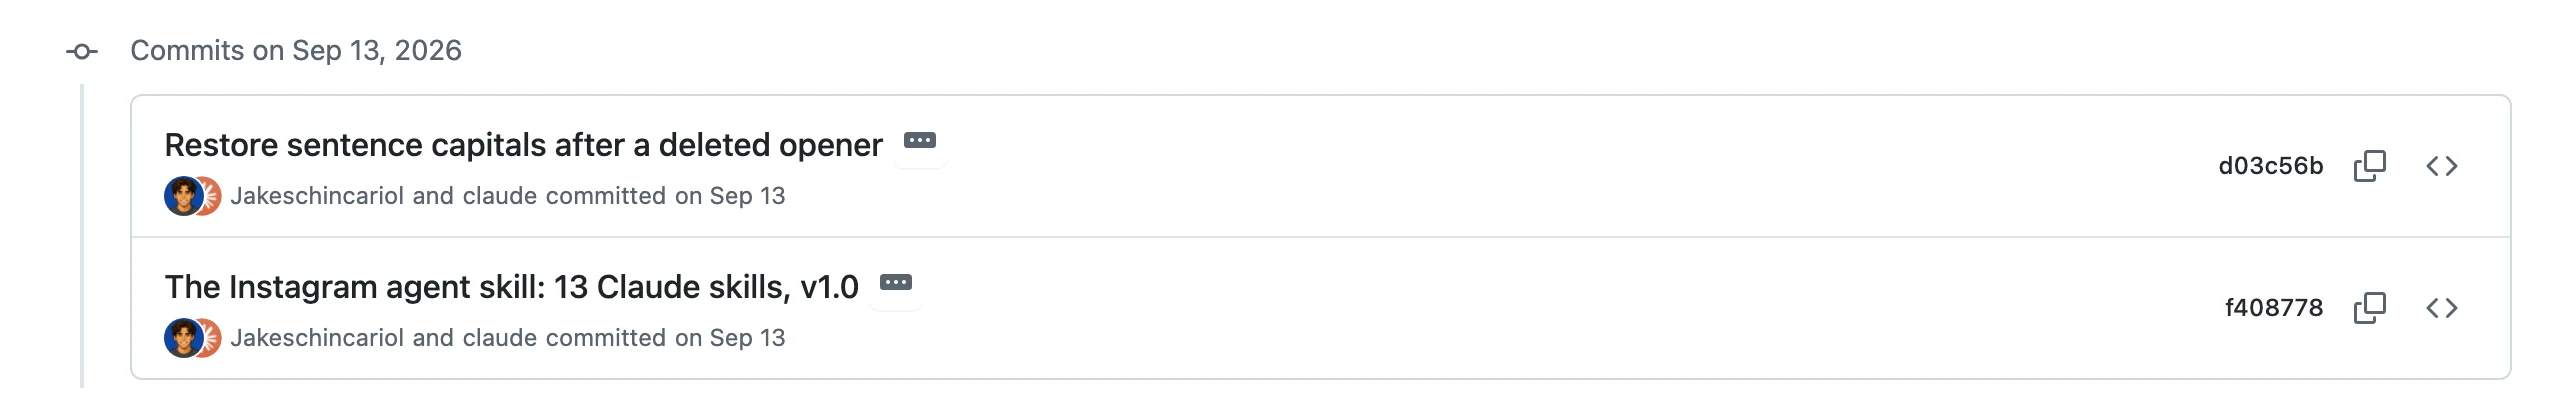
2026 年 9 月 13 日,一個叫 instagram-agent-skill 的 GitHub 專案推完它的兩個 commit,間隔只有 42 秒,之後程式碼就沒有再動過。48 天後的 10 月 31 日,它累積到 3,971 顆星、839 次 fork。這個專案做的事情一句話可以講完:13 個 Claude Skills,把寫 Reel 腳本、貼文文案、輪播、留言回覆這類文字工作接過去,免費、MIT 授權、不用註冊、不連任何服務。它真正值得花時間讀的有兩處:作者 Jake Schincariol 自己量出來的能力上限,以及整個專案刻意不碰你 Instagram 帳號的設計。

README 裡有一段標題就叫「我實際量到的,是最值得讀的部分」,這段也確實是整份文件的核心。作者用 74 條真實短影音開場當語料:五個頻道、每個頻道取表現最好與最差的各 8 支影片,抓自動字幕的前三秒,觀看數從 931 到 550,000。(這個取法的算術上限是 80 條,與實際的 74 條之間的差額,README 沒有交代。)語料來源是 YouTube Shorts 而非 Reels,理由寫得很明白:Instagram 不登入別人的帳號就拿不到可蒐集的觀看數,而爬資料會違反這個專案自己叫你別違反的條款。
量測結果是兩個方向不同的數字。對 10 條刻意寫爛的開場(打招呼、空泛開場這類),打分數程式分辨的 AUC 是 0.83,而且 10 條裡有 9 條被壓在真實語料的中位數以下。換成更難的題目,從同一位創作者的爆紅片與冷門片裡挑出爆紅片,AUC 只剩 0.56,而 0.50 等於擲硬幣。五項檢查裡只有具體度(SPECIFICITY)把兩個族群拉開了 60 分的中位數差距,另外兩項張力與稱呼(STAKES、ADDRESS)在兩個族群的中位數完全相同,等於在這份語料上量不到任何東西。
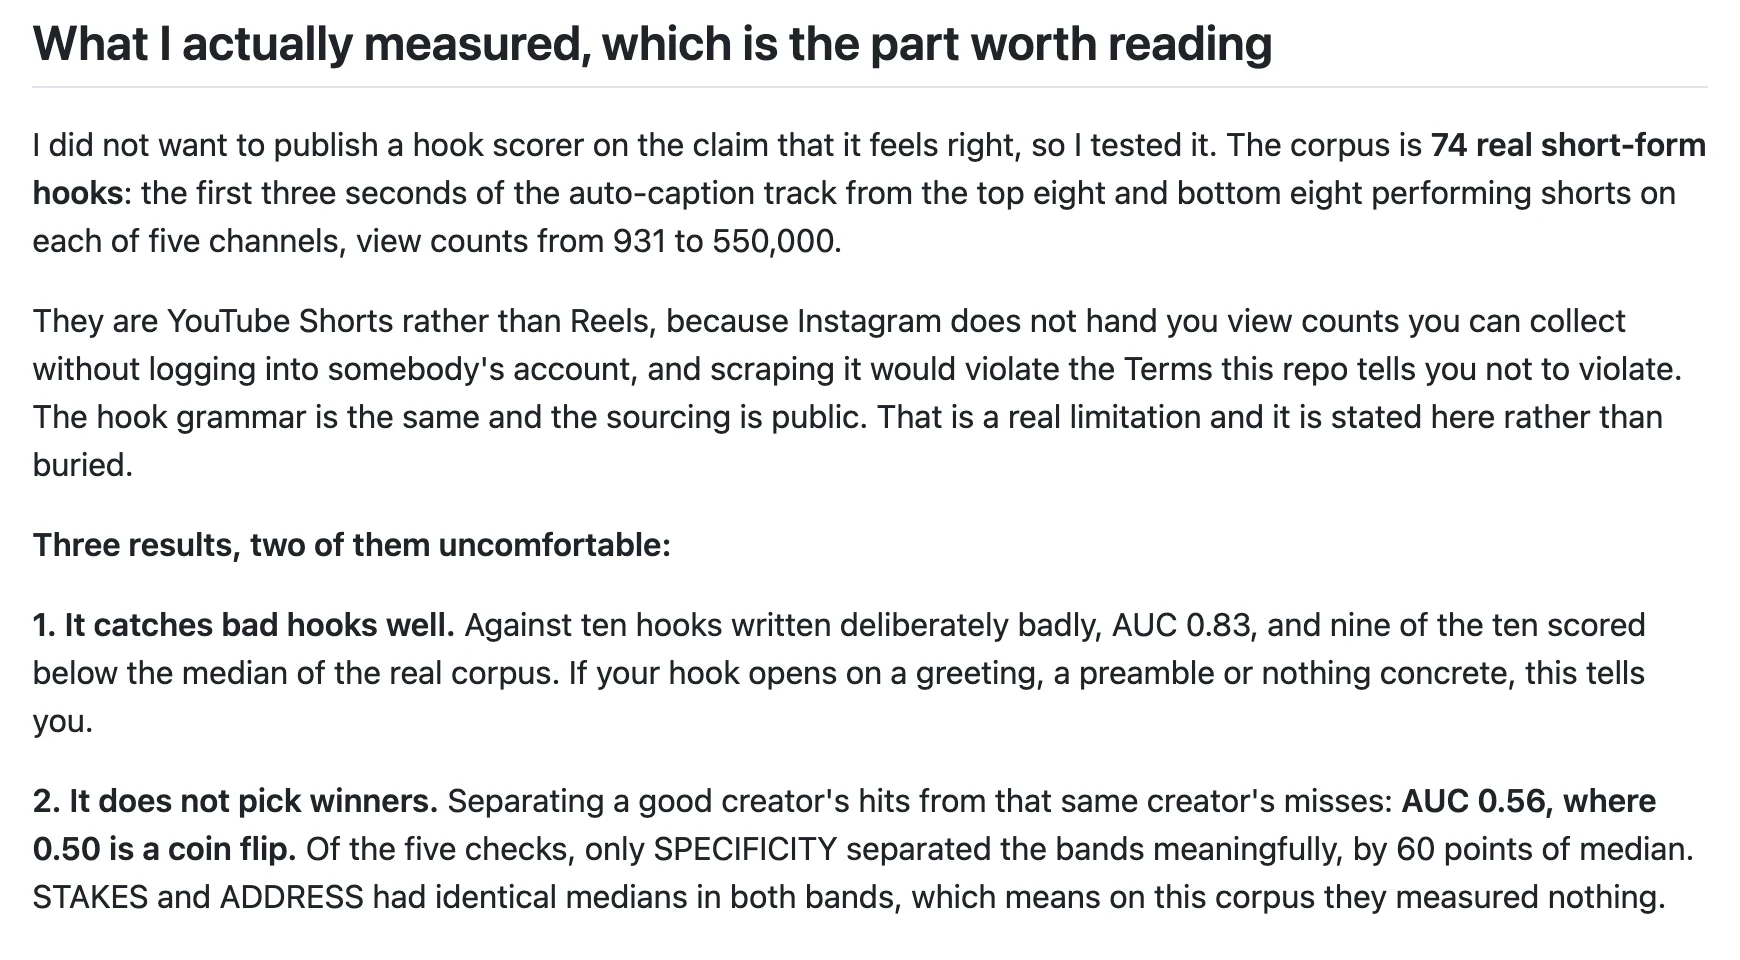
作者的結論間接轉述是:這種工具的正確用法是在開拍前刪掉明顯的爛開場,然後回去看自己的保留率曲線;讀文字的程式沒辦法告訴你兩個還不錯的開場哪個會紅,因為那由你的臉、你的剪輯、你的聲音,以及 Instagram 把影片推送給誰決定。
這段自測還順便抓出兩個程式缺陷。開場公式分類器最初只認得 8% 的真實開場,因為規則是照作者自己的範本寫的;對著真實轉文字稿改寫後升到 49%,剩下 51% 直接棄權不硬分。具體度檢查原本只數阿拉伯數字,所以「zero dollars」「three marketing books」這種把數字唸出來的說法會被當成沒有具體內容,後來才補上口語數字。這些結果都出自 README 的自述,量測腳本沒有放進專案裡(作者說它依賴 yt-dlp),方法寫在 /ig-viral 的說明檔,作者形容只有四行。要重現,得自己照方法再做一次。
13 個指令照 README 的表格整理如下;粗分起來,寫作五個、研究與規劃四個、互動三個、去 AI 味一個:
| 指令 | 做什麼 |
|---|---|
| /ig-reel | 一個想法變成 Reel:從 26 個開場公式出 3 個開場、打分數,再產出腳本、螢幕字與帶時間碼的分鏡 |
| /ig-caption | 寫貼文文案並檢查,顯示動態消息裡按展開前看得到的前段 |
| /ig-carousel | 輪播貼文:封面、每頁文案與 1080×1350 檔案 |
| /ig-story | 每日限時動態順序、每個貼圖的用途與接續的私訊流程 |
| /ig-repurpose | 把一支影片、Podcast 或電子報拆成一週的 Reels 與輪播 |
| /ig-viral | 找你領域正在紅的內容,以相對帳號自身中位數的倍數排序 |
| /ig-profile | 用 12 項標準給個人檔案打 100 分,照最痛的順序重寫 |
| /ig-plan | 排一週計畫:發什麼、格式、時間與要互動的帳號 |
| /ig-audit | 事後復盤,依倍數與每觸及分享排序 |
| /ig-comment | 替別人的貼文寫留言,九種類型依內容選 |
| /ig-reply | 自己貼文下的留言串分六類依序回 |
| /ig-dm | 關鍵字發送、第一則訊息、合作邀約與兩則跟進 |
| /ig-human | 清掉 AI 慣用字詞與隱形字元,五項檢查打分數 |
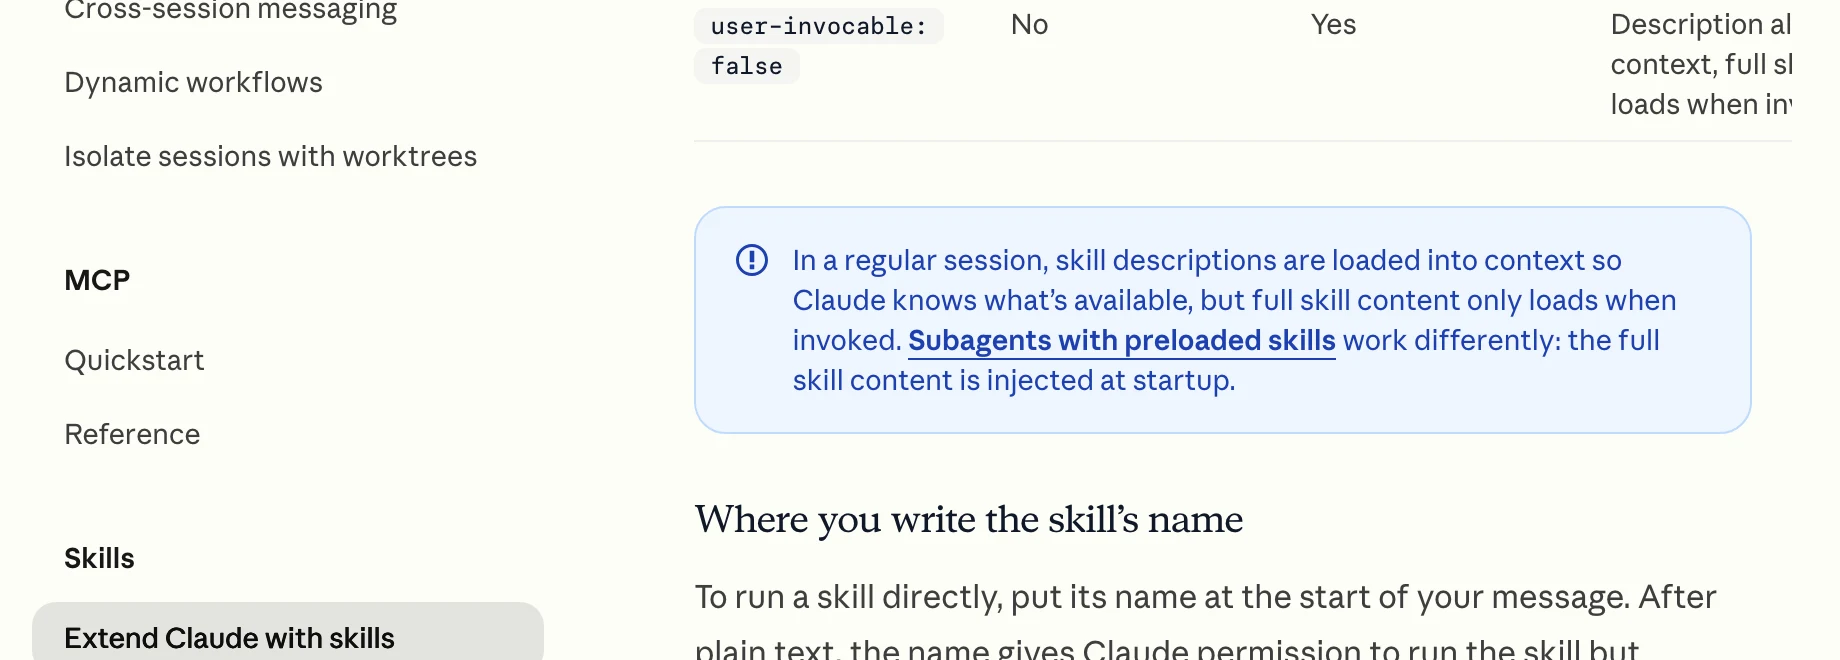
Skill 是 Claude Code 的一種擴充形式:一個資料夾放一份 SKILL.md 說明檔,可以再帶其他檔案。官方文件寫得清楚:一般對話中只有各個 Skill 的描述會先載入對話,讓 Claude 知道有哪些可用,完整內容要等被呼叫才載入。這代表裝 13 個 Skill 不會把 13 份文件常駐在對話裡。站內先前介紹過另一個同類型的開源研究 Skill /last30days,有興趣比較 Skill 生態的樣貌可以參考。
安裝有三條路:把專案網址直接貼給 Claude 請它裝;自己 git clone 後把 skills/ig-* 資料夾複製到 ~/.claude/skills/;或用外掛市集指令安裝。完全沒有 Claude Code 的話,把單一 SKILL.md 貼在對話最前面也能當模式用,但會失去那些 Python 工具,README 形容那是 /ig-reel 與 /ig-human 的大半重點。另外有個前置動作常被跳過:templates/voice.md 要先填,每個 Skill 都會讀這份聲音檔。
README 說這些工具「沒有外部套件、不連網路、不上傳任何東西」。對照原始碼,這句話成立:六支 Python 程式的 import 只有 argparse、json、os、re、statistics、sys、textwrap、unicodedata 這些內建模組,沒有任何網路相關的函式庫,程式只讀你指定的本機檔案。
六支程式各自做一件事。hookscore.py 給開場打分數,五個面向是長度、具體度、張力、前置、稱呼,並列出致命問題(例如以打招呼開場)。beats.py 用每分鐘 165 個英文詞的語速把腳本排成時間表,標出四種問題:開場超過 3 秒、單段過長、連續沒有具體內容、沒有回接到第一句。caption.py 預覽動態消息實際看得到的前段並檢查文案。humanize.py 做三趟清理:隱形字元、排版符號、154 個慣用詞的替換。detect.py 給五項分數。swipe.py 把你自己收集的內容依相對帳號中位數的倍數排序。README 標題寫「五個實際會跑的工具」,檔案清單卻列了六支,出入在於去 AI 味那組把 humanize 與 detect 兩支算成一個工具。
對中文使用者有一件事必須先講:hookscore.py 的斷詞規則只由英文字母、數字與幾個標點符號組成,detect.py 更只認英文字母,中文字元在計詞階段整行被略過。純中文的開場在長度檢查會被算成 0 個詞,直接落進最重的扣分區。這是從原始碼規則推出來的行為,實際跑中文稿之前別把分數當參考;英文稿、中英混雜的腳本才在它的設計範圍裡。
整個專案裡最鮮明的一條設計線,是它把「不代替你接觸 Instagram」寫成原則。README 開頭就一句:「在你說好之前,什麼都不會發出去。這些 Skill 負責寫,你負責發。」每個 Skill 的產出都以一個可複製的區塊收尾,貼文這個動作留給你。
這條線對應的是 Instagram 使用條款 4.2 的明文:不得以未經授權的方式建立帳號、存取或蒐集資訊,包括未經 Instagram 明示許可以自動化方式存取或蒐集,無論當下是否登入帳號。README 對此的說法是:真正合法的自動發文管道是給專業帳號用的 Content Publishing API,而那需要 Meta 開發者應用程式、連動的粉絲專頁、長效權杖與應用審查,不是一個 Skill 能替你辦到的;市面上其他自動化發文、留言、追蹤、私訊的做法,走的是瀏覽器自動化或第三方工具,兩種都違反條款,代價是帳號被限制行動。站內先前實測過的 Instagram 下載器,碰的也是同一條條款的牆。
兩個例外與一條但書寫得也算誠實。私訊的關鍵字自動回覆是 Instagram 官方自己支援的功能,而且只在對方先留言之後才觸發,/ig-dm 標出了這條線在哪。研究流用的 /ig-viral 則明言「讀,不爬」:10 個帳號、每個帳號約 12 支內容、以人的速度、用你自己的瀏覽器看,不要求密碼、不以你的身分登入。排序的基準是相對自身中位數的倍數,3 倍以上算訊號、1.5 倍以下算平常日,200 萬追蹤者做 40 萬觀看與 4 千追蹤者做 40 萬觀看,在這套算法裡是兩回事。
作者自己說 /ig-human 是「讓其他十二個用得下去的原因」。它處理的東西分三層:零寬空格、軟連字號這類複製貼上後仍不可見的隱形字元;破折號、彎引號等排版符號;以及 slop.json 裡 154 個慣用詞的替換(檔案實際數了 96 個詞加 58 個片語,另有 18 類隱形字元與 16 個結構訊號,數量與 README 相符)。改不了句子形狀的部分只標記出來還給你改,例如三連排比、表情符號條列、整齊劃一的句長。
但要把它當成「躲偵測」工具就讀錯了。README 講明五項檢查是本機的啟發式規則,參考公開偵測器在看哪些訊號,本質上與 GPTZero、Originality 這類服務互不相通,也無從保證它們會給出同樣的判定;任何人宣稱「保證測不到」都是在賣東西。隱形字元的清理也只針對確實存在於生成文字的零寬與格式字元,不宣稱能破解加密浮水印。站內先前的 Pangram 4.1 報導提過商用偵測分數從單一數字改成區間的走向,對照來看,這種本機規則分數與商用偵測器的關係是「量類似的東西,不是同一把尺」。免費的去 AI 味網路工具先前也實測過,那條路已經斷線,本地腳本反而是現在還能用的一條。
caption.py 裡寫死三個常數:文案全長上限 2,200 字元、動態消息可見視窗 125 字元、標籤上限 5 個。其中 125 這個數字,程式自己的註解就承認是近似值,實際切點會隨裝置、字體與斷行漂移,所以拿它當餘量參考,不要把文案精算到剛好 125。
標籤從 30 降到 5 這件事有第三方時間錨:Social Media Today 在 2025 年 12 月 18 日的報導,Instagram 宣佈將標籤上限逐步更新為每則貼文與 Reel 5 個,並引用 Instagram 的說法,用更少(最多 5 個)但更精準的標籤,能改善內容表現與使用體驗。caption.py 註解裡引的正是同一段文字,出處標註為 Instagram 的 @Creators 帳號。這個數字的層級因此是媒體轉述官方帳號,加上程式碼註解的引用。README 結尾的提醒比數字本身更有用:平台規則會過期,如果專案內容與你讀到當下 Instagram 的做法矛盾,以 Instagram 為準。
人氣帳本之外還有一本維護帳本。這個專案的全部歷史是 9 月 13 日當天的兩個 commit(第二個是修「刪掉開場後句子開頭沒恢復大寫」的問題),沒有任何發佈版本、沒有標籤,截至 10 月 31 日,累積有 24 個 issue 與 9 個 pull request 未處理。星數證明它被很多人看到,證明不了它會被繼續修。
同一作者還有一個姊妹專案 linkedin-agent-skill,做法相同、平台換成 LinkedIn,而且時間上更早:2026 年 9 月 7 日建立,比 Instagram 版早六天,11 個 Skill、2,959 顆星。作者的網站 opusjake.ai 標語是「為你打造 AI 代理,並教會你用」,接案建代理與教學是主業,這個免費專案比較像方法論的展示櫃。
所以實際的取用姿勢是:把它當可拆解的樣板,別把它當有維護承諾的產品。MIT 授權允許整包搬走自己改;slop.json 本來就設計成要編輯的;hookscore 對中文失效的斷詞規則原始碼就攤在那裡,能改,但詞數滿分區間與秒數換算都是照英文口語設計的,改完得重新校一輪,這大概是把它當樣板的真正意思。裝之前先填 voice.md,裝之後每個數字(標籤上限、可見視窗、公式分類)都自己對照一次平台現況。至於效果期待,作者已經替你量好了:它擋得住爛開場,挑不出贏家,會紅的那一個永遠要靠你自己發出去試。