TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

ElevenLabs 於 2026 年 10 月 20 日推出 Eleven Realtime 的 Mini 與 Max 兩款即時語音代理模型,接收語音也以語音回應。官方文件明說底層是多模型串接、整體調校;對照 Artificial Analysis 獨立排行榜,Max 的推理與首音屬前段班但任務完成率落後 Grok Voice 3.0 與 Gemini 3.8 Live。切換前還要看清三道界線:直接介面只支援 WebSocket、部分設定改由官方託管、Mini 與 Max 的合規與資料駐留環境互有缺口。
用 AI 摘要這篇文章:
ElevenLabs 在 2026 年 10 月 20 日推出 Eleven Realtime,一次上架兩款即時語音代理模型:v1 Mini 與 v1 Max。發布文章的時間戳是當天晚間 8 時(台北時間),官方社群帳號在晚間 10 時 25 分跟進宣傳。兩款模型接收使用者的語音,也直接以語音回應,官方把它定位成「語音到語音」的新模型類別,支援超過 90 種語言,並能使用聲音庫裡一萬七千多種聲音(這兩個數字是廠商公布值,自己的中文場景仍要實際聽過再說)。
即時語音代理這個賽道最近很擠:SpaceXAI 的 Grok Voice 3.0、Google 的 Gemini 3.8 Live、OpenAI 的 GPT-Live-1 系列都在搶「電話接得快、事情辦得完」這兩個承諾。ElevenLabs 這次進場的姿勢不太一樣:它先宣布與 OpenAI Realtime 的事件協定相容,已經用 OpenAI SDK 寫好的程式只要改端點和模型名稱就能接過來;再把「選辨識、選語言模型、選朗讀、調輪替」這整段組裝工作收回官方手上。開發文件甚至把 SpaceXAI 與 OpenAI 並列為「你可能是從別家 realtime API 來的」,官方自己畫出的競爭地圖,比任何第三方整理都誠實。
先講可以防守的判斷:這次更新真正值得看的,不是評測分數又刷新了什麼,而是它把「語音代理等於一堆零件的組合」這個產業預設換掉,賣調校好的整組。代價也寫在文件裡:切換面上有一串明確的界線,協定只走 WebSocket、部分設定被官方託管、轉接與資料駐留都有新規則。這些界線對既有服務的影響,比任何一個百分點都直接。
官方社群帳號的同日宣傳把重點濃縮成一句「半秒內開口,語音推理題答得對」;對照成績單,Max 的首音是 0.57 秒,行銷上四捨五入成了半秒,行銷語言與分數的對應關係後面逐項拆。
這則新聞跟三種人最有關。已經用 OpenAI Realtime SDK 寫好語音功能的開發者,得到一條換引擎的低摩擦路徑;本來就在 ElevenAgents 上組代理的團隊,要面對「哪些設定交出去」的取捨;正在評估語音代理導入的產品負責人,則多了一個把組裝成本外包出去的選項,但合規與資料環境的帳要先算。
「語音到語音」描述的是輸入與輸出,不是內部結構。官方相容文件的常見問題區塊直接回答了這題:Realtime 模型採用串接架構(cascaded architecture),各元件是不同的模型,針對整體表現一起調校;文件同時聲明這不是融合模型,底層各模型的具體型號並未公開,不能自行腦補成某個已知組合。
這個說法值得肯定的地方在於誠實。它等於承認「接住一段對話」仍然需要辨識、理解、發聲等多個環節,這次賣的東西是把這些環節放在一起調好的結果。對開發者的意義很實際:你採購的是一組被官方持續調校的行為,而不是一顆可以拆開來換零件的模型;壞掉或升級都發生在你看不到的那一層。
對照組是 ElevenAgents 原本的 Custom 模式。那條路把每個環節都留給你選:語言模型可以挑內建清單,也可以接 Cloudflare、Groq、SambaNova Cloud、Together AI 這些託管推論服務,或自帶 Bedrock 與自訂端點;朗讀模型與辨識供應商同樣自己指定。自由度的代價是組裝與調校責任都在你身上,兩個環節搭起來接不住話,要自己找原因。Realtime 模式把這整段收走,文件裡那句「底層各模型用 ElevenLabs 最新研究、針對一起運作最佳化」,就是在講這筆交換。
也要跟一個月前的自家產品切開。9 月 28 日發布的 Eleven v4 與 v4 Turbo 是朗讀模型,工作是「把一段寫好的文字念好」,站上先前介紹 ElevenLabs Studio 4.0 時提過這條產品線的影片與配音整合;這次的 Realtime 是對話模型,要處理的是「對方講完了沒、現在該不該開口、開口後要不要呼叫工具」。兩者在同一條產品線上各占一個位置,朗讀需求不需要跟著這次新聞升級。同場加映的對照組是 Google 的 Gemini 3.8 Flash TTS,那也是朗讀端的更新,別混進對話端的比較。
官方部落格引用 Artificial Analysis 的三項公開評測當成績單。這三項量的東西不同,混在一起讀會誤判,先拆開。
Big Bench Audio 量語音推理:一千道題改編自 BIG-Bench Hard,形式邏輯、空間導航、物件計數與真值判斷四個類別各二百五十題,全部用語音問、語音答,答對才算分。Full-Duplex-Bench 量對話動態:模型知不知道該開口還是該安靜、被插話怎麼接、對方附和一聲「嗯」會不會誤以為是提問。Speech Agent Arena 量真人偏好:受試者跟兩個模型各講一輪即時對話,事後盲選比較喜歡哪個。公告提到的工具任務完成率,在 Artificial Analysis 那邊另列為獨立的任務成功基準,與真人盲比分開量,下面表格照官方口徑引用。Artificial Analysis 自己的說明就提醒過,一個模型可能其中一項強、另一項弱,三張成績單本來就不該加總成一個「最強」。
分數本身整理如下:語音推理 Max 答對 98.8%、Mini 75.9%;平均首音(開始出聲的等待)Max 0.57 秒、Mini 0.62 秒;工具任務完成率 Max 87.1%、Mini 60.3%;對話動態 Mini 拿 95.8%、Max 94.1%。真人盲比的 Arena 分數公告寫 Max 998、Mini 988。
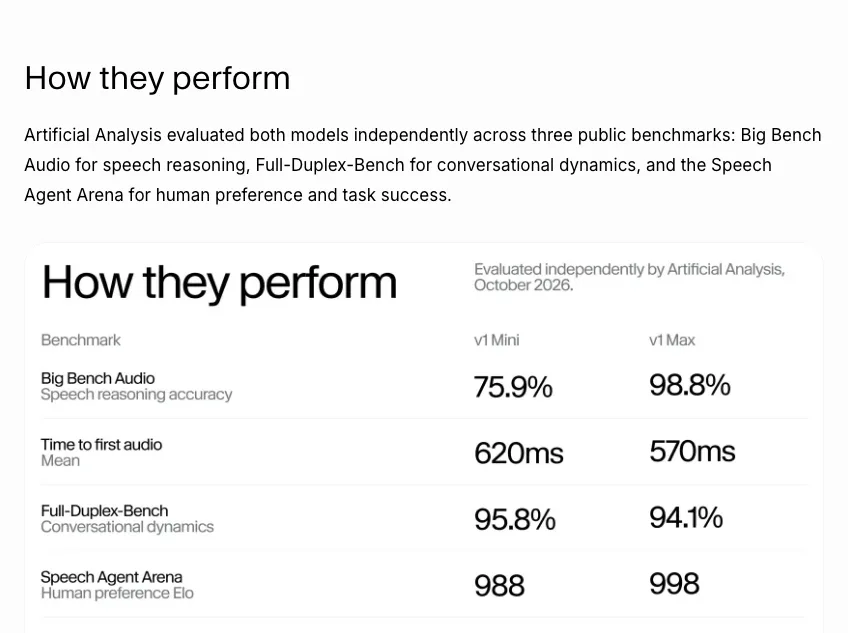
同一批數字,放進 Artificial Analysis 公開的語音對語音排行榜一起看,畫面就不太一樣了。以 10 月 21 日當時的榜單狀態來說:語音推理前端是 StepFun StepAudio 3 Realtime 的 99.7% 與阿里巴巴 Qwen Audio 3.0 Realtime Plus 的 99.2%,Max 的 98.8% 排第三;工具任務完成率 Max 的 87.1% 落在 SpaceXAI Grok Voice 3.0 的 94.8% 與 Google Gemini 3.8 Live 的 93.2% 之後;首音速度最快的是 Krafton Raon SpeechChat 的 0.04 秒與 Deepslate Opal 的 0.44 秒,Max 的 0.57 秒同樣排第三。真人偏好那一欄,Gemini 3.1 Flash Live Minimal 的 1095 與 Gemini 3.8 Live 的 1078 都明顯高於 Max 的 997。
官方「準確與速度通常得取捨、Max 兩者兼得」的宣稱,對著榜單讀會更精確:以 0.6 秒級的首音為前提,Max 的推理成績確實沒有同速度的對手;但若允許 0.8 秒,Grok Voice 3.0 用 98.5% 的推理與 94.8% 的任務完成率給出的組合更全面,若允許 8 秒以上,StepAudio 3 的 99.7% 更高。換句話說,「兼得」成立於速度優先的場景,公告沒有提的部分是:放寬半秒,整張表就換人坐。
任務完成率那一欄的擁擠程度特別值得注意。Max 的 87.1% 前面除了 Grok Voice 3.0 與 Gemini 3.8 Live,還站著 GPT-Realtime-2.1 High 的 91.5% 與 GPT-Live-1(Sol, low)的 90.9%,OpenAI 同世代的幾個型號多數都排在它前面;對「客服要照流程把事做完」的場景,ElevenLabs 目前賣的其實是速度與聲音庫,任務可靠度這一格仍要對照著選。真人偏好那一欄也類似,Gemini 3.1 Flash Live High 的 1066 與 Grok Voice 3.0 的 1064 都在 Max 的 997 之前;盲比這種形式難免摻入聲音聽感的成分,ElevenLabs 把一萬七千多種聲音當資產經營,打的正是這一格。
還有個公告裡容易被略過的細節:對話動態是 Mini 高於 Max。想讓代理「聽起來會聊天」,便宜的那款反而強;需要它照流程查資料、改狀態、連續呼叫工具,才輪到 Max 上場。站上先前拆過 NVIDIA PersonaPlex 的全雙工設計與Freya、Adam、Eve 語音模型的榜首成績單,同樣的結論一再出現:接話自然與任務做完全是兩種能力,一張榜單不會有全能冠軍。
讀這類分數還要認得它們的性質。公告寫 Max 的 Arena 分數是 998,Artificial Analysis 榜單上登錄的是 997,兩邊差了一分;榜單的分數在模型首次列入時就凍結,並不是持續變動的數字,這種個位數差距在兩種口徑下都沒有判讀意義。真正值得記的區別是:固定題組的答對率重跑差異有限,真人盲比的排名則連模型組合都會換,看榜時先分清楚量的是哪一種,才不會把行銷數字讀成定論。
排行榜上的成本欄位也要小心口徑。Artificial Analysis 用固定四十題子集換算「每小時輸入音訊」的成本,Mini 與 Max 在那個口徑下相同;那個數字計入輸入與輸出,但不含快取折扣與工具呼叫,而且換算基準是輸入音訊時長,跟廠商按分鐘加 Token 的帳單結構不同,不能拿來當定價看,真實帳單的結構下面另談。
兩款的官方定位差異,加上文件裡的合規與環境限制,整理成一張表:
| 比較項目 | Eleven Realtime v1 Mini | Eleven Realtime v1 Max |
|---|---|---|
| 官方定位 | 自然對話,成本與延遲低 | 複雜指令與多步工具,回應前先推理 |
| 模型字串 | eleven_realtime_v1_mini | eleven_realtime_v1_max |
| 平均首音 | 0.62 秒 | 0.57 秒 |
| 語音推理(Big Bench Audio) | 75.9% | 98.8% |
| 工具任務完成率 | 60.3% | 87.1% |
| 對話動態(Full-Duplex-Bench) | 95.8% | 94.1% |
| 每 Token 費率 | 較低 | 較高 |
| 零資料留存與 HIPAA | 不支援 | 美國與歐盟環境可用 |
| 印度與新加坡資料駐留環境 | 可用 | 不提供 |
| Token 上限需求 | 無特別限制 | 至少 1,024,或設為無上限 |
表中最後三行是公告沒有凸顯、卻可能直接決定選型的一組事實。Mini 完全不提供零資料留存模式與 HIPAA 選項;Max 提供,但只限美國與歐盟環境,而且不進印度與新加坡的資料駐留環境。換句話說,產品有合規要求的團隊沒有「用便宜款」這個選項,而資料必須落在印度或新加坡的服務則反過來只能用 Mini。
這裡的「環境」是服務端的資料駐留選項,與使用者在哪個城市打電話進來是兩回事。台灣團隊若需要零資料留存,對應的組合是 Max 加上美國或歐盟環境;若只是把 Mini 當一般雲端語音服務用,預設環境就夠。零資料留存不管是工作區強制啟用還是代理層級開啟都會生效,不合規的模型會直接被拒絕,錯誤訊息會指名模型。
聲音與語言的設定在這次更新裡完全保留。文件明列系統提示、開場白、聲音(含一個代理多個聲音的多聲音支援)、語言、溫度、工具與知識庫,在 Realtime 與 Custom 兩種模式下用法相同;也就是說,換成 Realtime 並不會把你挑好的聲音或提示詞組合換掉,動到的只有引擎與節奏那些被託管的底層。官方宣稱的 90 種以上語言與一萬七千多種聲音是可用範圍的上限值,中文聽感與特定口音的表現仍屬於要自己驗證的那一類,這一點公告與文件都沒有給保證。
另外兩個適用範圍的邊界。Realtime 模式只開放給 ElevenAgents 建立的代理,透過 Speech Engine 等其他產品建的代理不能用;檢查的時點也在發布那一刻,草稿存得下來,發布時才會被擋,錯誤會指名要改的設定。這代表「先試試看」的成本很低,但上線前那一次發布才是真正的驗收。
實際的順序建議照這樣排:先到工作區確認資料環境與零留存需求兜不兜得住,再決定 Mini 或 Max,最後才動程式。順序顛倒的風險是程式都接好了,才在合規那一關發現款式選錯,回頭改的工又是一次遷移。
這次更新對既有 OpenAI Realtime 使用者最有感的一句話是:同一套事件協定、同一個 WebSocket 傳輸,把端點改成 wss://api.elevenlabs.io/v1/convai/realtime、模型名稱換成 eleven_realtime_v1_mini 或 eleven_realtime_v1_max,OpenAI 的 SDK 原樣能跑。
但「相容」的邊界要讀細。直接介面只支援 WebSocket,原本走 WebRTC 的整合得先把傳輸層改過來;而 OpenAI SDK 只為它的 WebRTC 傳輸自動處理音訊收放,走 WebSocket 時麥克風輸入與聲音播放要自己接,格式是 24kHz 的 PCM16。連線憑證的流程則是:後端先向 ElevenLabs 換一組短效的 client secret(官方範例的效期是 600 秒),瀏覽器拿這組憑證代替 API key 連線,金鑰本身不進前端。這是標準的安全設計,但表示「只改兩行程式」的說法只對已經用 WebSocket 的人成立。
官方的 Python 範例透露了幾個預設值,值得抄下來對照:輪替偵測用語義型的語音活動偵測(semantic_vad)、敏銳度設中等;出場聲音範例是 brian;輸入輸出音訊都是 24kHz 的 PCM。換句話說,就算換了引擎,「等多久才算講完」這類對話節奏參數仍然存在,只是從你手上的設定檔搬到換憑證時送出的 session 組態裡,那份組態就是這條連線的初始權威狀態。
還有兩個文件明寫的缺口。伺服器端 OpenAI Realtime SDK 的連線文件尚未發布,目前官方指南只寫了瀏覽器流程,配套的是一個放在 GitHub 上的 Next.js 完整範例;官方另有一份遷移指南,說明步驟與 OpenAI API 的差異處,跨過去之前值得整篇讀完。而 Realtime API 與 ElevenAgents 平台是分開運作的,直接呼叫 API 拿得到模型,拿不到電話、網頁、WhatsApp 與聯絡中心通路的整合,也拿不到工作流程、知識庫、防護欄、測試與監控這些平台功能,需要通路的團隊應該從 ElevenAgents 蓋起。
ElevenAgents 的每個代理都有語音模式:Custom 是自己選語言模型、朗讀模型與辨識設定;Realtime 是選一個 Realtime 模型,其餘交給官方。切到 Realtime 之後,有一整組設定會被官方接管,檔案裡儲存的舊值會被忽略,包括:LLM 本體、推理力度、思考預算、平行工具呼叫、串接逾時、TTS 模型、表情模式與辨識供應商。切回 Custom 時這些值會原樣恢復,所以試用是可逆的。系統提示、開場白、聲音(含多聲音)、語言、溫度、工具、知識庫與對話輪替設定則兩種模式都照常使用;小提醒是介面在 Realtime 模式下會藏起 LLM 設定,溫度要透過 CLI 或 API 改。
文件列了五種「應該留在 Custom」的情況:代理用了自訂 LLM、Amazon Bedrock 或 Speech Engine;需要指定某個 LLM 或 TTS 模型;工作流程節點會覆寫被託管的設定;會與 Custom 模式代理互轉;以及純文字代理。這些條件命中任何一條,Realtime 模式在發布時就會被擋下,錯誤會指名要改的設定。
轉接規則是既有服務最容易踩到的坑:Realtime 模式的代理只能與同為 Realtime 模式的代理互轉,Mini 與 Max 之間可以互轉,與 Custom 之間不行,錯誤訊息原文是 Transfers between default and Realtime model modes are not supported。更麻煩的是檢查時點:Custom 端轉進 Realtime 代理的問題,要等到那個 Custom 代理下一次發布才會被抓到,在那之前會在通話中被拒,現任代理留在通話裡繼續講。多代理流程的團隊遷移時要連著轉接圖一起盤,逐個換的模式在過渡期會出現「有的代理轉得過去、有的轉不過去」的混合狀態。
營運面還有兩個細節。Realtime 模式仍在逐步開放,如果代理的 Agent 頁籤看不到 Voice mode 選項,是工作區還沒開通,直接透過 API 送 realtime_model 會被拒,錯誤訊息原文就寫 Realtime models are not available for this workspace。而當 Realtime 模型逾時或出錯時,代理會退回備援 LLM 繼續服務,等待多久才退也由模型端決定,這對通話連續性是好事,對除錯則代表「壞掉的那段」可能不在你手裡,監控要看平台的事件紀錄而不是自己的應用程式日誌。
Token 上限是另一個 Max 專屬的門檻。Max 要求上限至少 1,024,或者完全不設限,而且工作流程節點不能覆寫這個值;低於門檻的代理會在發布時被擋下來。官方沒有解釋這個最低值的原因,但 Max 的定位是回應前先推理,輸出空間給得太緊,出現「想一半被迫開口」的機會也會變大,保守起見照門檻設或直接不設限是比較穩的做法。
計費結構官方寫得很清楚:Realtime 代理照標準 ElevenAgents 每分鐘費率收,再加上輸入、快取輸入與輸出三種 Token 的用量,Max 的每 Token 費率高於 Mini,實際費率以定價頁當期數字為準。
這個結構值得停下來看一眼。同樣十分鐘的通話,若其中一段要反覆查知識庫、等工具回來再往下講,Token 帳就會墊高,兩款的差距也會被放大;只看每分鐘費率比較,會低估多步流程的真實成本。反過來說,快取輸入獨立計價也代表重複出現的系統提示與知識庫片段有機會壓成本,符合條件的內容會照平台規則認定。要比較兩款對自己服務的實際差距,拿同一份真實通話流程各跑一輪、記整筆用量,會比對著費率表心算準確得多。
真正要比的其實是兩種花錢方式。留在 Custom 模式,帳單上每一項都看得懂,但組裝、調校與出包時的除錯時間是自家團隊的隱形成本;切到 Realtime,這些時間變成 Max 高一階的 Token 費率。通話量大的服務,這筆交換可以用幾週的用量資料算出損益兩平點;通話量小的服務,省下的工時通常比多付的 Token 費有感得多。
Mini 不是定位在速度嗎,為什麼首音比 Max 慢? Mini 的定位是成本與延遲的平衡,但這次公布的平均首音 Mini 是 0.62 秒、Max 是 0.57 秒,Max 反而先開口。延遲的優勢要在同類比較裡看,Max 的 0.57 秒在獨立榜上是前段班,Mini 的省錢優勢則反映在每 Token 費率上。
已經在用 Eleven v4,需要換嗎? 不需要。v4 與 v4 Turbo 是朗讀模型,把寫好的文字念好;Realtime 是對話模型,接語音、判斷輪替、呼叫工具。朗讀需求留在原處,對話產品才在這次的範圍裡。
帳號裡找不到 Realtime 選項,是操作錯誤嗎? 不是。官方採逐步開放,工作區還沒輪到時,Agent 頁籤不會顯示 Voice mode,API 也會直接拒絕並回覆工作區尚未開通。等得到就等,等不到就先在 Custom 模式把流程準備好。
WebRTC 的既有服務可以直接接嗎? 不行。直接介面只走 WebSocket,WebRTC 整合要先把傳輸改掉,瀏覽器端的音訊收放(24kHz PCM16)也要自己處理。官方的相容指南與遷移說明寫的是瀏覽器流程,伺服器端的連線文件還沒發布,時程未定。
一定要用 ElevenAgents 平台嗎? 不一定,但拿到的東西不同。走 Realtime API 只拿到模型本身,通路、知識庫、工作流程與監控都要自己建;走 ElevenAgents 則是平台功能跟著代理走,代價是託管設定與轉接規則都要照這次的文件走。兩條路可以並存,先小規模用 API 驗模型、再用平台上線,是文件自己也暗示的路徑。
這則新聞裡有三件事目前沒有答案:Token 的實際費率結構(定價頁採動態呈現,文件只保證 Max 高於 Mini)、伺服器端 SDK 文件的發布時間,以及中文與台灣常見口音在這兩款上的實際表現。評測以英文推理題組為主,盲比受試者的組成也沒有地區保證,中文的輪替習慣、混合英文名詞的辨識,仍要靠自己的語料驗證。
想跟進後續的人,可以盯三個位置:代理設定頁的 Voice mode 是否出現(開放進度)、Artificial Analysis 語音對語音排行榜的變動(競爭位置),以及 ElevenLabs 部落格與文件的更新(費率與伺服器端文件)。逐步開放加上每月都在變動的榜單,文中的數字都以 10 月 21 日當時的狀態為基準,一週後再查一次會是最穩的做法。