TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

2025 年被推薦時它只是一個本地研究迴圈,2026 年的 Local Deep Research 已是內建 SQLCipher 加密資料庫、27 個搜尋引擎與代理式研究策略的自架研究系統。實際用 pip 裝起來跑一遍,看清預設安裝的真實姿態、macOS 的第一個撞牆點,以及想真全本地必須自己準備的三件事。
用 AI 摘要這篇文章:
在 2026 年 9 月的機器上把 Local Deep Research 1.10.7 裝起來、打開網頁介面、填一個問題按下去,得到的畫面是一個紅框:模型欄位空著,介面拒絕開始研究,下拉選單寫著 No models available。這正是這套工具 2026 年版的設計哲學:它預設什麼都不替你決定,包括要用哪個模型。想得起 2025 年春天那波推薦文的人,記憶裡的它是一個裝完就能問的本地 AI 研究助理;18 個月後再裝一次,你會發現它已經換了一個物種,從一條研究迴圈長成一套自架的研究基礎設施,連帳號註冊按鈕都叫 Create Encrypted Account。接下來把你現在裝它會遇到的每一關實際走一遍,看完你會知道它適不適合你,以及哪些舊印象該更新了。
用 pip 安裝是這次實測最順的一段。在 macOS(Apple Silicon、Python 3.14)開一個乾淨的虛擬環境,pip install local-deep-research 一個指令裝完 1.10.7,連加密資料庫需要的 sqlcipher 都是現成的預編譯套件,全程沒有碰過編譯器。這點值得先講,因為這類帶加密層的 Python 專案在 macOS 上最常見的死法就是使用者在編譯階段放棄。
真正的第一關在啟動。它預設聽 5000 埠,而 macOS 的 AirPlay 接收器剛好也佔著 5000 埠,於是第一次啟動直接失敗,終端訊息會指你去系統設定關掉 AirPlay 接收器(這條提示來自它底層的伺服器程式),官方 FAQ 也把這個撞牆列成 macOS 疑難排解的第一條。解法有兩個:關掉 AirPlay 接收器,或者用環境變數 LDR_WEB_PORT 換一個埠,後者不用動系統設定,建議直接用。另一個值得記下來的細節是它的網路姿態:用 pip 直接啟動時,它只綁在本機的 127.0.0.1,不對區域網路開放;要開放給整個網路,得自己用環境變數明講。預設收緊、開放要明說,這個方向跟很多急著讓你連上雲的工具剛好相反。
資料落地位置也先交代:它在 macOS 上把所有東西放在使用者資料夾的 Application Support 底下,啟動日誌會明講資料庫用 SQLCipher 加密、每個帳號一個獨立的加密庫。這句日誌不是場面話,後面帳號那段會看到它玩真的。
介面打開、註冊完帳號之後,研究頁的預設值長這樣:模型供應商是 Ollama(標著 Local,本地端)、搜尋引擎是 SearXNG(標著 Locally-hosted,自己架)、研究策略是 langgraph-agent(讓模型自己決定查什麼、用哪個引擎、什麼時候收斂成報告)。而語言模型欄位是空的,佔位文字寫著 Enter or select a model。
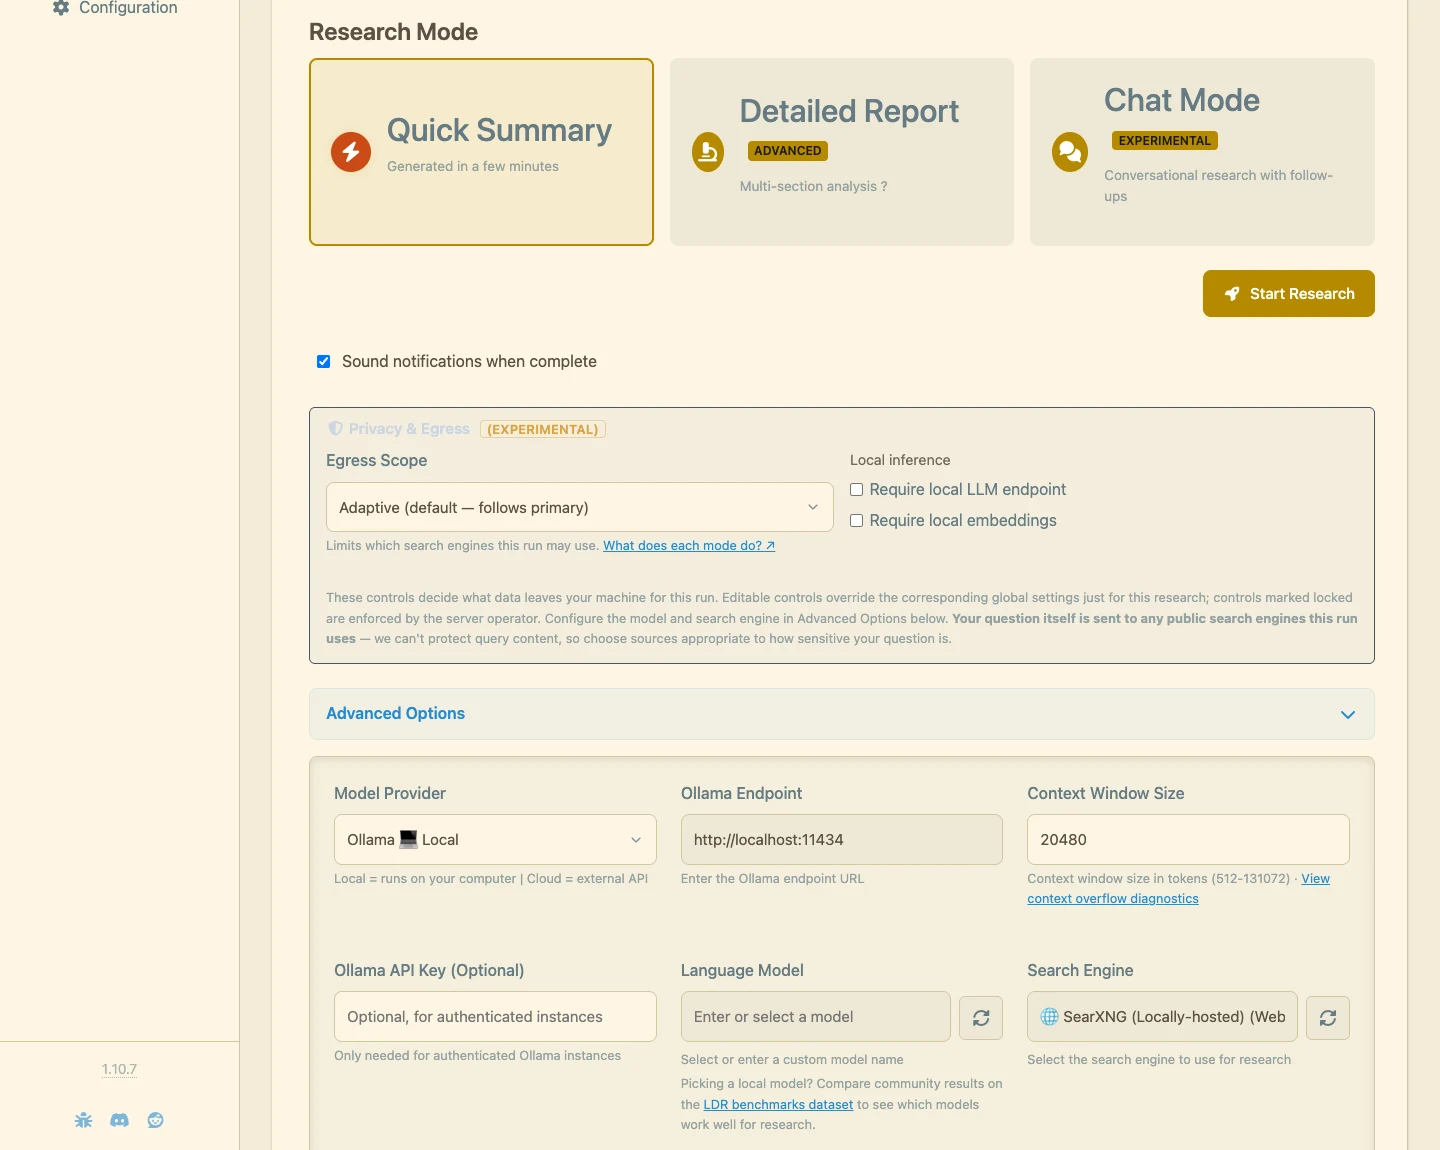
空著的模型欄是整套預設姿態的核心。送出研究時它不會猜、不會抓一個預設模型下載、也不會偷偷改用哪個雲端服務,直接跳紅框擋下來。對照官方文件裡的自述,這是 2026 年 4 月 v1.6.3 之後的行為:在那之前,安裝完什麼都不設定,它會自動填上 Ollama 的 gemma3:12b,然後在你第一次跑研究的時候靜默下載一個數 GB 的模型檔。官方把這個行為拿掉的理由寫得很白:那是「使用者沒有要求過」的靜默下載;現在你沒選模型,它就大聲告訴你沒選模型。很多工具的更新是在加功能,這一次更新反而在減少自作主張,這在 2026 年的 AI 工具圈不算常見。
模型這一關按下去的實際行為是:按 Start Research,前端直接擋下,什麼都不啟動;後端只對本機 11434 埠(Ollama 的位置)做了一次探測,探測不到就顯示 No models available,全程沒有任何對外下載。模型供應商的選單有 15 個選項:本地三條路(Ollama、LM Studio、llama.cpp),另外 12 個以雲端 API 為主(OpenAI、Anthropic、Google Gemini、DeepSeek、xAI、OpenRouter、Requesty 等,其中兩個是相容端點、也能指向自架服務)。也就是說它的邊界畫得很清楚:本地路線的鑰匙和算力都是你的,雲端路線就是一般的 BYOK,用多少付多少,工具本身兩邊都不抽成也不代言。
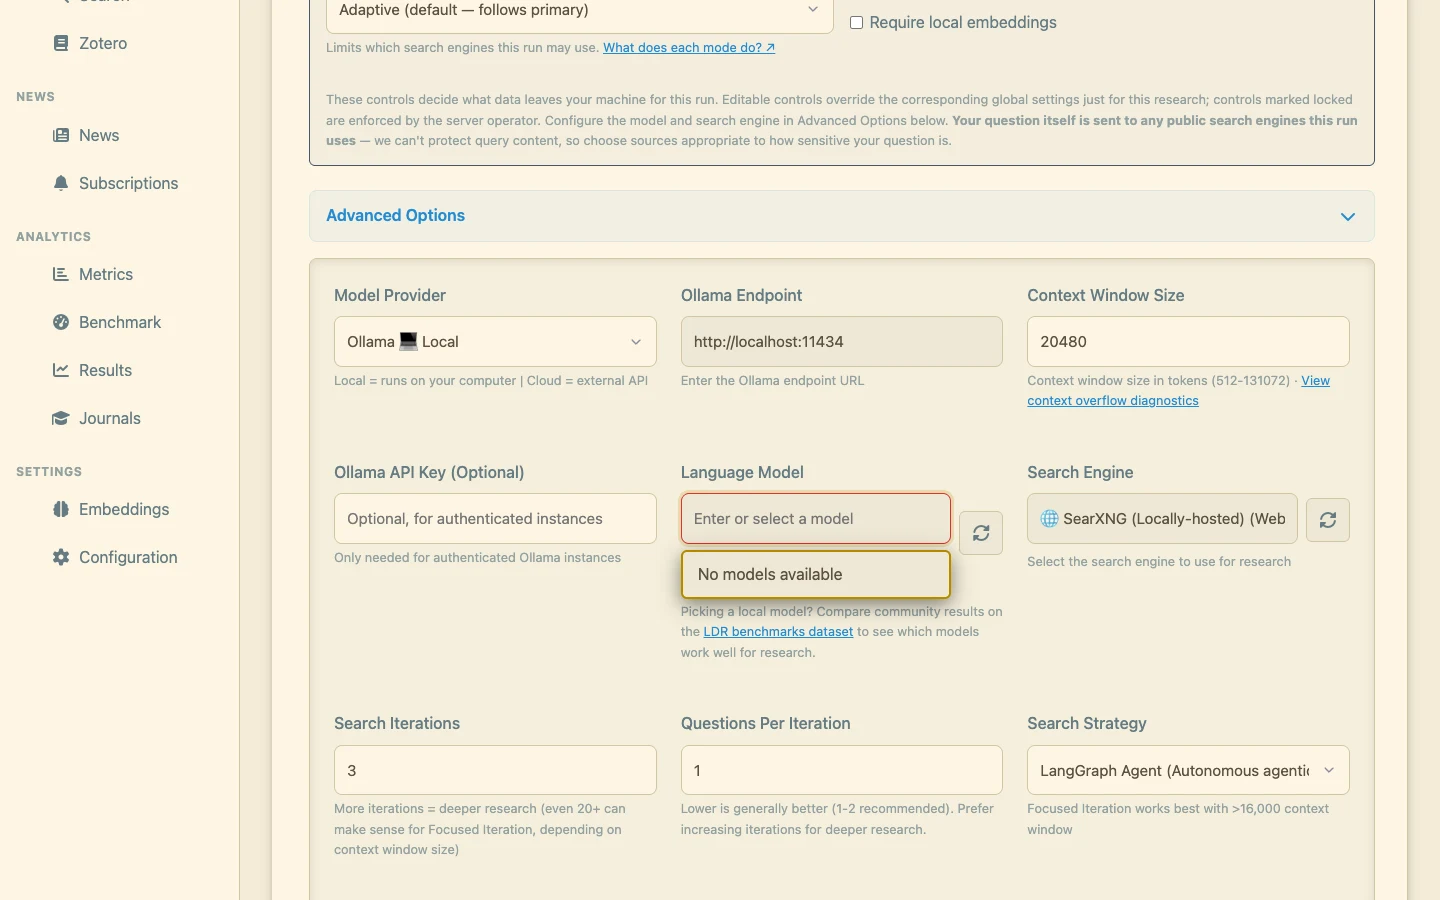
想真的把研究流程整組留在自己機器上,會發現本地這兩個字在這套工具裡是三道門。
第一道是模型門,上面講過了:裝 Ollama、挑模型、下載權重,都是你自己的事。模型選得好不好,官方甚至給了一個公開的社群排行榜(放在 Hugging Face 上,授權 CC-BY-4.0),讓你下載數 GB 權重之前先比對各家模型的研究表現;README 上最亮眼的那筆成績,是 Qwen3.6-27B 在單張 RTX 3090 上跑出 SimpleQA 95.7%、深度搜尋基準 77%,官方還自稱是第一個在單張 3090 上全本地跑出這個成績的開源專案,這個第一無從逐家查證,但成績、題目與跑法都攤在公開資料集上,任何人可以重驗。官方自己也附了但書:樣本小、評分模型有噪音、新一代模型可能有題目汙染風險。這種成績當參考座標可以,當採購依據前記得它是社群提交的數字,不是期刊審查過的結果。
第二道是搜尋門。預設引擎 SearXNG 是你自己架的中繼搜尋服務,官方 Docker 文件的標準組合就是三個容器一起跑:LDR 本體加 Ollama 加 SearXNG。這裡有一個 2026 年 8 月 v1.10.3 之後的新行為要特別注意:因為它加了一整層 SSRF 防護,指向本機或區域網路的引擎位址預設會被擋下,管理員必須用環境變數明確核准這個位址才能用。換句話說,它的安全設計把你導向本機位址的設定預設當成可疑操作看待,第一次升級到這版的人會發現原本能用的 SearXNG 突然連不上,此時該做的是補一次核准,屬於預期內行為。麻煩嗎?有一點。但這正是它跟「隨便填個 URL 就幫你抓」那類工具的分界線。
第三道是帳號門。每個帳號一個獨立的 SQLCipher 加密資料庫,加密金鑰由你的密碼推導,密碼本身不落地儲存,登入這個動作實際上就是拿你輸入的密碼去試著解開你自己的資料庫。這個設計的直接後果是:密碼忘記,資料就結束,沒有救援管道。註冊頁的按鈕文字直接寫 Create Encrypted Account,密碼規則旁邊也勸你交給瀏覽器的密碼管理器。它的多帳號隔離、加密儲存、API 金鑰加密放進個人資料庫,這些都是真的,但代價是你必須像對待加密貨幣錢包一樣對待這組密碼。
還有一個誠實得有點罕見的細節:研究送出之前,介面會明白提醒你,你的問題本身會送給這次研究用到的公開搜尋引擎,工具保護不了查詢內容,敏感的問題請自己挑合適的引擎與隱私範圍。它把本地模型顧好了、把資料庫加密了,然後坦白告訴你搜尋那一層的隱私要自己負責。官方 FAQ 也一樣直白:能不能完全離線用?部分可以,本地模型加本機文件可以離線,網頁搜尋就是要網路。這種把界線講在前面的做法,比行銷頁先喊本地、裝完才讓你發現落差常見得多,也是全文印象最深的部分。
從介面的引擎選單 API 實際拉下來的清單有 30 個項目:扣掉圖書館本體和兩個自動建立的文集,真正的搜尋引擎是 27 個,其中 14 個完全不用金鑰(SearXNG、Wikipedia、arXiv、PubMed、OpenAlex、Semantic Scholar、Wayback、Project Gutenberg、Open Library 等),13 個要申請 API 金鑰(Google 兩種、Brave、Tavily、Serper 等)。免費全本機路線確實存在、經得起檢驗。
但 2025 年那波推薦文裡列的引擎組合,現在對不起來了。最明顯的是 DuckDuckGo:現在的選單裡選不到它。往上追原始碼會發現它處於一種半退休狀態:引擎註冊表裡還登記著它、Python 依賴裡那個套件也還在、官方文件裡還留著它的一節(附註限流嚴格、建議改用 SearXNG),但設定介面的清單就是沒有它。同一批的 The Guardian 引擎也是同樣處境。舊文的讀者照著推薦文去設定會找不到入口,這是舊教學文跟不上版本的最典型案例。
免金鑰那一側還有一個容易被忽略的設計:引擎清單裡除了對外搜尋,還掛著你自己的資料。安裝完之後,選單裡自動多出了兩個文集項目,一個叫 History、一個叫 Library,也就是說每一輪研究的紀錄和每一份收進圖書館的文件,本身就能被當成搜尋引擎來查詢,跟 arXiv、Wikipedia 平起平坐地出現在同一個下拉選單裡。論文工作者可以用 OpenAlex、Semantic Scholar、PubMed、NASA ADS 這幾個免金鑰的學術引擎組出一條完全不走一般網頁搜尋的路線;一般使用者用 SearXNG 加 Wikipedia 加 Wayback 就有基本盤。想要期刊可信度過濾的,再開期刊評分,預設直接把名單上的掠奪性期刊從結果裡移除,其餘來源掛上期刊品質分數。
文件層面還有一個小出入值得知道:安裝說明的 FAQ 寫 Python 3.10 以上就能裝,但套件本身的中繼資料實際要求 3.12 以上、3.15 以下。安裝前以套件要求為準,舊機器上的 Python 要先升級。
把時間軸排開,這個專案的變化速度會超出大部分人對開源個人專案的想像。倉庫 2025 年 2 月建立,2025 年 3 月那波推薦文出現時它才五週大,當時的它是一條會自動生追問、附引用的研究迴圈,引擎選單裡還有一個會自動挑引擎的 auto 模式。到 2026 年 9 月的現在:9,114 顆星、829 個 fork、161 個 PyPI 版本,查核當日 main 分支還有新的 commit 進來,最新版 v1.10.7 是 2026 年 8 月 28 日發的。
功能上它長出了三層。研究層從固定流程換成代理式策略,讓模型自己規劃查詢路徑;當年那個會自動挑引擎的 auto 模式已經在改版中移除,理由是新的代理策略本來就會逐題動態選引擎,舊設定會自動遷移。介面上看得到三種節奏:快速摘要(官方標示約 30 秒到 3 分鐘出帶引用的答案)、詳細報告(進階)、多輪對話模式(實驗性),同一個問題可以依急需程度選深度。
知識層是長得最兇的一層。研究過程中找到的來源可以直接收進加密圖書館(arXiv 論文、PubMed 文章、網頁都行),系統自動抽文字、建索引,下一次研究就能把自己的文件和即時網頁一起查,知識會隨使用累積;文獻工作者有 Zotero 整條匯入,同步是增量的,刪掉的項目也會對帳移除。
筆記功能做成一個小型知識庫:Markdown 編輯、版本歷史、雙向連結,還有一個叫 Verify with Research 的動作,把一則筆記裡的主張逐條抽出來跑深度研究、附來源評分,等於把「查證」變成一鍵流程。期刊品質評分用 OpenAlex、DOAJ 與掠奪性期刊名單三份開放學術資料做信譽評分與過濾(收錄約 21 萬個來源),寫論文引來源時多一層過濾。訂閱功能則把研究排程化:訂一個主題,AI 定期過濾新發展、摘要成報告。
安全層則是過去一年最密集的部分:每帳號一個的加密資料庫從 2025 年 8 月的 1.0.0 就落地,當年 12 月再補上文件儲存加密;2026 年 7 月的 1.9.0 加了雙軸出口管制,私人文集的內容要送去公開搜尋引擎或雲端模型時直接拒絕起跑;2026 年 8 月連發多個安全版,其中 1.10.4 修的是官方自己承認嚴重的身分驗證繞過,1.10.7 修的是通知功能的 SSRF,修復前某個通知 URL 寫法可以被用來讀本機檔案再送出去。連 Docker 映像都有供應鏈工序:簽章、來源證明、軟體物料清單三件套齊備,這在個人開源專案裡少見。對自架者的啟示很直接:它在活躍開發、也在認真修安全問題,但攻擊面是真的,跑舊版不如不跑。
還有兩個加分項。遙測這件事先講:官方宣稱零遙測零分析,把整個倉庫的原始碼掃過一輪,常見的分析套件與對外上報端點全部零命中,宣稱與程式碼對得起來;它對外的連線只有你自己設定的搜尋引擎、模型端點和通知管道。另一個加分項是它附了一個 MCP 伺服器,可以把整套研究能力掛進 Claude Desktop 或 Claude Code 當研究後端(同類的 MCP 應用可以參考我們之前寫過的 mcp-use 開源 MCP 客戶端),官方也提醒這個入口設計給本機使用、沒有內建身分驗證,別直接暴露到網路上。
它適合的人很明確:手上有 GPU 或願意花雲端模型費、想把深度研究流程整組搬進自己機器、在乎查詢內容出境邊界、而且願意同時照顧三個服務的人。對這群人,它可能是目前開源圈最完整的一份:研究、文獻、筆記、加密、出口管制全在同一個可自架的系統裡,MIT 授權可以自由改造,本地模型路線的參考成績有公開排行榜可查(想先看看 gpt-oss 這類開放模型長什麼樣,可以先玩我們介紹過的 gpt-oss-playground)。
它不適合的人也一樣明確:想要開箱即得答案的人,會卡在模型下載和 SearXNG 架設這兩關;不想管任何服務的人,三個容器的組合本身就是成本;預算是零又沒有 GPU 的人,本地路線跑不動,雲端路線就是花錢買 token。軟體本身免費這件事不代表使用免費,這筆帳要算的是模型那一側。好在它把帳本攤給你看:內建的分析頁會記每次研究的用量、成本與效能指標,而且這些紀錄一樣留在你自己的加密資料庫裡,用雲端模型跑一週之後再查看數字,比憑感覺估成本可靠得多。如果你要的只是本地 AI 助手而非研究系統,之前介紹過的 AingDesk 本地 AI 助手或 NoteGen 本地筆記都是負擔輕得多的起點。
最後三個實際提醒:介面全英文,沒有多語切換;搜尋語言預設 English,中文資料的檢索品質要自己調整設定後再評估;註冊帳號那一刻就是加密庫的起點,密碼先想好存放方式再開始。
MIT 授權,授權條款隨倉庫附上,商用與修改都不用另外談授權。專案在 2026 年 9 月仍高度活躍,最新版 v1.10.7 發布於 2026 年 8 月 28 日,PyPI 上累計 161 個版本,Python 需 3.12 至 3.14。安裝文件在 GitHub 倉庫與 PyPI 頁面都有,pip、Docker Compose、Unraid 三種安裝路徑齊備,Unraid 使用者在倉庫裡附了現成範本,其他 NAS 用 Docker Compose 一樣裝得起來。想追進度的人,官方 Discord 與 Reddit 社群都在運作,模型表現的排行榜放在 Hugging Face 上,採社群提交制。安全修復紀錄與 Docker 映像簽章驗證方式都寫在倉庫的 SECURITY 文件裡,自架前值得花十分鐘讀完,尤其打算把服務開給別人用的話。