TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 推出 Gemini 3.8 Flash TTS 與 Flash-Lite TTS 兩款文字轉語音模型,能用文字描述設計聲線、逐句安排語氣與雙角色對話,語言表列有繁體中文。本文對照官方文件整理兩款模型差異、限時價格與 2027 年調漲幅度、聲音複製的同意錄音規則,以及台灣使用的兩個邊界。
用 AI 摘要這篇文章:
Google 在 2026 年 9 月 23 日推出兩款文字轉語音模型:Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS,開發者即日起能在 Gemini API 與 Google AI Studio 使用。這次更新的重點不在聲音更像真人,而在控制方式的改變:你可以先用文字描述設計一把聲線,再逐句安排語氣、速度、口音與停頓,還能讓兩個角色照同一份劇本輪流對話。先講兩個在地可用性重點:兩張模型卡的語言表都列了繁體中文(Chinese (Hant script)),生成繁中腳本可用;聲音複製功能台灣也在開放地區內,但同意語句目前只有簡體中文版,沒有繁中版。
以下內容均對照 9 月 24 日抓取的 Google 官方公告、模型卡、語音生成文件、定價頁與聲音複製文件整理。
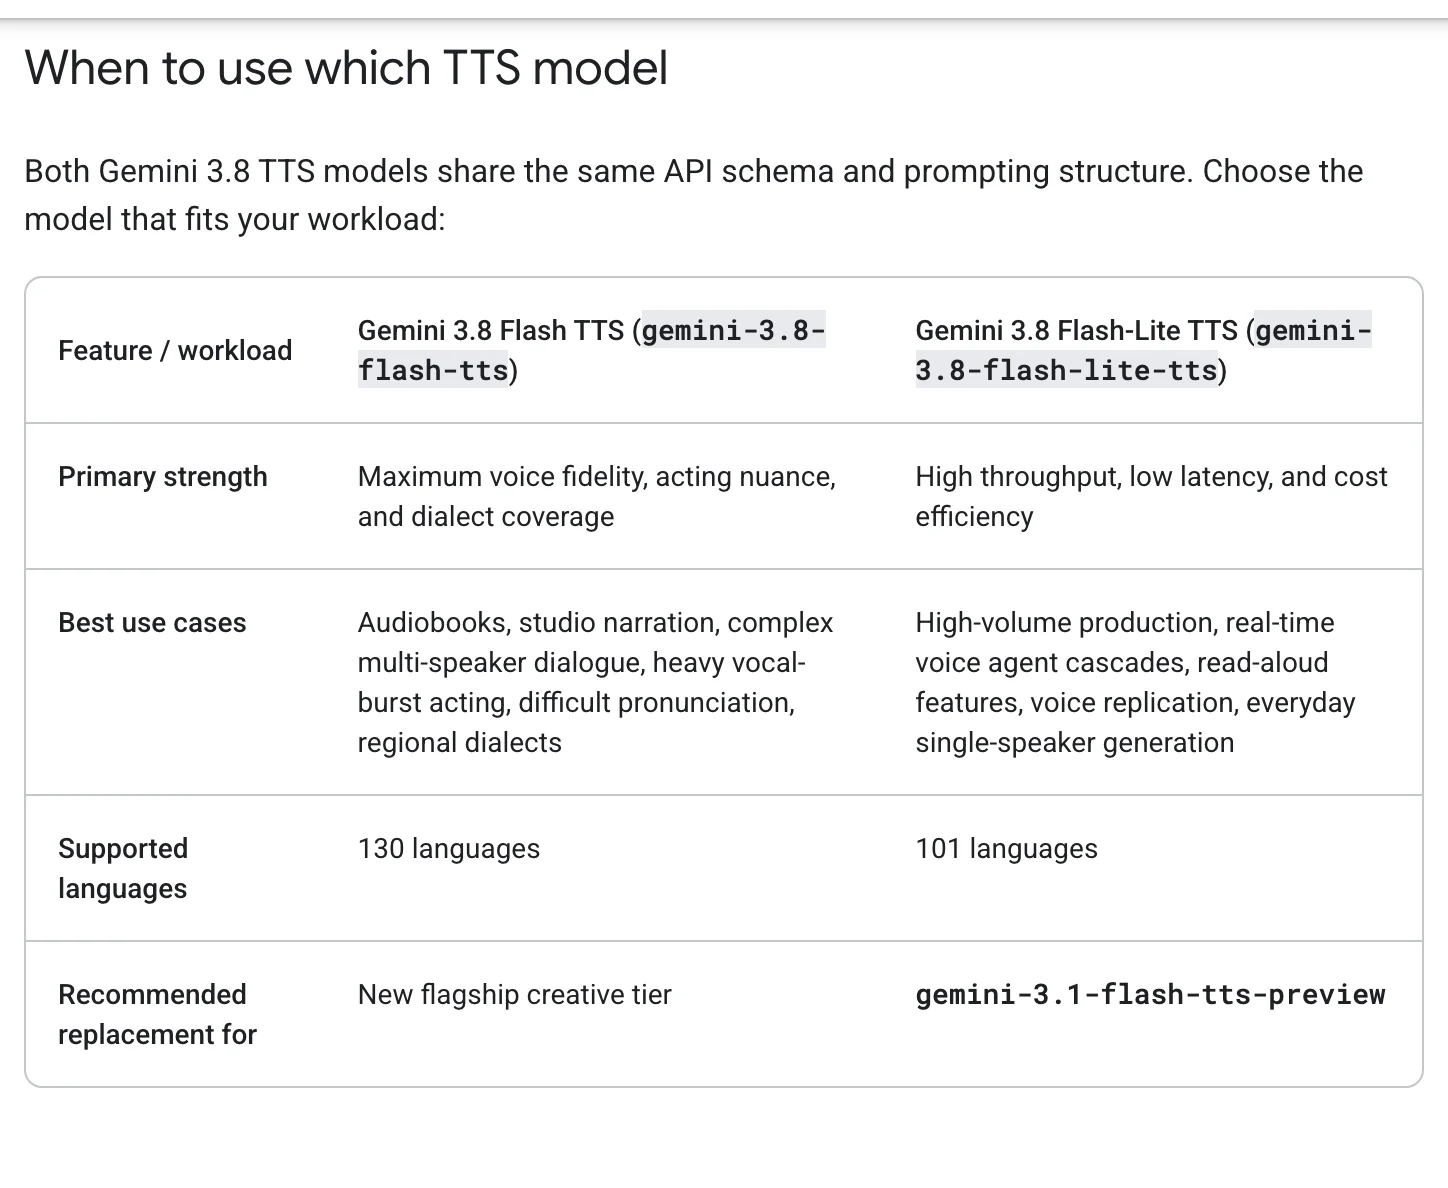
Google 把這兩款模型放進 Gemini Audio 家族,排在先前的 3.5 Live Translate、3.5 Transcribe、3.8 Live 與 3.8 Live Extended Thinking 之後,補上「照稿演出」這一塊。兩者的分工在官方公告與模型卡寫得很清楚:共用同一套 API 結構與提示詞格式,差別在設計目標。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 定位 | 創作旗艦,配音表演與方言細節 | 高產量、低延遲、成本效率 |
| 官方列的適用情境 | 有聲書、錄音室旁白、多角色對話、高難度發音與口音 | 大量配音、語音代理流程、朗讀、單人語音生成 |
| 支援語言 | 130 種 | 101 種 |
| 繁體中文文字 | 支援(Chinese (Hant script)) | 支援(Chinese (Hant script)) |
| 輸出音訊單價(2026 年底前) | 每 100 萬 token 9 美元 | 每 100 萬 token 6 美元 |
| 建議替代對象 | 新的創作旗艦級距 | 取代 Gemini 3.1 Flash TTS Preview |
選擇的判斷很直觀:需要細緻控制角色與語氣、每次生成量不大的創作場景,從 Flash 開始;每天要產出大量朗讀或配音內容、對成本敏感的流程,Flash-Lite 是官方指定的量產路線,模型卡也直接寫明它是 Gemini 3.1 Flash TTS Preview 的替代品。
語言數字要看得再細一點。模型卡說的是模型支援哪些語言的文字,不代表每個地名、人名或台灣口音都能一次唸對。Google 在公告裡只寫支援超過 100 種語言,實際部署前,拿自己的稿子試聽仍是必要程序,特別是中英夾雜與數字的段落。
這次更新把 AI 配音的工作方式分成兩層,跟以往「挑一把預設聲音、調語速和音高」是不同的思路。
聲音來源有四種。預設聲音、透過 API 取用的延伸聲音庫(官方說從 30 個原始聲音擴充到超過 2,000 個生產級聲音,含墨西哥西語、魁北克法語這類區域變體)、用文字描述設計出來的自訂聲線,以及從錄音複製的聲音。自訂聲線是用自然語言描述角色,例如沉穩的旁白或帶特定地區腔調的主持人,試聽後可以保存下來重複使用,讓同一個角色在不同內容裡維持一致音色。公告也預告了下一波功能:挑既有聲音再微調音色、音高與語速。
表演控制在語音生成文件有一條關鍵規則:Gemini 3.8 TTS 把輸入文字嚴格當成逐字稿。持續整段的語氣要求(例如悄悄話、激動、放慢)要放進結構化的 speech_metadata 欄位,瞬間的非語言聲音才用行內標籤標注,像 <laugh>、<sigh>、<short pause> 這類。把「用興奮的語氣說」直接寫進台詞,模型可能會連這句指示一起唸出來。這對從舊模型搬稿子的人是最容易踩的坑,文件的遷移指南花了不少篇幅解釋怎麼把舊式舞台指示搬進 metadata,因為 3.1 預覽版時代的習慣是直接把指示寫在純文字裡,兩代不相容。
雙角色對話是同一套邏輯的延伸。在 speech 設定裡配置兩個說話者,每句台詞附上說話者與個別的語氣設定,用 conversational 模式就能生成自然輪替的對話。AI Studio 裡對應的介面是一個雙人劇本編輯器,官方形容它像一間聲音設計工作坊:先設計或複製聲音,再進劇本逐句指揮。模型卡另外列了行內 IPA 音標覆蓋與 backchanneling(應答式的嗯、啊回應),這些都是為了讓台詞聽起來像排練過,而非整篇用同一種語氣唸完。
長稿要注意單次生成上限。模型卡列的輸入上限是 8,192 token、輸出上限 16,384 token,而音訊輸出以每秒 25 token 計,換算下來單次輸出大約 10 分鐘出頭的音檔就得分段,長篇有聲書要把分段與銜接列入流程。官方文件對長內容的宣稱是能跨數小時維持音色與音量一致,這點屬於官方說法,實際表現仍以自己的稿件驗證為準。
複製既有聲音的規則,聲音複製文件寫得相當具體。每次申請要附上同一位成年說話者的兩段錄音:10 到 30 秒的乾淨參考錄音,加上一段逐字唸出指定同意語句的錄音。英文版語句是「I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model.」,系統會核對兩段錄音是不是同一個人,才會建立聲音模型。官方的建議還包括兩段錄音用同一支麥克風、同一個環境錄,通過驗證的可靠度才高。
同意語句支援 30 種語言版本,中文只列了 zh-CN 簡體版,沒有繁體中文版。在台灣想複製自己的聲音,現階段得照官方文件上的簡體語句逐字唸,或改用英文版本,這是流程上的小障礙,不是功能封鎖。地區方面,公告註腳載明 AI Studio 的聲音複製不適用於伊利諾州、德州、歐洲經濟區、英國、瑞士與印度,台灣不在排除名單內。實際操作上,AI Studio 內建了互動式的複製流程:在瀏覽器裡錄或上傳兩段錄音、預覽複製結果,通過後拿到 voice 開頭的識別碼,直接貼進 API 呼叫。文件建議把錄音轉成 24kHz 單聲道 16 位元 WAV 再上傳,辨識通過率會比較穩。
授權與浮水印的設計也值得知道。每段 Gemini Audio 生成的音檔都會嵌入 SynthID 浮水印,人耳聽不出來,但可用來辨認是 AI 生成;複製出來的聲音另附 C2PA 憑證。這套組合回答的是聲音授權的舉證問題:誰同意了、生成物是不是機器做的。與坊間拿 3 秒樣本就能生成配音的聲音複製工具相比,Google 把同意驗證做進了流程本身,拿到聲音的門檻高一截。不過浮水印與同意程序處理的是授權鏈,拿到授權之後的商業使用權利、肖像與合約問題,還是要自己把關。
定價頁上兩款新模型的費率是限時價。2026 年 12 月 31 日前,輸入文字每 100 萬 token 0.50 美元,輸出音訊 Flash 是 9 美元、Flash-Lite 是 6 美元;2027 年 1 月 1 日起輸入調為 1 美元,輸出調為 18 美元與 12 美元,剛好翻倍。對照前身 Gemini 3.1 Flash TTS Preview 的輸入 1 美元、輸出 20 美元,新模型在限時期間的輸出單價分別只有原本的 45% 與 30%,等於省下 55% 到 70% 的輸出費,這是按兩張定價卡的單價換算的幅度。
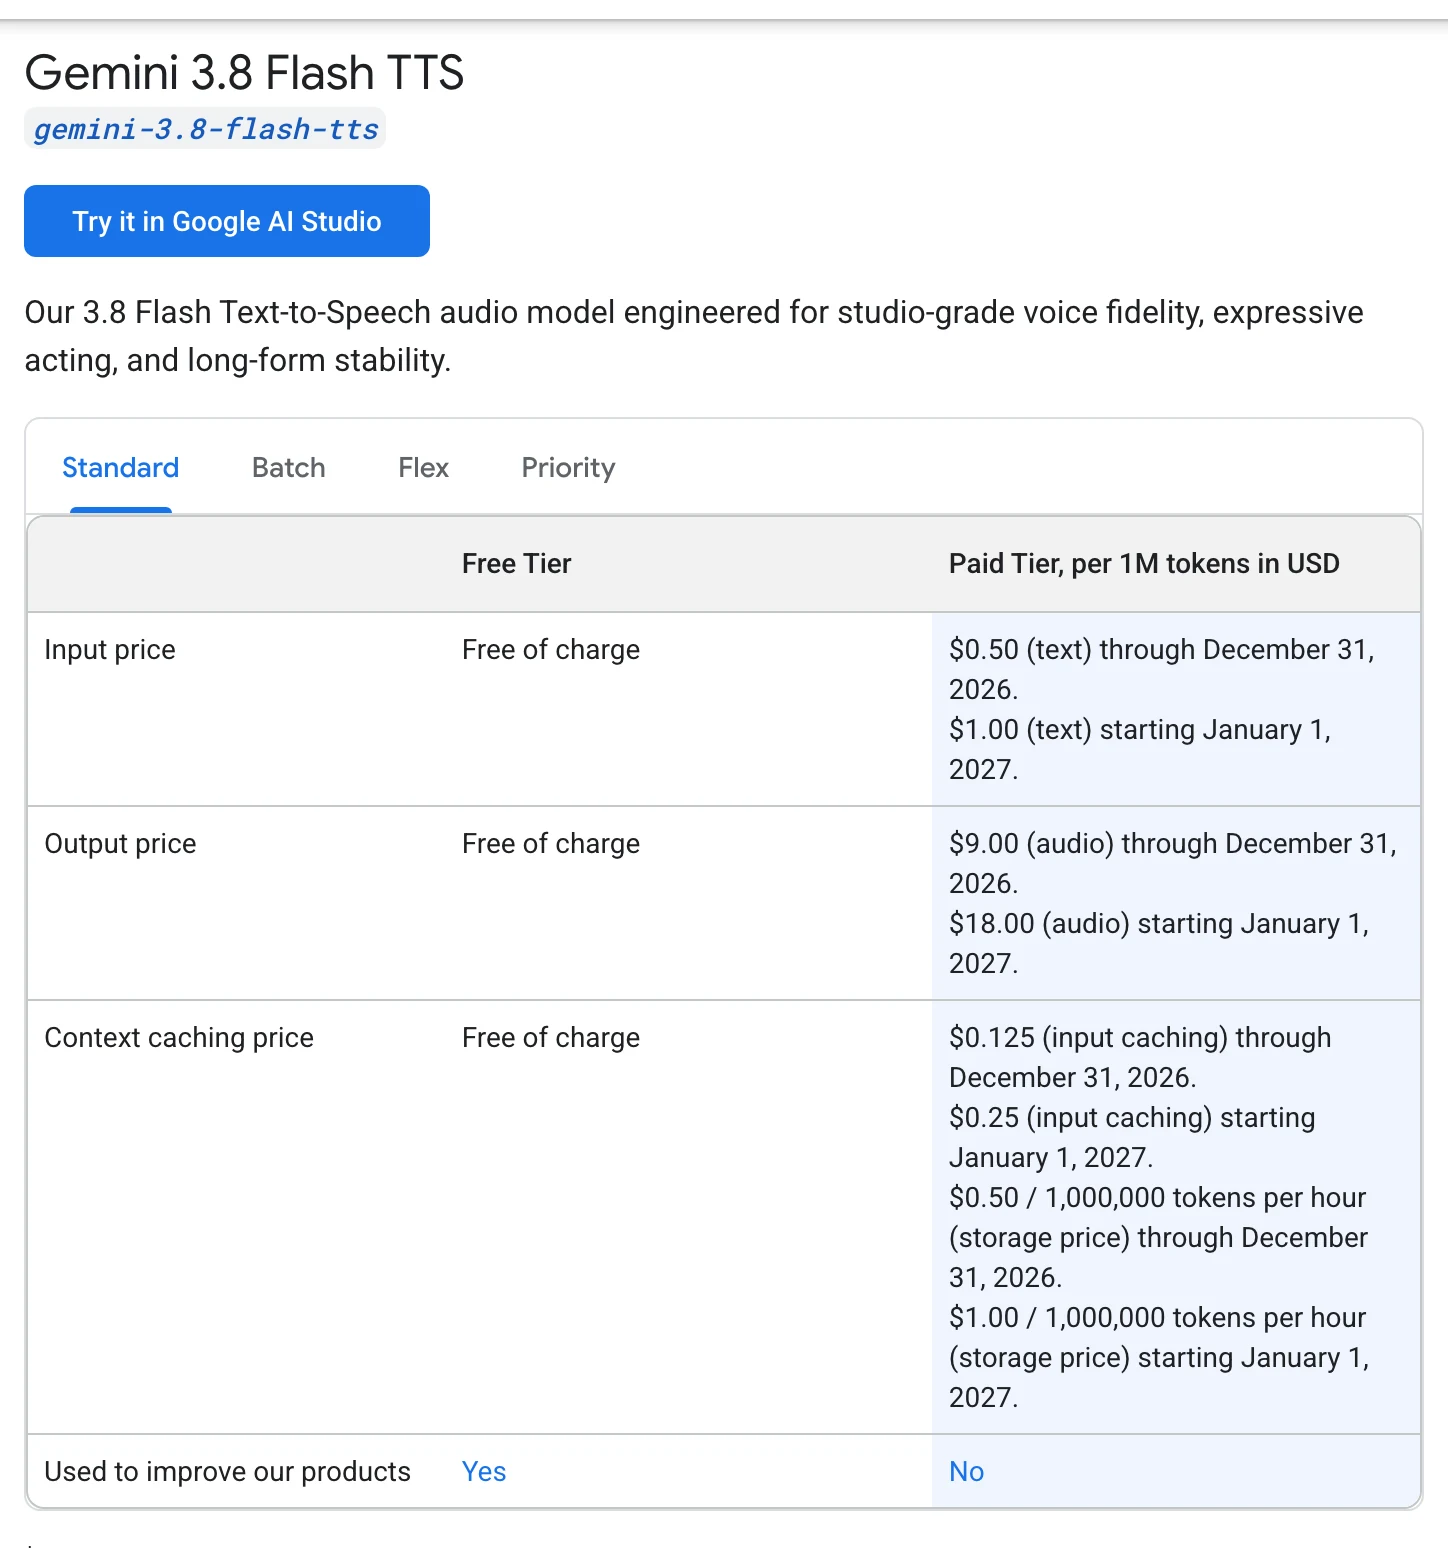
token 計價需要換算才有感。官方註記音訊輸出以每秒 25 token 計,換算成 1 分鐘語音約 1,500 token,輸出費 Flash 約 0.0135 美元、Flash-Lite 約 0.009 美元(限時期間、僅計輸出費,未含輸入與其他用量)。要拿這個數字估算專案成本,記得兩件事:2027 年起同樣的量要乘以二,以及實際帳單以 Google 當期定價與專案用量為準。會重複生成相同前綴的流程另有一組快取價可看,定價頁列限時期間輸入快取每 100 萬 token 0.125 美元、快取儲存每 100 萬 token 每小時 0.50 美元,2027 年起同樣翻倍,對反覆迭代同一份劇本的工作流有實際影響。
免費層的取捨比價格數字更該先看。定價頁的資料用途欄位寫明:免費層的內容會用於改善 Google 產品,付費層不會。換句話說,未公開的腳本、客戶資料或含個資的文稿,直接走免費層等於把內容交給 Google 當訓練素材,這條線在導入前就該決定好,而不是出事再補救。
Google 在公告裡公布了一組成績:Flash TTS 在 Hume AI 的 Voice Design Benchmark 以 71.4 分拿下總分榜首,口音建模 60.8 分也是榜首;兩款模型在 Hume 的 Overall Quality Index 包辦前兩名。另有 Voice Arena 盲聽偏好評測,Google 稱兩款模型在日語、巴西葡語、越南語、現代標準阿拉伯語、墨西哥西語與印地語等語言名列前茅。這些是廠商自己公布的數字,Hume 官網上的排行榜框架頁沒有直接列出這批名次,引用時應保持「Google 公布」的層級。
更值得記住的是 Hume 自己對評測的提醒。該框架的研究摘要寫明,TTS 的自然度、情緒表現、聲線一致性與穩定性是互相獨立的評測維度,單一總分回答不了所有問題。也就是說,總分榜首不代表它對你的台灣口音旁白、專業術語或中英夾雜句子同樣出色。榜單可以當入場參考,決定權還是在自己稿件的試聽結果上,這與前面語言支援的提醒是同一件事。
一般使用者這端的分配是:Flash TTS 進了 Gemini Notebook,Flash-Lite TTS 進了 Google Vids,對應各自的重度使用場景。AI Studio 的語音工作區開放所有人試用,設計聲線、複製聲音、進雙人劇本編輯器都在同一個介面裡。企業版 Gemini Enterprise 的 API 存取官方只寫 coming soon,沒有給時間表,企業導入時程要另外追。
生態系的動向也反映了這波定位。Google 點名 Agora、LiveKit、Pipecat、Vercel 等開發者平台已接上這組模型,Figma、HeyGen、Linguana、Wondercraft、99.co 與 Ollang 則在整合中,用途集中在多語配音、區域口音在地化與對話式語音代理。與上週開放的 Gemini 3.8 Live API 對照著看更清楚:Live 系列做即時對話,TTS 系列做照稿演出,兩者合起來才是完整的語音產品線。如果你原本的工作流在 ElevenLabs Studio 這類整合剪輯台或自架 Azure 語音服務上,這次的看點是 Google 用導演式控制與限時價格把純文字轉語音這段變便宜了,至於整段配音後製流程要不要搬家,得看你的工具鏈對 API 的依賴程度。
短期能做的事分三種角色。創作者可以先進 AI Studio 用自己的稿子試聽,重點檢查人名、地名、數字與中英夾雜的段落,順便測雙人劇本是不是真的省下後製時間;開發者可以在限時價期間把 Flash-Lite 接進既有流程壓成本測試,並把 speech_metadata 的改寫排進遷移工作,因為逐字稿行為對舊式提示詞不相容;處理他人聲音的團隊,先把同意錄音流程與繁中語句缺失的應對寫進規範,再考慮啟用複製功能。
時間點上有一個明確的檢查日:2027 年 1 月 1 日費率翻倍生效,需要在屆時前鎖定用量估算或改變方案的團隊,可以在 12 月回來核對定價頁。企業版 API 的開通時程、榜單名次的獨立驗證與繁中同意語句會不會補上,這三件事目前官方都沒有給出日期,有進展時值得再回頭更新這篇的結論。