TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

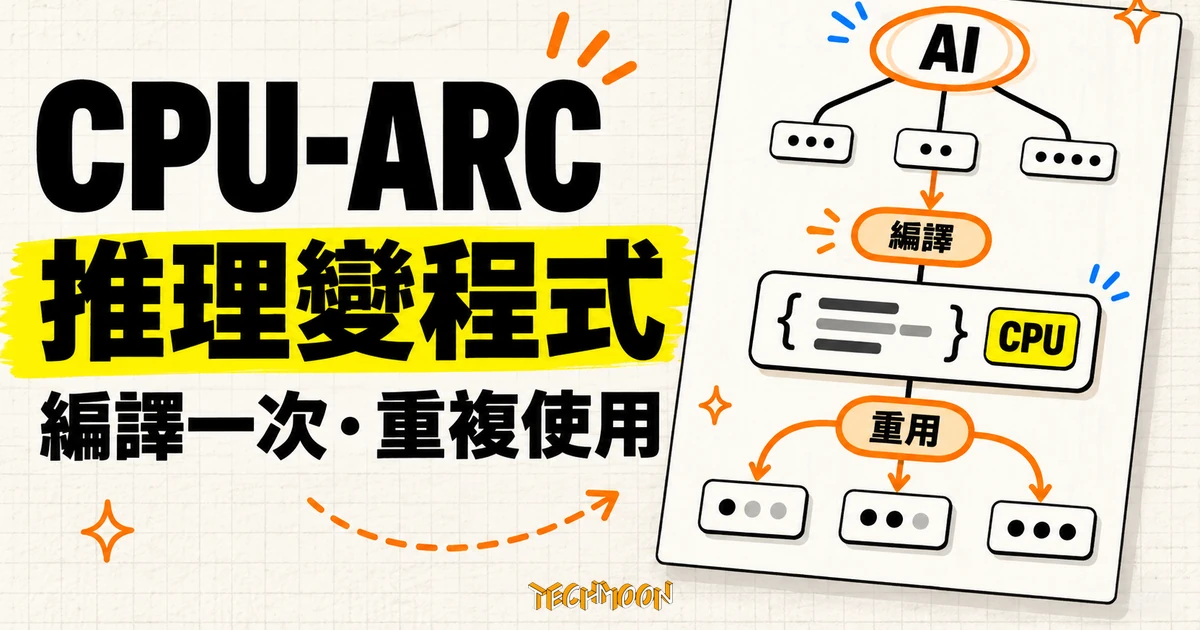
NVIDIA 研究團隊 2026 年 11 月在 arXiv 發表 CPU-ARC,把 Claude Opus 4.5 的解題推理編譯成 CPU 可執行的小程式:重用一次成本剩十六分之一到二百九十一分之一,建置要先花十二到八十四倍,AIME 約 13 次回本、GSM8K 約 90 次。Table 2 八列數據與尚未驗證的部分一併整理。
用 AI 摘要這篇文章:
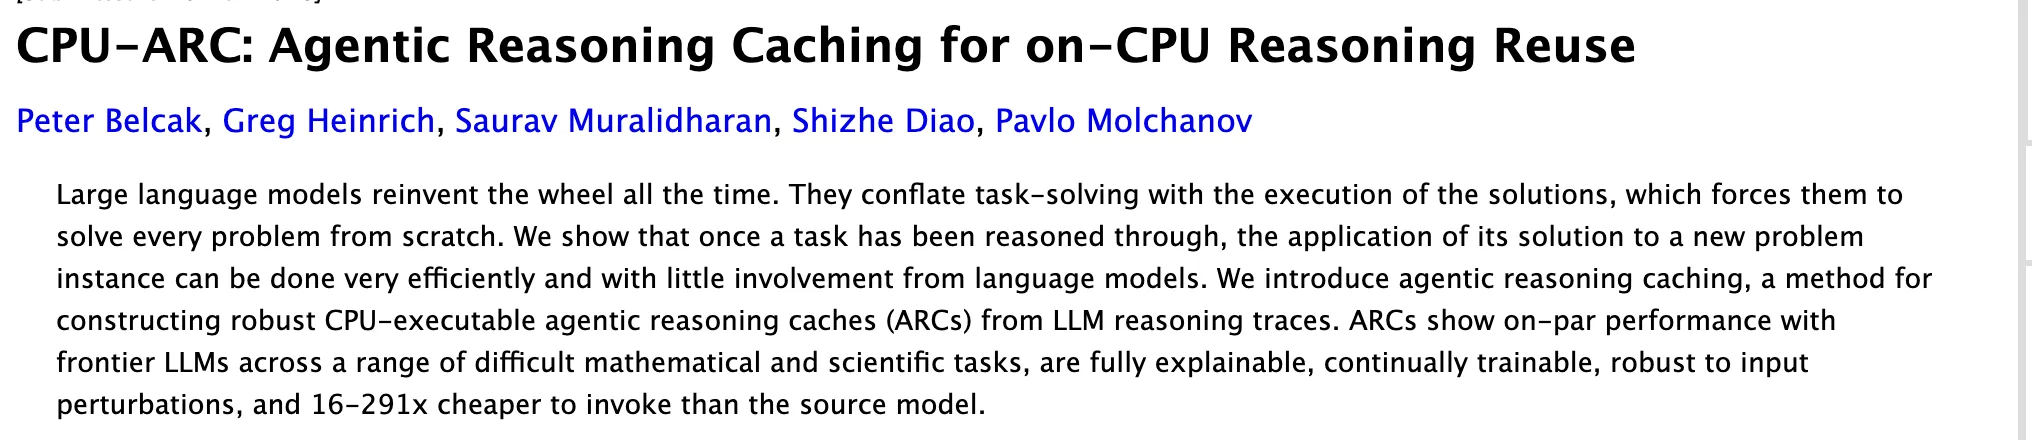
NVIDIA 的研究團隊在 2026 年 11 月 6 日把一篇名為 CPU-ARC 的論文放上 arXiv(編號 2611.09891,台灣時間 7 日凌晨上架)。這篇 28 頁的技術報告處理一個很多人隱約感覺到、卻少有人認真量測的浪費:大型模型解過一次難題之後,遇到只有數字或措辭不同的相似題目,仍然會把整段推理從頭走一遍。CPU-ARC(Agentic Reasoning Caching)把模型的解題推理整理成可以在 CPU 上執行的小程式,題目換數字、換說法時直接沿用程式重算,不必每次都叫前沿模型重新推理。
論文量出了兩個方向相反的數字,單獨引用任何一個都會誤導。在八個數學與科學基準上,建立好的快取後續每用一次,成本約是原始解題費用的十六分之一到二百九十一分之一;但建立這份快取,要先花掉約十二到八十四倍的解題費用。所以 291 倍的節省只屬於「同一套解法被反覆使用」的場景,一次性問題走這條路反而更貴。對每天在 API 上跑大量重複推理的團隊來說,這份研究真正給出的是一套判斷框架:哪些工作值得編譯成快取,哪些繼續按次付費給模型。
研究出自 NVIDIA Research 之下、由 Pavlo Molchanov 帶領的深度學習效率研究團隊 DLER,論文由 Peter Belcak 等五位研究者署名,首頁連結欄直接指向 NVIDIA Research 的在地前沿智能(Local Frontier Intelligence)計畫頁。論文放上 arXiv 三天後的 11 月 9 日,已經有人把它分享到 X 上。
論文用一個取自 MATH-500 的真實題目示範整個概念:「196 有多少個正因數?」模型推理時會先把 196 做質因數分解,得到 2 的平方乘 7 的平方,再套用「每個質因數的次方加一後相乘」的公式,算出 3 乘 3 等於 9。CPU-ARC 建立的快取保存的就是這條路徑:輸入一個正整數,中間經過質因數分解與公式計算,輸出因數個數。之後題目換成「144 有多少個正因數」,程式重新分解出 2 的四次方乘 3 的平方,算出 5 乘 3 等於 15,整段過程不再需要前沿模型參與。
論文把這些單元稱為語意函式(semantic function):除了可執行的程式,還一併保存輸入、輸出與用途描述,讓系統之後能用語意搜尋把它找出來。論文開頭對問題的描述很直白:語言模型一直在重新發明輪子,把「想出解法」與「執行解法」混在一起,所以每個問題都被當成全新問題從頭解。研究者的兩個前提觀察是:一次推理裡的大部分內容,其實可以沿用到同一個問題的其他實例上;而這些內容可以轉成程式碼,只在需要語意相似搜尋、數值擷取、格式轉換、分類或摘要這類小事時,才動用小語言模型。
這與兩種既有的快取做法不同。提示快取(prompt caching)省的是模型重複讀取相同輸入段的費用,答案仍要模型自己生成,站上先前的 Asana 代理成本實驗 量過這類快取能省多少、以及它成立的前提;「相似問題直接回傳舊答案」則會在數字改變時出錯,因為措辭相近不代表答案相同。CPU-ARC 把程序和參數分開處理:解法相同、答案不同的題目可以正確應付,代價是程序的建立與驗證都比較複雜。由於每條快取本體就是程式碼,它天生可檢視、可人工或用 AI 修正,也能不斷往主快取裡新增條目而不用重建既有內容,論文以持續可訓練描述這個性質;語意函式之間還能互相組合呼叫,必要時也可以接上終端機或網路搜尋這類工具。
建立階段由大型模型主導。論文的方法章把流程分成幾個動作:從原始對話裡辨識問題與答案、拆出中間步驟、隔離可變的輸入與固定不變的邏輯、分析每個參數在邏輯上成立的有效範圍,然後反覆生成程式碼交給評判器測試,沒有一次轉換就必然正確的保證。參數範圍是成敗關鍵:題目裡常帶著前提條件(例如熱力學題註明假設氣體都是理想氣體),換一組數字時前提不一定還成立,程式照樣能跑,答案卻已經回應另一個問題了。論文的對策是多重檢查:把原始問題送回建好的函式核對結果,要求參數擷取與重建符合原題,驗證時還要確認所有領域限制仍被滿足,避免把文字裡不同角色的數字放錯位置。
呼叫階段輕得多。新問題進來,系統先用嵌入模型做語意搜尋找出候選函式,相似度超過門檻才繼續往下走;接著由小模型從題目裡擷取參數值,程式在 CPU 上執行計算,執行過程累積的敘述記錄就是人類可讀的逐步解釋。若找不到合適函式或執行出錯,請求會退回原本的來源模型,所以整條管線是快取與備援並存,而非兩者只能選一個。
模型配置值得單獨看一眼。解題與建立快取用的是 Claude Opus 4.5(開啟 4096 token 預算的延伸思考),接手參數擷取、格式轉換與敘述等輔助角色的,是先用 Claude Haiku 4.5、後換成微調版 Llama 3.2 1B 的小模型,檢索則交給約 3 億參數的 Embedding Gemma 產生 768 維向量。換成 1B 模型的過程本身就是個小實驗:研究者收集評估中約兩成的實際使用案例,讓來源模型生成約十倍大的合成訓練集去微調 Llama 3.2 1B,結果 10 億參數就足以勝任目標角色,成本再壓低一截。名稱裡的 CPU 容易被讀成「從此不再需要模型」,實際上小模型仍在流程裡工作,省掉的是整段反覆出現的推理。
成本數字全部出自論文的 Table 2,計價採 2026 年 3 月的 API 費率:Claude Opus 4.5 每百萬輸入 5 美元、輸出 25 美元(提示快取寫入 6.25 美元、讀取 0.5 美元),微調 Llama 3.2 1B 每百萬輸入 0.023 美元、輸出 0.194 美元。這表示倍數反映的是那個月的相對價格結構,模型單價一變,倍數就會跟著變,而模型 API 降價在這一年並不罕見,引用時要記得附上計價時點。
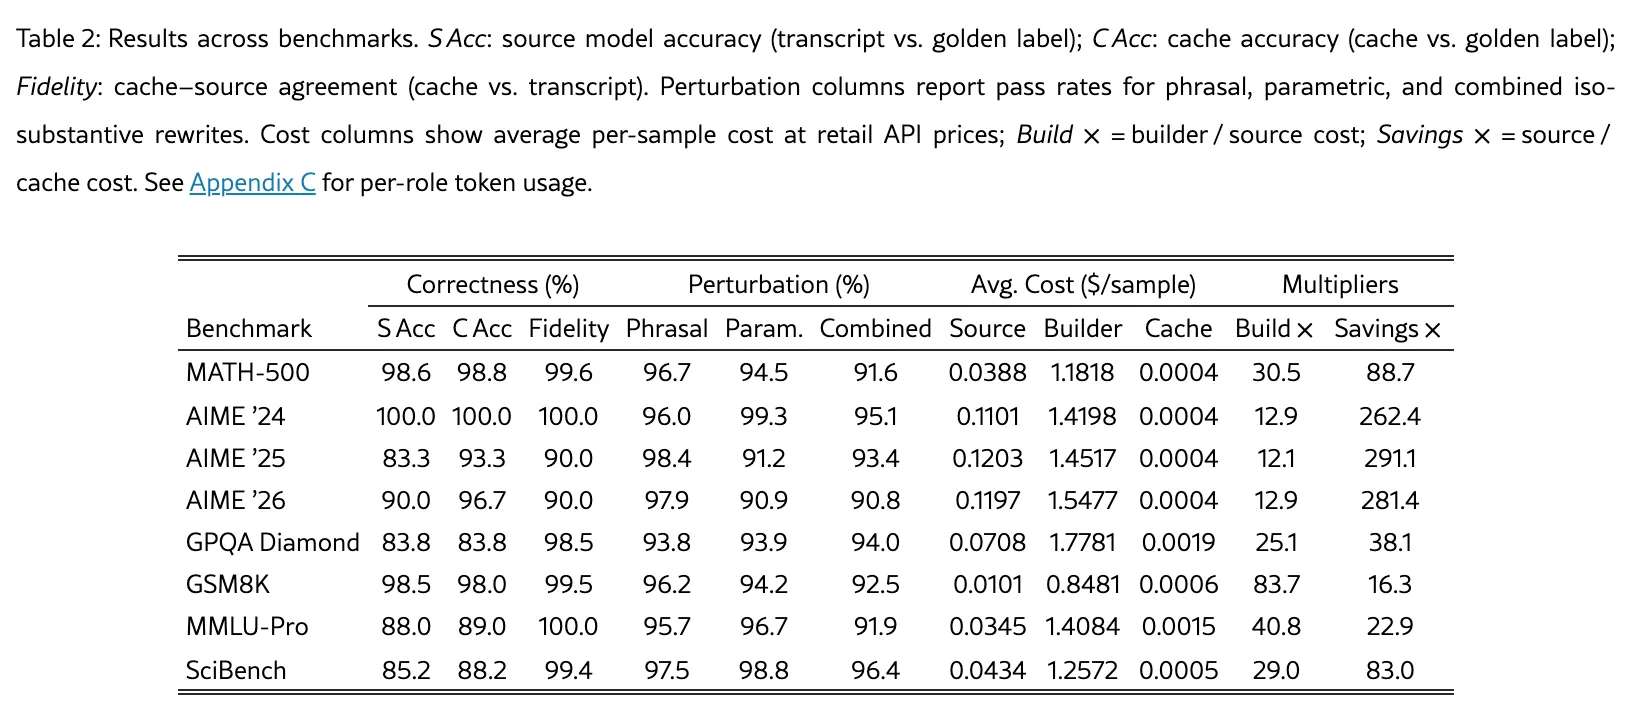
| 基準 | 來源正確率 | 快取正確率 | 一致度 | 建置成本倍數 | 單次節省倍數 |
|---|---|---|---|---|---|
| MATH-500 | 98.6% | 98.8% | 99.6% | 30.5 倍 | 88.7 倍 |
| AIME 2024 | 100.0% | 100.0% | 100.0% | 12.9 倍 | 262.4 倍 |
| AIME 2025 | 83.3% | 93.3% | 90.0% | 12.1 倍 | 291.1 倍 |
| AIME 2026 | 90.0% | 96.7% | 90.0% | 12.9 倍 | 281.4 倍 |
| GPQA Diamond | 83.8% | 83.8% | 98.5% | 25.1 倍 | 38.1 倍 |
| GSM8K | 98.5% | 98.0% | 99.5% | 83.7 倍 | 16.3 倍 |
| MMLU-Pro | 88.0% | 89.0% | 100.0% | 40.8 倍 | 22.9 倍 |
| SciBench | 85.2% | 88.2% | 99.4% | 29.0 倍 | 83.0 倍 |
逐列看會發現節省倍數的分布很不均勻,而且分布有個清楚的規律:題目越貴,編譯越划算。AIME 系列(競賽數學)每題原始成本約 0.11 到 0.12 美元、建置約 1.42 到 1.55 美元,但每次重用只要 0.0004 美元,節省倍數高達 262 到 291 倍;MATH-500 與 SciBench 落在中間,節省 83 到 89 倍;GPQA Diamond 與 MMLU-Pro 約 23 到 38 倍;GSM8K 每題本來就便宜(0.0101 美元),建置 0.8481 美元雖是八列中金額最低的,換算成倍數卻高達 83.7 倍、是八列最重的相對負擔,節省也只有 16.3 倍。換句話說,最容易算的題目經濟學最差,最難算的題目反而最有動力編譯。
論文接著給了回本算式:把一次性建置成本記為 B、來源模型每次成本為 S、快取每次成本為 C,累積省下的金額超過 B 就回本,需要的次數就是 B 除以 (S 減 C)。按論文自己的倍數估計,AIME 類題目約 13 次鄰近重用就回本,GSM8K 要約 90 次。這個算式可以直接搬到自己的工作流程裡用,只要把三個換成自己的數字:建一次函式的成本、現在每次叫模型的成本、快取命中一次的成本。
還有兩筆帳常被漏掉。快取只在命中的題目上省錢,未命中的請求照付原模型價格,整體省多少取決於命中率,不能把每次呼叫都按最大倍數計算。另外,實際服務要保存函式、管理版本、修理錯誤,這些工程成本論文沒有量測,是任何團隊自己部署前要另外估計的部分。論文倒是有個省錢細節可以學:建立階段的多輪生成迴圈本身就用了提示快取,多數輸入 token 按便宜的讀取費率計價,壓低了建置成本。
品質面,論文報告八列比較中有七列的快取正確率不低於來源模型,進步最明顯的都在競賽數學:AIME 2025 來源模型 83.3%、快取 93.3%;AIME 2026 來源 90.0%、快取 96.7%。唯一例外是 GSM8K,快取 98.0% 略低於來源的 98.5%,這個反例值得保留在視野裡,它說明編譯成程式不保證每一種題目都變準。Table 2 還有一欄常常被轉述時省略:快取與來源模型答案的一致度落在 90% 到 100% 之間,也就是即使雙方都答對,答案的呈現方式也不一定逐字相同,驗收時要比對的是最終答案與過程解釋,而非要求複製原本的輸出。
提升的原因論文自己有交代,引用時要連原因一起講:建立過程會反覆測試與挑選,推理正確的軌跡才會被留下來成為快取,等於多了一層篩選。所以這組數字描述的是「成功建立的快取」面對鄰近變化時的表現,並沒有覆蓋建置失敗的題目,把它讀成「任何模型推理轉成 Python 都會自動更準」就超出證據了。穩健性測試也在同一範圍內:把題目改寫措辭、更換參數、或兩者同時改的通過率,落在約 90.8% 到 99.3% 之間,而且只對成功建立的快取進行,改參數後的參考答案也有模型生成的環節,並非每一題都有人工獨立驗證的標準答案。
論文首頁的連結欄把它掛進 NVIDIA Research 的在地前沿智能(LFI)計畫。那個計畫頁寫的目標,是讓前沿智能在地、私有、高效率地執行,並完全在使用者的控制下,把現在集中在雲端資料中心、少數機構手裡的前沿模型,變成耗電少到連手機都跑得起的東西。CPU-ARC 與這個方向一致:把最貴的反覆推理換成便宜的程式執行,就能讓一部分智能離開資料中心。發表它的 DLER 團隊在自家頁面上給自己的任務也寫得很明白,讓智能更快、更便宜、更不耗電。不過計畫頁是研究倡議,論文也沒有提出任何產品或時程,把它讀成 NVIDIA 的產品路線圖會超出證據範圍。
目前沒有可以直接安裝的東西:arXiv 頁面與論文 PDF 的連結欄都沒有公開程式碼庫,僅有的連結是團隊頁、計畫頁與論文頁。所有數字也只涵蓋數學與科學題,寫作類的開放式任務、規則經常變動的商業流程,都不在測試範圍內;真實企業流量上的命中率與品質,論文同樣沒有驗證。
如果你的工作流程裡有「同一套指令、不同數字或資料」的重複流量,這篇論文給的框架可以直接套用,而重複性工作的計費這一年也正在被各家重新定義,值得一起看。舉幾個形狀接近的例子:固定口徑的報表數字更新、欄位固定的表單分類、格式一致的文件抽取,這些任務每次只是數值與內容變,解題邏輯不變。判斷順序是先統計同一種解法形狀實際出現的頻率,再按 B 除以 (S 減 C) 估出回本次數,超過門檻才值得考慮建立快取,低於門檻的流量繼續走原模型。論文自己建議的落點也是這個方向:裝在處理重複性高、指令相近請求的端點上,並保留大型模型作為未命中與失敗時的備援。要回查的訊號很明確:這篇目前是 11 月 6 日的 v1,之後若出現 v2、官方程式碼或 NVIDIA 部落格公告,費用倍數與回本估計都要重算一次。