TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

ModelScope 開源 EntroPack,讓 PyTorch 張量壓縮擺脫四與八位元的固定選項,可設定非整數目標位元率把權重塞進指定記憶體預算。官方基準顯示解碼時間與實際占用仍有代價,換不換要連任務品質一起看。
用 AI 摘要這篇文章:
10 月 14 日,ModelScope 的官方帳號在 X 發出宣佈:開源 EntroPack,一套給 PyTorch 用的張量壓縮庫,標榜按 GPU 記憶體預算設定任意位元率,把模型權重壓到剛好塞得進那張卡。宣佈文字裡的關鍵詞是 calibration-free,不用跑校準資料、不用微調,拿到權重直接壓。
這件事改變的是選擇方式。過去壓模型多半在四位元與八位元之間跳檔,選了哪個精度就吃哪個檔位,GPU 剛好剩三點多個位元空間時,往下跳一檔浪費品質、不跳又放不下;EntroPack 把目標位元率變成 0.001 到 11 之間可以任意填的數字,對「差一點就塞不進某張顯示卡」的部署場景,離散的跳檔選擇變成了連續調整。不過官方文件同時把代價寫得很明白:壓完的權重推論時要解碼,每一步都會多花時間,誤差也真實存在。值不值得換,得把空間、速度與輸出品質放在一起算。
把時間軸對齊,會發現這場宣佈的節奏比貼文日期更早展開。GitHub 儲存庫的第一個 commit 落在 9 月 23 日;9 月 28 日同一天,論文放上 arXiv、第一個 PyPI 套件 0.1.0 上架、ModelScope 上的預壓縮權重包頁面也建立完成;接著 10 月 12 日推出 0.1.2,10 月 15 日再推 0.1.3。X 上那則宣佈文發在 10 月 14 日,距離程式碼實際公開已超過兩週。
這個時間差對讀者有兩層意義。其一,宣佈的並非剛推送的原型,而是一個已經連發四個版本、連文件站都建好的作品,README 還附了中文版。其二,專案仍然非常年輕:儲存庫至今只有 19 個 commit、22 顆星與 1 個 fork,沒有打過任何 release tag,PyPI 是唯一的版本化發佈管道;最新的 commit 落在 10 月 15 日,內容是線性層緩衝區的重構,開發仍在一線上。授權採 Apache 2.0,商業使用沒有額外條款負擔。
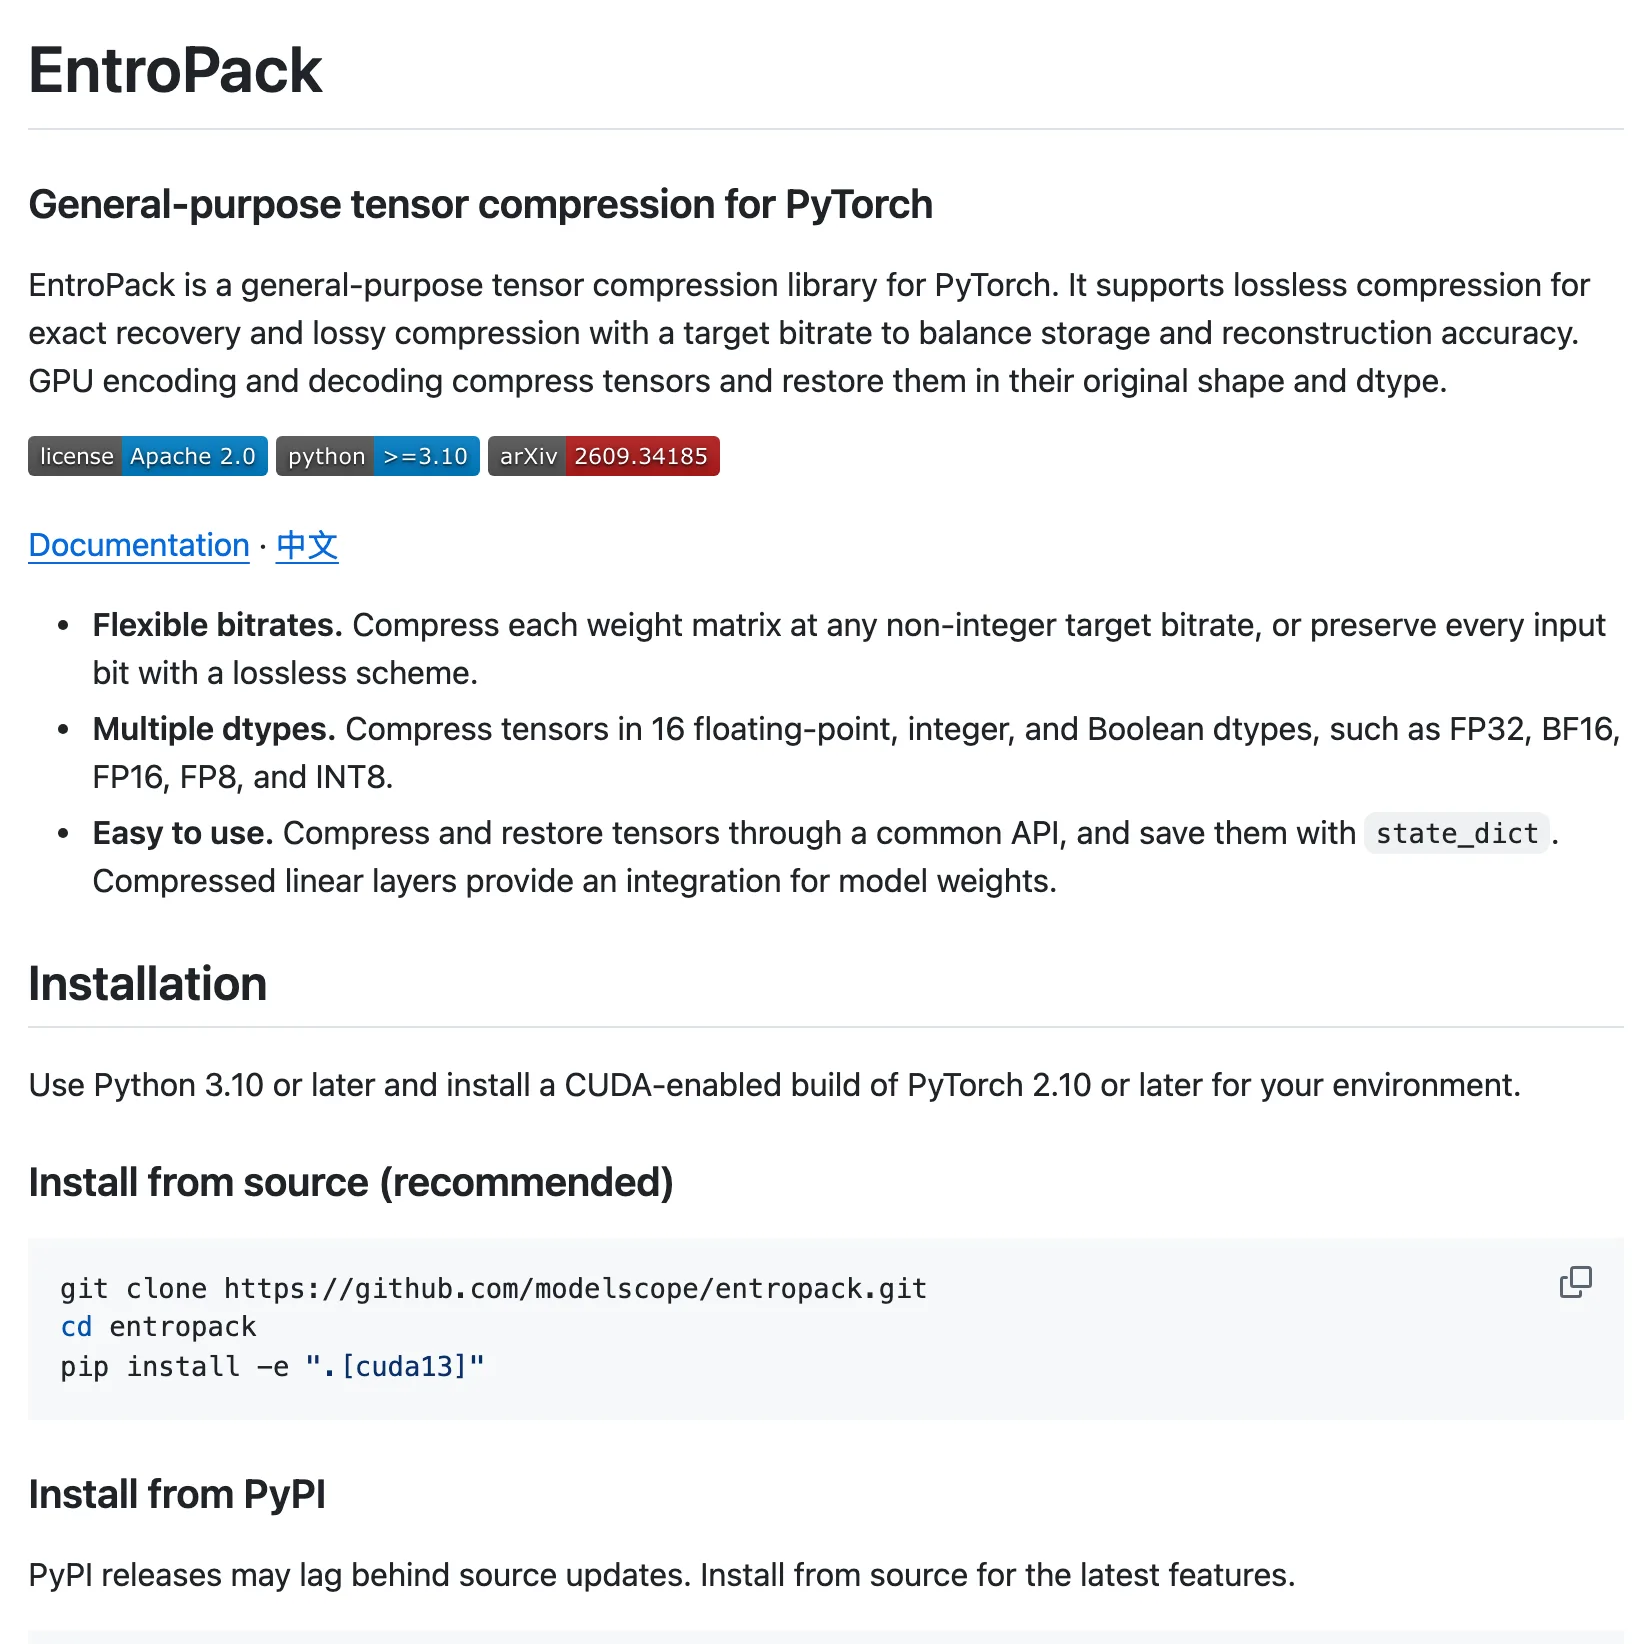
要理解 EntroPack 與固定精度量化的差別,先看官方快速上手的一組例子。設定目標位元率 3.5,程式壓完後會回報兩個數字:目標值是你指定的 3.5,實際值則包含還原所需的詮釋資料,通常略高於目標。官方效能段落給的實例是:目標 4.0,實際占用 4.02。位元率的概念可以用白話講,每個模型參數平均分到多少位元的儲存空間;目標 3.5 代表一百萬個參數的資料部分約占三百五十萬位元,而不是硬體上真有半個位元這種東西。
壓縮與計算精度也是脫鉤的。套件支援 BF16、FP16、FP32、FP8、INT8 等共 16 種資料型態,涵蓋浮點、整數與布林,壓的是權重怎麼存放,解碼後仍恢復原本的形狀與型態。整套 API 也走日常 PyTorch 的習慣:壓縮用一個函式呼叫,還原用另一個,回傳的張量接著用就行,壓縮結果還能跟著 state_dict 一起存進檢查點。有損方案目前限於二維的浮點與整數張量,這個邊界文件寫得明白,模型裡常見的線性層權重正好都是二維,套用沒有障礙,但其他形狀的張量就要走無損路線。
論文對方法的描述可以簡化成兩步:先把權重放上一種高維度、排列均勻的座標網格做量化(論文用的結構叫 E8 lattice),再把量化後出現頻率不同的值做不等長的熵編碼,常見的值用短碼、罕見的值用長碼,而且切成一塊塊可獨立解碼的單元,讓 GPU 能在推論現場邊解邊算。挑量化粗細的方式也務實:用取樣估計儲存量來決定解析度,避免為了試一個位元率就把整份權重完整編碼一次。這套設計的血緣不難追溯,README 致謝的先例包含 DFloat11、DietGPU 與 tile-ANS 等既有壓縮研究,差別在於把「任意位元率、免校準、GPU 解碼」三件事組進同一個可直接安裝的套件。
另外還有一條無損路線。除了有損壓縮,套件提供兩種無損方案:DFloat11 專做 BF16 張量的逐位元還原,官方定位是給需要精確取回的應用;TileANS 支援多種資料型態但壓縮比依資料分布浮動。需要把權重原封不動取回的場景,走這條路;願意用誤差換空間的,走任意位元率那條路。文件站為三種方案各寫了一頁原理說明,參數上限也依資料型態分列,挑選前值得花十分鐘讀過。隨著模型參數量一路往上疊,像 七百多 B 參數級的預覽模型都得先問「跑得動嗎」,權重存放空間的調整粒度,正慢慢變成部署決策裡的獨立變數。
README 的效能段給了一組完整數字:在 NVIDIA H20 上,把圖片生成模型 Z-Image-Turbo 擴散主幹的全部 276 個線性層以目標 4 位元壓縮,壓縮本身只花 3.5 秒;壓完權重實占 4.02 位元,相對 L2 重建誤差 7.18%;用這組權重跑推論,每個去雜訊步驟 544.7 毫秒,比原本 BF16 的 505.7 毫秒慢 7.7%。以 BF16 換算,4 位元目標約是把權重存放空間壓到原本的四分之一;每步多出的 39 毫秒,累積到整張圖的生成流程裡,就是每 10 步多等將近 0.4 秒,慢得有限但要計入。壓縮那 3.5 秒也要擺對位置:它是部署前的一次性成本,之後每次推論面對的都是解碼,兩種時間不能混著比。
兩個數字還要正確解讀。相對 L2 誤差 7.18% 量的是壓縮前後權重本身的距離,它不等於輸出圖片的品質分數;同樣的權重誤差在不同層、不同任務上造成的影響可以差很多,這正是官方另做輸出層級比較的原因。而每步 7.7% 的延遲,只描述去雜訊步驟這一段,模型載入、文字編碼、VAE 解碼都不在其內,拿它推算整體速度變化會失真。
這組是官方自測數字,機器只有一台 H20,採用時該當宣稱看。論文另給了一個對照點:同樣 4 位元目標下,EntroPack 的相對 L2 權重誤差比 NF4 低約 24%,占用空間也更小。NF4 是 QLoRA 微調常用的四位元格式,在壓縮圈外也有能見度;這個比較目前只有作者自己的量測,願意深究的讀者可以先把它當初步參考,定論得等獨立量測。
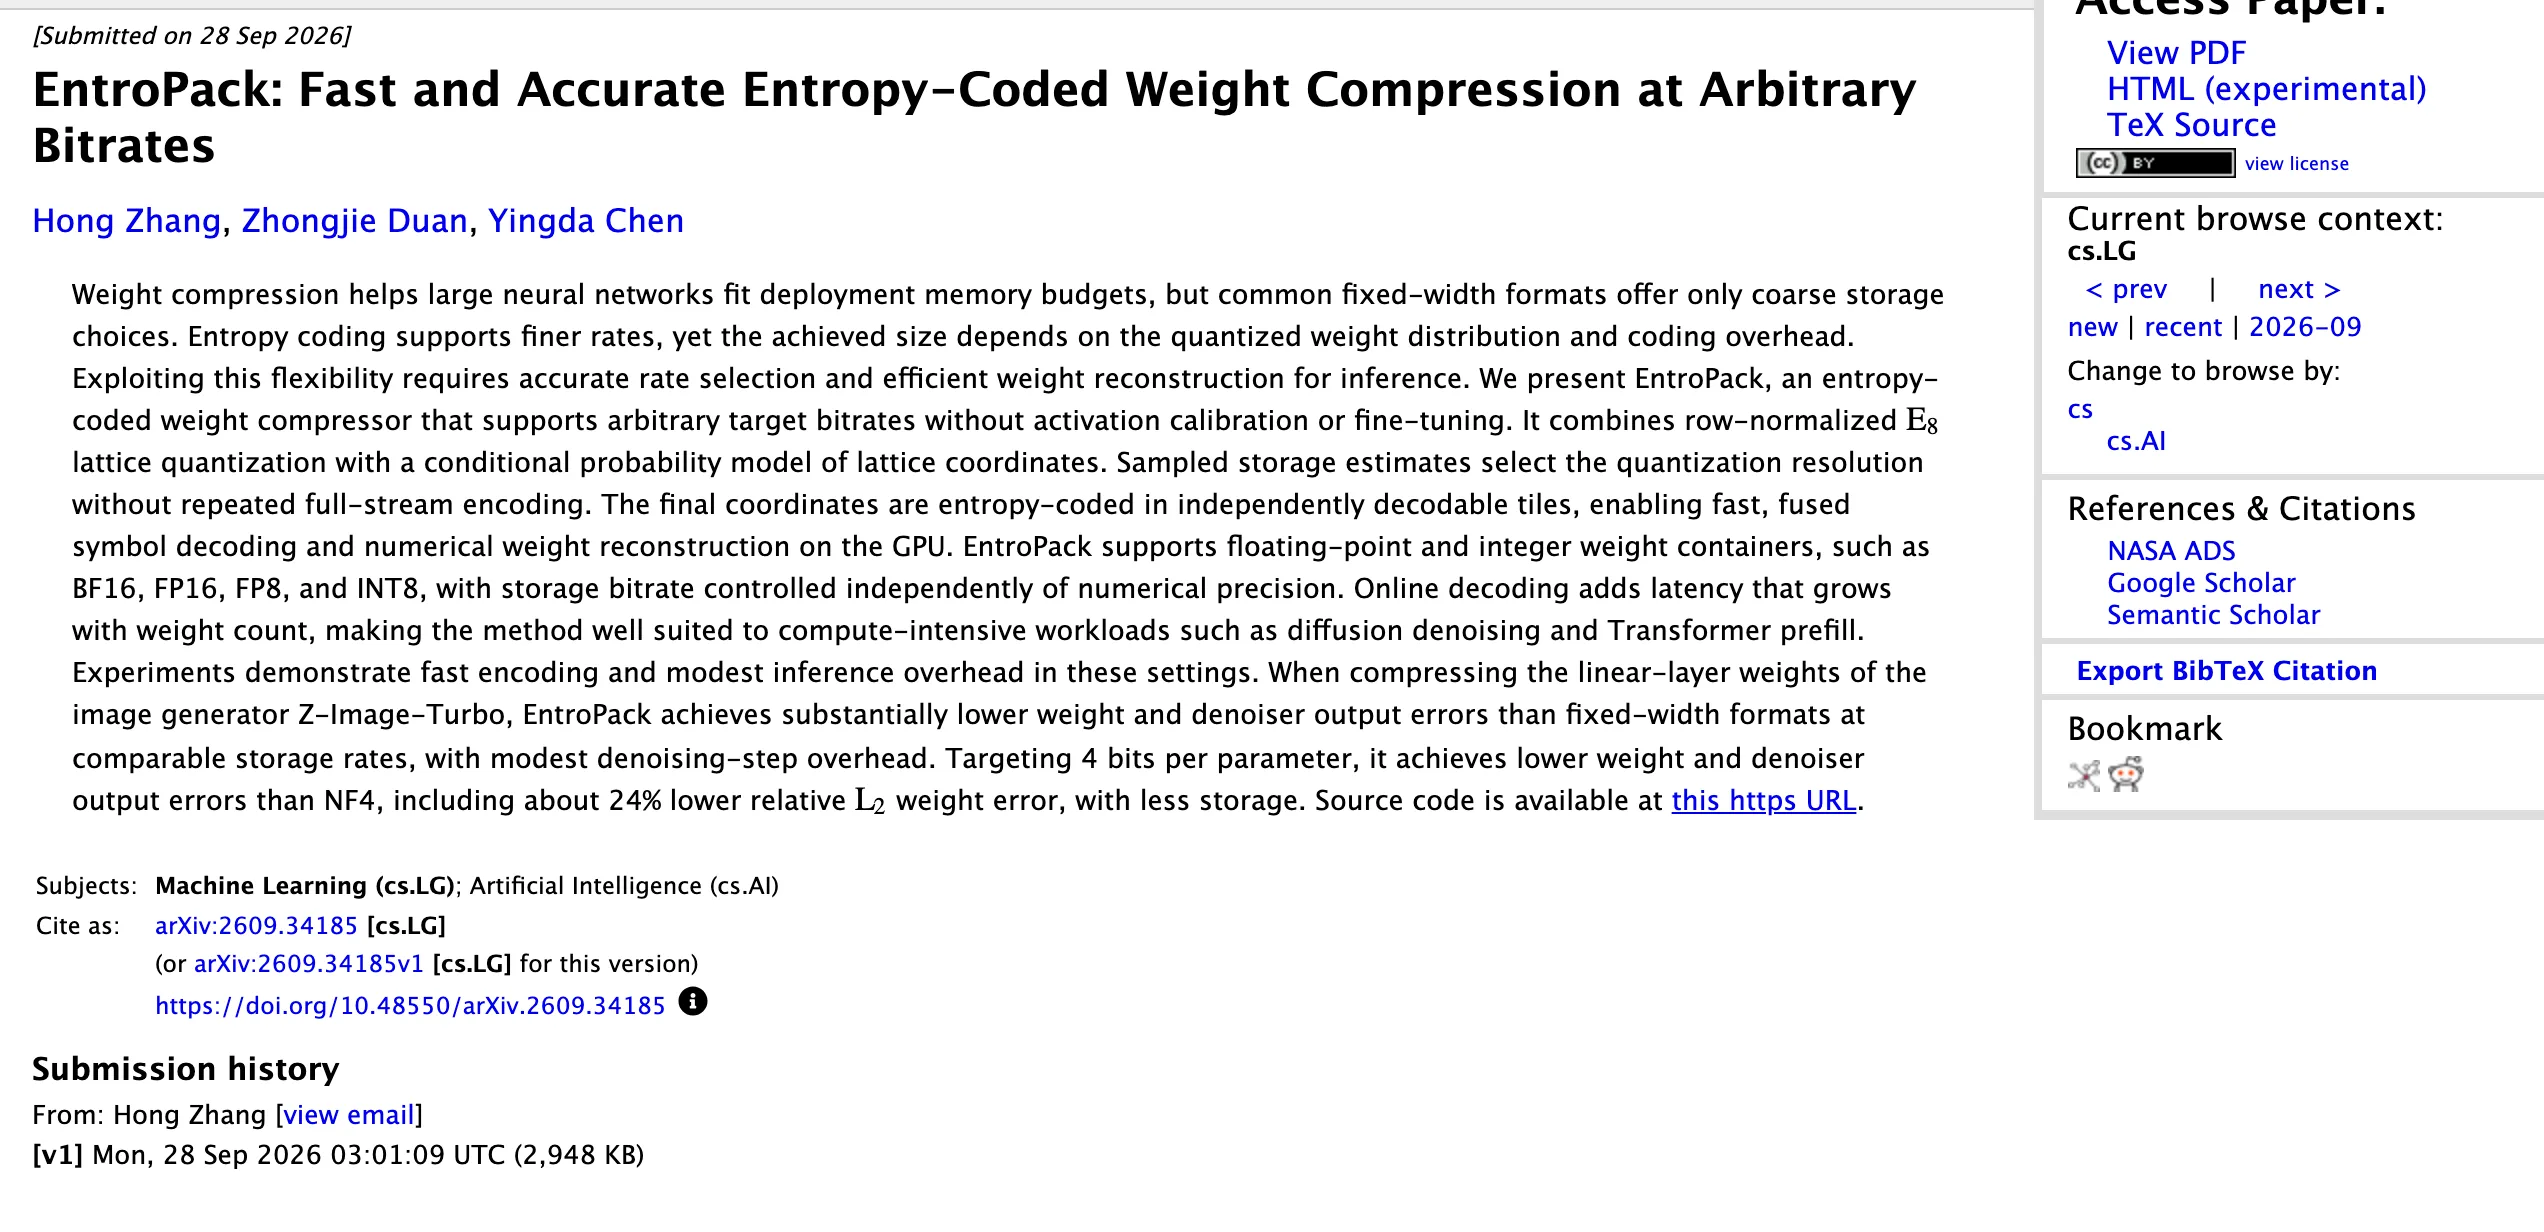
更關鍵的邊界寫在論文摘要裡:線上解碼的延遲會隨權重數量成長,方法適合算力密集的負載,例如擴散模型的逐步去雜訊、Transformer 的 prefill 階段。換句話說,若你的瓶頸是記憶體不夠而計算量充足,多花的解碼時間容易被吃掉;若工作負載本身輕、對延遲又敏感,每一步 7.7% 的代價就會被放大。這也是為什麼判斷「塞不塞得進」之前,先弄清楚自己的卡到底跑不跑得動模型仍是第一步,壓縮解決的是空間,解決不了算力。
不想自己動手的讀者有現成入口。ModelScope 上的 EntroPackPreQuants 套件頁提供三個擴散模型的預壓縮權重:Z-Image-Turbo、Qwen-Image 2.1 與 MiniMax-H3,透過開源工具庫 DiffSynth-Studio 載入,該工具庫本身也是 Apache 2.0 授權、一萬三千多顆星的活躍專案。打開套件頁的檔案清單,結構一目瞭然:每個模型的主幹(DiT)與文字編碼器各有 4、5、6、7、8 位元五種版本,每種版本是一對 JSON 設定檔加 safetensors 權重檔,要哪個位元率就抓哪個,不必重算。五種位元率並列還有一個好處:可以先抓 8 位元試水溫,品質可接受再往下換 6、5 位元,每次只動一個變數,出問題時容易回頭。
兩種特殊包值得多看一眼。FP8 版把 FP8 權重碼壓到 5 位元存放,推論時走 FP8 矩陣乘法,等於存放與計算兩邊都吃低精度紅利;極端混合位元版則按每一層對誤差的敏感度分配預算,敏感的層多留位元、遲鈍的層壓到底,Z-Image-Turbo 壓到 2.3 位元,Qwen-Image 2.1 與 MiniMax-H3 壓到 3.0 位元,以 BF16 換算分別約是原本的七分之一與五分之一。這個思路與常見量化實作裡的混合精度同源,差別在預算可以細到非整數。
三個模型剛好橫跨圖片與影片生成:Z-Image-Turbo 與 開放權重的 Qwen-Image 2.1 是圖片模型,MiniMax-H3 則有兩個擴散主幹(檔名裡的 FL2VA 與 REF2VA)共用同一組文字編碼器與影片 VAE。值得注意的是,現成包只到擴散模型為止,沒有現成的大型語言模型包;要壓自己的模型,套件提供把線性層換成壓縮層的整合方式,一行 from_linear 呼叫就能替換,替換後的層照常接受輸入、回傳輸出。從一小段開始替換、對照前後輸出,比整包替換更容易定位問題。
安裝條件畫出了適用範圍。官方要求 Python 3.10 以上、PyTorch 2.10 以上而且必須是 CUDA 版,搭配的 CuPy 套件分 CUDA 12 與 13 兩種安裝選項,一條 pip install “entropack[cuda13]” 裝完。整條路徑都指向 NVIDIA 顯示卡;官方安裝說明沒有提供 CPU 或其他廠牌的路線,已經裝好相容 CuPy 的人可以省掉附帶安裝。在 Mac 或 AMD 顯示卡上跑模型的讀者,這套工具目前幫不上忙,同樣需求得等其他方案。PyPI 版本可能落後原始碼,要最新功能得從 GitHub 原始碼安裝。
版本面的提醒同樣實際。專案仍在 0.1.x 階段:0.1.0 在 9 月 28 日上架,隔天 0.1.1,10 月 12 日 0.1.2,10 月 15 日 0.1.3,API 有調整空間,儲存庫上連一個正式 release tag 都還沒有。對願意早期採用的人,這代表功能推進很快;對要寫進正式部署的人,這代表鎖定版本、留下重測紀錄是必要動作。文件資源倒是齊全:readthedocs 文件站從快速上手、參數參考到三種壓縮方案的原理頁都有,GitHub 上也附了中文版 README。
分幾種情況看。模型本來就放得進、推論速度也夠用的人,沒有理由為了壓縮而壓縮,多一層解碼只會多一份變數。剛好差一點空間、而且跑的正是那三個模型的 NVIDIA 用戶,最划算的第一步是直接抓預壓縮包,用同一組輸入對比壓縮前後的品質與時間。要壓自己的模型,就從線性層的小範圍替換開始,保留未壓縮版本當對照基準,把位元率、版本號與測試輸入一起記下來,之後升級才知道要重測哪些東西。
不確定的部分也要攤開:H20 以外顯示卡的解碼延遲、實際生成品質的差異、大型語言模型端到端的效果,目前都只有官方單機自測與 NF4 單點比較,沒有獨立第三方驗證。極端混合位元包壓到 2.3 位元後輸出還剩多少可用性,文件沒有給圖例,採用前要自己驗。有幾個訊號出現時,這篇的結論就該更新:獨立測試上站、預壓縮包清單長出語言模型、或其他熵編碼壓縮專案跟進同樣的任意位元率介面。
最後是保存期限。這篇的數字以 10 月 15 日的 README 與 0.1.3 版為準;以專案三週四版的節奏,下一個版本隨時可能改寫效能與介面。回查時看三個地方就夠:PyPI 的版本號、GitHub 的 commit 記錄,加上文件站的參數範圍。任意位元率這條路現在有了開源實作,至於它會不會變成部署標配,要看接下來幾個版本長出什麼。