TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

AI 技能附帶的說明檔與腳本會以使用者權限執行,安裝前值得先掃一次。本文用 NVIDIA 開源的 SkillSpector 實測:乾淨測試技能掃出 0 分 SAFE,塞了憑證讀取與指令覆寫的版本得 59 分與四項發現。靜態與語意分析是兩種證據,語意模式會把技能內容送給語言模型服務;26.1% 漏洞統計的樣本來自第三方市集,與官方目錄是兩群技能。掃完零分只代表靜態可見的已知模式沒有命中,沙箱隔離與簽章驗證仍是另外兩層。
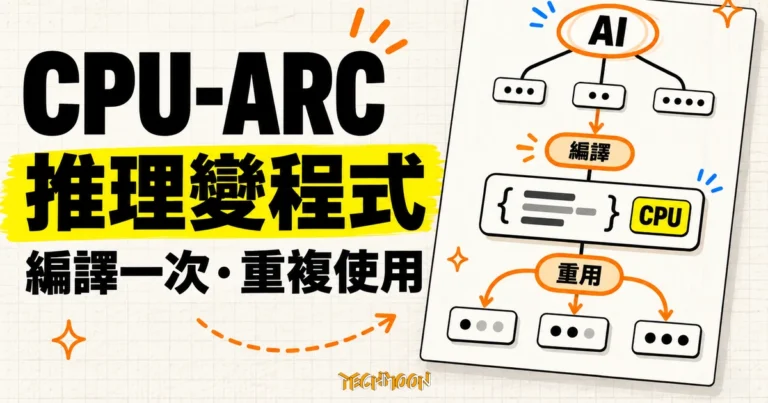
NVIDIA 研究團隊 2026 年 11 月在 arXiv 發表 CPU-ARC,把 Claude Opus 4.5 的解題推理編譯成 CPU 可執行的小程式:重用一次成本剩十六分之一到二百九十一分之一,建置要先花十二到八十四倍,AIME 約 13 次回本、GSM8K 約 90 次。Table 2 八列數據與尚未驗證的部分一併整理。
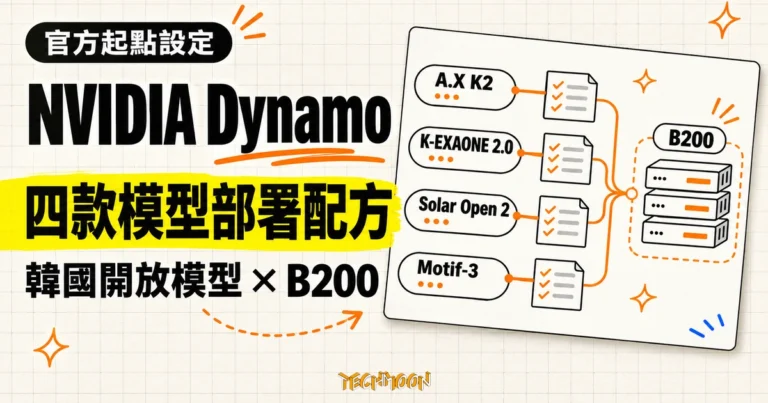
NVIDIA 把 SK telecom A.X K2、LG K-EXAONE 2.0、Upstage Solar Open 2 與 Motif-3 整理成 Dynamo 部署配方,B200 卡數、精度與推測解碼都有官方範例。分離配置多一倍卡每卡吞吐持平、首 token 等待變長,兩倍宣稱未附對照組,MoE kernel 釘選與正確性驗收仍留在部署方。
黃仁勳在 GTC Berlin 受訪回應 AI 債務疑慮:GPU 可用七至八年的殘值主張,與同日公布的 DSX POD 貨櫃工廠構成一套融資論述。本文以官方逐字稿與新聞稿對照,拆開部署端與資產端的證據強度:一端有 14 天部署與 2027 年交付日期可回查,另一端目前只有賣方單方估計。
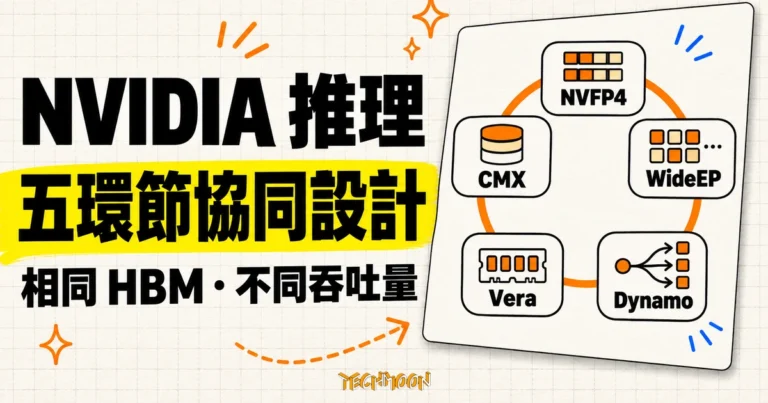
NVIDIA 技術部落格 11 月 5 日刊出記憶體協同設計解析,說明 Vera Rubin NVL72 如何在單卡 288GB HBM 與前代相同的條件下,靠 NVFP4、寬專家並行、Dynamo、Vera CPU 與 CMX 五個環節把每兆瓦推理吞吐量拉開最高三十倍。每個倍率數字各有對照組與前提,KV 快取也從各 GPU 的副產品變成艦隊共管的分層資源。
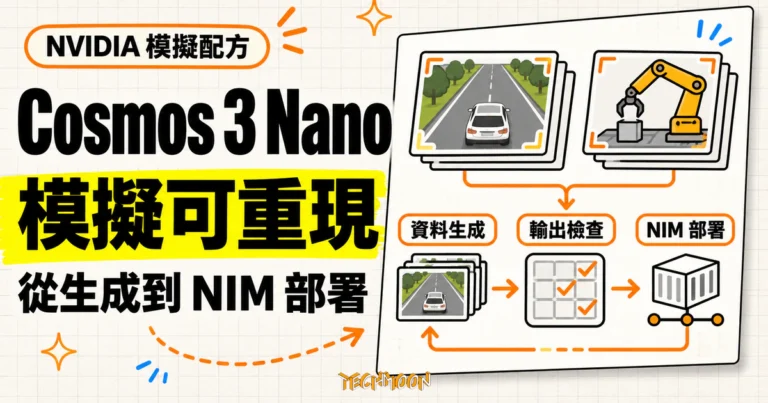
NVIDIA 在 11 月 2 日的技術文章裡,把 8 月底就建立的 Cosmos 3 Nano 檢查點接上新整理的模擬配方與 NIM 部署容器:Transfer-Auto 雙向生成做離線資料、Sim-Auto 串流生成陪政策做封閉迴路測試,同一條路換天氣不換軌跡,記憶體需求與兩層授權邊界整理成表。
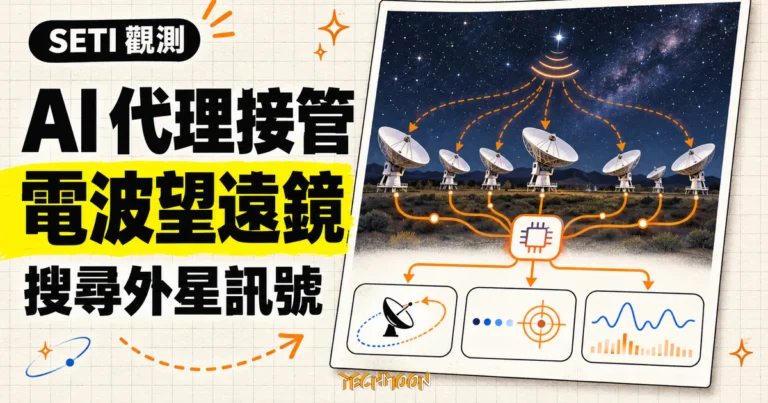
NVIDIA 在 10 月 30 日宣布 Breakthrough Listen 與 SETI Institute 把代理式 AI 帶進 Allen Telescope Array,一句自然語言就能轉動天線、校正儀器、修正資料錯誤。但蟹狀星雲脈衝星的即時 AI 偵測是 2024 到 2025 年就完成的管線驗證,每秒 2.4Tb 是吞吐宣稱,代理框架 Nexus 的程式碼目前也尚未公開。
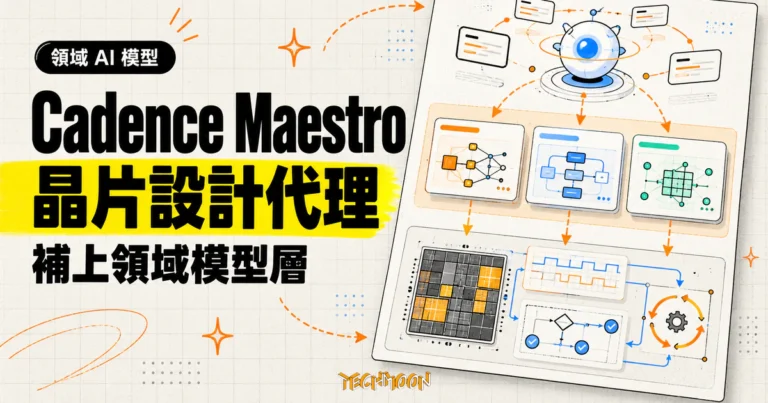
Cadence 在 10 月 26 日發布 Maestro 領域 AI 模型組合,為既有四個 AI Super Agent 補上自家的模型層。官方數字 up to 30% 品質提高與 5 倍 token 效率,量的是設計工作流初期結果、分母是通用基礎模型;Socionext 的 5 倍是客戶期待值,40 倍加速則是 6 月 ChipStack 的舊數字。首批模型 2026 年第四季只給選定早期客戶,部署可選 Cadence 雲、公共雲或客戶地端。
NVIDIA 與德州大學奧斯汀分校的 ScheduleGen 研究把多臂機器人的示範生成拆成兩層:接觸技巧沿用示範、轉場重新規畫,兩手何時等待或重疊交給混合整數線性規劃求解,排程本身也用 700 段固定路徑軌跡單獨驗證。79.6% 生成率、65.5% 策略成功率與真機 50–80% 各自量測不同的階段,直接互比會誤讀;程式碼未公開,是採用前最主要的邊界。
NVIDIA 在 2026 年 10 月 30 日介紹開源診斷工具 gds-diag,用一組可重複執行的檢查釐清儲存到 GPU 的資料路徑是否真的直達,還是靜靜退回經 CPU 的相容模式,並提供 Claude Code 與 Codex 可用的 Agent Skill。實測在沒有 GPU 的機器上跑 pre-install 得到三個 FAIL 與退出碼 1;工具不自行改系統,代理判讀也有明文的沙盒邊界規則。



