TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA 在 2026 年 10 月 30 日介紹開源診斷工具 gds-diag,用一組可重複執行的檢查釐清儲存到 GPU 的資料路徑是否真的直達,還是靜靜退回經 CPU 的相容模式,並提供 Claude Code 與 Codex 可用的 Agent Skill。實測在沒有 GPU 的機器上跑 pre-install 得到三個 FAIL 與退出碼 1;工具不自行改系統,代理判讀也有明文的沙盒邊界規則。
用 AI 摘要這篇文章:
NVIDIA 在 2026 年 10 月 30 日於技術部落格介紹開源診斷工具 gds-diag,連同一個可以讓 Claude Code 與 Codex 使用的 Agent Skill。工具的承諾可以用一句話說完:把「儲存設備到 GPU 顯示記憶體的資料路徑到底有沒有走對」這件事,變成一組可重複執行、有明確輸出的檢查,而不是靠經驗猜。
我把工具抓下來實際跑了一遍。在一台沒有 NVIDIA GPU 的 Mac 上,pre-install 檢查照樣執行,回報 3 個 FAIL、6 個 WARN、3 個 PASS,頭一個 FAIL 就是「GDS is Linux-only. Detected: Darwin.」,行程以退出碼 1 結束。整個過程不需要安裝任何第三方套件,只要 Python 3.8 以上。這也順便劃出工具的服務對象:管理 Linux GPU 主機或容器的團隊,例如自建推論伺服器或研究叢集的單位。
GPUDirect Storage(GDS)的目的,是讓儲存設備的資料不必先繞進 CPU 與系統記憶體,直接送進 GPU 的顯示記憶體。工具文件列出四種資料路徑:靠 nvidia-fs 核心模組的原生直達、PCIe 對等傳輸(在 Grace 系列 ARM 平台是 C2C)、走 InfiniBand 或 RoCE 的 RDMA,以及相容模式(compat)。
相容模式是這套檢查存在的理由。它讓資料先暫存在 CPU 端再搬進 GPU,工作可以照常完成,程式也不會跳出錯誤,但資料其實沒有走原本期待的直接路徑。驅動版本、檔案系統、容器啟動參數,任何一環沒對上,都可能讓部署靜靜退回相容模式。換句話說,「應用程式能跑」與「資料直達 GPU」是兩個獨立的問題,後者需要另外檢查。
gds-diag 檢查的就是後者。公告出自 NVIDIA 資深軟體工程師 Phil Carns,官方形容這個工具由 GPUDirect Storage 團隊開發,變更紀錄上的提交者也看得到同一個名字。文中直白地說:官方文件已經詳細描述各平台與儲存方案的設定方式,但管理者得自己在一堆文件裡導航;gds-diag 把「盤點環境、找出阻礙、給出緩解方向」整理成一個命令列工具,並附上結構化的 JSON 輸出,方便接進其他流程或存檔備查。
這不是 NVIDIA 第一次推出 GDS 檢查工具。CUDA 的 GDS 套件裡本來就內建 gdscheck,裝好 GDS 之後可以拿來驗證安裝狀態。gds-diag 的差別在於把檢查分層:依部署階段與問題類型拆成七個子命令,各自回答不同的問題。
| 子命令 | 回答的問題 |
|---|---|
| all | 從哪開始都不確定時,跑一輪建議的完整診斷 |
| pre-install | 主機還沒裝 CUDA 與 GDS,條件夠不夠 |
| post-install | 裝好之後,執行環境與版本組合對不對 |
| mount-check | 某個實際掛載路徑能不能走直接路徑 |
| config-audit | 生效中的 cuFile 設定,或候選設定檔內容合不合理 |
| container-check | 容器內看得到必要的裝置、檔案與工具嗎 |
| support-matrix | 哪些檔案系統與儲存路徑支援哪種模式 |
七個子命令裡,all 是官方建議的起點:它會判斷現在是在主機還是容器裡,挑合適的檢查依序執行,遇到第一個不成功的返回碼就停下來,裸機、虛擬機與容器環境都適用。container-check 則專門處理容器這個最容易出錯的層:公告列出的適用環境涵蓋 containerd、Docker、Enroot 與 Kubernetes,README 也給了把工具目錄以唯讀方式掛進容器再執行的範例,自動判斷模糊時還能明確指定執行環境。
值得留意的是新舊工具的關係。檢視原始碼會發現,gds-diag 並沒有拋棄 gdscheck:config-audit 優先叫用 gdscheck -p 取得生效中的設定段,找不到才依序退到環境變數指定的檔案、/etc/cufile.json、CUDA 範本;support-matrix 也會自動偵測 gdscheck 是否存在。我在沒有安裝 GDS 的機器上跑支援矩陣時,輸出開頭明白標示這是靜態模式、而且找不到 gdscheck。這是分層共存:gds-diag 把舊工具的輸出包進更大的框架,而非取代它。相對地,機器上裝了 GDS 套件時,gds-diag 能讀到的現場資訊也會更完整。
每個子命令共用一組退出碼規則:0 代表全部通過,1 代表至少一個 FAIL,2 代表環境還沒準備好,3 代表參數用錯。這條規則寫在 gds-diag.py 的說明文字裡,我實際跑出來的行為與它一致,代表可以把 gds-diag 直接接進腳本,用退出碼決定下一步。
授權分成兩層:Python 原始碼與測試走 Apache-2.0,Agent Skill 的文件與非程式資產採 CC-BY-4.0 與 Apache-2.0 雙授權。另外,MagnumIO 儲存庫上的 gds-diag 目前版本是 1.0.0,最後一次 commit 落在 10 月 9 日,比 10 月 30 日的官方介紹早了三週;變更紀錄裡還有一段未發布的改良,預備讓 mount-check 認出 LVM、dm-crypt 這類 device-mapper 掛載並標為不支援直接路徑,理由是 GDS 解析掛載時要回溯到原始 NVMe 裝置,看不穿 device-mapper 的重新映射。看更新節奏,這份工具仍在滾動,公告日期不等於功能全部定案。
官方對執行條件寫得很保守:Linux 加 Python 3.8 以上,不需要其他相依套件。GDS 本身需要資料中心等級的 NVIDIA GPU 與 CUDA Toolkit 12.2 以上,開發團隊標明在 CUDA 12.2 與 GDS 1.7.2 以及更新的版本上驗證過,但這些是 GDS 的需求,不是 gds-diag 的相依。README 另外明言:pre-install 本來就設計給還沒安裝 GDS 的主機,support-matrix 與 config-audit 在沒有 GPU 的機器上也能用。
我用 Python 3.14.7 實測。–version 會印出工具版本與 git commit 短雜湊,對照儲存庫可以確認跑的是哪一份程式碼。pre-install 的輸出分成「執行環境版本」與「發現」兩區:前者列出核心、CUDA、驅動、nvidia-fs、libcufile 的偵測結果;後者把每個發現包成一個卡片,狀態標記、問題說明、緩解方向三件套。我的 3 個 FAIL 分別是作業系統(只支援 Linux,偵測到 Darwin)、NVIDIA 驅動未安裝、CUDA Toolkit 找不到;6 個 WARN 包括 lspci 不存在導致無法掃描 GPU、偵測不到 MLNX_OFED 或 DOCA 等。每個 FAIL 都附上具體的下一步,例如到 CUDA 下載頁取得驅動;WARN 也一樣有方向,例如先裝 pciutils 才有辦法掃描 GPU。
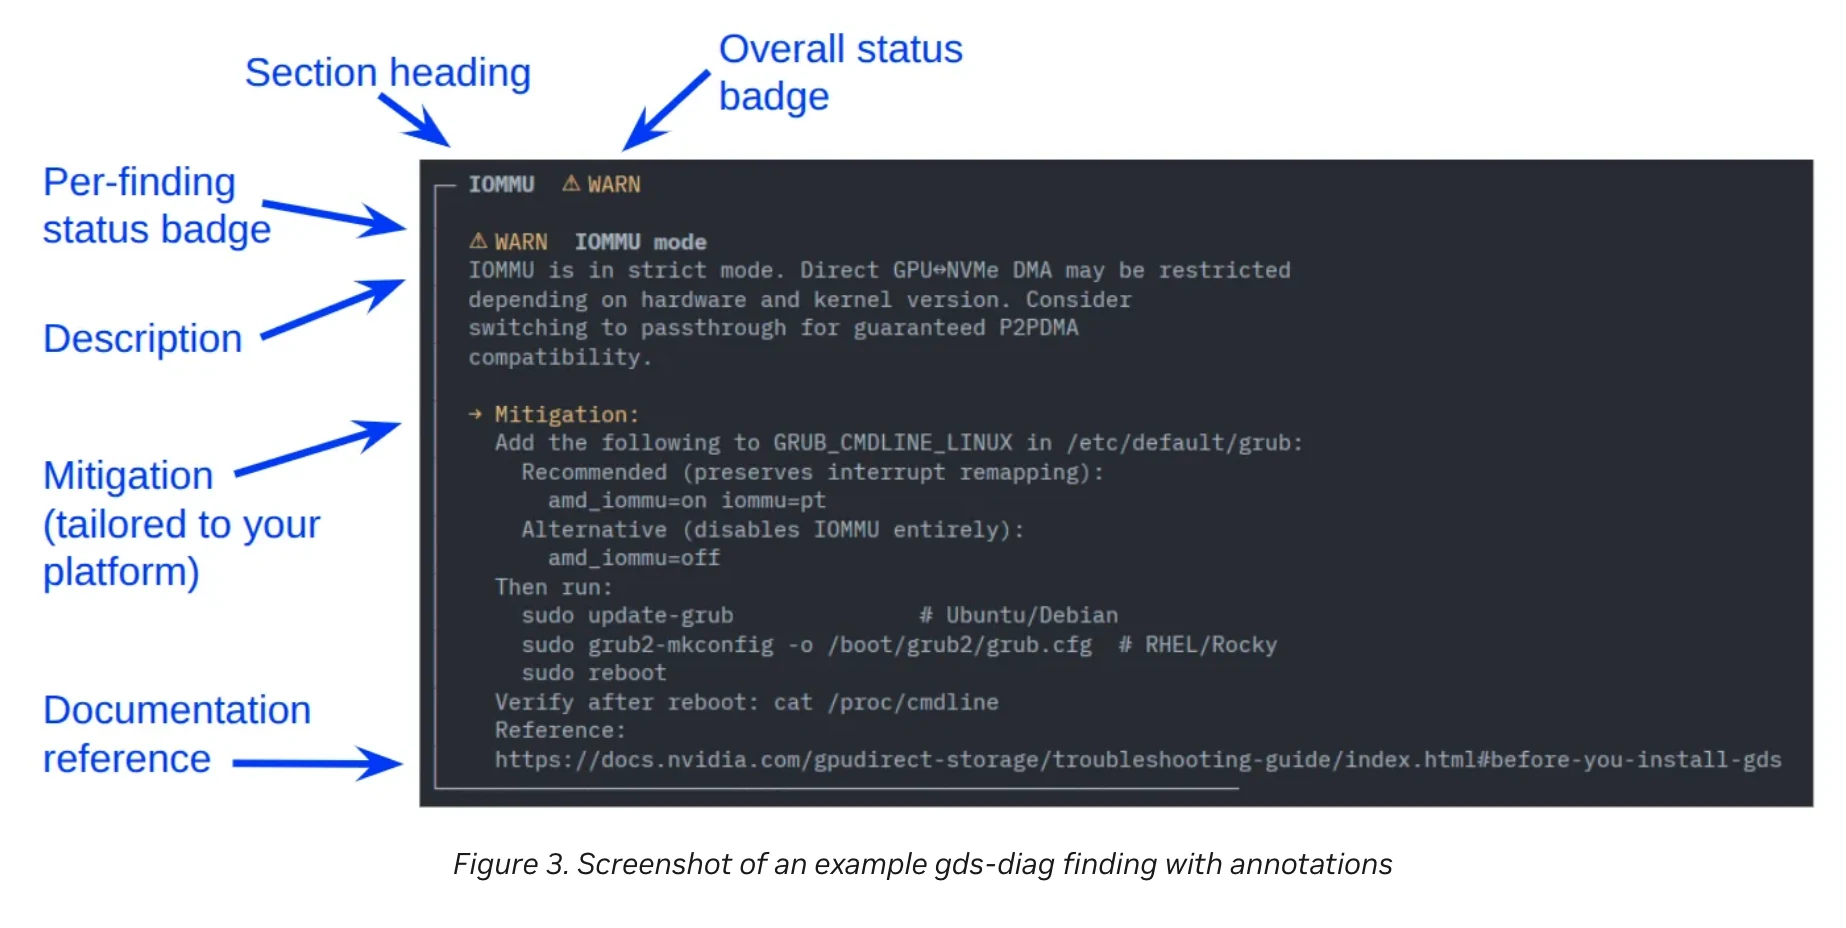
有個細節值得拿出來講:JSON 輸出裡 NVIDIA 驅動那欄註明「pre-install 刻意不用 nvidia-smi」。在還沒安裝驅動的機器上,靠 modinfo 之類的靜態證據判斷,比叫起一支需要驅動就緒的工具更合理。這種小地方的取捨,看得出工具面對的情境想得很具體。同一份 JSON 也把工具版本、git commit、各元件的偵測來源與總計數寫成固定欄位,要歸檔或餵給其他程式都不用再解析文字。人眼閱讀的終端機輸出預設只列問題,通過的項目要用 verbose 旗標才顯示,這與文件描述一致。
在 Mac 上跑還撞到一個小瑕疵:版本偵測區把 Darwin 核心 27.2.0 標成「Linux kernel」。不影響後面的 FAIL 判定,但提醒了一件事,這份工具假設的對象是 Linux 主機,跨平台體驗不在它的目標裡。
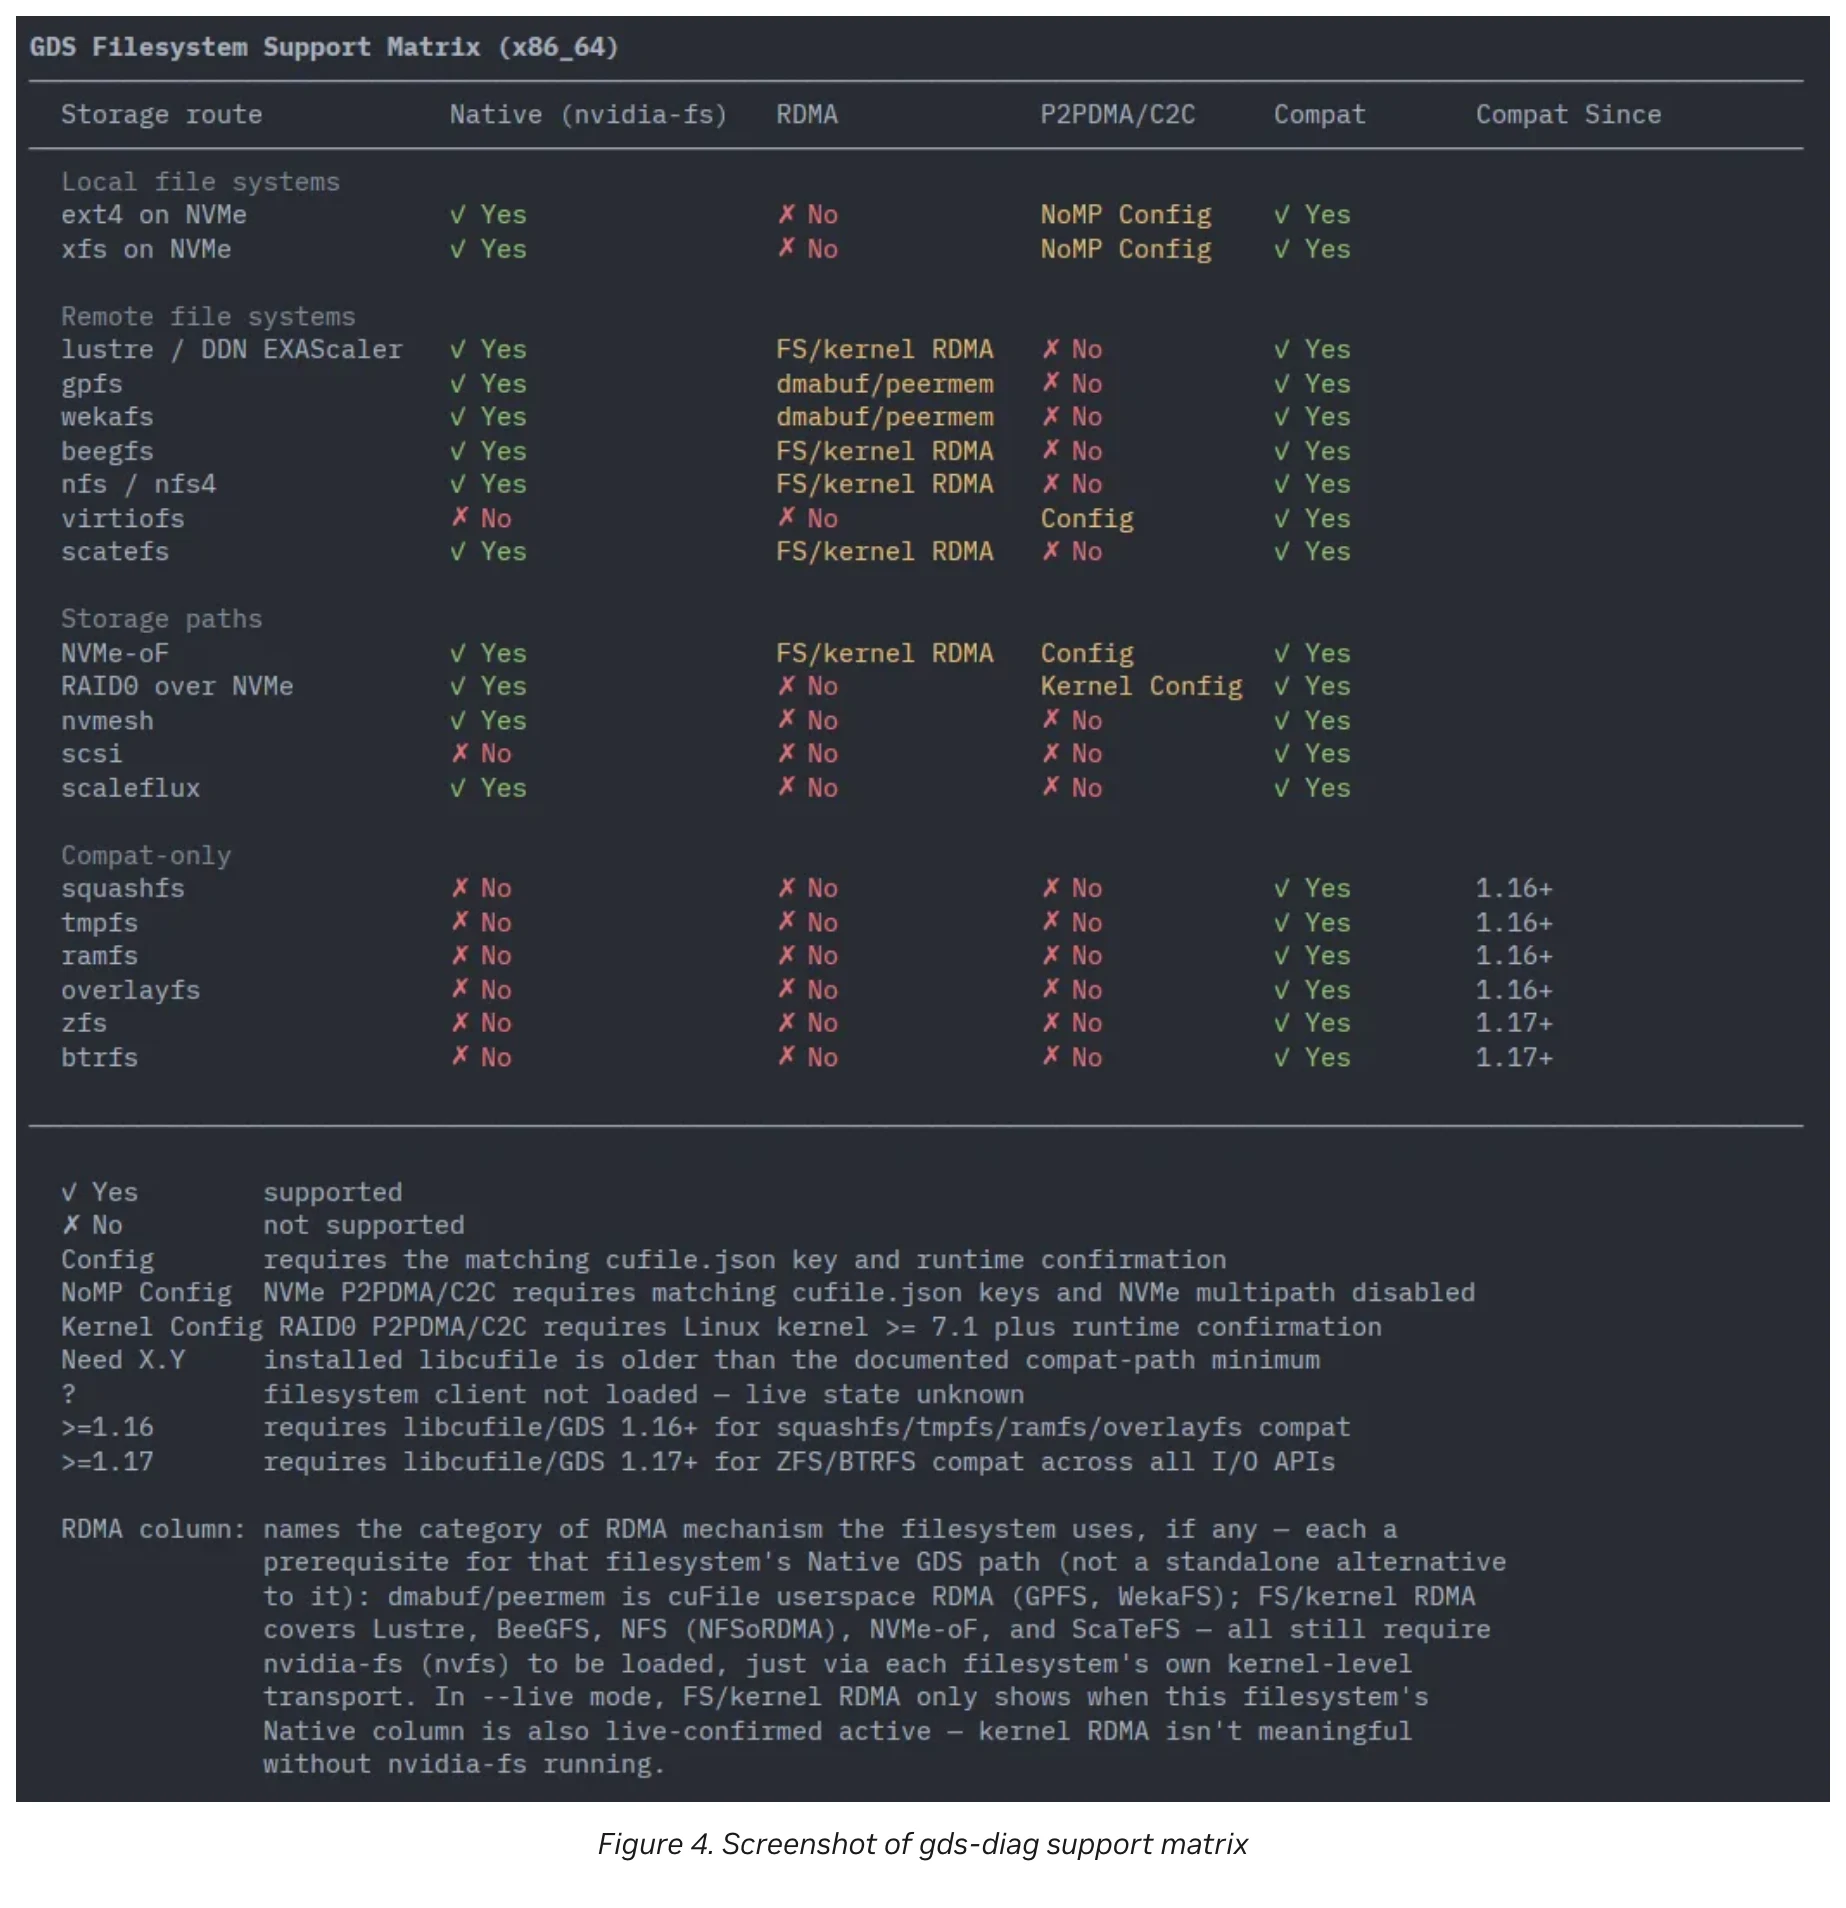
support-matrix 靜態模式的輸出是一張帶註腳的表格:ext4 與 XFS 在 NVMe 上原生支援;GPFS 與 WekaFS 走 dmabuf 或 peermem 的使用者空間 RDMA;NFS 掛的則是 NFSoRDMA 機制,註腳特別提醒這條路仍然需要載入 nvidia-fs,與本機 NVMe 的原生路徑是不同的機制;squashfs、tmpfs、ramfs、overlayfs 只能走相容模式,而且要 GDS 1.16 以上,ZFS 與 Btrfs 則要 1.17 以上。表格分成靜態與 live 兩種視角:前者回答架構上支援什麼,後者再加上目前這台機器的實際狀態。把兩種視角分開,正是「參考表」與「實測」容易混淆的地方。
官方在公告裡另示範了一段命令列流程:拿 config-audit 檢查一份準備上線的候選設定檔,工具抓出拼錯的欄位名稱,修正後再跑一次,設定得到確認並附上提示。候選檔可以先審再上線,不必為了驗內容就把主機的生效設定換掉,這對交接與變更管理都很實用。
Agent Skill 的設計立場,從 SKILL.md 開頭就寫死了:Python 程式碼是探測、解析、支援矩陣語意、設定驗證與輸出格式的唯一真相,skill 不得重做這些檢查;skill 負責的是理解操作者的目標、挑最對口的子命令、執行、然後解讀輸出。
使用方式也刻意做低門檻。把 gds-diag 目錄在 Claude Code 或 Codex 裡打開,技能會自動生效,也可以在問題裡點名 /gds-diag;儲存庫同時放了 .claude/skills 與 .agents/skills 兩條探索路徑,對應兩家代理。官方在部落格裡說工具已與 Claude 和 Codex 驗證過,其他助理或許也能用,但不在保證範圍。這種同時照顧兩家代理的對等設計,先前在讓 Claude Code 與 Codex 共用記憶的開源工作區也出現過。
這份 skill 連命令路由都寫成對照表,例如「為什麼這個掛載點在相容模式」對到 mount-check、「這台機器現在實際回報什麼」對到 support-matrix –live。公告給的範例問句還包括「這套系統有資格用 GDS 嗎」「哪顆 NVMe 裝置離 GPU3 親和性最好」,後者已經碰到位拓撲判斷。文件也誠實標出能力邊界:若使用者只給一份 cuFile 記錄檔,skill 會說明目前不解析記錄檔,改請對方提供掛載路徑或設定檔。與其他把整套流程都寫進提示詞的技能相比,這種「只路由、不重做」的約束,是在防止代理與程式各自維護一套互相矛盾的判斷規則。TechMoon 先前介紹過的代理說明文件拆分建議與把對話變成技能的建立器,處理的是同一個問題的不同側面。
至於代理能不能動手修,公告裡的官方展示是這樣的:Claude Code CLI 讀進容器的啟動腳本,判斷該用哪個子命令調查,找出啟動設定的缺口後,提出修改腳本的選項並確認。這是官方錄的展示,我沒有 GPU 主機可以重現;文件也強調,哪些動作需要確認,依本機設定與站點政策而定。工具本身則有明文:gds-diag 只指出問題與最佳化機會,附上緩解建議,不會自己改系統。官方把代理稱為能力的放大器,可以追問、可以請代理代為實施緩解,但動手與否的權限在操作環境手上。展望後續,官方也預告這個模組化架構會再納入網路傳輸、物件儲存與應用框架的診斷,並歡迎社群貢獻新的檢查。
這份 skill 最有價值的一段,可能是多數人想不到要寫的:沙盒可見性。代理的執行沙盒可能遮住 /dev/nvidia* 裝置節點,讓 nvidia-smi、gdscheck 與執行期驗證在代理內失敗,而主機上的驅動其實完好。SKILL.md 為此規定了流程:先正常執行一次;若失敗原因指向驅動不通,但 lspci、modinfo、核心記錄等其他證據顯示 GPU 存在,不得直接斷定主機壞了,要請求許可在沙盒外重跑同一條命令,並以沙盒外的結果為準;若許可被拒絕,結論必須寫明「受代理執行環境限制」,請操作者回到一般終端機再跑一次。文件甚至給了範本:在 Codex 裡透過提權機制附上理由重跑,例如詢問使用者能否允許在沙盒外存取裝置節點以驗證執行期狀態。
這條規則背後的紀律,也適用在報告的寫法上。診斷結果寫「這個容器內看不到必要裝置」是事實,省略範圍寫成「主機沒有安裝」就成了過度推論。同樣的邏輯延伸到修補之後:改了主機設定,只看主機檢查通過,並沒有回答原本那個容器的問題;要讓新的啟動設定真正生效,回到同一個容器、同一個掛載路徑重跑一次,前後結果才接得起來。而從這些檢查的性質也可以預期:移除一個阻礙後,下一個設定問題才會現身,頭一個警告消失不代表全部成立。
還不能下的結論也要先說清楚。官方沒有提供任何部署情境的加速百分比,路徑修好之後工作有沒有變快,要用相同的模型、資料與工作條件自己量測;官方展示中的代理修補流程,我沒有重現;pre-install 在 Mac 上被擋,也只代表工具的邊界誠實,不代表它在真實 GPU 主機上的診斷品質,那部分需要實際環境驗證。想追蹤後續發展,看儲存庫的變更紀錄與 GDS 疑難排解指南是最直接的兩個入口。
回到最初的分工問題:把可以重複的探測交給確定性的程式,把意圖理解與結果判讀交給代理,兩邊各自做擅長的事,再把邊界寫成文件。管理 Linux GPU 主機或容器的團隊,現在就可以在既有機器上跑一輪 pre-install 盤點缺口;至於只在雲端控制台拉模型、不碰主機設定的使用者,這套工具不會讓聊天或生圖變快,知道有這件事就夠了。