TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

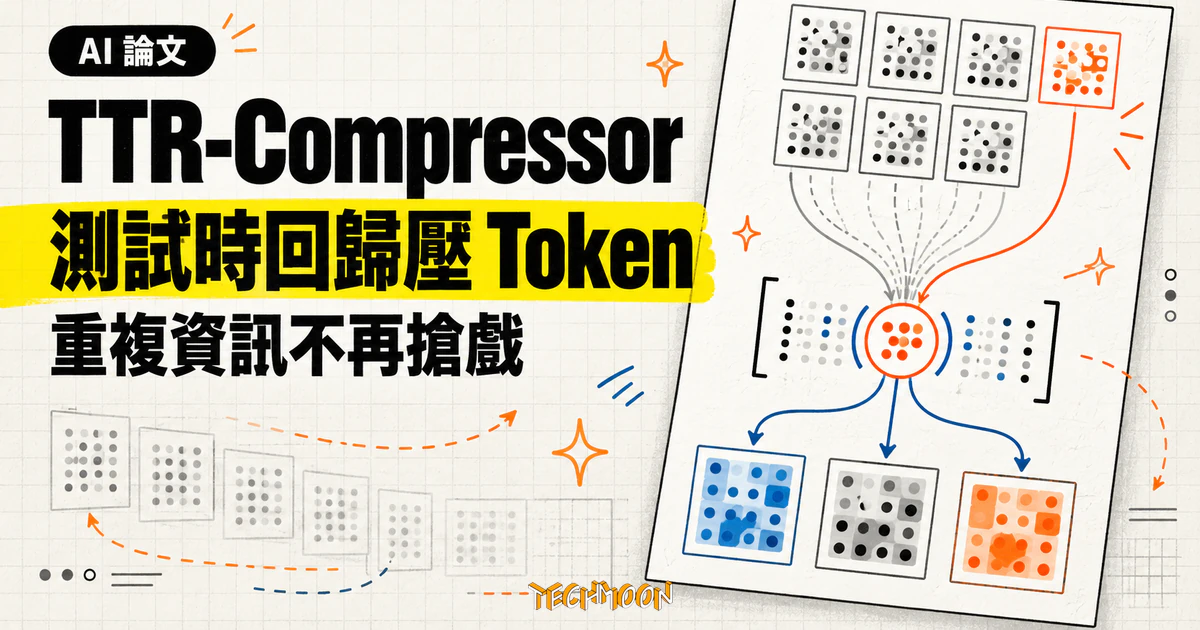
TTR-Compressor 把序列壓縮改寫成「每次輸入解一次回歸」:係數在推論時用閉式解當場算出,重複資訊的影響隨之遞減。在 Qwen3-VL 視覺端,3×3 合併版本用比標準 MLP 合併器少 55.6% 的視覺 Token,十項評測平均 54.85 對 54.93;在稀疏注意力端,RULER 檢索平均 51.44% 對 39.20%。本文對照論文、專案頁與 GitHub 原始碼,拆解兩張成績單的量測條件、訓練成本與尚未揭露的部分。
用 AI 摘要這篇文章:
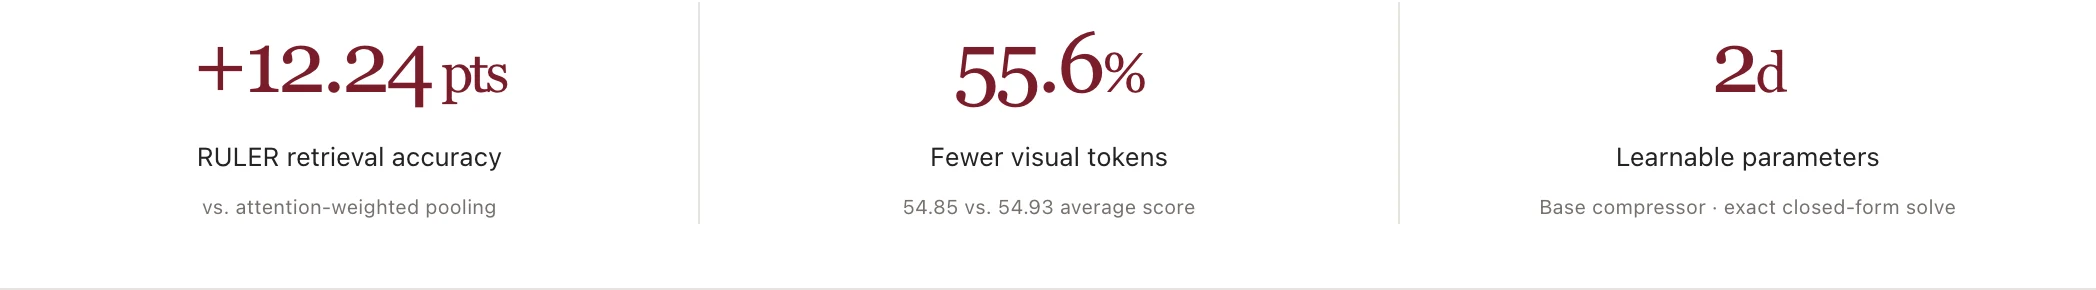
視覺模型讀圖的成本,很大一塊花在圖片轉成的一長串視覺 Token 上;壓縮這串 Token 的標準做法,是把相鄰幾個位置餵給固定權重的合併器。2026 年 10 月 22 日提交到 arXiv 的 TTR-Compressor(論文標題 Rethinking Sequence Compression with Test-time Regression)換了一個方向:讓每一組輸入自己定義一個回歸問題,把解出來的係數當成壓縮後的表示。論文交出兩張成績單:在長文檢索的 RULER 基準上,加上局部卷積的版本平均正確率 51.44%,比它取代的注意力加權平均 39.20% 高出 12.24 個百分點;在視覺端,它用比標準 MLP 合併器少 55.6% 的視覺 Token,把十項評測的平均分守在 54.85 對 54.93 的水準。
先把結論講完。這篇論文值得模型團隊注意的地方,在於它把「合併權重由誰決定」從訓練完就固定的參數,換成每次輸入現場解出來的結果;但 55.6% 這個數字來自合併格數的算術(3×3 合併對上 2×2 合併),真正的證據是同分數水準下的取捨,而且論文沒有量部署後的端對端速度。它也不是能裝在現有模型上的外掛,而是預訓練層級的組件替換:實驗用的是重新訓練的 4B 視覺語言模型,訓練以 2×8×H100 伺服器十幾個小時起跳。
與這則新聞直接相關的讀者,是正在自己做預訓練或多模態微調的團隊,以及評估長上下文架構的工程師;只想用現成 API 的使用者,可以把它當成下一波效率研究的訊號來讀。本篇內容對照論文全文、官方專案頁與 GitHub 原始碼(截至 2026 年 10 月 27 日)整理而成。
作者群來自香港中文大學的 Sihan Yang、Hanxuan Li、Yifan Guo 與通訊作者 Weiyang Liu,加上獨立研究者 Jie Huang,以及阿里巴巴 Token Foundry 的 Weigao Sun、Yiran Zhong。通訊作者 Weiyang Liu 所屬的 SphereLab 放了完整專案頁,論文首頁也以技術報告的形式標註。
公開的節奏分成幾步,每個材料的時間戳都對得起來:
| 項目 | 時間 |
|---|---|
| HuggingFace 七個模型權重上架 | 10 月 17 日至 19 日 |
| GitHub 儲存庫建立 | 10 月 18 日 |
| 訓練與評測程式碼批次進庫 | 10 月 19 日 |
| arXiv 論文 v1 提交 | 10 月 22 日 |
| Weiyang Liu 在 X 公開介紹 | 10 月 23 日 |
X 貼文依貼文 ID 解碼的時間是 10 月 23 日 20:37 UTC;貼文除了宣布,也點出通訊作者自己最看重的一點是這個工作看序列壓縮的視角根本不同。儲存庫 README 標記的發布日是 10 月 20 日,落在程式碼進庫與 arXiv 提交之間;對一般讀者來說,把 10 月下旬當成這批材料集中出現的時間帶即可。
要理解它改了什麼,先看原本怎麼做。圖片經過視覺編碼器後變成 N 個視覺 Token,標準做法是把相鄰的 2×2 位置串接起來、用固定權重的 MLP 映射成一個 Token,數量從 N 變成 N 除以四。這類合併隱含一個假設:每個位置的重要性差不多。問題在於大面積的重複背景本來就佔多數,如果摘要主要反映出現次數,小字、按鈕、表格線這類少數關鍵細節就容易被蓋掉。
TTR-Compressor 動的是「權重怎麼來」這一層。它把每一組 Token 視為一個回歸問題的資料:正規化後的 Token 構成回歸的解釋變數,一個訓練學出來的投影產生目標值,接著用閉式解(直接依數學式求解,不需要一輪輪調整)算出回歸係數,係數就是壓縮後的表示。換一張圖,Token 之間的關係不同,係數也跟著不同;但該解哪個回歸問題這件事,在訓練完成後就固定了,推論時不需要梯度更新。
論文用一個示意例子說明差異:三個方向相同的表示加一個方向不同的表示,加法式合併下兩群的相對影響是 3 比 1;改成聯合回歸解後變成 3 比 2。重複出現的資訊仍然有影響,但邊際影響遞減。用會議來比喻:加法式合併像每位發言者都拿到同樣的麥克風音量,同一個論點被講三次就大聲三倍;回歸解像主席現場重新分配發言權重,已經被講過的觀點再講一次,音量只增加一點。
兩個工程細節值得記下。當合併組裡只有 4 或 9 個 Token、而特徵維度在 1024 以上時,回歸可以直接在 Token 數量對應的小系統裡解,避開大型矩陣運算,基礎壓縮器的參數量只有特徵維度的兩倍。另外,相似度的比較端做正規化、目標端保留原始幅度,這種不對稱讓每次輸入真的會改變解出來的結果;論文的消融實驗也顯示,拿掉比較端的正規化會讓平均檢索分數從 50.92% 掉到 25.31%,是整套設計裡最不能少的一塊。至於前面一直出現的「局部卷積」,指的是算回歸目標之前先做一次局部卷積(語言序列用一維、視覺特徵用二維),讓目標值先帶進鄰近位置的脈絡,論文的說法是這讓回歸目標更有資訊量,也解釋了卷積版為什麼在各張成績單上幾乎都多拿幾分。
論文在注意力端的應用是區塊式稀疏注意力。長文先切成區塊、每個區塊壓縮成摘要向量,查詢時只對摘要計分、挑出少數區塊細看;這類架構的檢索品質,直接取決於摘要做得多好。研究團隊拿 HiLS-Attention 當基礎框架,只換掉壓縮器這一個組件,對照平均、串接投影、HiLS 原本的注意力加權平均,以及 TTR 兩種版本。
訓練設定是 345M 參數的語言模型、FineWeb 資料集約 300 億 Token、8K 訓練長度;評測用 RULER 的單針與多鑰匙檢索任務,長度從 4K 拉到 32K,超出訓練長度的部分測的是外推能力。結果:TTR 加局部卷積版平均 51.44%,基礎 TTR 版 50.92%,注意力加權平均 39.20%(論文另外把全注意力與滑動視窗注意力列為參考對照);最吃外推的 32K 單針檢索裡最基本的那一項(S-NIAH-1)上,卷積版正確率 98.8%,注意力加權平均是 74.0%,不過另外兩個單針變體在同一長度連卷積版都只剩一成左右。論文把差距歸因回機制:平均與投影把 Token 各自獨立加總,區塊裡多數的重複內容蓋過少數關鍵 Token;回歸解把相關 Token 一起考慮,重複證據的影響被壓低,摘要保住查詢要找的特徵。
附錄還有一組放大實驗:1B 參數、1,000 億 Token 的規模,TTR 平均 79.96% 對注意力加權平均 73.5%,而且差距隨長度增加而擴大。兩組實驗規模不同,分數可以看出趨勢一致,但不能跨組相減當成放大帶來的效果。對長上下文檢索有興趣的讀者,可以把這個結果與把決策模型上下文拉到 384K 的做法對照:一邊加長輸入,一邊壓低摘要成本,兩條路都在解序列開銷的同一個瓶頸。
有個誠實的細節值得肯定:論文也跑了常識推理等短語境基準,並明言那些評測的語境太短、根本不會觸發稀疏注意力,分數反映的只是預訓練學到的常識能力,與壓縮器無關。把不支持的評測明講清楚,這在效率研究裡不算理所當然。
另一個應用換成視覺 Token 合併器。設定用 Qwen3-VL 的視覺編碼器,配上 Qwen3-4B-Instruct 當語言骨幹,兩階段訓練後在十項評測上比較,題型涵蓋一般視覺問答、知識、文件理解與空間關係。更強的合併本來就是被點名的需求:論文引用的脈絡是更長的多模態語境、以及代理工作流裡重複出現的視覺觀察,都讓 3×3 這一級的合併變得有必要,而不只是為了好看的壓縮率。
55.6% 是這樣算出來的:標準 MLP 合併器把 2×2 位置合成一個,N 個位置剩下 N 除以四;TTR 的對照版本用 3×3 合併,剩下 N 除以九。N 除以九對 N 除以四,少了 55.6%。這個比例由合併格數決定,任何方法選同樣的格數都會得到同樣的數字;研究真正要回答的問題是,位置少留這麼多之後,後面的模型還能不能正確回答。答案寫在分數裡:卷積版 3×3 合併平均 54.85,貼近 MLP 2×2 合併的 54.93,論文的寫法是用不到一半的視覺 Token 達到相近表現。
更有內容的部分是同一壓縮率下的對比。同為 3×3 合併時,卷積版平均贏 MLP 2.58 分,而且差距集中在文字密集題型:OCRBench 多 4.10 分、InfoVQA 多 4.54 分、ChartQA 多 3.56 分。同為 2×2 時,TTR 是 55.92、卷積版 56.03,對 MLP 的 54.93。這組分佈與機制預測對得上:合併最容易破壞的就是小字與線條細節,而這正是回歸解宣稱要保住的資訊。
兩個提醒。平均分接近不代表每一項都無損,文件類與空間類產品在意的題型不同,採用前應回到自己最在意的項目看單項分數;另外這些分數來自研究團隊重訓的 4B 模型,不是官方 Qwen3-VL 產品的實測,換解析度、換影片長度或換骨幹之後,實際的視覺量與分數都要重新量。
每次輸入都要解一次回歸,會不會把省下的計算吃回去?論文量了兩個層面,也留下明確的空缺。
訓練端,視覺模型用 2×8×H100 訓練,四種組合的實際時間是:MLP 2×2 合併 18.40 小時、TTR 2×2 合併 18.55 小時、MLP 3×3 合併 17.25 小時、TTR 3×3 合併 17.02 小時。同一壓縮率之下,加入回歸求解沒有推高訓練成本,3×3 那組甚至略快;論文只說這凸顯了較高壓縮率下的效率與擴展性,成因沒有進一步解釋。模型的效率帳還有另一種算法,像用分層記憶體把巨型模型塞進小顯卡的 Strata 是從記憶體階層下手,TTR 則是從輸入序列長度下手,兩者互不衝突。
推論端,論文只量了稀疏注意力架構的預填與解碼延遲,結論是各壓縮法相近、並且在超過 16K 的長度明顯勝過全注意力;視覺端只有訓練時間,沒有推論延遲。部署後每張圖快多少、每個回答省多少成本,論文沒有答案,要等有人跑過端對端量測才知道。換句話說,「視覺 Token 少 55.6%」目前支持的是「送進語言骨幹的序列變短」這個中間事實,還不直接等於產品回應變快。
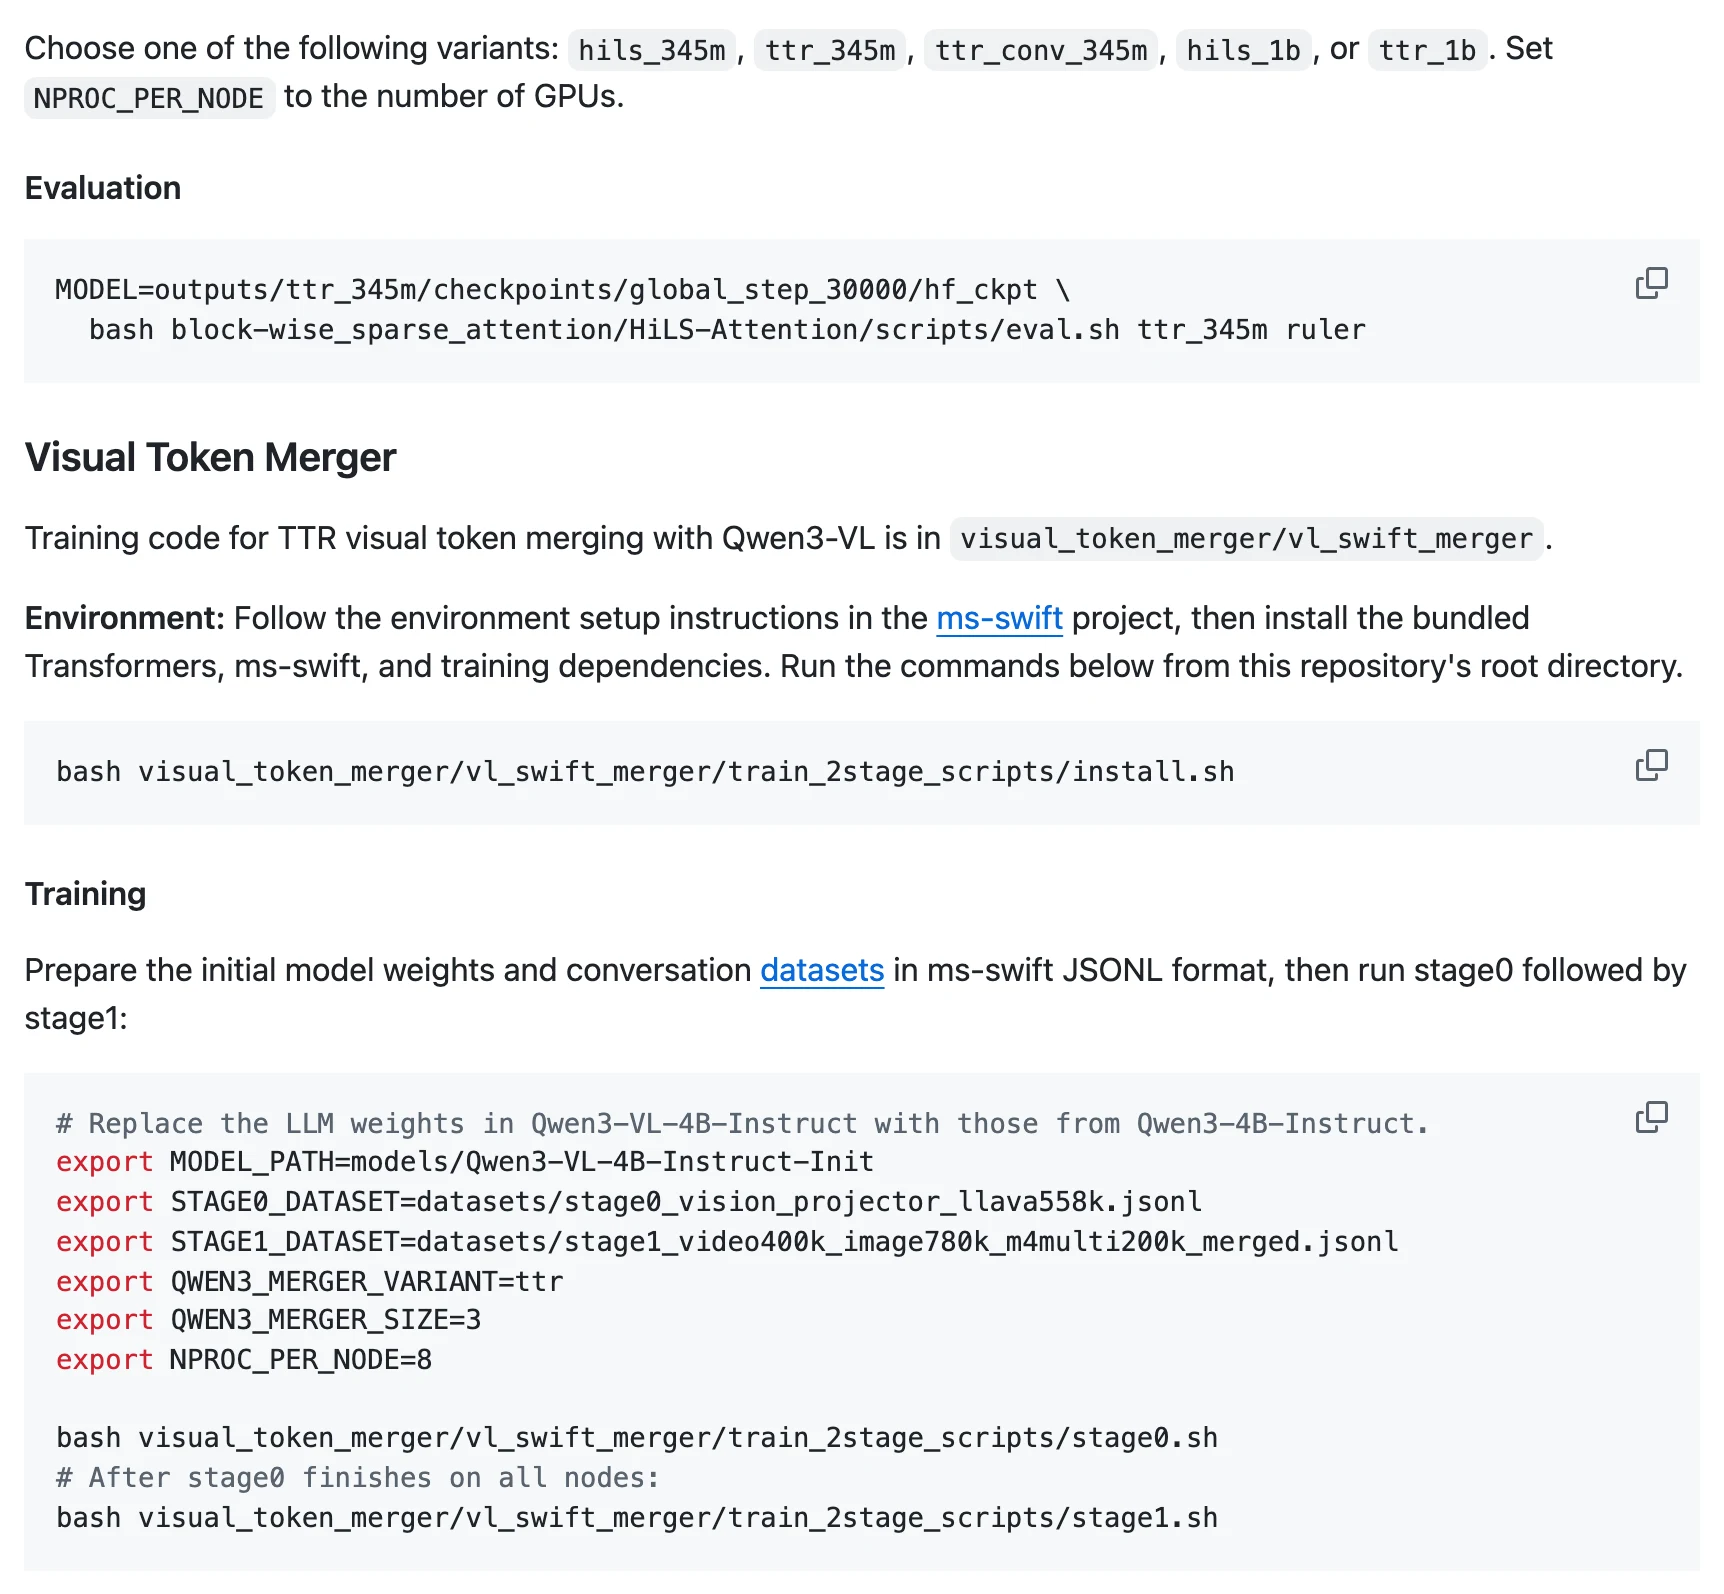
GitHub 上的 Sphere-AI-Lab/ttr-compressor 把兩條應用路徑分開放:稀疏注意力路徑基於 HiLS-Attention 的訓練與評測腳本,視覺路徑基於 ms-swift 的兩階段訓練腳本。腳本設計對對照實驗友好:合併器有 mlp、ttr、ttr_conv 三種選項,合併格數 2 或 3 用環境變數就能切換,固定其他條件、只換合併器這件事在腳本層級做得到。HuggingFace 上的 SphereLab 收藏集放了七個權重:345M 與 1B 的稀疏注意力模型,加上 2×2 與 3×3 各兩個 4.3B 視覺模型,下載次數都在個位數到二十出頭,還在非常早期的階段。
要特別注意的是授權。儲存庫頂層沒有 LICENSE 檔,樹狀結構裡的授權檔都屬於隨附的第三方專案,GitHub 把儲存庫的授權狀態列為沒有偵測到;HuggingFace 上的權重也沒有授權標籤。公開可下載不等於可商用或可再散佈,想把這套方法或權重用在產品裡,授權要自行向作者確認,或等正式條款補上。
後續值得回頭查的訊號有三個:論文有沒有出新版本修訂、儲存庫與權重有沒有補上授權條款、以及有沒有人補上部署端的端對端量測。序列成本與檢索品質的取捨正在變成一整條研究線,從用兩百七十五分之一算力訓練文生圖模型的實驗到這篇的輸入端壓縮,方向不同,問的都是同一件事:模型的能力,能用多少算力換到。