TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Artificial Analysis 於 10 月 30 日推出 HLE-Diamond 獨立榜單,把推理與知識分區、每題成本與努力設定攤在同一頁。榜首 Gemini 4 Carbon 尚無公開 API,Claude Opus 5.5 從低努力到最高設定的每題成本相差約 35 倍,領先模型的推理分數更普遍比知識高 16 到 35 分,分數、成本與可用性之間怎麼換算,一次說清楚。
用 AI 摘要這篇文章:
模型榜單最常見的讀法是只看第一名。2026 年 10 月 30 日上午 10 點 09 分(UTC 02:09),評測機構 Artificial Analysis 在 X 發布 HLE-Diamond 獨立榜單,而這張榜值得停下來看的地方,恰恰不在名次:它把每題成本、努力設定(effort)與題型分區三個原本散落各處的訊號放上同一頁,讓「模型多答對幾題」和「你為這些答案付多少錢」可以直接對照。
但有兩個前提,會讓只看名次的讀者做出誤判。榜首 Gemini 4 Carbon 在 AA 的圖表裡以格紋標示,對應的圖例寫明「No publicly available API」,一般開發者此刻叫不到這個模型;而整張榜量的是無工具、單次作答的封閉問答,分數無法直接外推到能查資料、能操作工具的代理工作。數字很有用,只是要經過換算。
先把兩個日期分開。HLE-Diamond 這份題庫是 Center for AI Safety(CAIS)與 Scale AI 在 2026 年 9 月 22 日發布的,屬於 Humanity’s Last Exam 修訂版:經過一年的清理與修訂、納入研究社群意見,精簡為 1,000 題封閉式學術問題,其中 500 題標為推理(reasoning)、500 題標為知識(knowledge),272 題附帶圖像,資料集放在 Hugging Face 的 cais/hle-diamond,原始論文發表於 Nature。
10 月 30 日的新事件,是 Artificial Analysis 以這份題庫為底發布自家的獨立評測,並把 HLE-Diamond 納入 Artificial Analysis Intelligence Index v5.0,權重占 10%,與 AA-Omniscience 同屬指數裡的一般知識類別。
評測怎麼跑,AA 的方法頁寫得相當透明:全部 1,000 題都不給工具,每題只讓模型作答一次,也就是 pass@1;提示詞用官方 HLE 系統提示,要求模型給出解釋、答案與信心程度;評分交給 GPT-5.6 Luna(medium 設定),依官方 HLE 裁判提示與參考答案比對。圖像題有個容易忽略的細節:能收圖的模型會拿到題目圖片,只有在碰到供應商的圖片大小限制時才縮圖;不能收圖的模型在這 272 題只拿到文字,但最後仍以全部 1,000 題計分。換句話說,純文字模型的總分裡混著輸入能力的劣勢,拿它跟能讀圖的多模態模型比總分,本來就不站在同一條起跑線上。
裁判本身也是模型,這一點 AA 沒有迴避。HLE-Diamond 與舊 HLE 等評測共用同一個等價判斷器 GPT-5.6 Luna(medium),選它的依據是對人類判分結果的驗證;數字型答案另給了小範圍的容許誤差。一致的評分流程能壓低任意變動,但語意判斷終究不是逐字比對,想追查特定題目的得失,特別是非常專門的答案,仍得回到題目與參考答案本身,總分推不出每一題的錯因。
誰需要在意這張榜?拿分數溝通模型採購的人、要決定 API 努力設定開多少的開發者,以及需要向主管解釋「為什麼選這個模型」的團隊,都會在接下來幾個月不斷遇到 HLE-Diamond 這個名字。
看首發成績單。10 月 30 日的首發圖上,Gemini 4 Carbon(high 設定)以 69.1% 排第一,Claude Opus 5.5 的 max 設定(AA 榜單上標註為 Max, Default Fallback)67.9% 居次,GPT-6 Astra(max)63.8% 第三,再往後是 Claude Fable 5.1 的 60.1% 與 GPT-6.1 Sol 的 58.8%。到了 11 月 2 日,頁面摘要另列出 Opus 5.5 的 xhigh 設定 64.0%,排在 max 之後、Astra 之前,前兩名沒有變動。
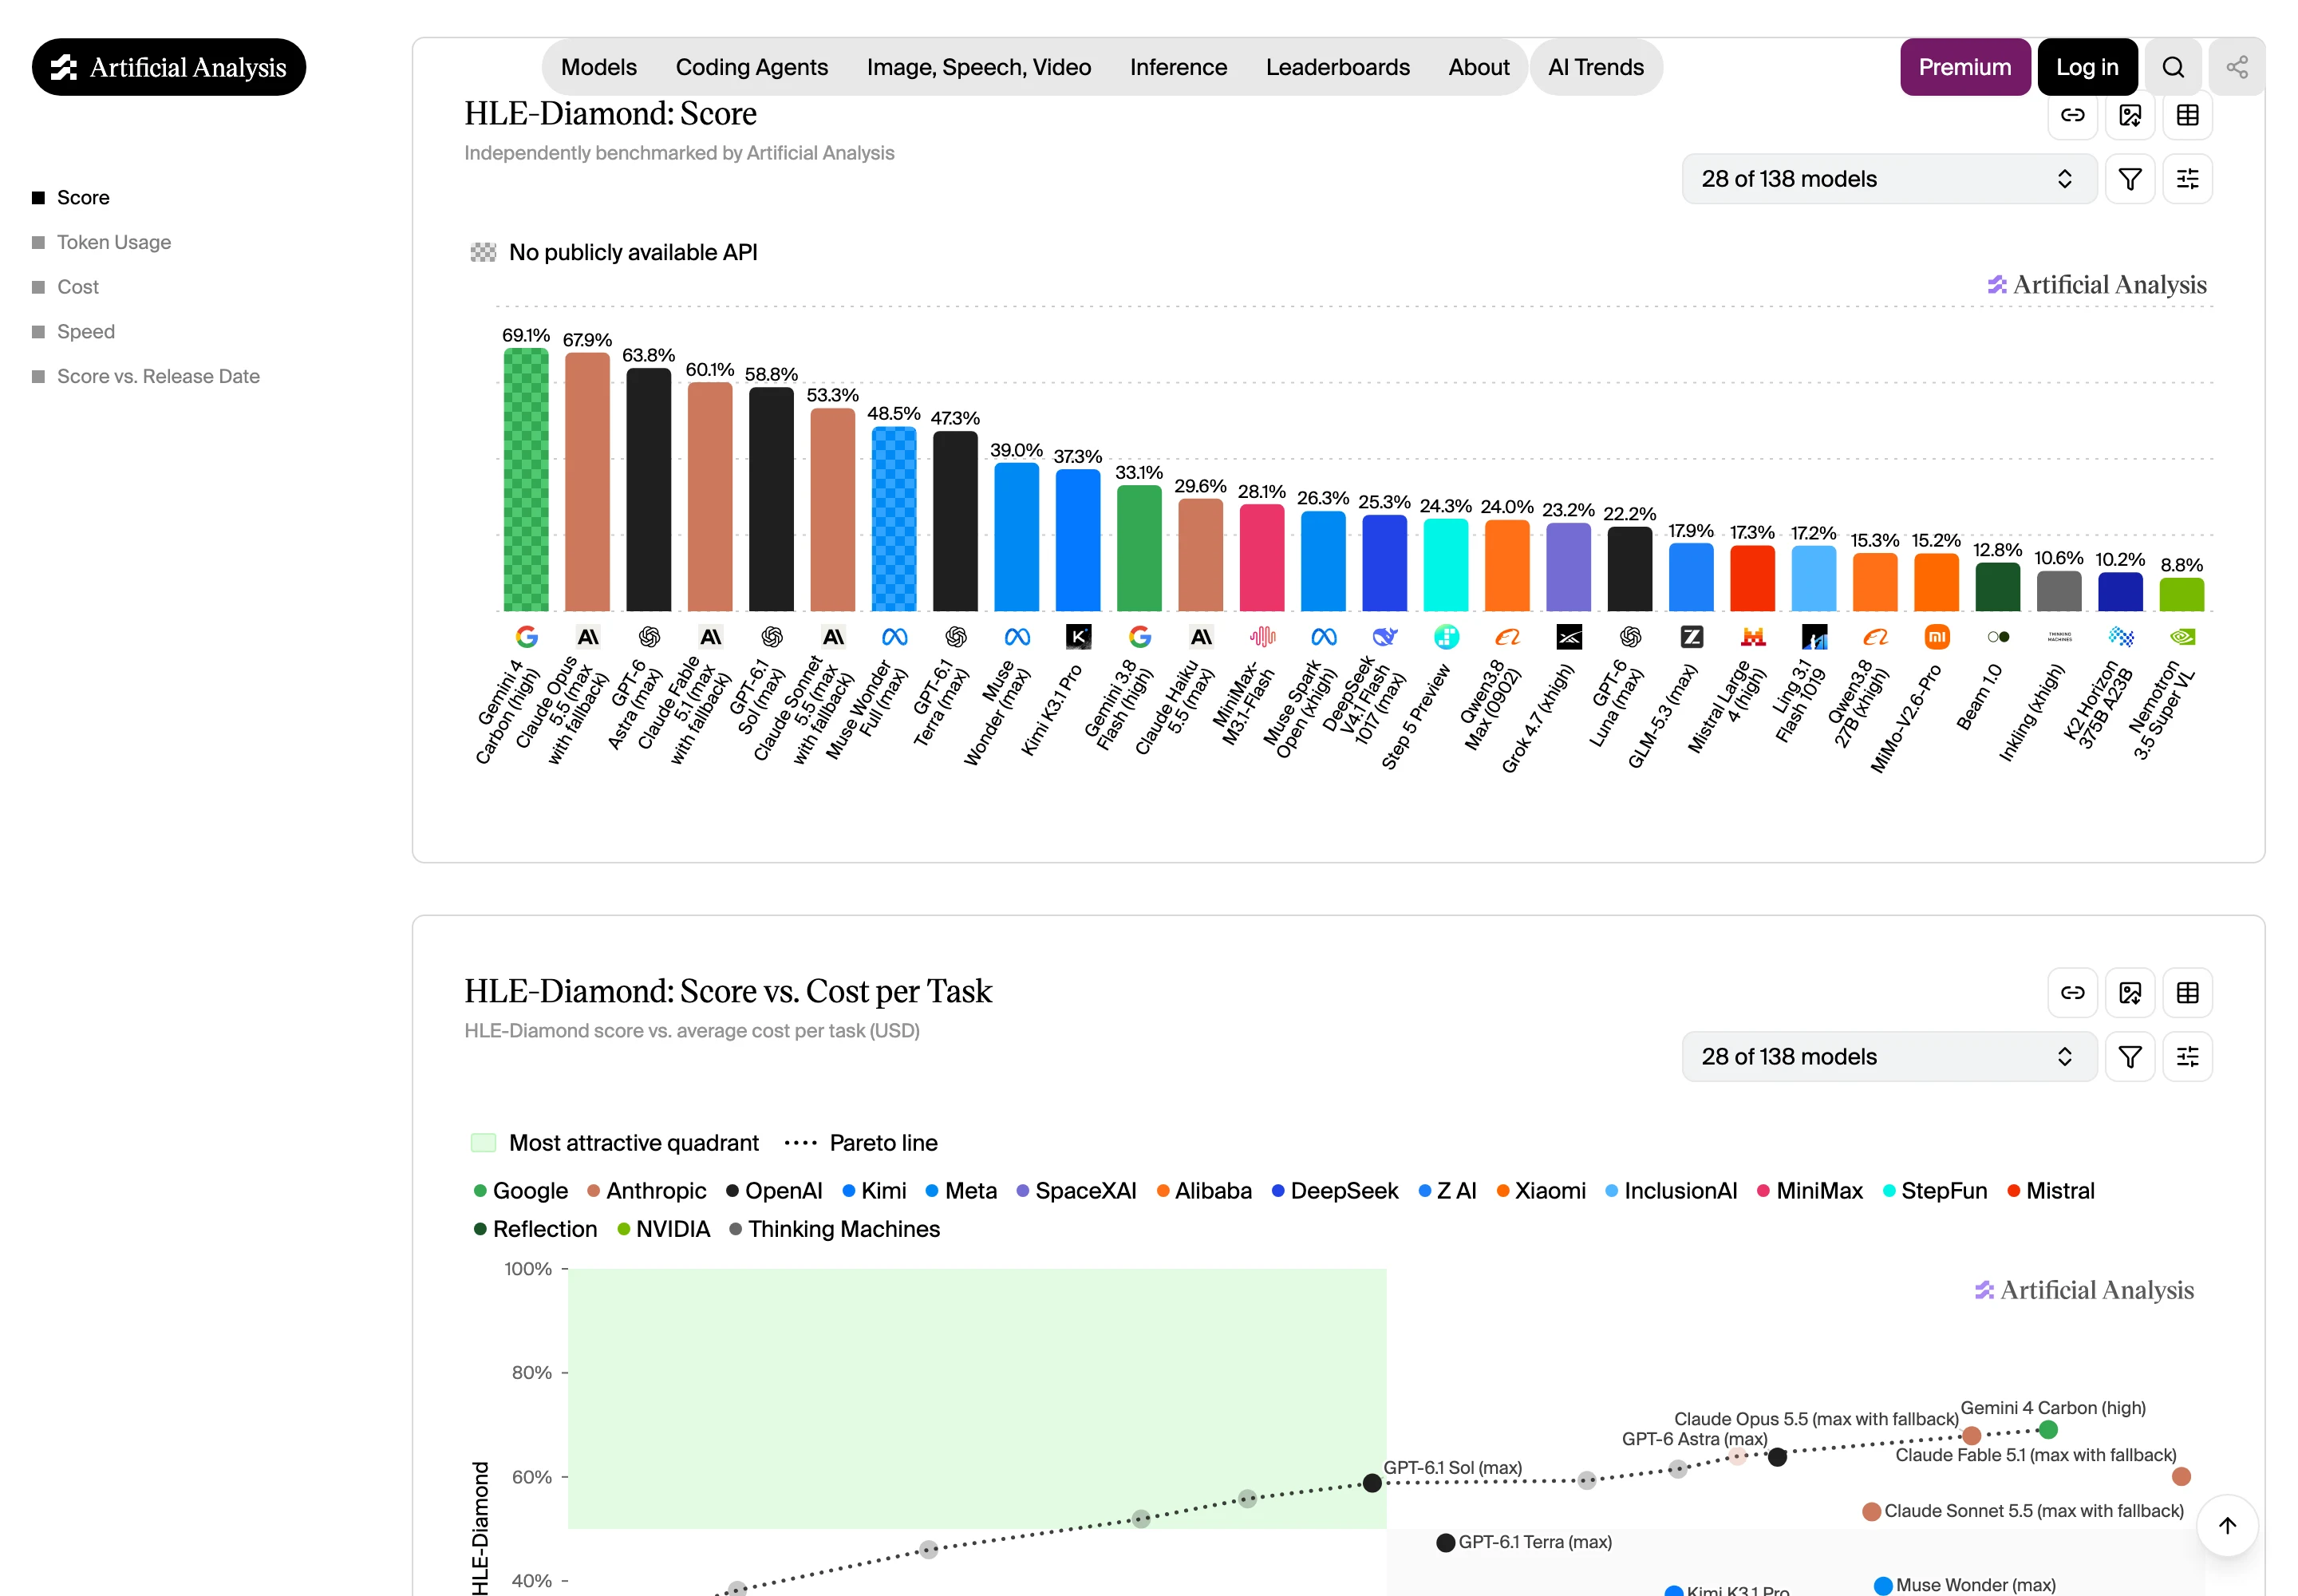
問題出在第一名。Carbon 在 AA 圖表裡的格紋樣式,對應「沒有公開可用 API」:榜單量得到它,一般使用者卻沒有公開入口可以叫它。公告貼文下方當天就有使用者回覆抱怨,說這個模型連公開管道都沒有,不該出現在比較圖裡。情緒歸情緒,採購面的事實是:把格紋的模型拿掉,能經由公開 API 取用的最高分,是 Claude Opus 5.5 的 max 設定 67.9%,而這個設定的每題成本,正是後面要算的帳。TechMoon 先前在 Gemini 4 Carbon 發表時整理過它的資安評測表現與開放對象,當時它就是先給防禦團隊的定位。
同一則公告也給了整體分布:AA 說在其量測範圍裡,只有 17 個模型變體(約 13%)總分超過 50%。首發圖表列出 28 個模型設定組合,分數從 69.1% 一路排到 8.8%,頭尾差距超過 60 個百分點。換言之,這是一張多數模型都還不及格的榜,前段班與中段班之間存在明顯斷層:首發圖上 60% 以上只有四個組合,53% 之後就掉到 49% 以下。
這張榜最有決策價值的數字,藏在 AA 接續發布的成本串文(thread)裡。原文是:「Claude Opus 5.5 gains 26 points from low effort (42%) to max (68%) at ~35x the cost per task, and GPT-6 Astra gains 19 points from low (45%) to max (64%) at 11x the cost per task.」翻成白話:Claude Opus 5.5從低努力到最高努力,多答對 26 個百分點,每題成本變成約 35 倍;GPT-6 Astra 多答對 19 個百分點,每題成本是 11 倍。
這組對照可以從三個角度看。最直接的一層是:努力設定是價格開關,同一個模型名稱、同一份題庫,low 與 max 是兩種價格的產品,選模型如果只寫模型名、不寫設定,等於採購單上沒寫規格。再往細看,成本曲線因模型而異:Opus 花 35 倍換 26 分,Astra 花 11 倍換 19 分,換算成單位分數的成本,Astra 的價格曲線平緩得多。而最容易被傳錯的,是倍率的歸屬:35 倍量的是這次評測裡每題實際成本(輸入、快取、推理與輸出合計)、按供應商計價換算的結果,它不能改寫成「Claude 比別家貴 35 倍」,也不能直接換算成你的帳單,因為輸入長度、快取命中與批次結構都會改變最後數字。
對實際開發的含義很直接:如果一批請求裡只有少數難題值得開最高檔,按題目分流,會比全部開 max 省得多。至於你的任務該怎麼分流,榜單沒有答案,它只把分與價攤開給你看。附帶一提,AA 對每題成本的定義比想像中細:輸入、快取命中、快取寫入、推理與答案輸出各按供應商牌價分開計,在能取得標準 token 計數的前提下才納入,這也是為什麼同一個倍率搬到不同用量的帳單上會失真。
HLE-Diamond 每一道題都標了推理或知識,AA 因此能給一般榜單給不了的剖面。官方串文的觀察是:總分超過 50% 的模型,推理分數全部比知識分數高 16 到 35 個百分點;在其量測的模型裡,超過九成是推理較好的一邊。領先群中落差最寬的是 GPT-6.1 Sol(max):推理 76.2%、知識 41.4%,同一個模型在兩類題目上近乎兩個世界。
兩個分區各占 500 題、等權計分,所以分區平均就是總分,這點可以自己驗算:Carbon 是 79.6% 與 58.6%,平均 69.1%;Opus 5.5(max)是 78.0% 與 57.8%,平均 67.9%;Astra(max)是 78.0% 與 49.6%,平均 63.8%。順著這條算式看第二名的守成與第四名的追趕,會發現 Opus 5.5 與 Astra 的推理分數同為 78.0%,總分之間的 4.1 個百分點差距,完全由知識分區的 57.8% 對 49.6% 構成。要超車的前段模型,卡住分數的已經是知識分區。
這對選模型的啟示,比名次本身實用。知識型的錯誤,很難用推理預算補:在不能查資料的封閉問答裡,題目需要的專家知識若不在模型內部,想得再久也生不出來。如果你的工作錯誤集中在法規版本、內部術語、時事這類會過期、會改版的知識,提高努力設定的幫助有限,該補的是檢索與文件來源;相對地,條件都給齊、需要多步計算的題目,才是努力設定直接作用的範圍。
還有一個交叉證據讓「領先模型普遍缺知識」比單一榜單更可防守:題庫作者自己的測試呈現同一個形狀。官方 9 月公告裡,Astra 的推理 74.2%、知識 45.6%,Opus 5.5 是 62.4% 對 46.8%,GPT-6.1 Sol 是 67.4% 對 39.0%,每個模型都是推理明顯高於知識。兩套獨立量測的絕對數字對不上,剖面卻一致,這種一致性比任何單邊的分數都更接近現象本身。
開放權重那一側的現況也被這張榜照得很清楚。AA 的說法是開放權重模型落後 30 分以上,其中分數最高的 Kimi K3.1 Pro 為 37.3%,且 AA 特別加註它的權重尚未發布;第二名 MiniMax-M3.1-Flash 是 28.1%。想自架重現這些數字的人,此刻連最強開源模型的權重都拿不到,能下載的選項落在更後面的位置。「開放權重」四個字向來不等於「能重現」,授權範圍與釋出時程的邊界,先前在 Mistral Large 4 的 MEOW 授權整理過同類案例。
題庫作者自己也交過成績單。9 月 22 日的公告裡,CAIS 與 Scale AI 用 reasoning high、無工具的設定量得:GPT-6 Astra 59.9%、Gemini 4 Argon 56.9%、Claude Opus 5.5 54.6%、GPT-6.1 Sol 53.2%、Kimi K3.1 Pro 29.5%。對照 AA 的獨立榜:Astra(max)63.8%,Kimi K3.1 Pro 37.3%。
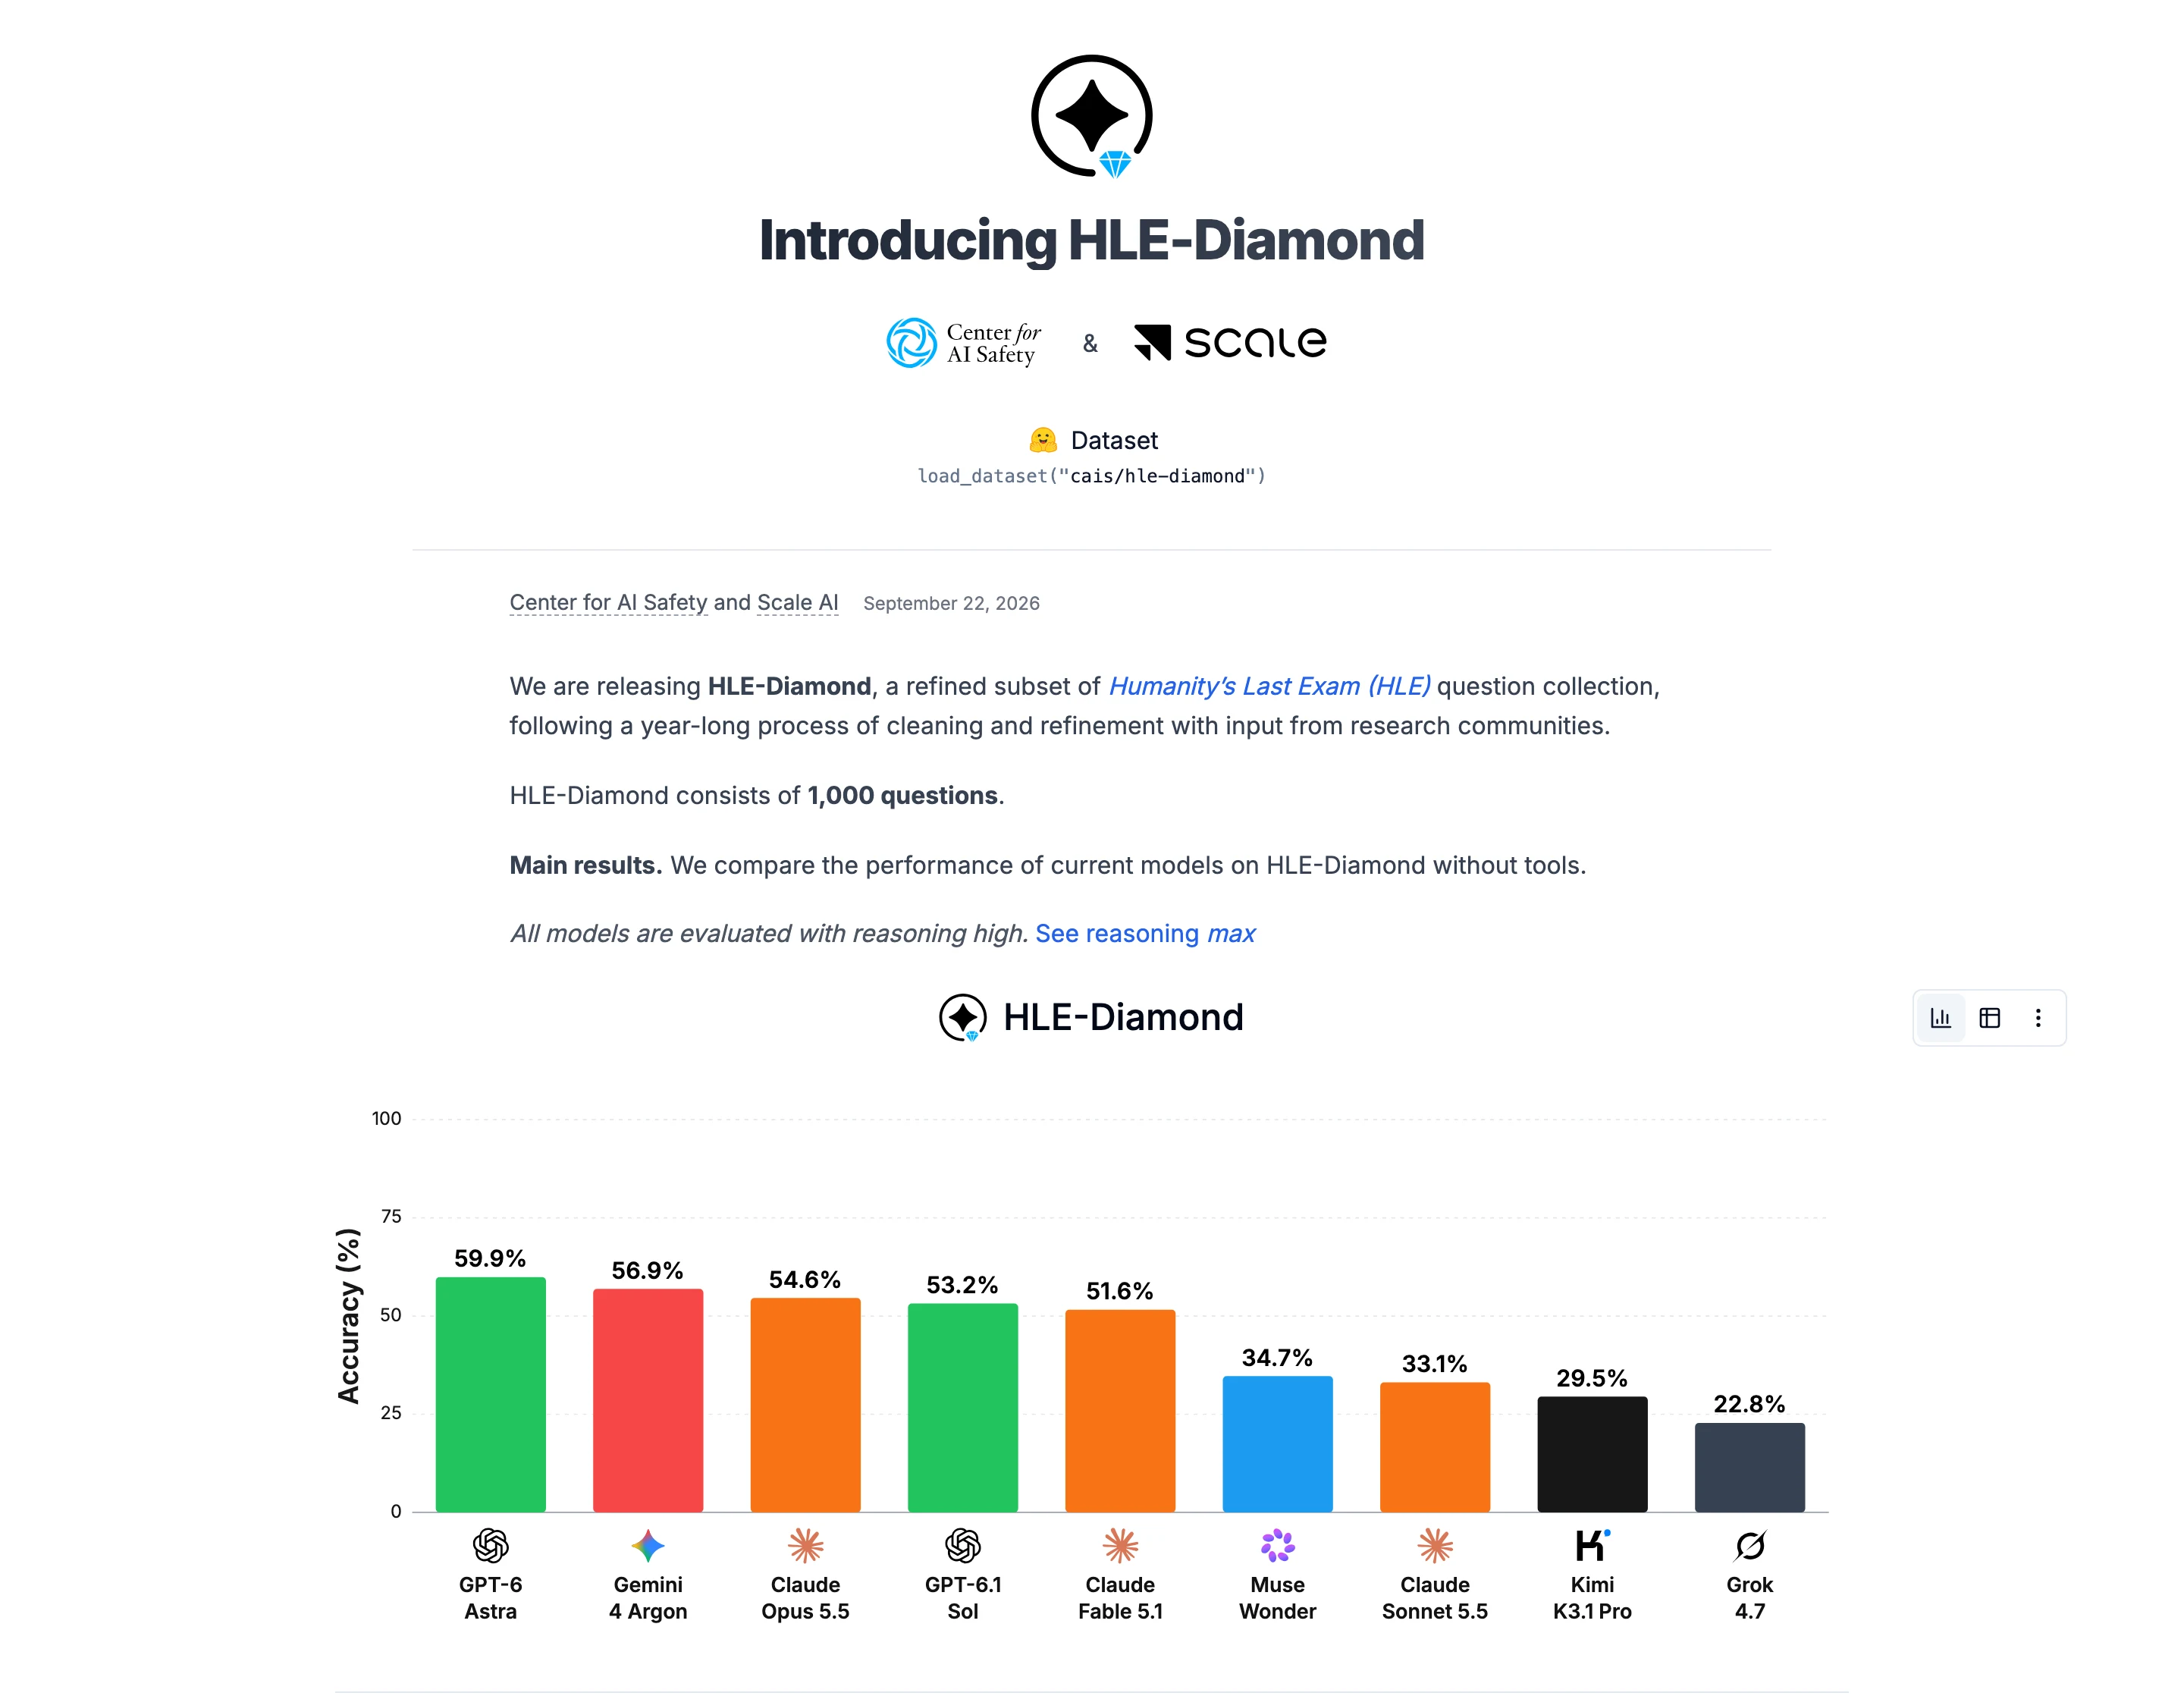
兩邊的數字不一樣,不必然有誰錯。努力設定不同(官方自測是 high,AA 榜上的 Astra 是 max)、實作與裁判流程不同(AA 用自家實作配 GPT-5.6 Luna 裁判),任何一項都足以移動幾個百分點。給引用者的教訓是:這類數字要把「誰量的、什麼設定」一起抄下來,否則 59.9% 與 63.8% 會在同一份簡報裡打架,而沒有人能解釋差異從哪來。
官方公告還給了一組更容易被忽略的對照:接上網路搜尋與程式執行工具後,Astra 從 59.9% 提高到 82.9%,Opus 5.5 從 54.6% 到 73.9%,GPT-6.1 Sol 到 69.1%。工具讓這批模型多答對 16 到 23 個百分點的題目。這就是封閉問答榜單的邊界:榜上的數字量的是模型單打獨鬥的樣子,而真實工作裡能查資料、能跑程式的代理,表現不會是榜上那個封閉數字,方向只會往上。
綜合以上,三個換算動作比背名次有用。
先確認入口再談分數。榜上的每個數字都對應特定的模型與設定組合,入口不存在,分數就只是參考,Carbon 的格紋是最現成的例子;反過來說,開放權重模型要先確認權重到底發布了沒,Kimi K3.1 Pro 的 37.3% 此刻就屬於「看得到、裝不到」的數字。
引用前先對齊設定與題型。抄 67.9% 之前先問:自己的任務是知識型還是推理型、需不需要讀圖、能不能接受單次作答。推理強、知識弱的模型放進查證型的工作,會正好踩到短板;不能收圖的模型遇到圖像題,劣勢在計分方式裡就已經寫死。
分數之外保留自己的驗收。這張榜量的是 1,000 題學術封閉問答,程式碼、代理任務、長文件各有 AA 的其他評測,產品裡的最終表現仍要用你自己的資料與完成條件量一次。榜單縮小的是候選名單,不是驗收流程。
幾件事至今沒有公開數字:每題成本的絕對金額在 AA 頁面上是互動圖,公告文字只給了倍率;Intelligence Index v5.0 的正式切換日期未在公告裡標明;首發圖之外其餘模型的評測狀態也沒有逐一說明。榜單數字本身是活動的,10 月 30 日的首發值在 11 月 2 日查核時仍與線上值一致,之後 AA 隨時會更新,引用時附上查詢日期,11 月 9 日前後再回查一次會比較保險。
HLE-Diamond 的分數可以和以前的 HLE 成績接起來比嗎?
不行。AA 說明它過去的 HLE 評測用的是原始題庫裡 2,158 道純文字題,HLE-Diamond 則是修訂後的 1,000 題、含 272 道圖像題,兩份測試的題目組成不同,百分數之間沒有固定換算。看到某模型「從舊分數進步到新分數」的說法,先確認中間有沒有換題庫。
「35 倍」代表 Claude 比其他家貴 35 倍嗎?
不是。那是同一個 Opus 5.5 在低努力與最高努力兩種設定下,每題評測成本的倍數,比較對象是它自己的低檔位。跨品牌的價格要比各家牌價與你自己的用量結構,榜單上的倍率不能搬去當售價結論。
支持開源模型的人可以重現這些成績嗎?
多數還不行。開放權重組別分數最高的 Kimi K3.1 Pro 權重尚未發布,其他模型也要各自確認版本與入口。已經可下載的開源模型,在這張榜上落在更後面的位置。
裁判也是 AI 模型,這些分數可信嗎?
有邊界的可信。AA 依官方 HLE 裁判提示用 GPT-5.6 Luna(medium)評分,選這個裁判的依據是對人類判分結果的驗證,數字型答案另給小範圍容許誤差;同一套流程讓大規模評分有一致標準,但語意判斷不可能零失誤,追查個別題目仍要回到題目與參考答案。
這張榜把每題成本與題型短板放進榜單,是評測透明度往前的一步,但它能回答的問題,到封閉問答為止。什麼時候該把 35 倍的成本開關交給產品裡的自動分流,答案不在榜上,在你自己難題的價值與驗收標準裡。