TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

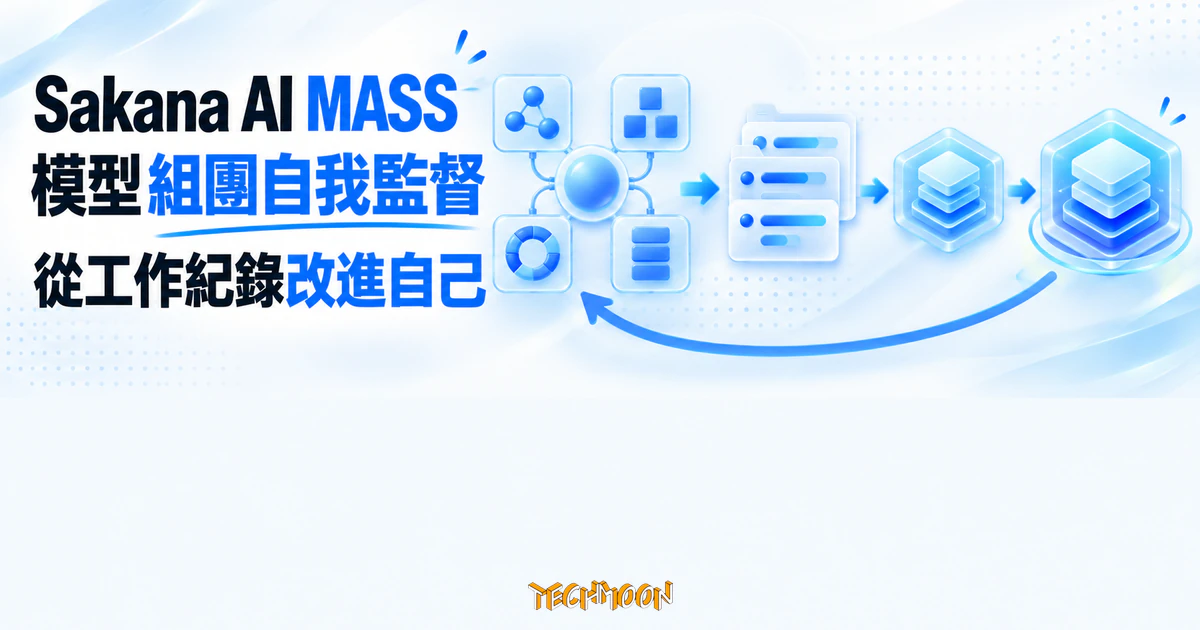
Sakana AI 與 UC Berkeley 提出 MASS:同一個模型同時當執行者、流程優化器與評估者,先搜尋更好的多代理分工,再把團隊軌跡拿去微調自己,兩輪後研究基準的每 token 得分達基礎模型 1.2 到 1.6 倍。數字口徑、寫程式基準不進步與重現成本,全部回到論文與官方程式碼核對。
用 AI 摘要這篇文章:
Sakana AI 與加州大學柏克萊分校的研究團隊,十月八日在 arXiv 提交論文《Recursive Self-Improvement through Multi-Agent Self-Supervision》,提出名為 MASS 的遞迴自我改進方法:讓同一個語言模型同時扮演執行者、工作流程優化器與評估者三種角色,先搜尋更好的多代理分工方式,再把團隊的工作紀錄拿去微調模型本身,如此交替兩輪。官方研究頁在十月中旬上線,Hacker News 討論串同一晚出現,至十月十三日查詢,累積一百三十一分與七十七則討論。
遞迴自我改進這個題目,今年已經有幾種不同的切入方式:Google 團隊八月把探索歷史做成精確重放的「夢」式訓練,智譜則在基礎設施報告裡自述代理如何改進訓練管線。MASS 的差異在於它把整個過程交給同一顆模型自己監督,而且把方法與成本攤到可以被外界檢驗的程度。「多代理」只是這套方法的招牌,最值得看的其實是論文對自身成績的誠實標註:宣稱的一點二到一點六倍進步,單位是每一個輸出 token 的得分;換到寫程式基準,同一個指標反而降到零點九六與零點九四倍。把這些數字的口徑讀對,比記住倍數本身重要。
這次發佈分成三個時間點。GitHub 儲存庫 SakanaAI/mass 建立於九月二十九日;arXiv 論文編號 2610.12176 於十月八日提交,共三十九頁;官方研究頁 pub.sakana.ai/mass 標註發佈於十月,Google News 索引時間為十月十一日下午,Hacker News 討論串則在同日晚間十點二十二分由帳號 hardmaru 提交。
論文作者共七人,橫跨兩個機構:Hyunin Lee、Donghyun Lee、Somayeh Sojoudi 與 Matei Zaharia 掛名 UC Berkeley,Jinglue Xu、Jeffrey Seely 與 Yujin Tang 掛名 Sakana AI;官方頁註明首位作者的工作在 Sakana AI 實習期間完成。換句話說,這是一篇學術論文加上一份公開的程式碼,目前沒有對應的商業服務。
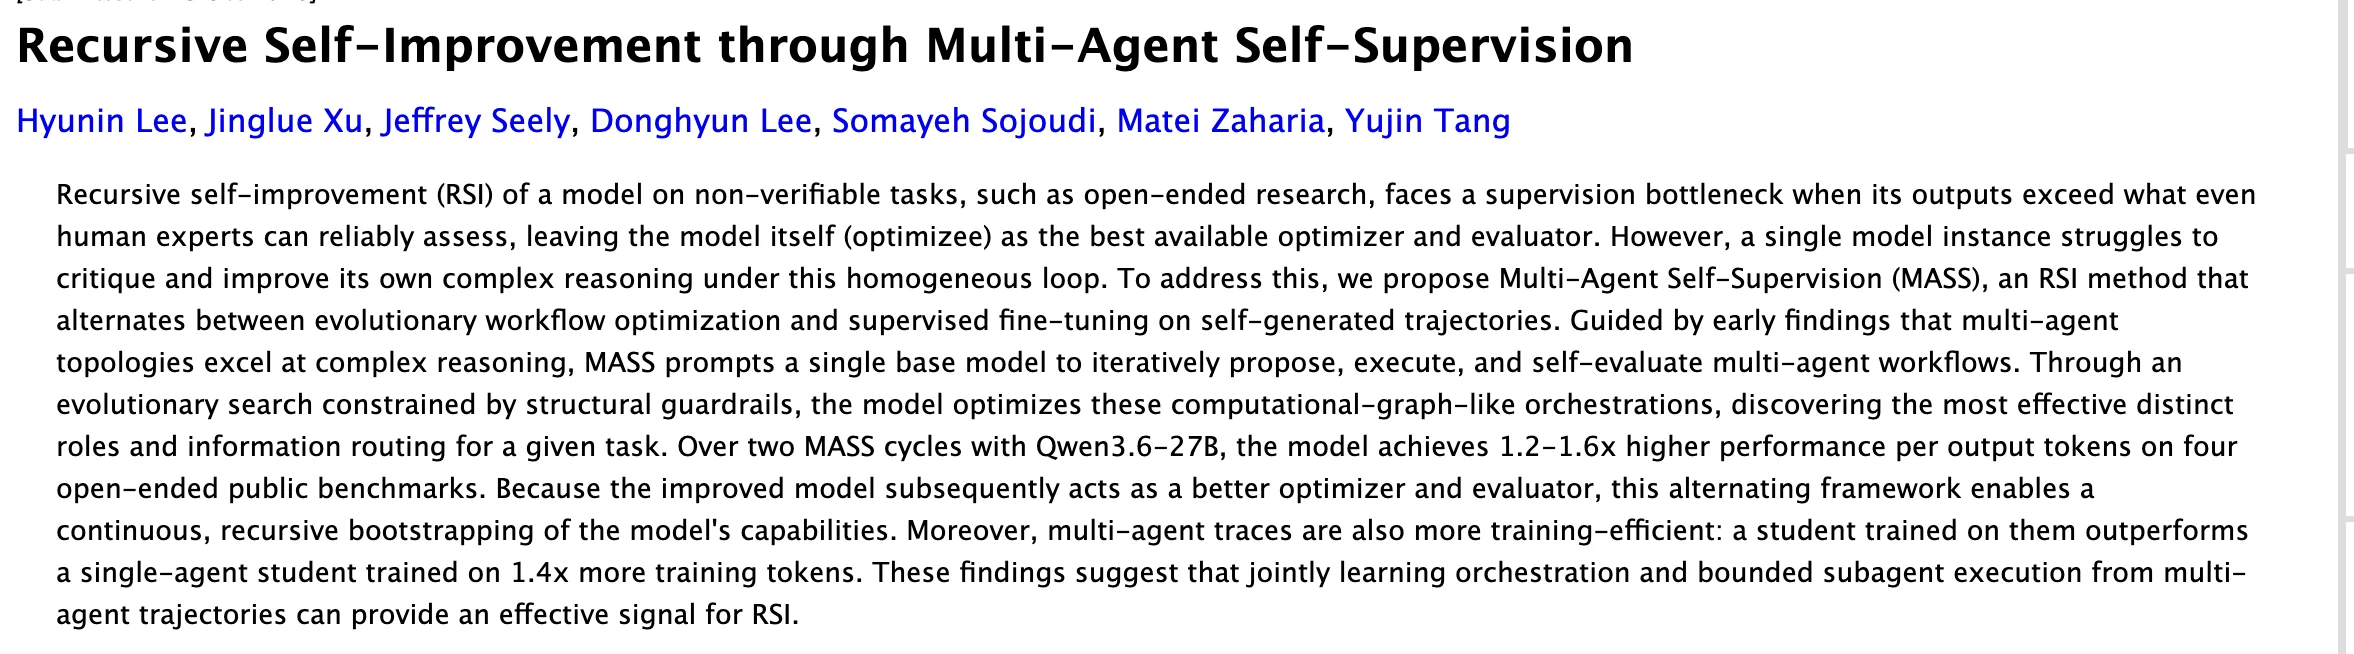
MASS 的全名是 Multi-Agent Self-Supervision,可譯為多代理自我監督。它的核心設計,是把「模型如何改進自己」拆成兩層交替進行的迴圈。
內圈處理「怎麼做」。這個階段權重完全不動,改的是送給團隊的工作計畫。每份工作流程由四個部分組成:每個子代理的角色、指令、產出合約,以及呼叫順序。舉研究裡的財務任務為例,演化後的流程把資料準備、特徵構建、建模、歷史驗證、稽核排成固定順序,資料專員的產出合約還明文要求檢查時間切分是否讓歷史決策用到了未來資訊。搜尋過程採演化式:每一輪執行候選流程、由評估者比較產出、優化器再依回饋改寫流程,同一訓練任務會保留一份目前最佳的冠軍流程。
外圈處理「從做過的事學習」。研究讓冠軍流程對每個訓練任務執行十八次,用目前模型對產出兩兩比較,經 Bradley-Terry 模型轉成分數後排名,每個任務最多保留十六條軌跡,其中十五條進訓練、第十六名進驗證。訓練資料有個容易忽略的設計:構築訓練範例時,研究人員把工作流程文字從指揮者的提示裡移除,讓模型從任務本身學會怎麼組織工作,而不是依賴那份被搜尋出來的劇本。微調採 LoRA,訓練完成後的版本重新接手三種角色,進入下一輪。
整個實驗從 Qwen3.6-27B 出發(執行端採 FP8 量化版),在 qwen-code 0.20.0 編碼代理環境裡跑了兩輪,產生第一代與第二代模型。訓練用的合成研究任務共十二項,涵蓋金融、機器人與藥學三個領域,其中九項用於訓練、三項保留測試;研究也註明這批任務描述在實驗前由 GPT-5.5 產生,且有一項訓練任務因流程搜尋找不到勝過參考版本的分工而被排除,最終八項任務供應了微調資料。
新聞標題最容易寫錯的地方在這裡。論文宣稱的進步,是第二代在四個研究類基準上「每一個輸出 token 的得分」達到基礎模型的一點二到一點六倍;官方研究頁另載明 Terminal-Bench 2.0 為零點九六倍、SWE-bench Verified 為零點九四倍,也就是寫程式與終端機這兩類基準的同一指標不升反降。
這個比值同時包含兩種變化:得分變高,或輸出變短。對照儲存庫 README 的原始分數表,可以自行驗算兩者並不同步。資料科學基準 DSBench 的原始分數只從零點四七三升到零點四八二,進步幅度不到百分之二;科學任務基準 ScienceAgentBench 從百分之二十八點八升到三十一點七;MLR-Bench 交件率從百分之五十七升到七十六。換句話說,效率面的一點二到一點六倍,有一部分來自第二代學會用更少的輸出到達相近或更好的結果。這是值得肯定的進步,但把它讀成「能力全面提升一點六倍」就是口徑錯誤。
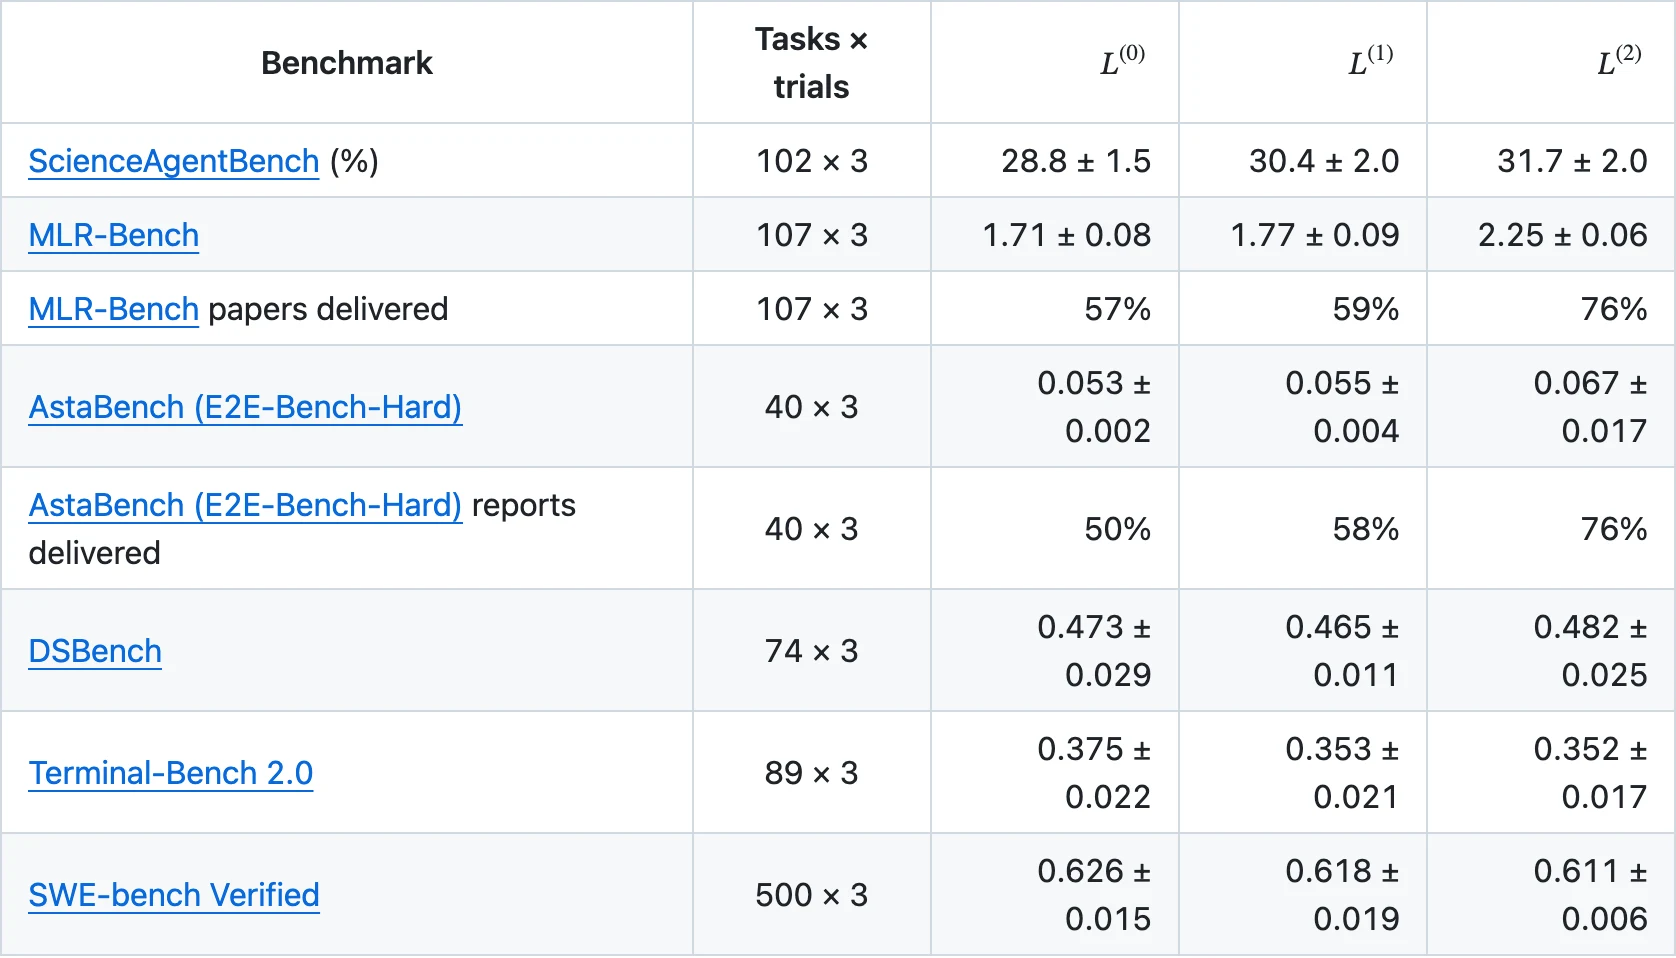
MLR-Bench 的數字還有另一個陷阱:官方材料存在兩套口徑。主表採十二任務子集、每任務五次試驗,分數從一點五八升到二點四零;README 另報了涵蓋一百零七項任務、每次三試的評測,分數從一點七一升到二點二五,而儲存庫隨附的設定只包含較早的十二任務子集。兩套都是官方數字,引用前值得先確認講的是哪一套。官方頁更自己提醒一個均值陷阱:在十二任務子集上,基礎模型交件論文的平均分是三點零七,兩輪後反而降到二點八八,但兩個平均蓋在不同的完成集合上,統計結論取決於聚合方式。
外部衡量的設計也站得住腳。研究另外聘 GPT-5.5 與 Claude Opus 4.8 當外部裁判評估完成的工作,這些判斷完全不回饋進 MASS 的訓練流程。在保留的三個測試任務上,第二代對基礎版的勝率從第一輪的百分之五十三點九升到第二輪的六十九點九。
最影響後續判斷的是角色泛化。研究只拿解題軌跡去訓練,工作流程優化器與評估器的能力卻一起變強:自評裁判與外部強模型的一致率從百分之七十三升到九十三;流程移轉測試裡,基礎模型執行第一代搜尋出的流程,對執行基礎版搜尋流程的勝率達百分之六十四。這正是「遞迴」能自續的前提,改進後的版本確實變成更好的教練與裁判。
訓練效率的證據則給了多代理軌跡一個明確理由。在控制訓練量的比較裡,用多代理軌跡訓練的學生處理二千八百八十二萬個監督 token 後達到百分之六十八點三的勝率(兩者都對基礎版計勝負),比用四千二百萬 token 訓練的單代理學生的百分之六十四高出四點三個百分點,等於省下百分之三十一點四的訓練量。團隊執行的原始輸出量約為單代理的二點四倍,但換算到每個監督 token 的學習效果反而更密。
最出乎意料的是瓶頸位置:多半落在優化器,評估者的問題小得多。消融實驗把基礎模型留在執行端,只把評估者換成 GPT-5.5,幫助有限;按官方研究頁對這組實驗的說明,評估器與優化器一起換掉時,五次迭代內就為全部十二項任務找到獲勝流程;論文附錄則載明純同質迴圈最終也在十一項任務達到全體一致的勝出,只是需要更多迭代。作者的解讀是:強裁判給得出高品質回饋,弱優化器要用更多輪才走得動,差別在改進速度,能力沒有缺席。對資源有限的研究團隊,這直接指出改進的優先順序。
行為層面還有一個變化:不給任何工作流程提示時,一百一十次執行裡出現代理委派行為的次數,從基礎模型的一次,升到第一輪的四十八次、第二輪的八十七次;一個子代理讀取另一個子代理寫的 Python 檔案這類交接,也從一次升到八十三次。學來的協調方式,內化成了模型自己的行為。
MASS 處理的是所謂非可驗證任務:開放式研究沒有標準答案可用自動規則評分,整個學習迴圈只靠自我評估的訊號推進,而這個訊號的正確性本身未知。官方研究頁結論對此毫不迴避,把共享盲點視為遞迴自我改進可能的阿基里斯腱:一個同源的誤解,可能讓錯誤成果被生產出來、被自評為進步、再被寫進下一輪模型;若人類專家也認不出這個缺陷,後續更新可能持續強化它。同樣的裁判同源問題,Anthropic 七月的研發自動化測量報告也用「模型量模型」的方式處理過,並同樣標註了自評的邊界。
官方研究頁還觀察到工作流程搜尋本身相當不穩定,強迭代之後可能跟著大幅退步,建議文字空間的優化器配上類似學習率排程的穩定機制。這些自陳限制,加上百分之九十三的一致率衡量的是與外部裁判一致,並不等於與真相一致,構成讀這份研究時該保持的距離。
官方儲存庫公開了完整管線:工作流程搜尋、軌跡收集與排名、對話渲染、LoRA 訓練、檢查點選擇與模型匯出,加上十二個合成任務與兩輪的設定檔。但文件同時攤開了相當清楚的重現落差。
授權狀態要先確認:截至十月十三日,儲存庫沒有 LICENSE 檔,GitHub API 回報授權狀態為空,也就是預設的權利保留,拿去改造或商用前需要先向權利人確認條款。涵蓋範圍的落差更大:實驗支援文件明言,README 報告的一百零七任務 MLR-Bench 評測、AstaBench、DSBench、Terminal-Bench 與 SWE-bench 的執行轉接器,以及論文裡多項消融與分析程式都沒有隨附;實作註記更直說,目前的工作流程搜尋驅動與論文算法一號並不完全相同、第二輪的一千六百二十四步訓練預算是重建時的選擇、完整的端到端訓練與基準重跑並未驗證過。
算力與安全前提同樣要計入。執行指南載明第一輪微調單是 SFT 就用掉六張 H100 約十九小時,工作流程搜尋與資料收集另計;qwen-code 以 yolo 核可模式執行模型產生的命令,合成任務執行器直接使用主機環境、不建安全沙盒,只有公開基準跑在 Docker 裡。想在本地端重現的人,隔離環境是必要條件,省不得。
Hacker News 討論串裡的質疑也集中在這兩點:有人直接問這是否只是二十七 B 模型的 LoRA 微調、成本是否值得。這些質疑沒有錯,但也正好示範了論文的價值所在:它把方法、成本與限制都寫到可以被檢驗的程度,並未只留下倍數宣稱。
寫程式基準不進步的原因,作者的推測是把軟體工程任務加進訓練資料就能輕易解決,這是未經實驗支持的宣稱,還稱不上結論。所有基準數字都是研究團隊自報,獨立第三方重現尚未出現。後續值得回查的節點有三個:論文是否推出修訂版、儲存庫是否補上授權檔,以及社群有沒有人真的用六張 H100 跑完兩輪並對上論文數字。在那之前,這篇研究最穩當的讀法,是把它當成一份把自我監督攤開給所有人檢驗的方法論文件,而非一份已經證明模型能無上限自我改進的判決書。這類大規模代理協作的下一步會走向哪裡,可以對照 OpenAI 先前用上萬個代理跑數學研究的爭議案例一起觀察。