TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Anthropic 在 Anthropic Institute 發布前沿研發步調量測報告,公布三項內部指標:截至 2026 年 8 月 Claude 已主導 26% 的模型研發工作、約三萬個 AI 代理在內部平台同時運作並單月產生逾十億次決策、7 月單週投入安全研究的算力約佔 6%。數字怎麼量出來、口徑有多保守、第三方驗證何時落地,答案都在報告原文裡。
用 AI 摘要這篇文章:
2026 年 9 月 17 日(美國時間),Anthropic 在官網的 Anthropic Institute 專區發布一份標題很直白的報告:〈Measurements for understanding the pace of AI development inside frontier labs〉,理解前沿實驗室內部 AI 研發步調的量測。內容是該公司少見的公開:截至 2026 年 8 月,Claude 已經「主導」Anthropic 內部 26% 的模型研發工作;在公司最常用的內部平台上,隨時有大約三萬個 AI 代理同時做研究與工程;檢視 7 月中一整週的算力去向,投入 AI 研發的算力中直接用於安全的大約佔 6%。
這三個數字各自回答一個過去外界完全看不到的問題:AI 幫 AI 做研發做到了什麼程度、誰在監看這些代理、算力實際花到哪裡去。值得先記住的是量測機制本身:整個過程是 Claude 測量 Claude 的研發參與,而報告把這條可信度邊界寫得相當清楚,甚至連「裁判模型可能犯跟受測模型同款的錯」都自己先講了。
時間軸往前撥兩週。9 月 12 日,Anthropic 執行長 Dario Amodei 在個人網站發表長文呼籲為前沿 AI 設速,提出讓獨立評估者以接近員工的身分進駐實驗室等具體機制(長文全文解析);同日 Altman 以承諾推文表態跟進,Musk 也留下一句話(兩種跟進方式的對照)。9 月 15 日,Dreamforce 大會把「AI 該不該放慢」連續拋給同日登台的黃仁勳、Amodei 與 Sam Altman,三個人給出三種答案(現場說法對照)。整場辯論最大的弱點始終是同一個:沒有數字可以驗收,所謂放慢或狂奔都是各自表述。
這份報告補的就是量測層。發布單位 Anthropic Institute 是 Anthropic 官網的研究專區,自我定位為從前沿實驗室內部研究強大 AI 對世界的影響,這份報告以該專區的 Illuminating the Frontier(照亮前沿)為題發布。報告開頭寫明:如果真的出現 Amodei 呼籲的那種設速協調,這些數字預期會改變。換句話說,Anthropic 先把基準線畫出來,讓「設速」從道德呼籲變成可以對照的數字。報告也把這三項量測放進既有的政策拼圖:模型能力的評估走責任擴展政策(RSP)的風險報告,規則制定走先進 AI 框架(AAIF)的政策提案,這次新增的指標補的是「模型怎麼被做出來」的生產過程,過去這一塊對外幾乎沒有量測。
研發自動化採用研究機構 Epoch AI 提出的自動化等級(Automation Level, AL)量尺,從 AL0 的完全沒有 AI 參與,到 AL5 的 AI 完全自主運作、無人介入。中間兩級是重點:AL3 定義為「協同」,AI 在人類密切指揮下承擔大塊工作;AL4 定義為「主導」,AI 能從一個高層次的提示出發,端到端完成大部分任務,人類只做監督。
報告用一個很具體的例子區隔這兩級:假設一條夜間資料管線壞了,明天運轉前要修好。AL3 的場景是工程師帶著故障日誌來找 Claude,自己先掃過一遍、心裡有假設,讓 Claude 調查與修復,中途冒出新問題就停下來等人決定,修完還要逐行檢視、親自重跑管線並且部署。AL4 的場景是工程師直接把故障警示丟給 Claude,它自己讀日誌、找出故障階段與原因、寫好修復、測試、處理意料外的狀況,寫一份報告標記工程師;工程師讀報告、掃一眼改動,決定今晚上線還是等一等。報告點出的關鍵差異是工程師不必再隨時盯著、隨叫隨到替 Claude 解鎖;至於部署,AL3 與 AL4 都留在人手上,要到 AL5 才會交給 Claude 自己動手。
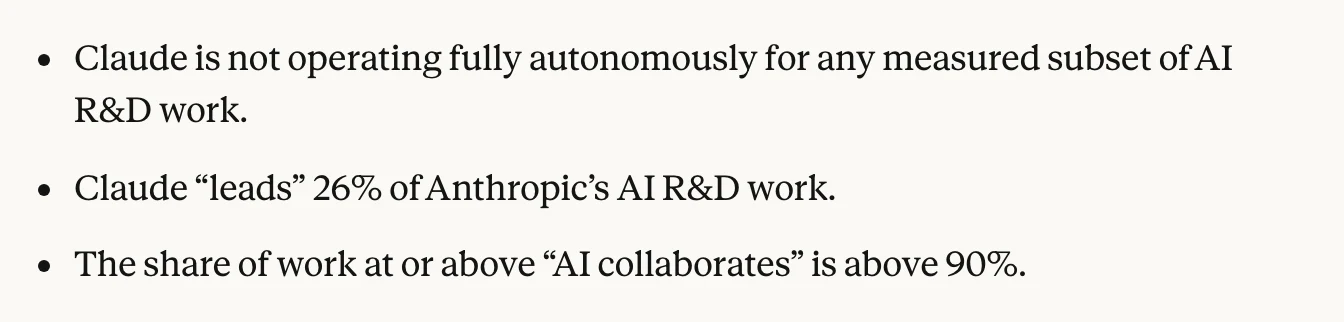
2026 年 8 月的量測結果有三條:Claude 在任何受測的研發子領域都沒有完全自主運作,AL5 為零;「主導」等級佔 26%;「協同或以上」超過 90%。正確的讀法是:AI 深度參與研發已經是常態,超過九成的研發工作至少有 AI 協同,但出貨前的授權與部署仍然由人類把關。這幾天網路流傳的「AI 已接管 Anthropic 研發」說法,超出了這份報告能支撐的範圍。
26% 不是問卷調查來的。方法在附錄裡寫得很細:2026 年 7 月的每個星期,從模型研發循環的各部門隨機抽樣 20% 員工,讓 Claude 研究代理讀取這些人當週在 Slack 與內部文件留下的工作紀錄,列出他們實際做的任務。整個 7 月累積出大約 15,000 項細粒度任務,再由 Claude 把它們組織成階層樹:根部是全部的模型研發,往下分出訓練、產品、預訓練、強化學習等分支,全樹 542 個節點,其中 378 個葉節點,細到「評測平台缺陷診斷與修復」這種等級。這張樹隨後被凍結,之後每次量測都對同一個籃子打分數,避免任務定義漂移。
評分交給另一個獨立的 Claude 裁判模型:對每個節點,研究代理先深入調查這類工作在公司裡實際怎麼做、用哪些工具、AI 做了多少,裁判再依證據評出自動化等級,而且只看該月份或更早的資料,避免事後全知。權重則用工時分配:一個人一週算一個單位,平分給他當週的任務,加總起來就是各節點的分量。為了檢查裁判的可信度,Anthropic 讓實際負責各領域的員工在不知道模型看過什麼證據的條件下盲評:模型與人類的完全一致率是 59%,人類彼此之間只有 35%;差距壓在一個等級以內的吻合度達 97%。
報告也老實列出兩個跨實驗室比較的障礙:各家還沒有共同的方法論,以及用自家模型當裁判,裁判可能犯跟受測模型同一類的錯。提出的解法是讓第三方或別家模型交叉驗證,並把這類量測當成更強要求的觸發器,例如新模型要投入進一步的研發使用前,先經過一段固定的測試期。
附錄裡還有一個設計細節值得注意:任務樹是拿 2026 年 7 月的資料建的,如果研究工作持續長出新形態,固定籃子就會失真。Anthropic 的檢查方法是另建一個以 1 月資料為底的對照樹,比對 2 月到 7 月每個月新出現的任務,結果沒有觀察到新型任務增加,模型研發工作的結構在這個分析層級上算是穩定。他們也計畫日後定期重建任務樹,並對已發布的自動化數字同步改版。26% 是對著 7 月籃子量出來的 8 月成績,籃子本身會按計畫換新。
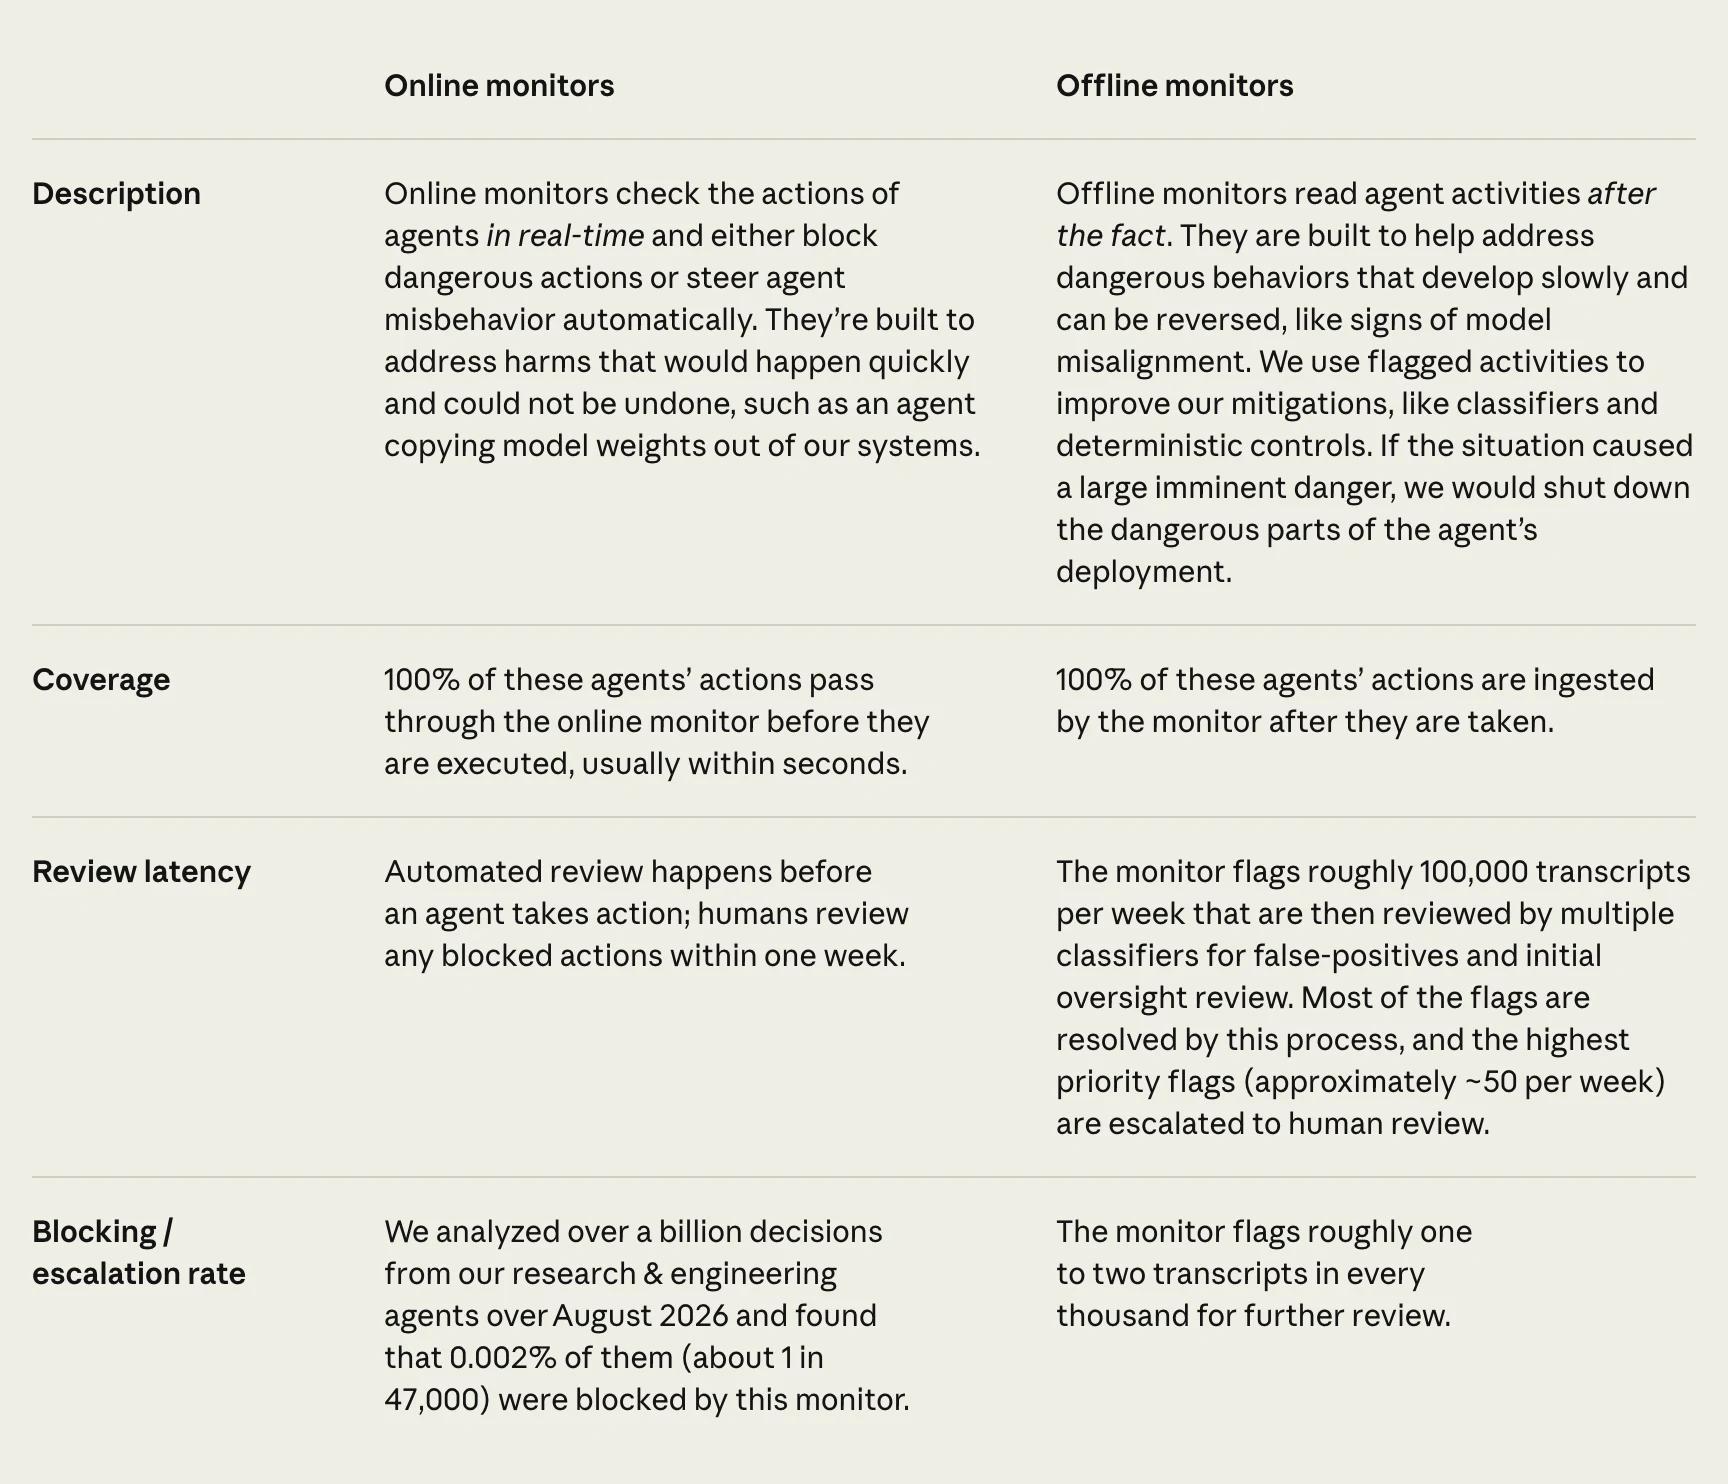
監督是另一項量測的核心。工作從「AI 協同」走向「AI 主導」的過程裡,代理做的決策越來越有分量,例如下一個研究方向要往哪裡走;報告的判斷是,單一代理在現有監控資料裡很少出亂子,但當經濟體裡有數百萬、數十億個代理在運作,再罕見的異常也會定期發生,所以覆蓋率與攔截率本身就該被量測。2026 年 8 月,Anthropic 最常用的內部平台上隨時有大約 30,000 個 AI 代理在執行研究與工程工作,這個數字只涵蓋該平台。這些代理單月產生超過十億次行動決策,全部經過兩層監控:線上監控在行動執行前檢查,覆蓋率 100%,通常幾秒內完成;離線監控在事後讀取全部活動紀錄,覆蓋率同樣 100%。
量出來的數字是:十億多次決策裡,0.002% 被線上監控攔下,大約每 47,000 次行動擋下一次,被擋下的行動由人在一週內複查;離線監控每週標記大約十萬份對話紀錄,經過多層分類器過濾誤報後,最高優先的約 50 起交給人工審查。設計意圖分得很清楚:線上層擋的是快速且不可逆的危害,例如代理嘗試把模型權重複製出系統;離線層找的是緩慢發展、可以補救的問題,例如行為偏離訓練意圖的跡象。
外部驗證有一個起點:報告註明 METR 曾獨立對 Anthropic 的離線監控平台做過紅隊測試。這些監督量測同時發布在該公司近期出版的風險報告裡,等於把內部監控的規模與攔截率放上對外文件。
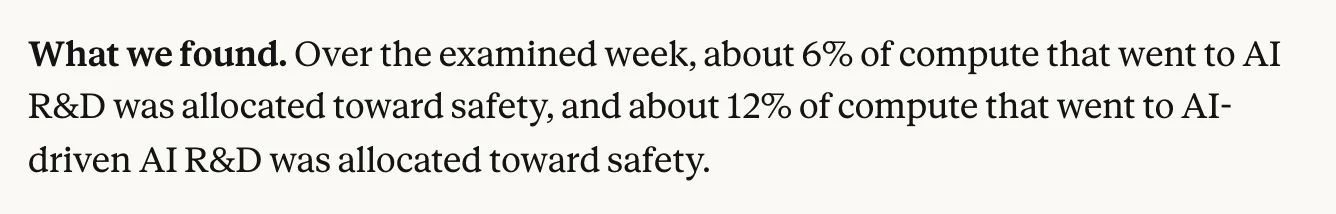
算力分配是最容易引發情緒的量測,也最需要看口徑。Anthropic 檢視 2026 年 7 月 13 日到 20 日一整週的全部算力,把每個工作負載分類後問一個問題:投入 AI 研發的算力裡,有多少屬於安全工作?答案約 6%;若只看 AI 驅動的研發算力,比例是 12%。分類的做法是對該週近一萬次運算任務按算力消耗加權抽樣約 14%,由提示過的分類器逐一判讀,兼顧能力與安全的工作一律歸入非安全。
報告強調這是刻意保守的估計:既能推進能力又能增進安全的工作不計入安全;線上防護分類器的推論算力,報告形容為與安全研發相當的另一批開銷,也完全沒有計入。同時提醒算力本來就難當安全投入的代理指標:安全研究多半是研究員花時間設計實驗的腦力活,跑實驗本身不太吃算力,而前沿訓練動輒吃掉整批加速器。
三個限制也寫得明白:分類依賴的底層標籤是自動規則與人工設定的 best-effort,未經驗證;只量了一週,足以證明量得到,不足以成為趨勢;算力份額只反映花費,分類器變快、比例就下降,不代表安全工作變少。6% 是個會讓人停下來的數字,但它量的是算力流向,不是安全投入的全貌。
把三項指標放回一起看,這份報告真正的立場是:先把自家數字攤開,同時承認首份快照尚未經外部驗證。裁判與受測者同源、分類靠抽樣與自行定義的判準、快照只涵蓋單月與單週,這三條邊界都不是外人找碴,是報告自己逐條寫出來的。這種寫法反而提高了整份文件的可信度:它沒有假裝 26% 是審計過的數字。
下一步的承諾是讓機制補上自評:報告寫道,Anthropic 計畫讓來自多個機構的獨立評估員進駐,取得與內部風險評估團隊相當的流程、系統與資料存取權,負責查核安全措施、回報事故、監控這類關鍵指標。要注意動詞時態,這是計畫層級的宣示,評估員尚未進駐,進駐後的權限範圍也要等落地文件才算數。與 9 月中前後關於「誰來當裁判」的標準機構討論(相關討論)放在同一條線上看,前沿 AI 的信任議題正從宣示階段走向機制階段,而量測是機制的地基。
對持續追蹤這條線的讀者,這份報告留下三個可驗收的訊號。獨立評估員是否真的進駐,包括機構名單與時間表。三項指標是否常態化發布,下份快照什麼時候來、方法學會不會公開到讓外人重跑。其他實驗室是否採用同口徑,沒有共同方法論,跨廠比較就沒有基準可言,這也是報告自己點出的核心障礙。
另一個實用的提醒:這兩天中文圈流傳的幾個數字,例如「2026 年 2 月還不到 1%、半年暴增 26 倍」,或「AL3 佔約 65%」的分佈圖,並沒有出現在這份報告裡。報告只交代 8 月的 26% 與 90% 兩個數字門檻,沒有提供歷史對比,也沒有公布各等級的完整分佈。看到更精細的圖表,先回報告原文確認它是不是真的寫了。
至於 26% 本身,它標記的位置比數字大小更值得記住:AI 參與研發已經站上「主導」的門檻,而部署的授權還在人類手上。報告結尾的承諾是會繼續發布這些量測。放慢與狂奔的辯論短期內不會有結論,但至少從這份報告起,雙方有了可以對帳的數字。