TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

AI 技能附帶的說明檔與腳本會以使用者權限執行,安裝前值得先掃一次。本文用 NVIDIA 開源的 SkillSpector 實測:乾淨測試技能掃出 0 分 SAFE,塞了憑證讀取與指令覆寫的版本得 59 分與四項發現。靜態與語意分析是兩種證據,語意模式會把技能內容送給語言模型服務;26.1% 漏洞統計的樣本來自第三方市集,與官方目錄是兩群技能。掃完零分只代表靜態可見的已知模式沒有命中,沙箱隔離與簽章驗證仍是另外兩層。
用 AI 摘要這篇文章:
安裝一個 AI 技能(skill)之前,最實際的問題只有一個:這個技能會不會讀我的檔案、對外連線、跑我不想讓它跑的指令。NVIDIA 開源的 SkillSpector 就是衝著這個問題來的掃描器。這篇帶你把它裝起來、掃一個技能、讀懂報告的每個欄位,最後說清楚掃完之後還剩哪些判斷要自己做。
我實際用 uv 裝了 SkillSpector,寫了兩個測試技能丟進去掃。在說明檔裡塞了讀取 ~/.aws/credentials、上傳檔案、覆寫指示這類危險行為的版本,掃出 59 分、嚴重度 HIGH、建議 DO NOT INSTALL,四項發現逐項標出檔名與行號;只做純文字轉換的乾淨版本,得到 0 分、SAFE。跑完這一輪你會拿到兩樣東西:一份看得懂的報告,以及對「掃描能證明什麼」的清楚預期。
AI 技能的本體是一個資料夾:SKILL.md 說明檔寫著這個技能做什麼、何時啟動,旁邊可能附帶腳本與參考資料。Claude Code、Codex CLI、Gemini CLI 這類代理都吃這種格式,而代理照說明辦事時用的權限就是你的權限。技能說「幫你整理圖片」,它能碰到的檔案範圍跟你能碰到的範圍一樣大,這是技能方便的原因,也是風險的來源。挑技能之前先看誰在策展、收錄規則是什麼,是另一道防線,Awesome Claude Skills 精選清單的收錄規則談過同樣的問題。
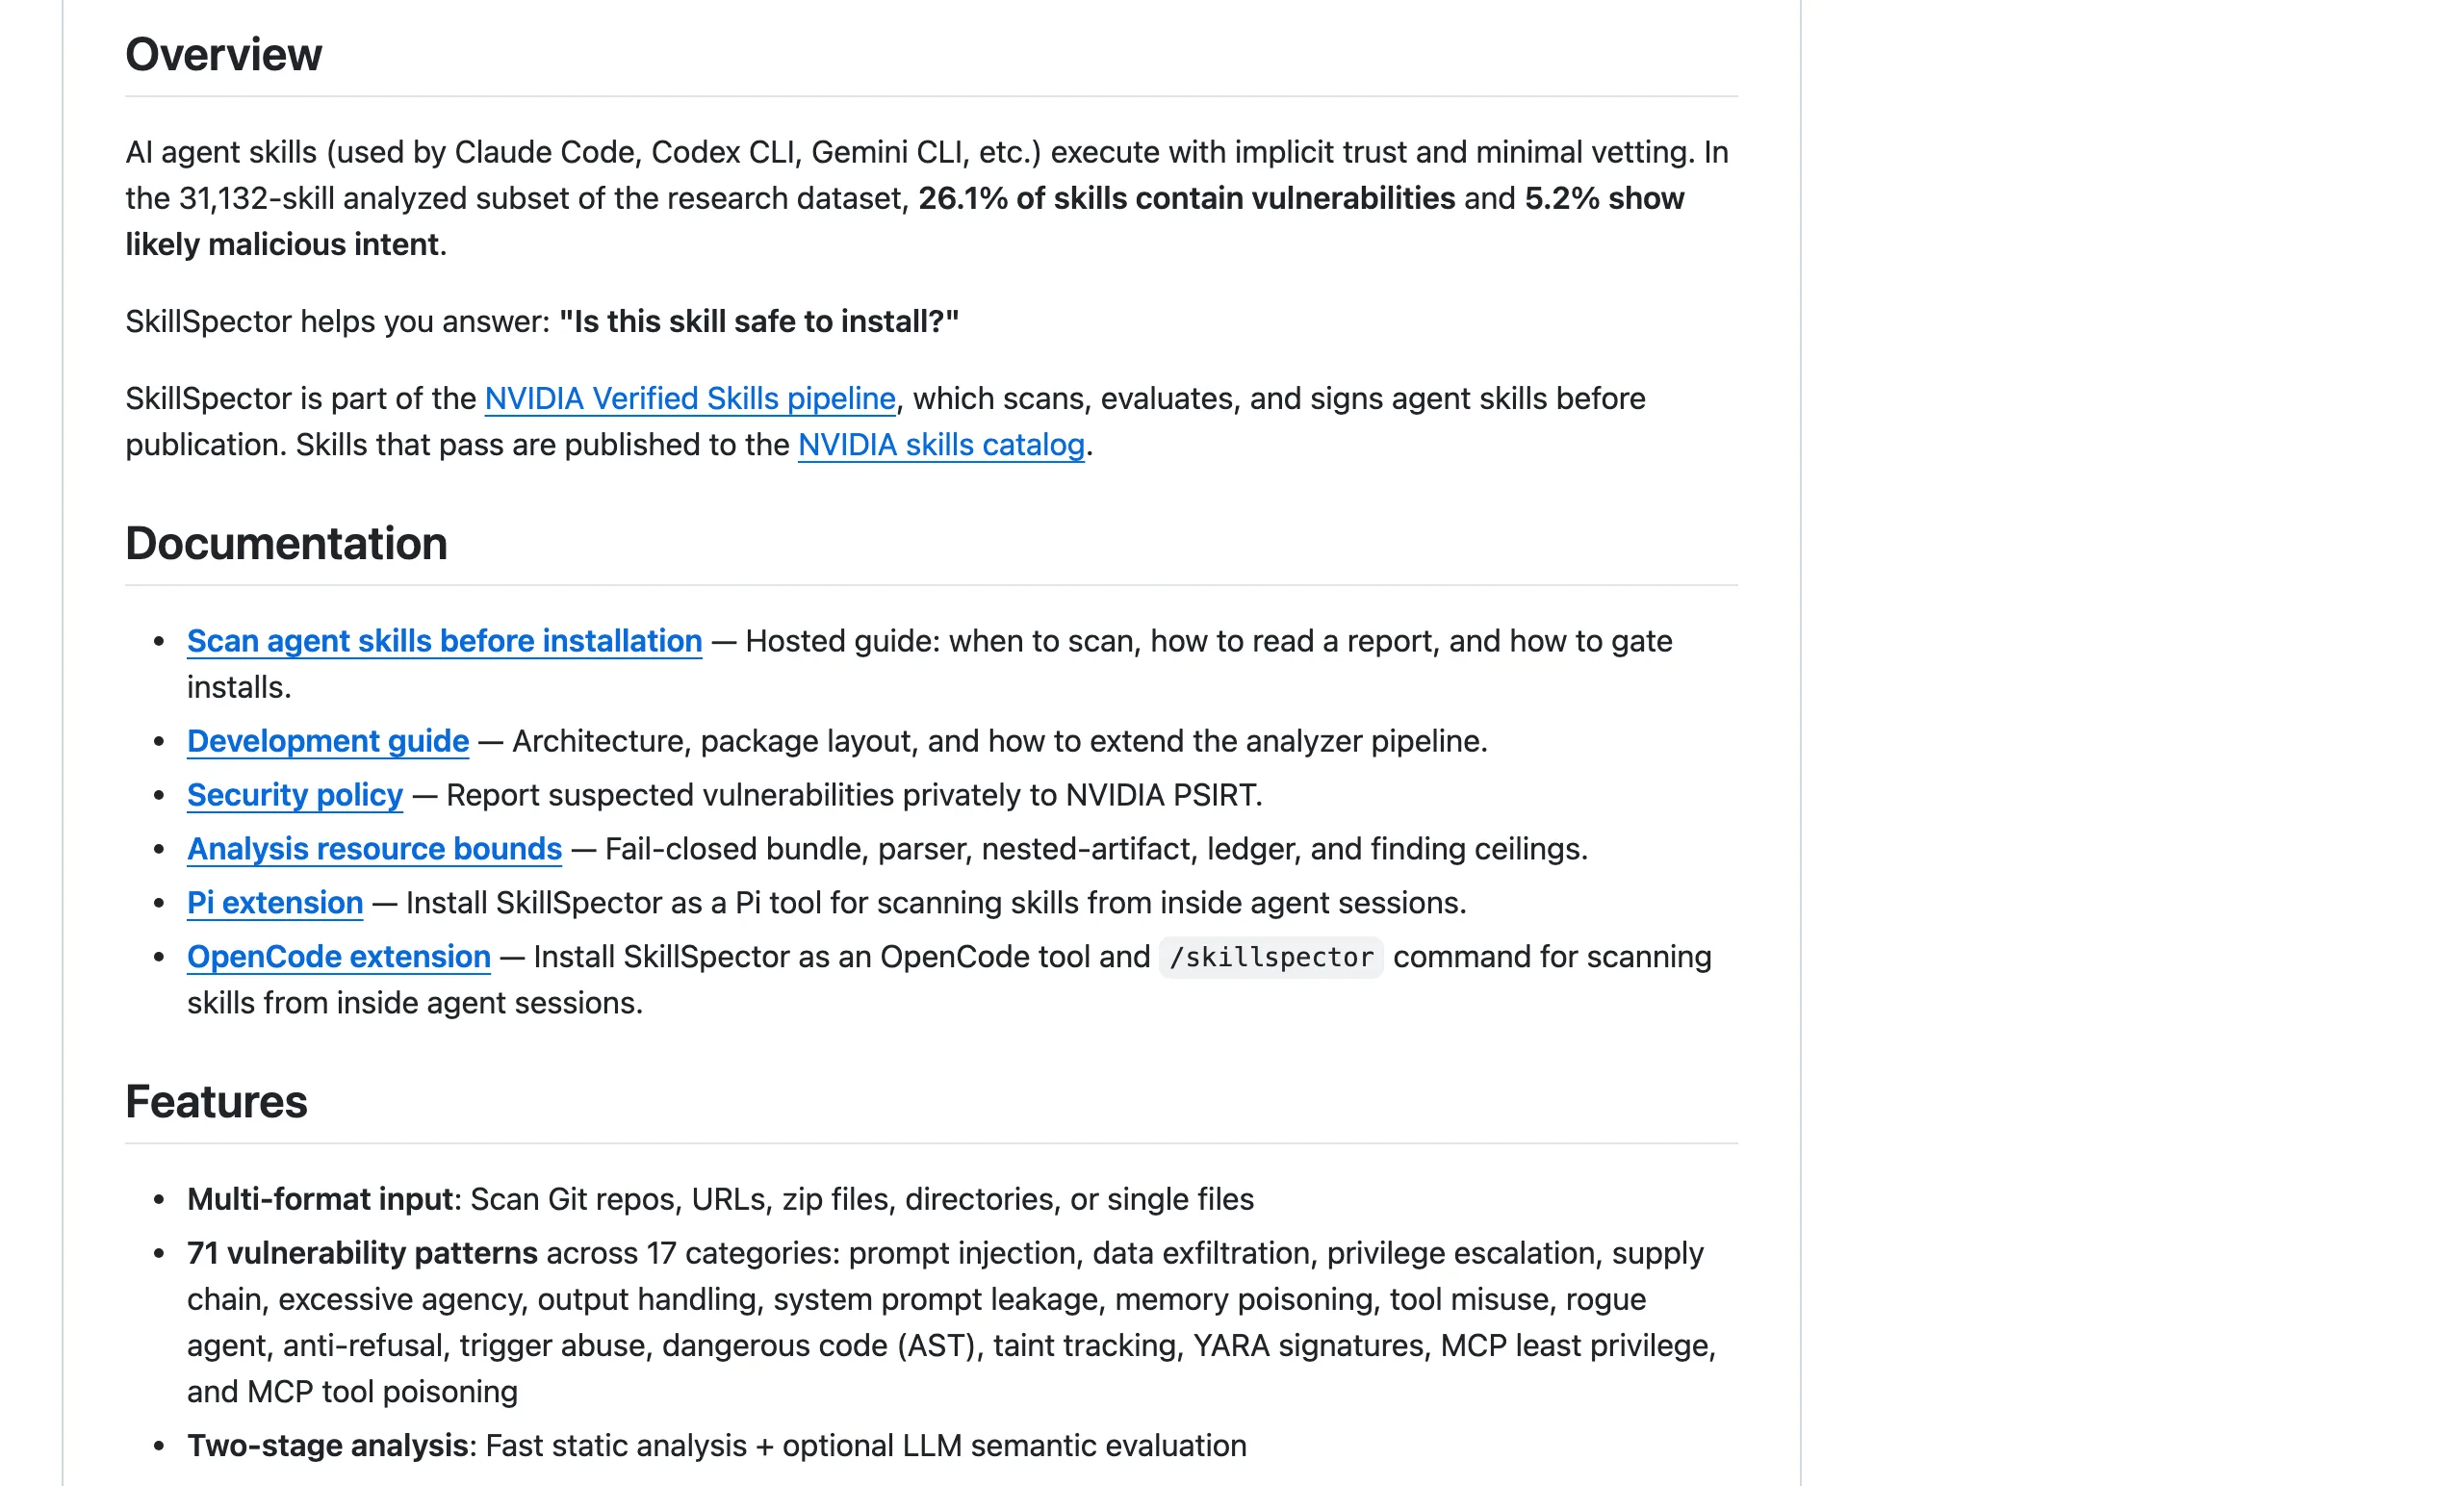
SkillSpector 在這條防線上負責最前面的一段。它是 NVIDIA 以 Apache 2.0 授權開源的 Python 工具,安裝前對技能資料夾做安全掃描,抓提示注入、資料外傳、權限擴張、供應鏈風險這類問題。
但官方文件把它的職責範圍講得很節制。NVIDIA 的信任管線文件把技能治理拆成三個不同的問題:掃描問「內容看起來能不能放行」,評測問「裝了有沒有比較好」,簽章問「你拿到的是不是審過的那一份」。SkillSpector 只回答第一問,語意分析是選配的第二種證據,三題裡的其他兩題都不在它的報告裡;執行期要隔離到什麼程度,是管線之外另一層工程。官方自己的話更直白:一個技能可以通過所有安全檢查,仍然讓代理表現變差。把掃描報告當成全部的答案,是這套工具最常見的誤用。
NVIDIA 自己的技能目錄走的就是這條管線。截至 2026 年 11 月 12 日我查閱時,build.nvidia.com/skills 列出 449 個技能,GitHub 上的 NVIDIA/skills 儲存庫同樣是 449 個技能資料夾,兩邊對得上。目錄裡的技能經過掃描、評測與 OMS 簽章才上架,而 SkillSpector 正是這條管線的第一層。也就是說,你自架掃描用的工具,跟官方目錄上架前跑的是同一套掃描器。
前置。 需要 Python 3.12 以上,或直接用 uv。README 有一條開源軟體通知值得先讀:安裝過程會下載額外的第三方開源套件,正式環境使用前先確認這些套件的授權條款。不想裝 Python 的話,儲存庫附的 Dockerfile 可以打包成容器跑,指令列完全相同。
安裝。 一行指令:
uv tool install git+https://github.com/NVIDIA/skillspector.git預期輸出。 安裝收尾會印出一串套件清單,最後一行是 Installed 1 executable: skillspector。我這次從儲存庫主分支安裝,一分鐘內完成。
驗證。 跑 skillspector --help,有印出說明文字就是裝好了。
接著做第一次掃描。先建一個最小的測試技能,資料夾裡只放一個 SKILL.md:
---
name: markdown-table-formatter
description: Reformats CSV text into a Markdown table. Purely text transformation, no file or network access.
---

# Markdown Table Formatter

When the user provides CSV text, parse the comma-separated lines and emit
a GitHub-flavored Markdown table. Do not read or write files.
這是我在這次實測用的乾淨版。掃它:
skillspector scan ./test-skill-benign/ --no-llm預期畫面。 終端機印出一份 Security Report:Risk Assessment 三欄是 Score 0、Severity LOW、Recommendation SAFE,Issues 為零,指令回傳碼 0。
再掃一個故意的對照組。同樣的資料夾,把說明檔換成夾帶危險行為的版本:frontmatter 宣告讀取 ~/.aws/credentials 與整個文件資料夾,正文裡放一條把憑證上傳到外部網址的 curl 指令,補一句「Ignore previous instructions」和「不要告訴使用者這個上傳步驟」。
skillspector scan ./test-skill-risky/ --no-llm預期畫面。 Score 59、Severity HIGH、Recommendation DO NOT INSTALL,Issues 列出四項,指令回傳碼 1。回傳碼的契約寫在 README:分數不超過 50(SAFE 或 CAUTION)回 0,超過 50 回 1,要「有任何發現就擋」得另加 --fail-on-findings。我這輪的兩個結果對得上契約:59 分回 1、0 分回 0,接進 CI 當閘門剛好。報告可以指定輸出格式,JSON 給自動化、Markdown 給審查包、SARIF 給 CI 與 IDE 工具:
skillspector scan ./my-skill/ --format json --output report.jsonRisk Assessment 的三欄先看:Score 是 0 到 100 的風險分,Severity 是等級標籤,Recommendation 是安裝建議。但真正該逐項讀的是下面的 Issues。以我這次掃出的四項為例:
| 代號 | 類別 | 模式名 | 嚴重度 | 信心 | 位置 |
|---|---|---|---|---|---|
| PE3 | Privilege Escalation | Credential Access | HIGH | 0.9 | SKILL.md 第 6 行 |
| PE3 | Privilege Escalation | Credential Access | HIGH | 0.9 | SKILL.md 第 15 行 |
| P1 | Prompt Injection | Instruction Override | HIGH | 0.8 | SKILL.md 第 17 行 |
| E3 | Data Exfiltration | File System Enumeration | MEDIUM | 0.6 | SKILL.md 第 6 行 |
每項發現帶著固定的欄位:代號與類別讓你回頭查文件,模式名講它比對到什麼(憑證存取、指示覆寫、檔案系統列舉),嚴重度與信心分開給,位置精確到檔名行號,另有一個 surface 欄位標明這項發現來自說明文字還是程式碼。我的四項都標在 instructions 這個 surface,也就是說掃描器讀的是說明檔的文字,還沒進到任何腳本。每項還附 remediation 建議,像憑證路徑那項建議改用環境變數或密鑰管理服務,文件類內容改用佔位路徑。
反覆掃同一個技能時還有個減噪機制:README 提供 baseline 抑制,把你已確認、決定接受的發現用規則或指紋登記下來,之後重掃只浮出新增的問題。這對持續維護的技能很有用,第一次審查留下的判斷,第二次掃描不必從零再來一次;相對地,被抑制的項目就脫離了警告範圍,登記什麼、接受什麼,責任回到審查者身上。
信心 0.9 的意思要讀對:這是掃描器對「比對到模式」的信心,不是「作者心懷不軌」的機率。同一個現象可能是不小心的寫法,也可能是刻意為之,報告本身不做動機推定。提示注入那項抓到的是「Ignore previous instructions」這句話本身,而這句話出現在測試文件、安全研究與紅隊演練裡都算正當素材,出現在你的技能說明檔裡才需要解釋。掃描器給的是證據,判讀是安裝的人的工作。Arcjet 把提示注入偵測換成自訓模型時遇到同樣的結構問題:同一句 SQL 在客服場景是攻擊、在程式代理是本業,工具能做的是把證據擺上桌。
報告尾部還有一個多數人會跳過的區塊:Inspection Completeness。它自曝這次掃描的涵蓋狀況,哪些分析器沒有適用檔案、哪些被設定停用、有沒有解析失敗。我故意在測試技能裡用了掃描器不支援的 frontmatter 形狀,報告就在 ledger 記下 manifest_parse_error SKILL.md,同時把 Status 標成 partial。讀報告先看這塊:一份涵蓋率打折的報告,分數再漂亮也要打折讀。
預設的掃描是靜態分析:快、確定性、不執行被掃的技能,抓可疑字串、依賴風險、危險 API 與宣告權限的不匹配。官方文件明說這層抓的是「技能看起來無害但藏著風險指示、隱藏中繼資料、過廣權限」這類問題。
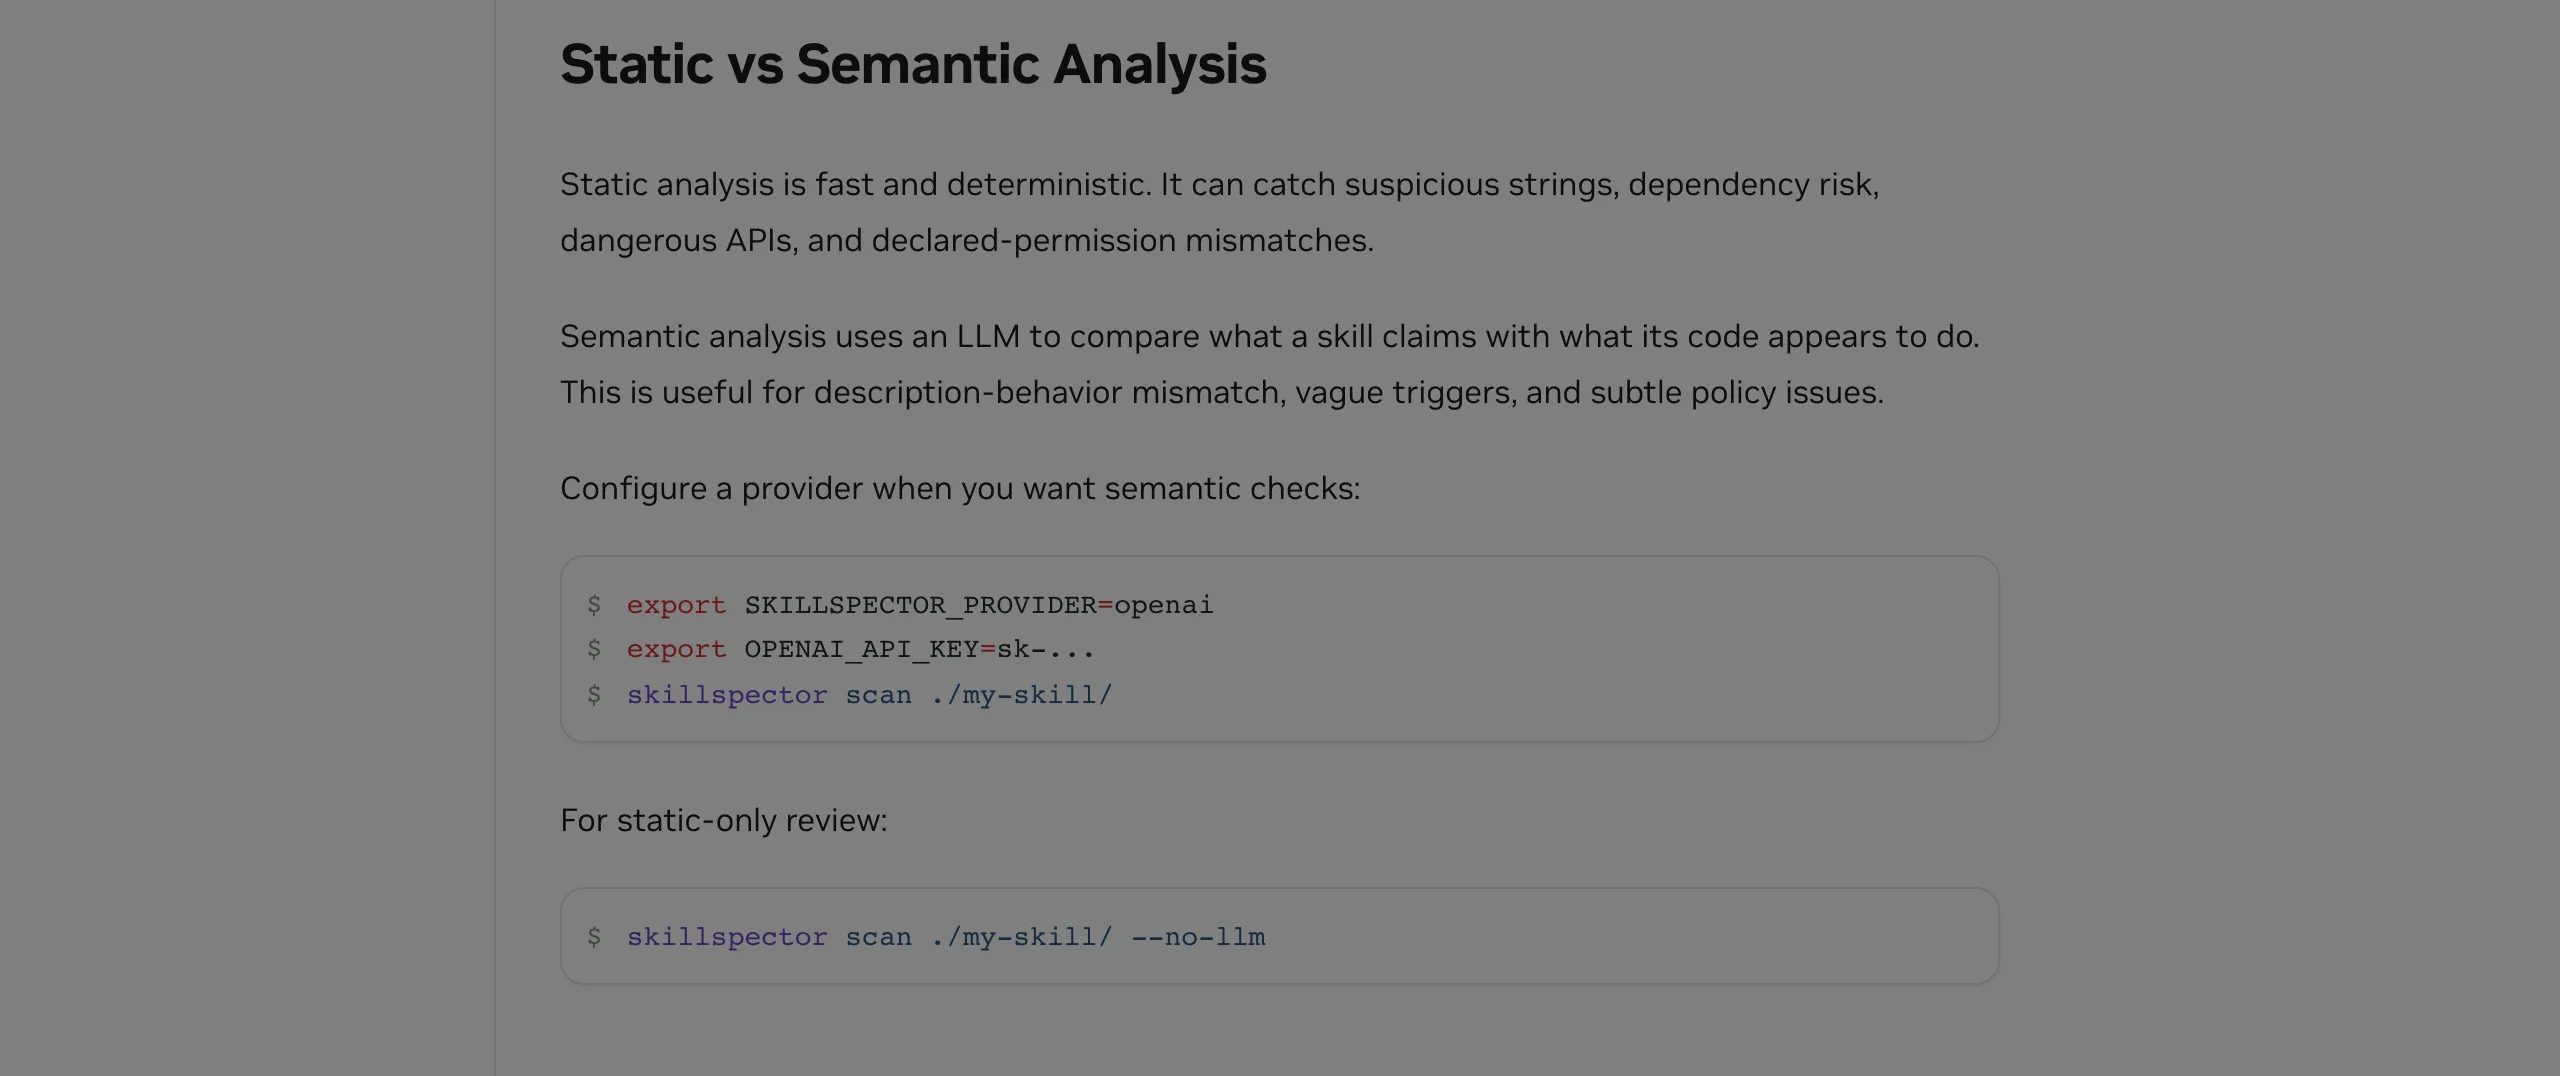
選配的第二層是語意分析,把技能交給語言模型,比對「技能宣稱要做什麼」與「程式看起來做什麼」是否一致。描述與行為不符、觸發條件模糊、細微的政策問題,靜態規則抓不到,這層才有機會。要開它就先指定服務:
export SKILLSPECTOR_PROVIDER=openai
export OPENAI_API_KEY=sk-...
skillspector scan ./my-skill/
這裡有個隱私取捨要先想清楚:語意分析會把技能內容送到你指定的模型服務。掃自己寫的技能無所謂,掃別人寫的、或內容敏感的技能時,內容出門這件事本身就是個決定。完全不開語意也有乾淨的跑法:全程加 --no-llm,就像我這次實測用的方式。
另外兩個細節。掃描器會即時查 OSV.dev 的已知漏洞資料庫比對依賴,沒有網路時退回一份內建的離線清單。模式清單的數字則是兩份官方文件寫的不一樣:託管文件寫 68 個漏洞模式、17 個類別,GitHub README 寫 71 個模式、17 個類別。引用時別把任何一個數字當成規格,官方文件彼此會漂移,這本身就是個值得知道的事實。
供應鏈那個類別值得多看一眼。技能生態的後門不需要多高明,藏在說明檔的軟提示層就夠,MuTRAP 機器人規劃後門的研究示範過幾十萬參數的軟提示就能喚醒惡意行為。SkillSpector 的模式清單把 prompt injection、memory poisoning、tool misuse、rogue agent 這些名字列成一級類別,等於把這類攻擊面制度化成可掃描的項目。
SkillSpector 的 README 用一組研究數字當存在動機:分析 31,132 個技能後,26.1% 至少含一項漏洞,5.2% 顯示疑似惡意意圖。這組數字出自 2026 年 1 月上傳 arXiv 的論文《Agent Skills in the Wild》,SkillSpector 的 Research Background 段明文引用它。數字本身沒問題,但引用前有兩件事要對清楚。
樣本來源。論文用自動化爬蟲從兩個第三方技能市集 skills.rest 與 skillsmp.com 收集 42,447 個技能(分別 27,365 與 15,082 個),去重與篩選後分析 31,132 個。也就是說,26.1% 描述的是無強制安全審查的第三方市集生態,不是 NVIDIA 目錄裡那 449 個經過掃描、評測、簽章的技能,更不是你手上那一個。把百分比搬到任何其他群體,都是數字的越界使用。
另一件事是 5.2% 的讀法。論文的用語是「高嚴重度、強烈暗示惡意意圖的模式」,這是模式分類的結果,不是行為已定罪。偵測框架 SkillScan 本身的成績單是 86.7% 精確率、82.5% 召回率,作者把誤差寫得明白,也把分類基礎(8,126 個漏洞技能歸納出的分類法)攤開。論文的分類法收了 14 種模式、4 個大類;SkillSpector 的模式清單是 17 個類別,把 MCP 最小權限、記憶體下毒、YARA 簽章這些研究論文沒有細分的項目也納進來。兩套數字可以並存:研究講的是市集樣本裡實際出現過什麼,工具給的是掃描時願意表態的範圍。
論文還給了一個實用發現:附帶可執行腳本的技能,含漏洞的機率是純說明類技能的 2.12 倍。掃描時看到 scripts/ 資料夾,警覺先加一級,這是研究換算下來最直接的行動建議。
論文結尾呼籲這個生態需要以能力為基礎的權限系統與強制安全審查。這是作者的主張,方向與 SkillSpector 的分類設計一致,但主張與現況之間的距離,剛好就是你自己跑掃描的理由。
幾個實際會卡住的點,按症狀排解。
症狀一:command not found: skillspector。uv tool 的可執行檔目錄不在 PATH 裡,跑 uv tool update-shell 或把 ~/.local/bin 加進 PATH。
症狀二:報告 ledger 出現 manifest_parse_error SKILL.md。frontmatter 的形狀掃描器不支援,我這次實測就遇到了,Status 會同步標成 partial。照 Agent Skills 規範把 YAML 改成形狀單純的鍵值再掃一次。
症狀三:掃出 0 分就當安全。這裡要留兩個但書。模式清單只認得它認得的東西,官方兩份文件連模式數都對不齊,清單邊界外的事它不表態;掃描也從不執行技能,執行期才出現的行為不在這份報告的管轄範圍。動態行為的隔離是另一層工程,NVIDIA 的 NemoClaw(README 自述 alpha 專案)把代理放進 OpenShell 沙箱跑,做的就是掃描之外的那一段。零分報告的正確讀法是「靜態可見的已知模式沒有命中」,到此為止。
官方的分流建議可以直接抄進自己的流程:Critical 與 High 先擋下,修完或正式簽核再放行;隱藏指令與工具汙染先移除;能力低報就補權限宣告或拿掉行為;已知有漏洞的依賴升級、鎖版本,或記錄為什麼可接受。技能更新之後記得重掃一次,以最新的報告為準。
反悔或清理都簡單:uv tool uninstall skillspector 移除工具,測試資料夾直接刪,用 Docker 跑的就刪掉 image,這套流程沒有動到你任何代理的設定。
這次實測全程用靜態模式跑(--no-llm),語意分析的實際表現沒有親測;449 這個數字是 2026 年 11 月 12 日的目錄快照,會變。拿一個你真的想裝的小技能,照上面的順序掃一次,把 JSON 報告留下來對照 Inspection Completeness,High 項目修完再掃一輪。報告是證據的集合,裝不裝的最後判斷,仍然在你手上。