TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

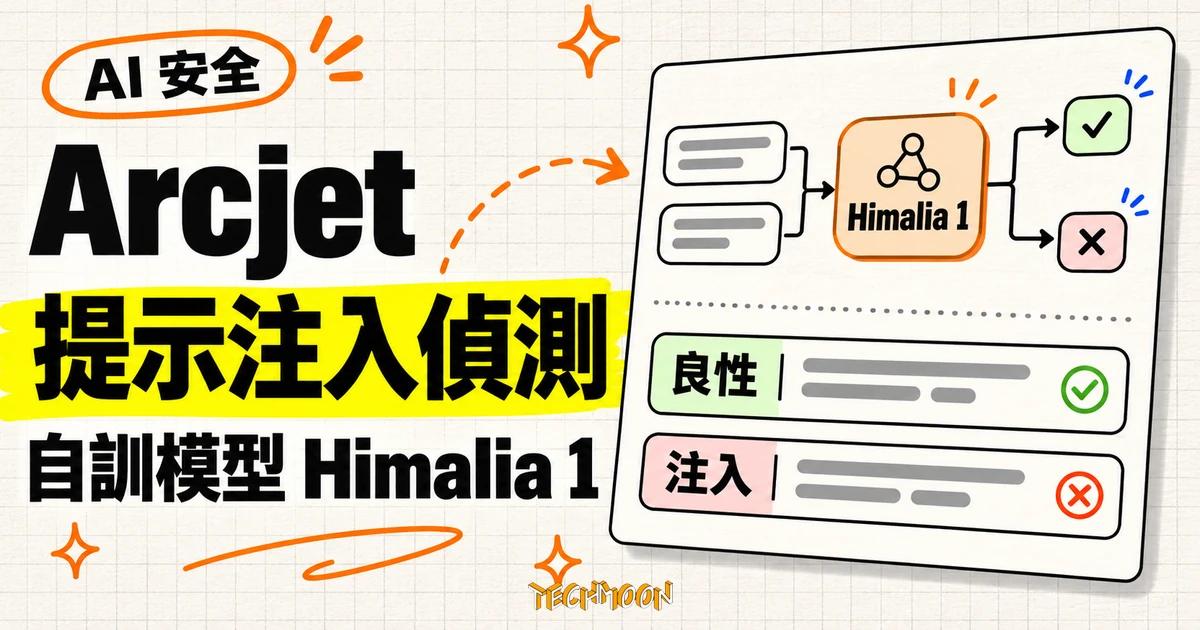
Arcjet 於 2026 年 11 月 5 日把提示注入偵測後端換成自訓的 Himalia 1,所有 SDK 呼叫直接生效;程式代理用的 Thebe 與資安代理用的 Carme 僅開放早期申請,公開效能表是資料集口徑。
用 AI 摘要這篇文章:
2026 年 11 月 5 日,Arcjet 發表自家訓練的 AI 安全模型系列,提示注入偵測的後端當天就換上第一個成品:通用模型 Himalia 1。所有呼叫提示注入偵測的 SDK 請求直接改跑新模型,整合端不用改任何程式。同場發表的另外兩個型號,給程式代理的 Thebe 1 與給自主資安代理的 Carme 1,目前只開放早期申請,還不是每個開發者都拿得到的能力。
這次改版真正值得記下的地方,是 Arcjet 把一個長期被含糊處理的問題寫進了產品結構:同一段文字算不算提示注入,取決於代理正在做什麼工作。把這件事當真,模型就得按場景拆開;只有通用版上線、專用版還在門外,也是這個結構的自然結果。
受影響最直接的是已經在用 Arcjet 提示注入偵測的應用:後端自動換新,攔截行為可能跟著變。還沒用的團隊,這份官方公告的價值在於公開了一個判斷(通用偵測在程式與資安代理場景會嚴重誤擋),以及一張可以對照自家流量的效能表。
換模型之前的偵測,是兩個開源分類器的組合。Arcjet 對它的評價並不客氣:誤擋與漏接的回報是常態。但要自己重練,官方給了三個理由。授權上,允許商業使用的提示注入偵測模型很少,開放存取、開源、開放權重是三件不同的事,很多看起來能用的模型其實不能放進商業服務。資料上,公開的提示注入資料集數量不多而且互相重疊,同一段文字在一個集裡標良性、在另一個集裡標惡性;用這些資料訓練的模型,常常是在自己看過的題目上被評測,發布的分數因此高於對新輸入的準確度。定義上,有的資料集把「問一句助理怎麼設定」算成攻擊,有的把要求有害內容也混進來。
最後這點畫出了一條常被搞混的界線:提示注入防護管的是文字是否假裝成指令、想改寫代理的任務;內容審核管的是文字本身是否有害。兩者獨立,混在一起就無法回答「一次阻擋究竟防住了什麼」。Arcjet 也確實把基於 Google ShieldGemma 微調的內容審核模型列為即將另行公告的產品,並沒有隨這次一起上線。看新聞時把兩者算成同一件事,會高估今天真正改變的範圍。
公告裡最能說明整套設計的例子,是一句 SQL。SELECT * FROM users 丟進客服聊天,是想碰機器人不該碰的資料,是注入;貼進程式代理,就是工程師的日常。同樣的邏輯也適用於 shell 指令、讀取環境變數裡的金鑰、要求代理印出系統指示:在客服場景都是攻擊訊號,在開發場景都是工作本身。
於是 Arcjet 把場景拆成三種,各配一個型號。客服與直接對外的模型端點應該保守,SQL、shell 指令與索取內部指示本來就不該出現在對話裡,Himalia 為這種情境而生。程式代理的 SQL 與 shell 是工作,下指令的開發者通常不是威脅來源,風險在代理自己拉進來的內容:工具輸出、抓回的網頁、安裝進來的技能,Thebe 針對這類流量訓練。自主資安代理最極端,它讀的 CVE 通報、安全公告、issue 與 changelog 通篇都在描述攻擊,文字表面全是會觸發偵測器的詞彙;真正的攻擊是藏在這些內容裡的指示,叫代理洩漏機密、塞入惡意依賴、削弱安全檢查,或把新指示寫進代理之後會讀到的設定檔,Carme 處理的就是這種情境。適用範圍也值得留意:這次換後端的是 Arcjet 提示注入偵測這條產品線,整合點照舊落在各語言 SDK 與框架介接層,官方文件列出的選項從 Next.js、Node.js、Python、Go 到 Claude Agent SDK、LangChain、OpenAI Agents 等代理框架都有,對已在這些框架上工作的團隊,接入成本主要落在規則設計,技術棧不必更換。
官方沒有迴避後果:通用模型在程式與資安這兩種場景會有高誤擋。這也是 Thebe 與 Carme 存在的理由。
專用模型之外,公告也說明了程式代理現行的兩階段審查。第一關先由微調模型掃過每個工具結果,標出看起來像注入的段落;第二關再由決策模型把這些段落,連同代理的任務、回傳內容的工具、近期的工作階段紀錄放在一起看,判斷它是攻擊,還是關於攻擊的內容。公告並未說明第二階段決策模型是否同樣出自這波自訓系列,這會影響整套流程未來的計價與延遲特性,是導入前值得向官方確認的問題。
把情境放進第二關有個具體理由:一場分散在多個訊息裡的攻擊,單看每一則都像良性,逐則判斷正好會漏掉。Thebe 的目標也有明確邊界:用程式代理流量訓練的第一關更準,需要第二關介入的次數就會減少。官方的說法停在這裡;「有了專用模型就不再需要情境判斷」是更強的主張,公告並沒有這樣講。
Himalia 1 的底盤是 Qwen3-0.6B,一個以 Apache 2.0 授權釋出的六億參數模型。Arcjet 做的是全參數微調,讓每個權重都更新,而不是只調整外掛的少量參數,再把原本生成文字的輸出端換成二分類頭,只回答良性或注入。官方形容成品體積約為 frontier 模型的千分之一,這是它能放進每個請求流程反覆執行的前提。
公告裡最誠實的一段,是訓練資料的插曲:早期資料裡幾乎沒有短的良性文字,模型於是把「短」學成了攻擊線索。資料分布本身就足以讓分類器抓到無關特徵。後續的修正靠的是資料清理,移除重複與錯標樣本、排除與評估集合重疊的資料,訓練時保留精確率與召回率曲線下面積最好的檢查點。
需要畫清的界線是授權:基底模型開源,不等於成品開源。公告沒有宣布公開 Himalia 的權重、訓練資料或整套服務的重製權利;使用者接的是 Arcjet 自行維運的雲端服務。官方也以此提供 SOC2 與 HIPAA 等合規框架的遵循宣稱,這部分屬於廠商說法,需要合規文件的團隊應向官方索取證明。
公告附了一張 Himalia 1 在兩個公開資料集上的測試表。官方其實也對自家的專有資料集做了測試,但表格只公開了公開資料集的數字,專有部分的成績沒有隨公告釋出:
| 資料集 | F1 | 精確率 | 召回率 | 誤報率 | 漏報率 |
|---|---|---|---|---|---|
| neuralchemy/Prompt-injection-dataset | 0.964 | 0.969 | 0.958 | 0.044 | 0.042 |
| jackhhao/jailbreak-classification | 0.971 | 0.978 | 0.964 | 0.024 | 0.036 |
五個欄位各回答不同問題。F1 是精確率與召回率的綜合;精確率看被判為攻擊的內容有多少確實是攻擊,召回率看所有攻擊裡被抓出多少。對產品體驗最直接的其實是誤報率:0.044 換算下來,一萬筆符合該資料集分布的正常輸入,約有四百四十筆會被誤攔。在正常流量遠多於攻擊的客服場景,這個數字直接決定有多少使用者會無故被擋。
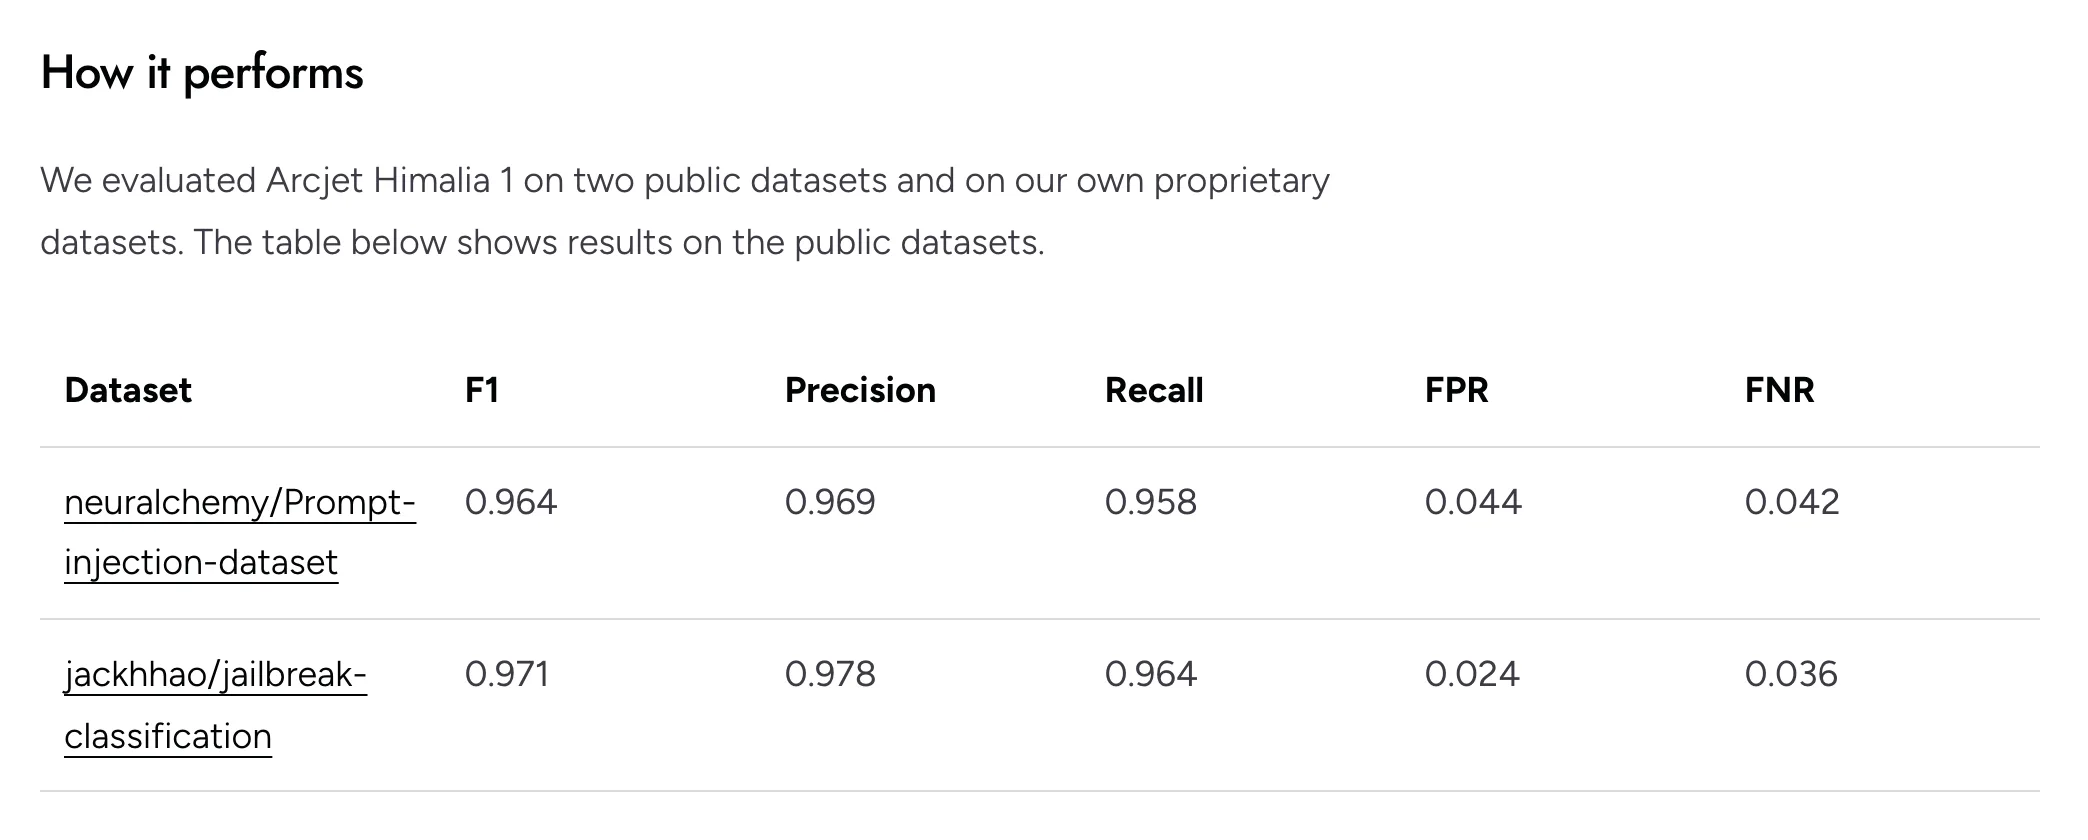
這張表能推到的邊界,官方自己先講了:公開資料集互相重疊、看過題目再考的問題,同樣存在於整個評測生態。所以它證明的是在這兩個集合上能區分多數樣本,不是任何公司的真實流量都有 0.97 的保護率。評估資料裡正常與攻擊文字的比例,也可能與正式服務不同。
編碼與變形攻擊則走另一條路。評估套件會把測試提示做 base64、ROT13、hex、leetspeak、反轉文字、假分隔符與假聊天格式 token 等變形,並按攻擊類別與資料集分開報分,避免弱點躲在漂亮的平均後面。正式服務裡先跑確定性解碼器,認出編碼文字與已知結構性攻擊模式就直接拒絕,解碼後的明文連同原文一起送進模型,編碼攻擊會以它實際說了什麼被評斷。
介面上有個會影響整合方式的決定:偵測結果只回裁決,不回信心分數。官方給的理由有兩個。分數會給攻擊者回饋,讓他反覆調整文字直到低於門檻;而如果應用端自己設了門檻,模型每次重訓後分數分布移動,門檻的效果會悄悄改變。內部當然仍有機率與門檻,只是不對外露出,模型更新時應用端不需要跟著調整。
官方偵測文件把使用方式定得很硬:模式只有 LIVE 與 DRY_RUN 兩種,LIVE 阻擋偵測結果,DRY_RUN 只記錄不攔。官方建議的路徑是先用 DRY_RUN 在自己的產品上量誤擋率,再切換 LIVE。Python SDK 甚至把 mode 設為必填,省略或試圖傳入 threshold 都會直接收到 TypeError,等於在介面層禁止自訂門檻。判斷結果本身是布林值:JavaScript 端看 decision.reason.isPromptInjection(),Python 端看 reason_v2 型別是否為 PROMPT_INJECTION,應用端拿到「有或沒有」的布林結果,程度資訊不對外露出。
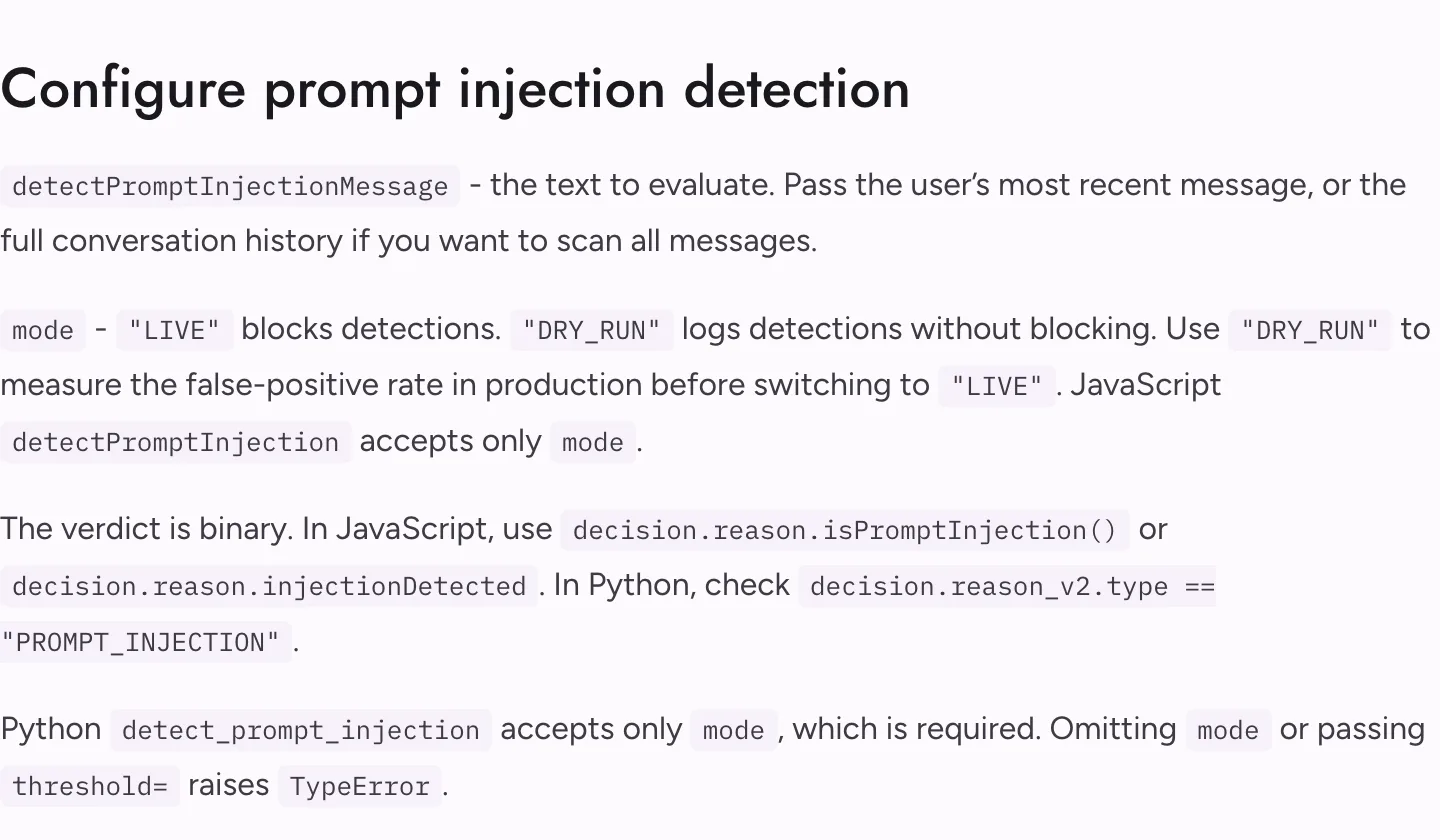
範例程式裡另一個值得抄的細節是錯誤處理:偵測服務出錯時,範例直接回 503 擋下請求,請求不會再往模型送。判斷有攻擊與服務故障是兩種狀態,混在一起會讓故障時的流量靜默失去保護。另外範例對超過 128 KiB 的文字一併拒絕,超長輸入本來就不適合進偵測流程。
這份公告留下幾個待觀察點。Thebe 1 與 Carme 1 只有早期申請,效果數字、計價方式與正式釋出時程都未公布;公告裡那張效能表只屬於 Himalia 1,不能平移到專用版。基於 ShieldGemma 的內容審核模型已完成微調,但官方只說即將公告。真實流量的保護率,以及與大型模型的對照表現,同樣沒有公布任何數字。
這些資訊的時效邊界也明確:一旦 Thebe 或 Carme 轉為正式開放,或 ShieldGemma 內容審核模型公告,「今天上線的只有通用版」這個核心事實就會過時。回查入口是 Arcjet 的 changelog 與部落格。
已經在用 Arcjet 提示注入偵測的團隊,什麼都不必做:後端已經換上 Himalia 1,值得做的是把 DRY_RUN 或決策記錄打開,比對誤擋與漏接有沒有變化。在做客服或聊天應用、正在挑防護方案的團隊,可以先用免費試用接入,但別急著切 LIVE:先用自己的合法流量量出誤擋率,被攔下的使用者也要有重新表達的出口,這兩件事比攔截率數字更影響體驗。
程式代理與資安代理的團隊是另一回事:今天拿到的仍是通用模型的行為,專用版要登記早期申請,官方也明說想看真實工作負載裡的誤擋案例。無論哪種場景,都別因為掛了偵測器就放寬工具權限:偵測器判斷文字,權限限制代理實際能做什麼,兩道控制互不替代。這套分層與 Google 近期提出的代理安全框架是同一個方向,能力分級、權限限縮與監督各自守一層;而在「誰在呼叫」這一層,把代理身分連回授權者的做法也與內容檢查互補。想知道自家代理實際做了什麼,對代理行為做獨立稽核的工具則提供了第三種視角,三件事加起來才構成完整的可觀測性。官方文件也把這個位置畫得很清楚:Shield 擋常見 Web 攻擊、提示注入偵測在推論前攔截惡意指示、機敏資訊偵測避免個資進入模型上下文,各守一層,組合使用才是文件建議的接法。提示注入偵測是其中一塊拚圖,把它當成唯一的鎖,反而是這次公告最想糾正的用法。