TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA 開源 1 億參數說話者分段模型 Nemotron 3 Diarization,最多標記 8 位說話者、支援重疊發言與串流處理,在 VoiceArena 第三方排行榜以 14.72% DER 排第一。本文對照官方模型卡與技術文章,整理與前代 4 人模型的差異、中文場景的官方成績與自架部署條件。
用 AI 摘要這篇文章:
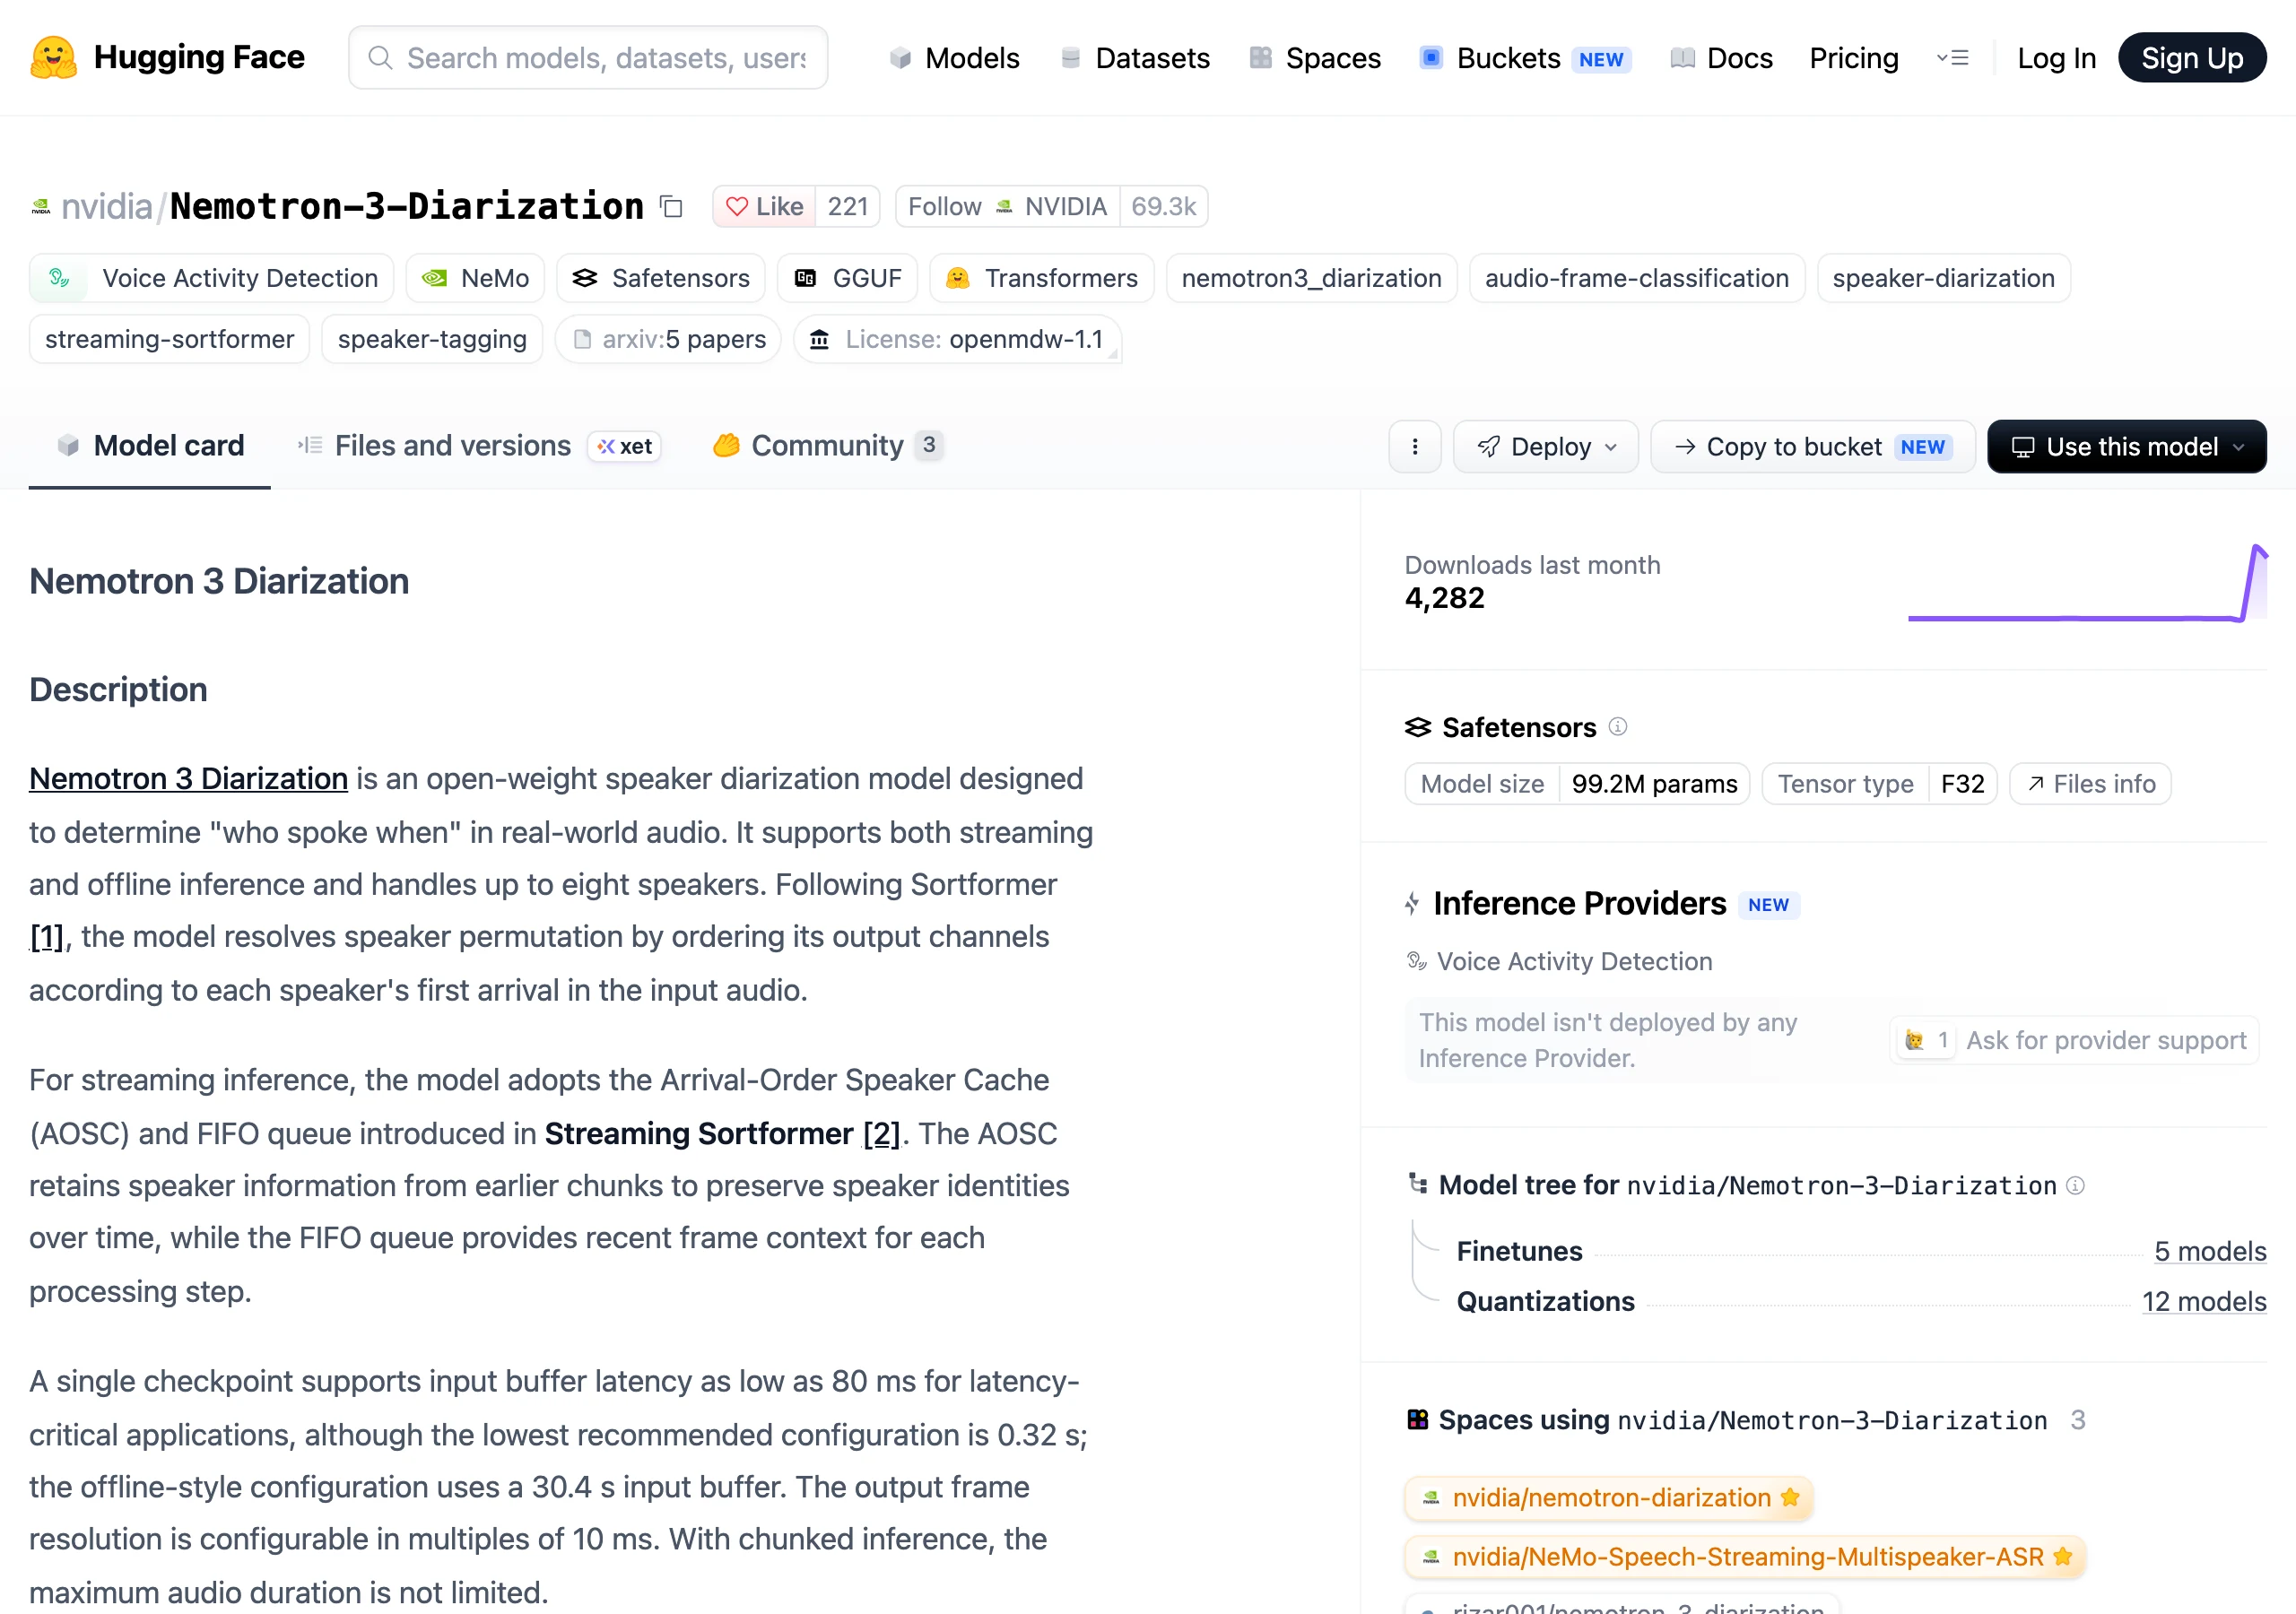
NVIDIA 在 2026 年 9 月 23 日公開開放權重(open-weight)說話者分段模型 Nemotron 3 Diarization,權重直接上架 Hugging Face,採 OpenMDW-1.1 授權,商業與非商業用途都放行。模型只有 1 億(100M)參數,卻把兩件事推到位:最多同時標記 8 位說話者,而且多人搶話重疊發言時,同一個時間點可以有多個聲道同時被判成活躍。在第三方評測 VoiceArena 的 Diarization-Bench 初版排行榜上,它以 14.72% 的說話者分段錯誤率(DER)排在 12 個系統的第一位,比第二名低約四分之一。
這是繼同一天 Google 發布Gemini 3.8 Flash TTS 語音模型之後,這週語音 AI 的另一波密集更新。以下內容對照 9 月 24 日查閱的 NVIDIA 官方技術文章、Hugging Face 模型卡、OpenMDW 授權條款與 VoiceArena 排行榜頁面整理。
說話者分段(speaker diarization)做的事,是把一段音訊切成不同人的發言區段,標上起訖時間與匿名標籤,例如 speaker_0、speaker_1。它處理的是「誰在什麼時候出聲」,與語音辨識(ASR)分工明確:ASR 把聲音轉成文字,diarization 給每段文字掛上說話者,兩者合併才會得到「誰說了什麼」的會議逐字稿。NVIDIA 在官方技術文章裡把這層關係講得很白:逐字稿每個字都聽對了,看不出是誰講的,行動項目與承諾照樣會記到別人頭上。
模型的輸入輸出規格從模型卡可以直接核對。輸入是 16kHz 單聲道音訊,wav、flac、opus、mp3 都收;輸出是一個 [T, 8] 的浮點張量,T 是時間格數,8 是聲道數,每一格記錄對應說話者當下的活動機率,預設每 10 毫秒輸出一格,也能改成 10 毫秒的任意倍數。兩個人同時開口時,同一格會有兩個聲道同時活躍,這是重疊發言能被標出來的原因。說話者聲道的順序按照「誰先出聲誰排前面」排列,所以同一個人的標籤在整段錄音裡保持穩定。
兩個常見誤解先畫出界線。它不會把 speaker_0 對應到真實姓名,要對應到人得靠會議名單、登入資訊,或另行使用聲紋驗證模型;它也不會自己產生文字,想拿到帶人名的逐字稿,還要接一套 ASR,官方示範的組合是與 Parakeet TDT 0.6B v3 這類能給出字詞時間戳的模型對齊,與 TechMoon 先前介紹過的開源 Parakeet 語音辨識是同一條路線。
串流模式最難的是記憶。離線處理時模型能一次看完整段錄音;串流時每次只拿到一小塊新音訊,缺乏有效的記憶機制,同一個人在前後兩個區塊可能被換到不同聲道。Nemotron 3 的解法承襲自 Streaming Sortformer:按「先出聲先編號」固定聲道順序,用一個到達順序說話者快取(Arrival-Order Speaker Cache, AOSC)保存先前區塊裡各聲道的資訊,再用一個 FIFO 佇列供給每一步最近的音框上下文,輔以緊接在當前區塊之後的右上下文音訊。四個官方延遲檔位,本質上就是這幾個參數的不同組合,同一份模型檔案切換檔位不用重新訓練。
NVIDIA 這次給的對照組是自家前一代最多 4 位說話者的串流模型 diar_streaming_sortformer_4spk-v2.1。模型卡列了八個評測集的完整對照,拿幾個代表性數字看方向(1.04 秒延遲檔位、全資料集 DER,越低越好):
| 評測集 | 前代 Sortformer 4spk v2.1 | Nemotron 3 Diarization | 相對改善 |
|---|---|---|---|
| DIHARD III(多領域) | 19.60% | 13.18% | 32.8% |
| CALLHOME-Part2(電話通話) | 11.31% | 10.29% | 9.0% |
| AliMeeting Test Far(中文遠場會議) | 15.58% | 10.80% | 30.7% |
| NOTSOFAR1 MHM(多麥克風會議) | 22.12% | 7.70% | 65.2% |
| NOTSOFAR1 SC(單麥克風會議) | 31.81% | 12.77% | 59.9% |
三個讀法。官方文章給的「平均 41% 相對改善」有明確口徑:八個評測條件各自的相對改善幅度(9.0% 到 65.2%)取未加權平均,不是把所有錄音合併算出的一個總分,引用時不要簡化成「錯誤率砍六成」。它並非全面碾壓,CALLHOME 的兩人通話子集在 30.4 秒檔位下,前代的 5.68% 其實低於新模型的 5.98%;改善主要發生在更多人、更難的聲學條件,如果你手上只有兩人通話且前代已經夠用,沒有立刻搬家的理由。吞吐量的提升比準確度更戲劇化:同樣 30.4 秒檔位、批次 32、開啟 torch.compile 的條件下,RTFx 從 2,619 升到 15,113(測試硬體為 RTX PRO 5000、BF16 精度),等於同樣的 GPU 時間能處理約 5.8 倍的音訊量,對要批次消化大量歷史錄音的團隊是直接的成本數字。
訓練側還有一個 NVIDIA 自報的數字值得記下:加入 David AI 的授權對話資料後,複合 DER 從 11.19% 降到 10.42%(0.77 個絕對百分點),代表這波成績有一部分是花錢買資料買來的,之後別家若用更大的授權語料追上,不必意外。
VoiceArena 這個榜本身值得認識。初版 Diarization-Bench 拿 139 段英文對話、共計 1,317.9 分鐘(約 22 小時)測 12 個系統、17 種設定,重疊發言計分、不給邊界容差(collar 0ms)。從排行榜頁面直接讀下來的結構是:第一名 NVIDIA Nemotron 3 Diarization 14.72%;第二名 BUT FIT 的 DiariZen WavLM Large 19.34%;三、四名是 pyannoteAI 的 Precision-3(20.56%)與 Precision-2(23.41%);NVIDIA 自家前代 Streaming Sortformer 4spk v2 排第五(24.61%)。榜上前五名有三個標示為開源系統:NVIDIA 的兩代模型,加上 BUT FIT 的 DiariZen。
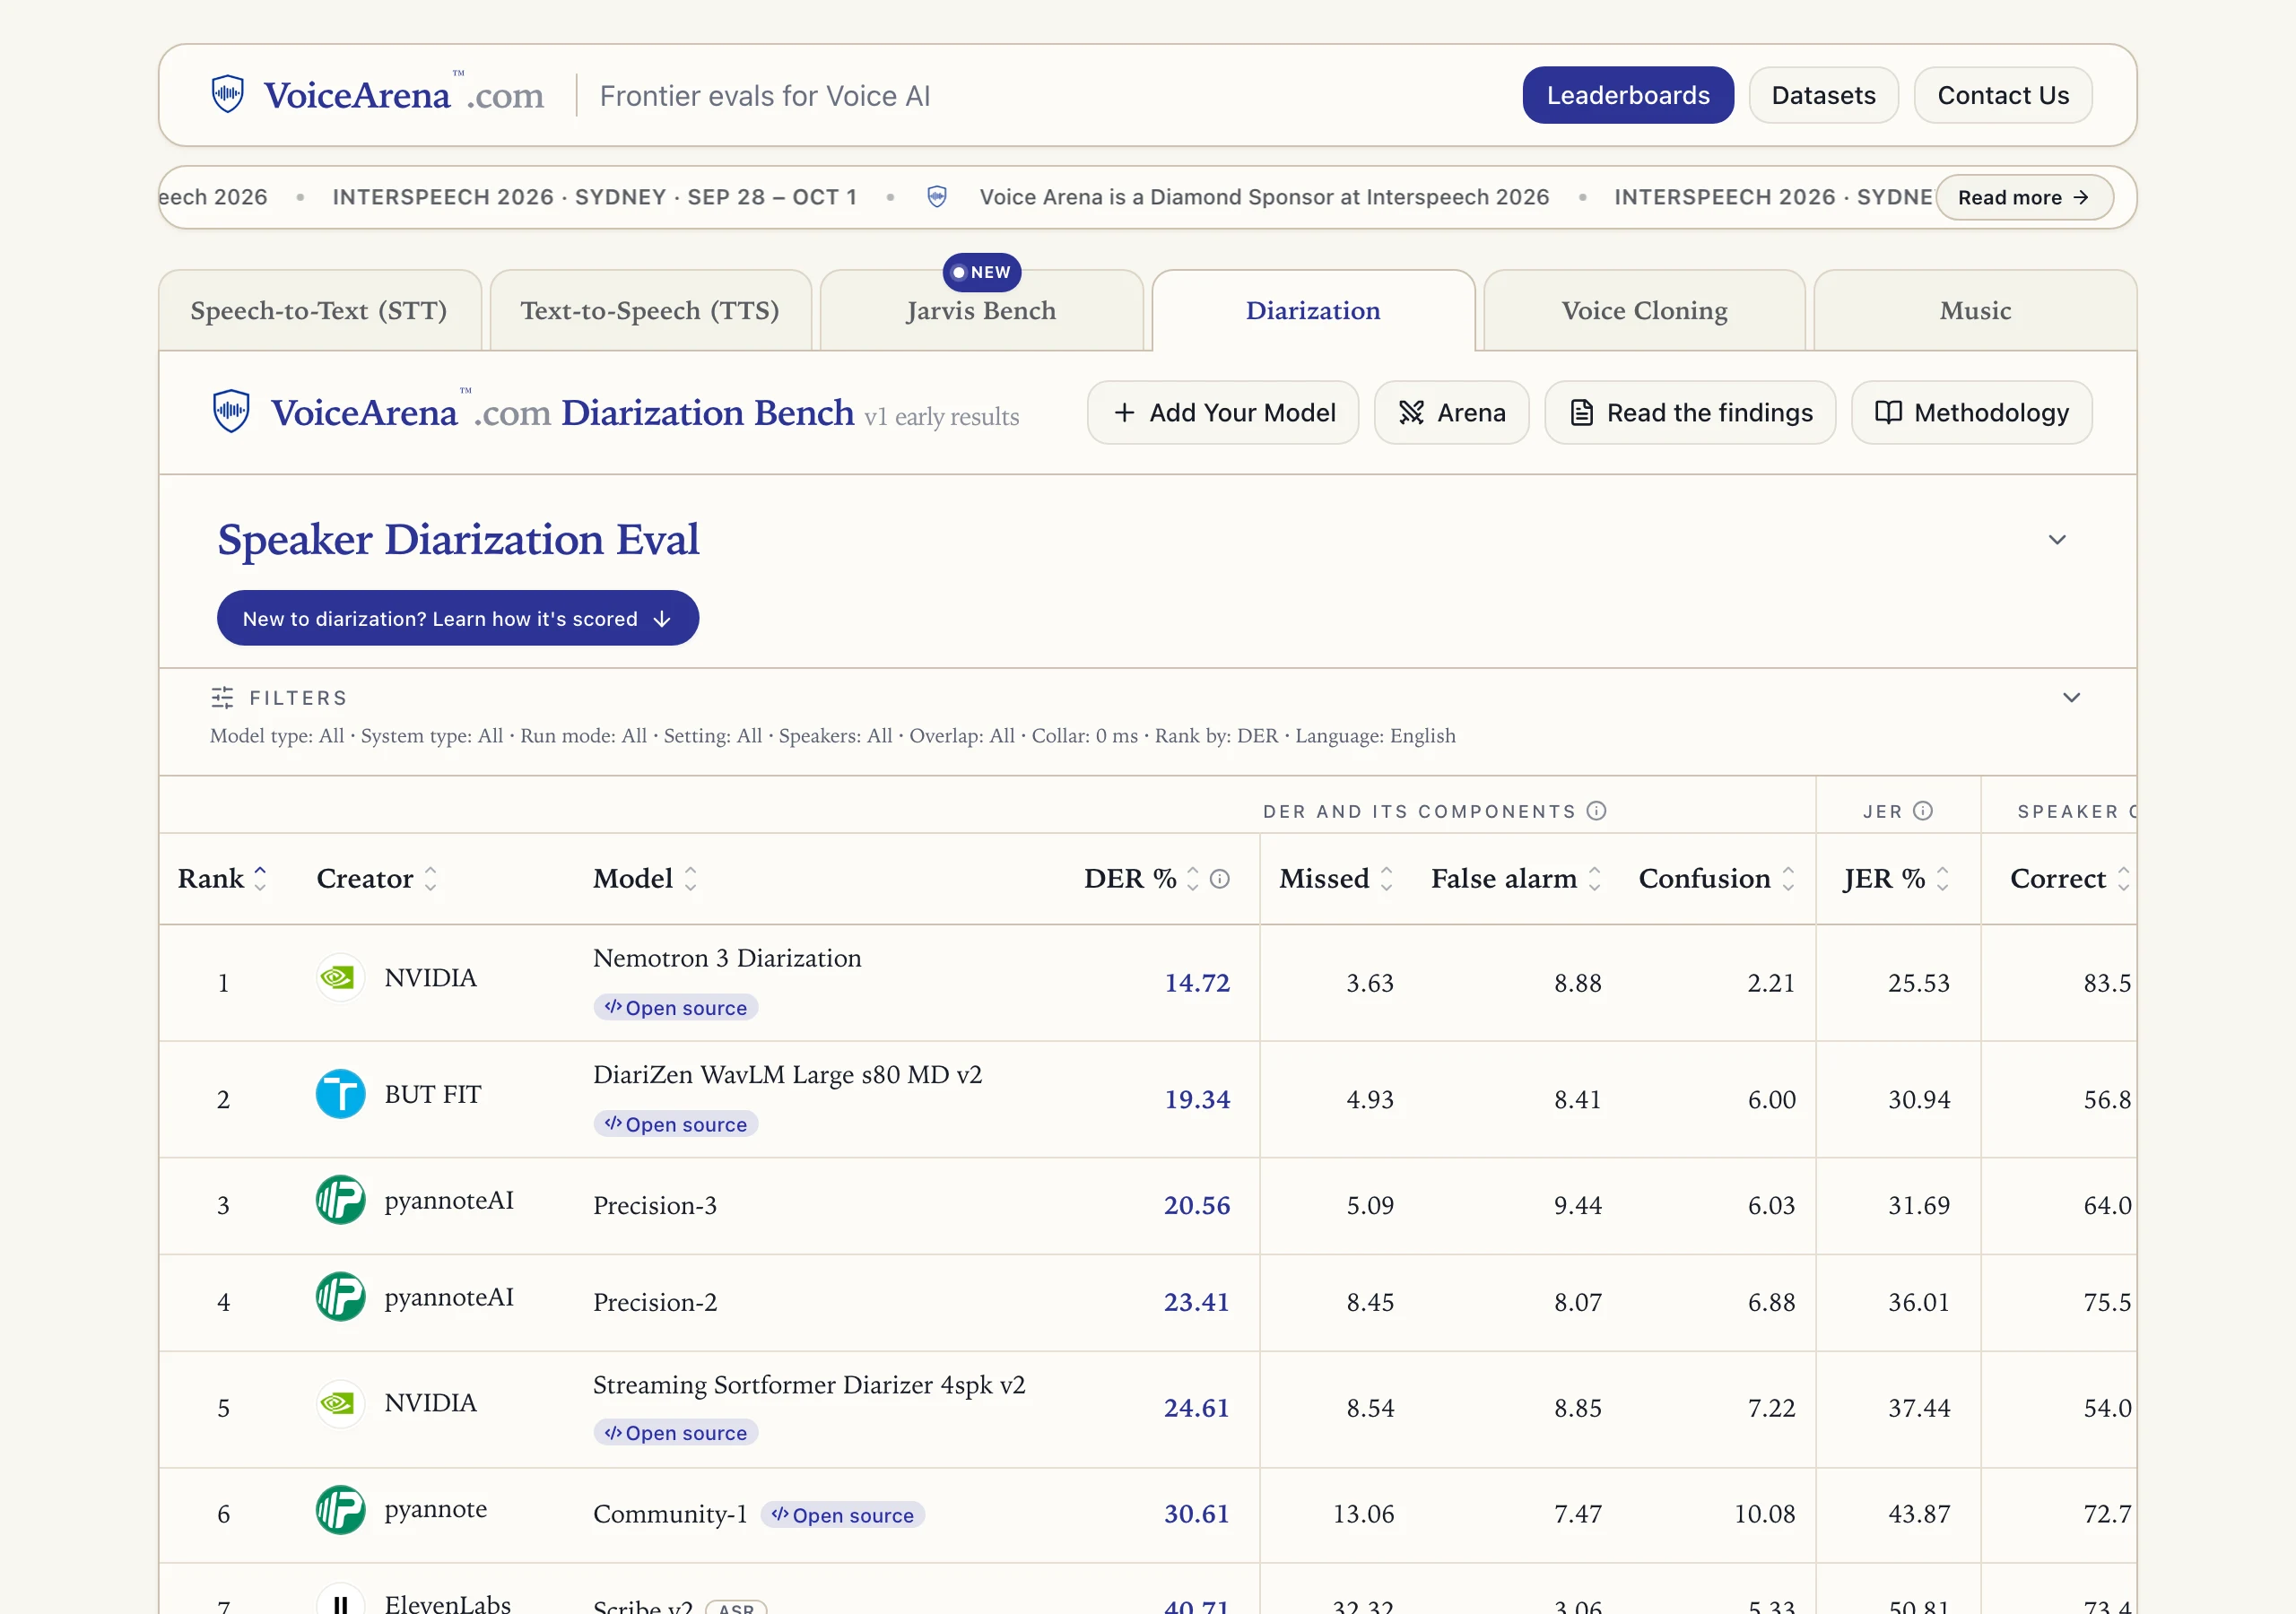
更有意思的斷層在後半段。六家商業 ASR 產品的轉錄管線被拿來測說話者分段,成績全部落在 40% 之後:ElevenLabs Scribe v2 40.71%、Meta Muse Voice Transcribe 42.06%、AssemblyAI Universal-3.5 Pro 44.64%、Soniox v5 Async 49.78%、Speechmatics Enhanced 53.30%、Deepgram Nova-3 67.13%。它們的轉錄文字能力本來就不在這個榜的評分範圍;真正的訊息是「ASR 順便附贈的說話者標記」與「專用分段模型」之間有成倍的落差。如果你的產品依賴轉錄 API 附帶的說話者資訊做歸責或分析,這個差距就是自架一套 diarization 的動機。
再往欄位裡看一層,Nemotron 3 的錯誤結構有個特徵:它的 DER 分解是漏失(missed)3.63%、誤報(false alarm)8.88%、說話者混淆(confusion)2.21%,其中混淆是全榜最低;商用轉錄 API 裡混淆最低的 Meta Muse 也有 3.29%(整體 DER 被漏失拖到 42.06%),開源對手 DiariZen 則是 6.00%。同一頁還列了換一種算法的 JER 錯誤率 25.53%,與說話者人數完全判對的比例 83.5%。換句話說,它的錯誤集中在「把不是說話的聲音判成有人講話」,而不是「把話算到錯的人頭上」。對於承諾歸屬、客訴處理這種認錯人代價高的場景,這是利多的錯誤分布;但會議室雜音、鍵盤聲多的環境,誤報偏高的特性就要實測再說。
還有一條出處免責要原樣交代:這個榜目前標示為 early results,VoiceArena 的 Version 1 完整評估與配對統計分析還沒完成,結果可能變動。引用榜首成績時,把這句一起帶上。
台灣讀者最該問的問題是它對中文準不準。模型卡給的答案分兩層。訓練資料裡有普通話語料:AISHELL-4 用於訓練,AliMeeting 同時出現在訓練與評測,全部真實對話約 10,000 小時,另外用 FastMSS 工具模擬了 82,611 小時的多人混合音訊,混合素材除英語語料庫外還包含 21 種語言的授權逐字稿。評測方面,AliMeeting Test Near(混合麥克風)在 30.4 秒檔位 DER 為 6.40%、Test Far(遠場)10.47%,對前代的 11.57% 與 13.69% 都是明確進步。
限制也一樣明確:AliMeeting 是簡體普通話的會議語料,VoiceArena 榜上 139 段對話全是英文。台灣口音、台語、中英夾雜的辦公室對話,目前沒有任何一張官方表格覆蓋。模型卡自己給的建議就是正確做法:用官方的 e2e_diarize_speech.py 評測腳本,拿自己的會議、電話錄音跑一輪,得出來的數字才是你的數字。重現時條件要對齊:官方評測裡 DIHARD III、AliMeeting、AMI、NOTSOFAR1 都是零容差(collar 0 秒),只有 CALLHOME 用 0.25 秒容差,而且每個評測集用的是哪一版參考標註,模型卡有明確交代,換一套參考標註成績就不可比較。這一步不需要訓練,只要推理。
它不是貼一個 API key 就能用的服務。Hugging Face 頁面上沒有代管推理 API,只有一個 Spaces 互動 demo 可以試聽;要進產品,就得自己跑模型。部署條件寫得很死:Linux 作業系統,NVIDIA GPU 從 Ampere 架構起算,GeForce RTX 3050 這級的消費卡到 B300、DGX 系列都在支援清單上,入門門檻不算高,但 macOS 與 Windows 原生環境不在列。
同一個模型檔案支援四種官方建議的延遲檔位,差別在送進模型的音訊緩衝長度:
| 檔位 | 輸入緩衝延遲 | 適合 |
|---|---|---|
| 離線處理 | 30.4 秒 | 事後處理錄音,準確度與吞吐最高 |
| 低延遲 | 1.04 秒 | 即時字幕、直播場景的預設起點 |
| 極低延遲 | 0.64 秒 | 對延遲更敏感的即時應用 |
| 超低延遲 | 0.32 秒 | 官方建議的最低檔 |
要注意「輸入緩衝延遲」指的是模型開始處理前需要先累積的音訊長度,運算、網路傳輸、ASR 與畫面更新的時間都要另外加。官方文章也明說,模型技術上可以壓到 80 毫秒緩衝,但 0.32 秒是最低的建議配置,再往下壓,準確度與吞吐都會付出代價,延遲檔位要對著端到端產品需求選,不是單看緩衝數字。
入門路徑有三條。要走 Python 生態,裝 NeMo Framework v3.0 的 nemo-toolkit,或用 Hugging Face Transformers(目前需要從 GitHub 原始碼安裝);想要最輕量的本地執行,NVIDIA 另外開源了 NeMo-Speech.cpp,裝好後一行指令 nemo-speech diarize meeting.wav 就能對錄音分段,也能加 --diarize 參數把說話者標籤直接標到逐字稿的字詞上。不想自己管機器,官方文章的資源清單點名了 Baseten 與 Digital Ocean 兩個雲端代管路線;要走裝置端整合,Argmax 的 Pro SDK 3 已宣布支援這個模型做即時分段,該公司自稱在其 OpenBench 的六系統、十一資料集測試中拿到最低 DER,這是 Argmax 的宣稱,引用時注意歸屬。
授權條款值得單獨看一眼。OpenMDW-1.1 是 Linux Foundation 體系下的開放模型授權:免費、不限制使用方式,版權、專利、資料庫與營業秘密權利一併授予,用模型產生的輸出完全不受條款約束。義務集中在散布行為:把模型或其一部分再發布出去時,要附上授權條款副本與原有的版權及來源標示。另有一條專利訴訟條款,主動對任何人發起主張模型侵權的訴訟,授權即終止,被先告之後再反訴的不在此限。對自用與產品整合的多數場景,它比常見的軟體開源授權更直白,義務面只剩散布時的標示與這一條訴訟紅線。
模型卡列的失能條件要照單全收:超過 8 人就會漏失發言或把人標錯頻道,而 DIHARD III 評測裡 5 到 9 人的聚合成績其實包含了 9 人音檔,超出模型上限,那一格數字要保守解讀;噪音大、殘響重、收音遠、會議超長或使用情境與訓練資料落差大的環境,錯誤率都會上升。記者會、法說會這種動輒十人以上的場面,現在還不是它的舞台。另外,說話者標籤是模型判斷,不是身分驗證,官方建議在監管、安全相關或後果重大的流程裡,保留不確定性、別把每個標籤當成不會錯的判斷,並在代表性音訊上評測完整系統,而不是把機器標籤當成已證實的事實。
誰該現在動手?手上有多人會議錄音、客服對話、播客後製需要標人的團隊,這是一個授權乾淨(OpenMDW-1.1 免費、不限用途、模型輸出無使用限制,散布模型本身才需要附授權副本與來源標示)、入門硬體門檻低、錯誤結構偏向不認錯人的基礎元件,值得花一小時拿自己的錄音驗證一輪。只在兩人通話情境使用、且現有方案已達標的,等更多人的實測再說。與先前介紹過的Qwen3.8-LiveTranslate 同傳模型對照著看,兩者都在補「分得清誰在說話」這一層,差別在 Qwen 把辨識與翻譯包在一起,NVIDIA 把分段單獨拆成可自架的元件,想自己組裝逐字稿管線的團隊,後者的彈性大得多。
時效上有一個明確的重看節點:VoiceArena 完成 Version 1 統計分析後,榜首與名次可能變動,屆時這篇引用的 14.72% 與榜單排序都值得重新核對一次。模型本身後續若有版本更新,以 Hugging Face 模型卡為準。