TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Hugging Face 與五所美國大學 10 月 29 日宣布開放科學倡議 Project ProtoStar,首場由卡內基美隆主辦的氣候挑戰正在進行,台北時間 11 月 14 日中午截止。這場比賽的預測分數只餵進六項評審準則中的兩項,宣告負結果的重現失敗也照樣計分;官方公告與挑戰文件對預測終點各說各話,一邊寫 2026、一邊寫 2025。
用 AI 摘要這篇文章:
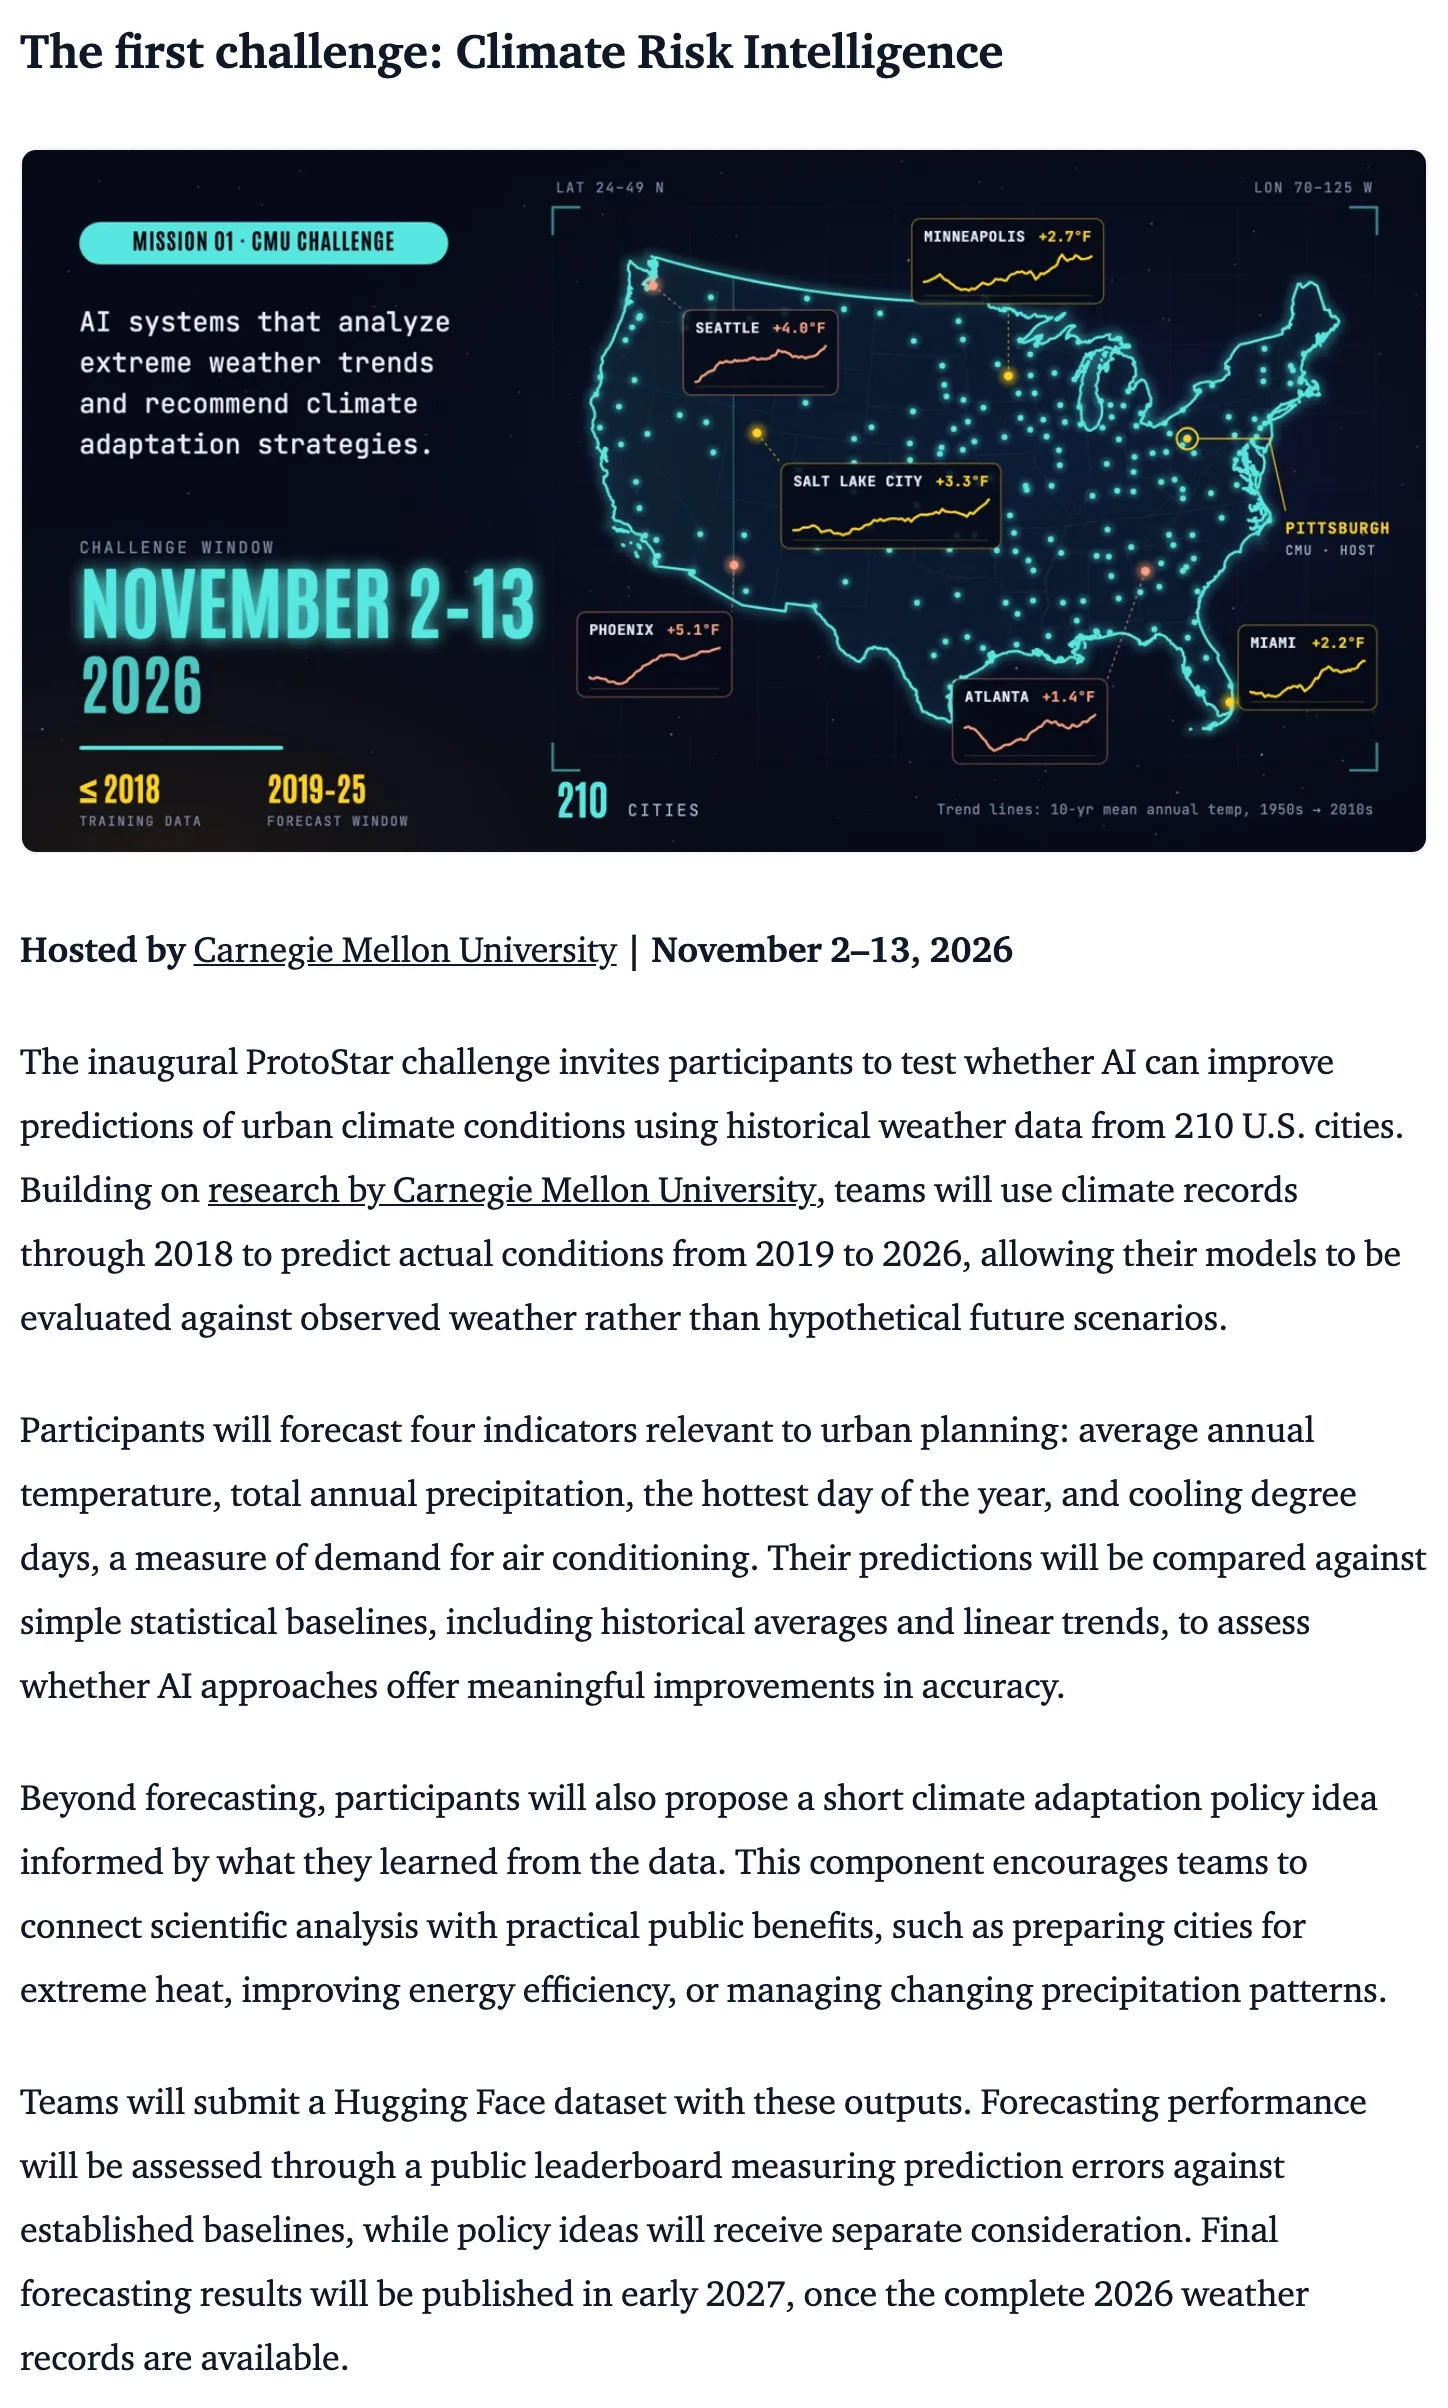
Hugging Face 在 10 月 29 日宣布開放科學倡議 Project ProtoStar,要把公開資助的研究成果整理成 AI 讀得懂、可追溯、可重用的形式。創始夥伴包括卡內基美隆、普渡、喬治亞理工、亞歷桑那州立與喬治華盛頓五所大學(經 Open Forum for AI 組成大學聯盟)、Astera Institute,以及負責社群連結的 Open Research Community Accelerator,Hugging Face 自己擔任基礎設施角色。首場公開挑戰由卡內基美隆主辦,主題是氣候風險,11 月 2 日開跑、11 月 13 日美東時間截止,等於台北時間 11 月 14 日中午 12 點 59 分收件,此刻正在進行中。
這場比賽最值得先看的,不是它又替 AI 找了一個新舞台,而是計分設計本身:預測準度只餵進六項評審準則當中的兩項,重現失敗可以宣告為負結果照樣計分,「哪裡卡住」的回饋是投稿必寫的段落。把權重攤開加總,與預測誤差直接相關的輸入只佔兩成,其餘八成在衡量重用、互通、可重現與生態回饋。換句話說,這場挑戰真正想收集的證據,是公開研究被別人拿來重用時會撞到的摩擦,預測氣候只是收集摩擦的引子。這條路上的規則細節,官方公告、挑戰平台的設定檔與專案頁各有各的說法,想參加的人可以把底下的整理當成規則導讀,不參加的人也可以看一個基礎設施公司怎麼把「開放科學」變成可量測的比賽。
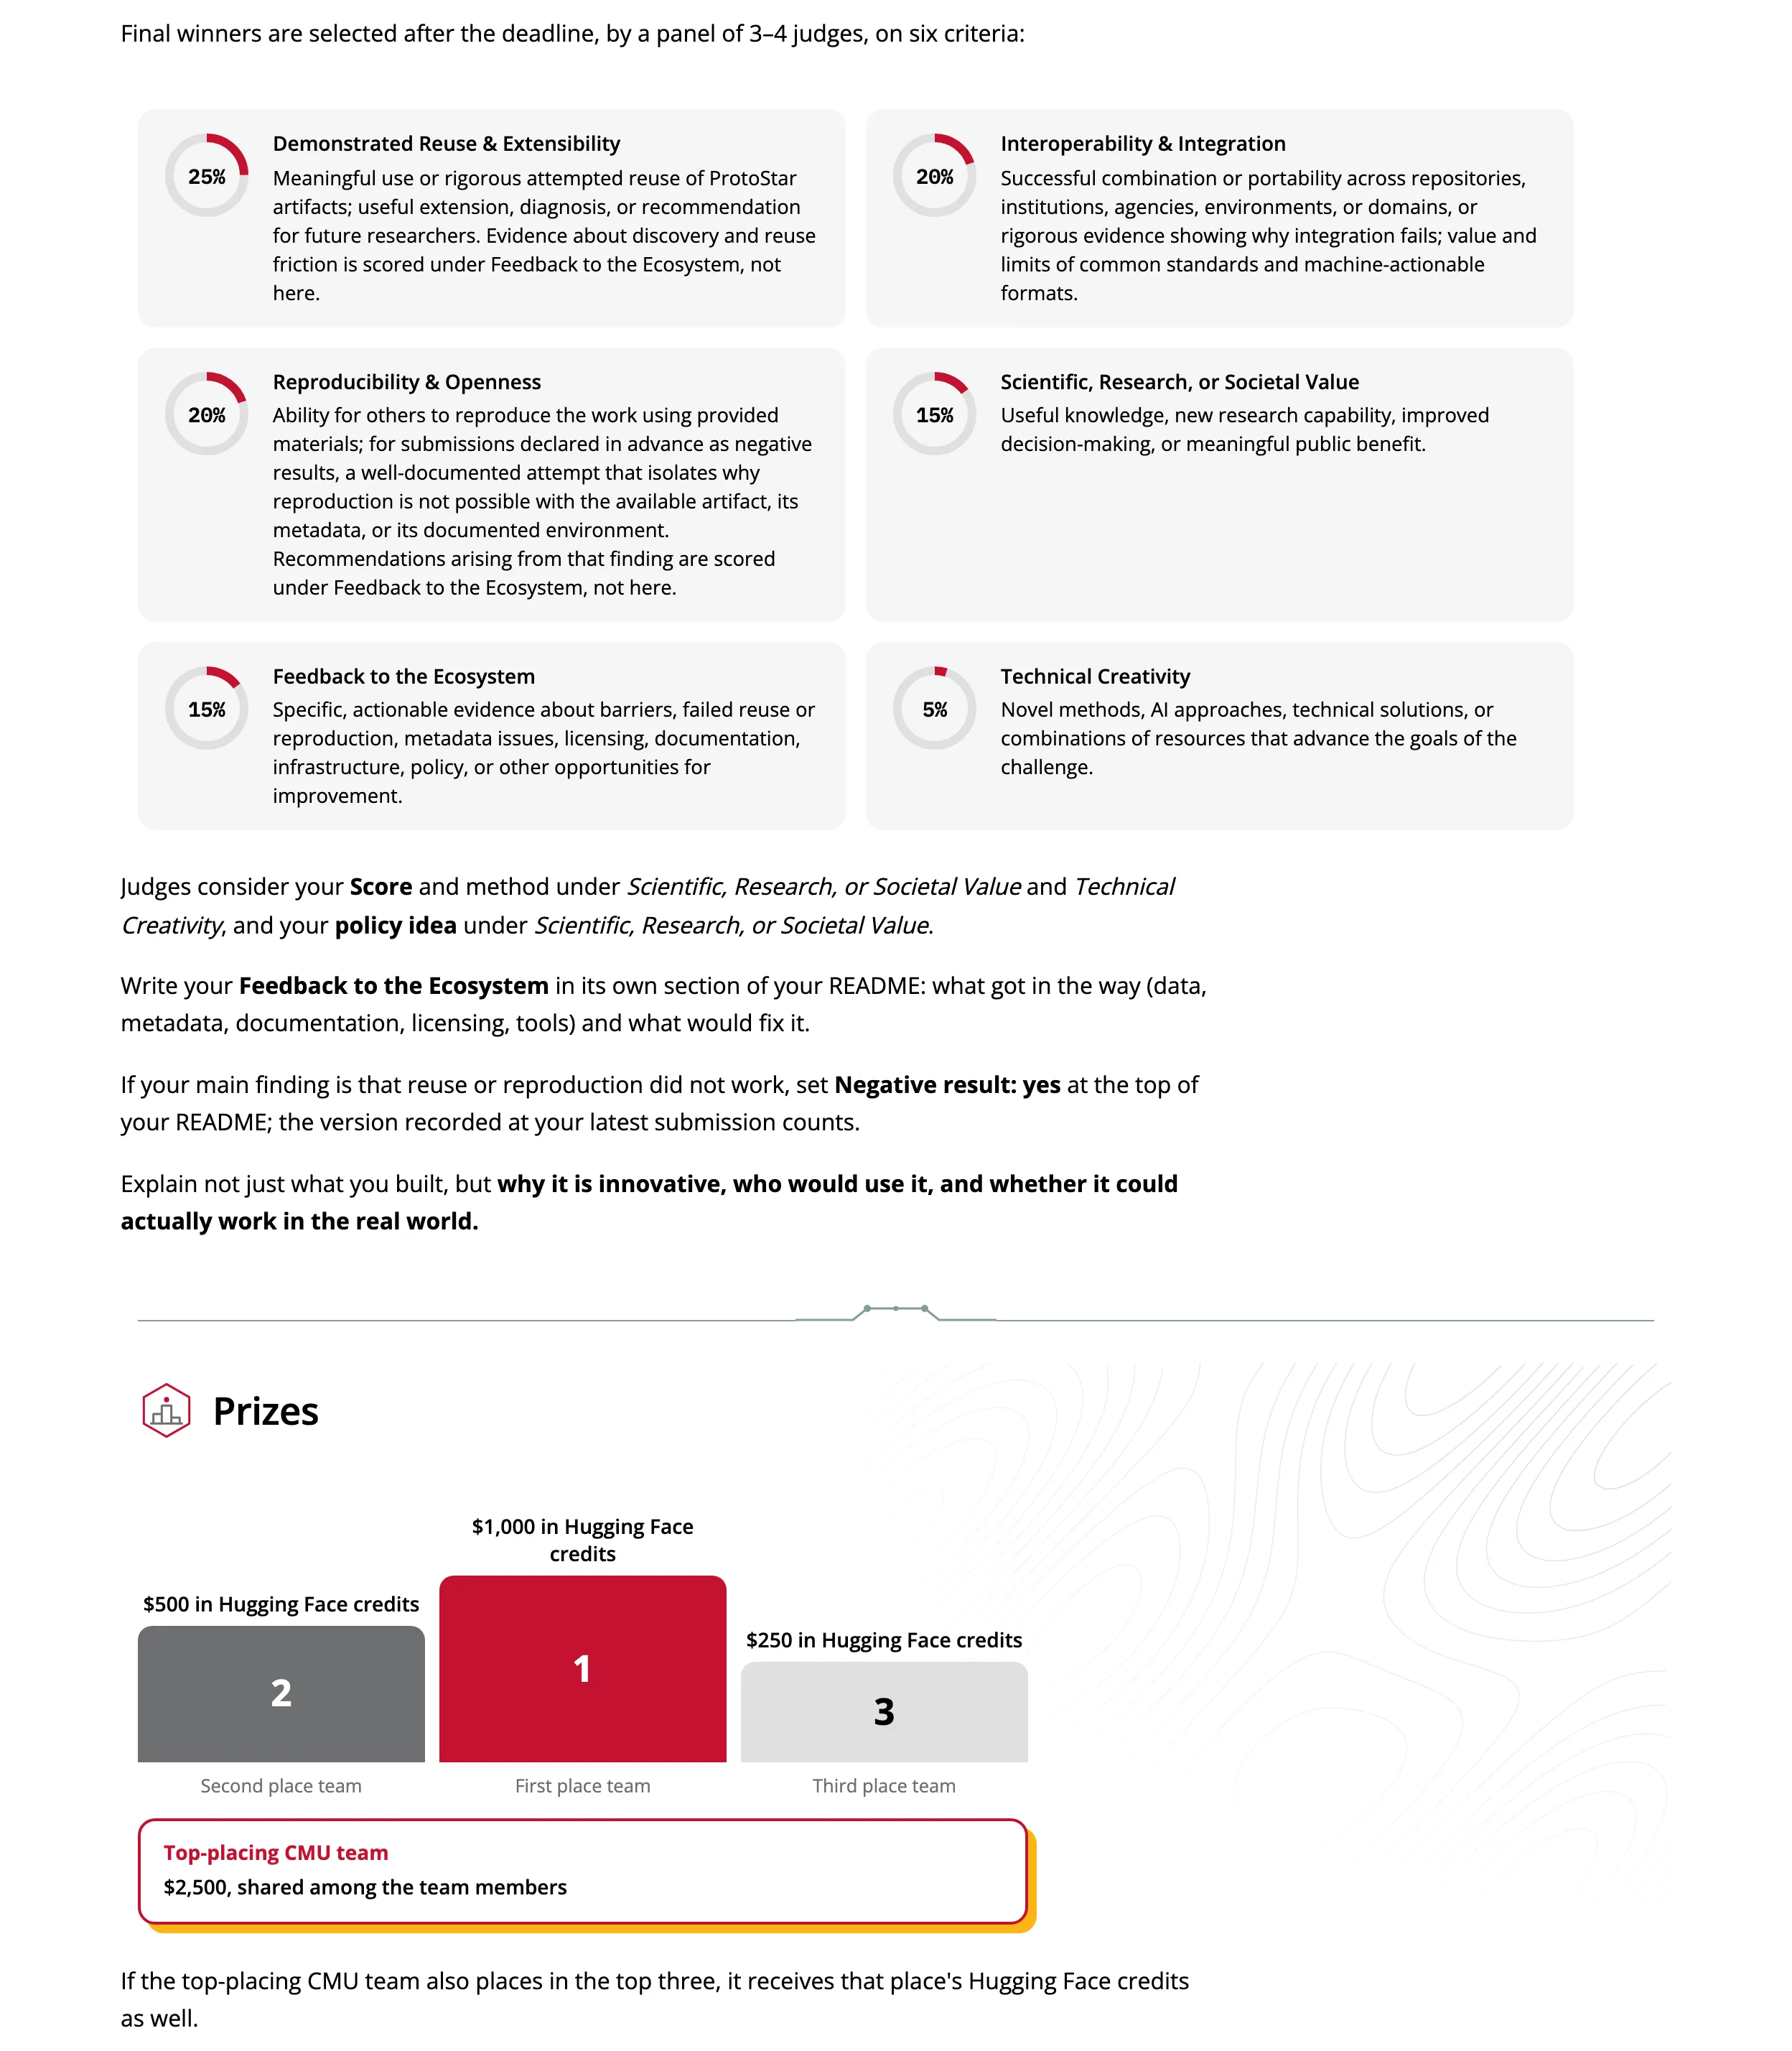
先講結論面的設計。預測成績會透過公開排行榜呈現,誤差越低名次越高,這部分沒有懸念;真正決定誰拿獎的是另一套機制。官方說明寫得明白:截止之後,由 3 至 4 位評審組成的小組依六項準則給分,加權後換算成 0 到 100 分,各評審平均決定名次。六項準則與權重如下。
| 評審準則 | 權重 | 官方要看什麼 |
|---|---|---|
| 重用與可擴展 | 25% | 是否實際用上或嚴謹嘗試重用 ProtoStar 資產,並對後續研究者有用 |
| 互通與整合 | 20% | 能否跨儲存庫、機構、領域組合資源,或嚴謹呈現整合為何失敗 |
| 可重現與開放 | 20% | 別人能否用你提供的材料重做;宣告負結果者,看失敗原因是否隔離清楚 |
| 科學與社會價值 | 15% | 產出哪些有用知識、新研究能力或公共效益 |
| 生態回饋 | 15% | 對資料、文件、授權、工具、基礎設施的具體障礙證據與改善建議 |
| 技術創意 | 5% | 方法、組合或解法的新穎程度 |
把這張表與預測分數的關係說清楚:官方在評審說明裡載明,預測分數與方法是放在「科學與社會價值」和「技術創意」兩項裡被納入考量,政策構想也歸在價值項。也就是說,排行榜上的名次是入場券與參考資料,不是得獎公式。前三名隊伍依序獲得 1,000、500、250 美元的 Hugging Face 點數,表現最好的卡內基美隆隊伍另外分享 2,500 美元,若同時擠進前三名,兩邊都能拿。
兩個設計細節會改變你對這場比賽的理解。其一,投稿 README 要在最上面宣告是否為負結果,如果你最主要的發現是「重用或重現根本做不起來」,官方照樣讓你參賽,評審會在看可重現性那一項時檢查你有沒有把失敗原因隔離清楚,相關建議則計入生態回饋;宣告以最後一次提交當下記錄的版本為準,事後改稿要重新提交才生效。其二,官方直接要求每隊在 README 寫一節「對生態系的回饋」:什麼東西卡住了,資料、詮釋資料、文件、授權還是工具,以及怎麼修。把這兩件事跟權重表放在一起,公告裡那句挑戰目標就有了著落:官方說這系列挑戰要「示範科學重用」並「找出讓重用成真的條件」,後者收集的正是摩擦證據。
公告也把這個倡議的核心問題寫成一句話:公開資助的資料集、模型與程式以 AI 可用的形式釋出後,能否被發現、重用、組合與延伸,進而加速科學發現與公共利益。首場挑戰就是這個問題的首場實測。
再看預測本身。參賽者要把自己放在 2018 年底的位置,替 210 座美國城市預測之後每一年的四個指標:年平均溫度(華氏)、年總降水量(英寸)、全年最熱那一天的高溫(華氏),以及冷房度日。冷房度日用一句話講:把全年每天的平均溫度減掉華氏 65 度,低於 65 度的日子不計,其餘逐日加總,得出這座城市一年需要多少「降溫量」,官方用它來估計冷氣需求。舉官方的例子:某天高溫 90 度、低溫 70 度,平均 80 度,這天就貢獻 15 度日。
計分用平均絕對誤差(MAE),四個指標單位不同,所以每項都跟同一個參考基準比:該城市 1989 至 2018 的三十年平均。公式是每一項先算「1 減去你的誤差除以三十年平均的誤差」,四項平均後乘上 100,下限是 0。這個設計的含意很直接:如果你的模型贏不了三十年平均,分數就是 0,做得再複雜也一樣。官方另把成績切成兩份:2019 至 2021 的即時成績讓你邊做邊看,2022 至 2025 的最終成績才是排名依據,兩者分開公布,理由寫得很白:針對前三年調出來的模型,不保證後面幾年也準。官方對「連三十年平均都贏不了」的診斷也不客氣:那多半代表模型過擬合了歷史雜訊,把隨機起伏當成了訊號。
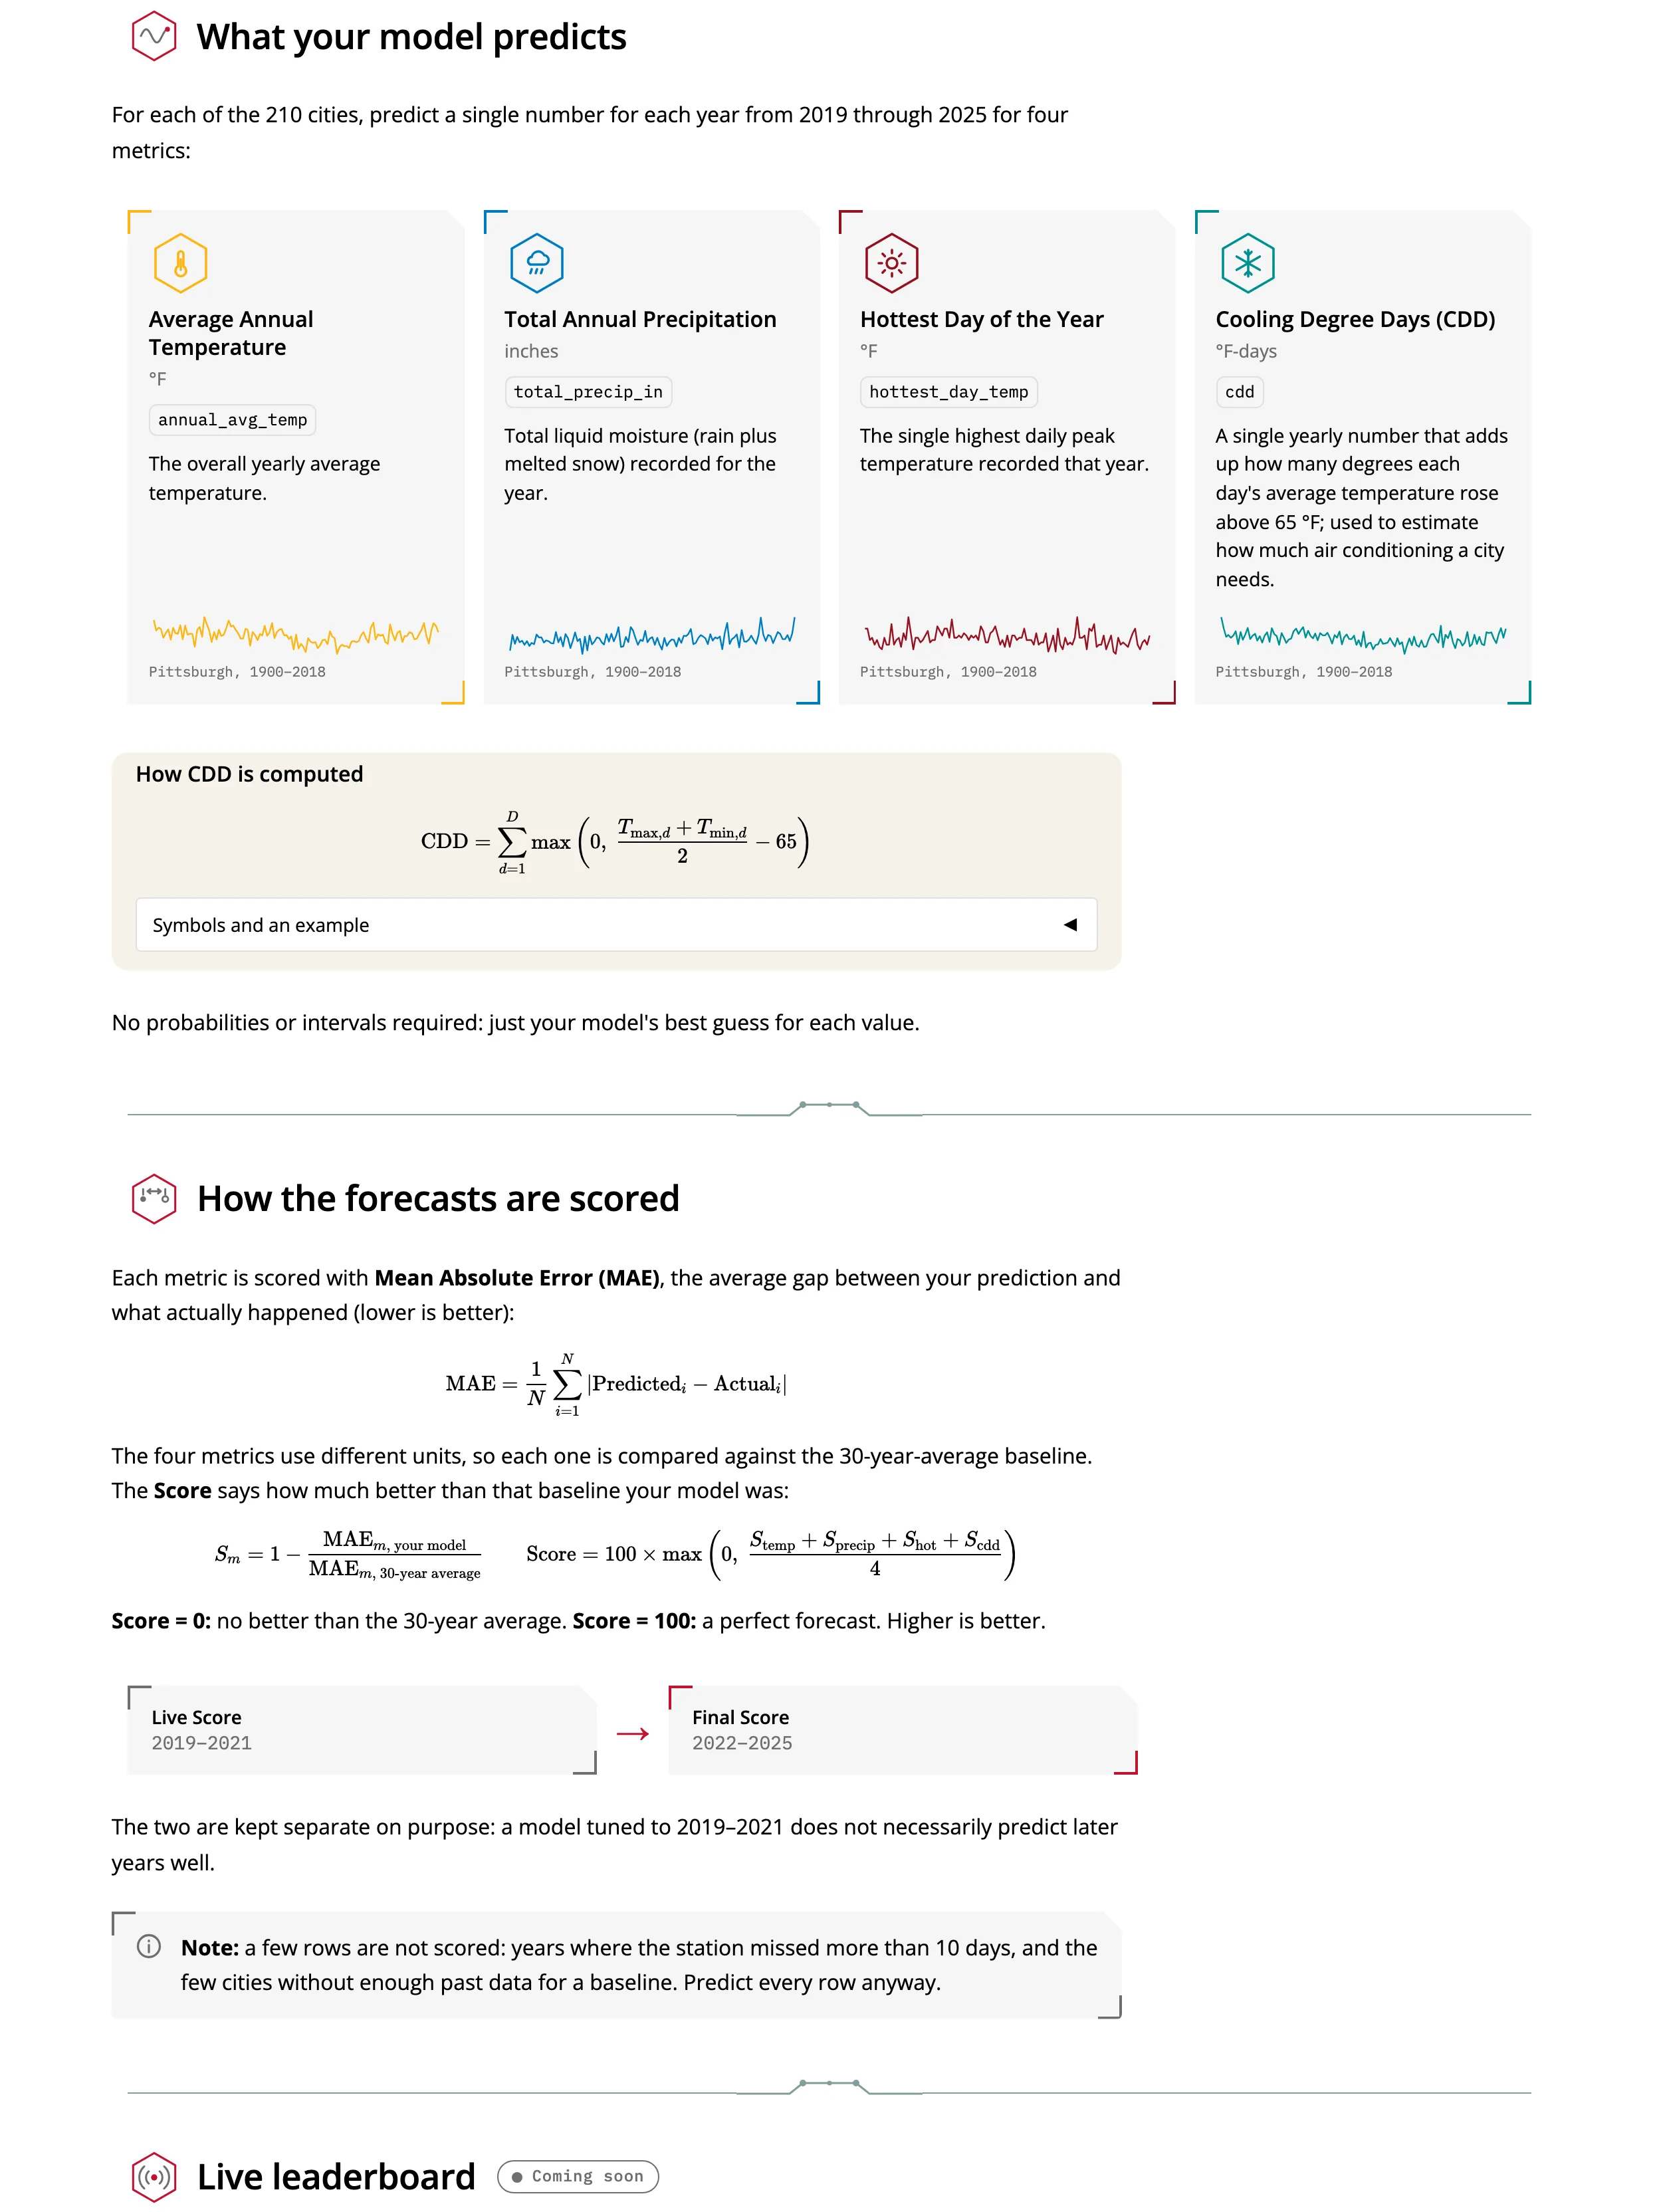
要打敗的參考解法有三個:把 2018 年的值一路重複、三十年平均、以及用最近三十年配一條直線延伸。官方的務實提示值得抄下來:最熱日與降水本質上很吵,貼著三十年平均就已經算合理,主要能拉開差距的是溫度與冷房度日。官方還公布了一次練習跑的數字:訓練資料切在 2010 年、預測 2011 至 2018 的話,三十年平均在冷房度日的誤差約 213 華氏度日,直線趨勢約 177 華氏度日,而 10 華氏度日以內的差距都算是年份之間的雜訊。少數測站缺漏超過 10 天的年份、以及歷史資料不足以算出基準的少數城市不列入計分,但投稿檔仍然要把每一列都填滿。
把誤差換算成分數再交給人評審,這種「機器分數只是材料之一」的結構,在近一年的 AI 評測裡越來越常見,原因也類似:單一分數會把能力與運氣壓進同一個數字。世界模型研究裡拿高分不等於懂環境的教訓,跟這裡把預測分數限縮在兩個準則內,是同一個方向的不同做法。
比賽用的資料集是 CMU-OSPO/protostar-climate-train-to-2018,授權 CC0,任何人不下載註冊也能直接取用。內容分三個子集:每日資料 10,245,754 列,涵蓋 1851 至 2018 年每座城市的每日高溫、低溫與降水;年度指標 28,052 列,是每城每年的平均、總量、極值與冷房度日;城市資訊 461 列,是測站編號、城市名稱、經緯度與合併測站的對應。這套資料的源頭是卡內基美隆 Lai 與 Dzombak 的歷史氣候研究,官方在文件裡附了資料論文與期刊論文的引用格式,要參賽者照著引用。資料集 10 月 27 日建立,到 11 月 3 日已有約 155 次下載。
規則的核心是一條榮譽制度:預測只能使用 2018 年 12 月 31 日以前的紀錄,而且不只是天氣資料。官方 FAQ 用一整張表說明什麼算「洩漏答案」:2019 年之後任何會回應當年天氣的資料都算,包括他們列的例子,棒球全壘打產量(熱空氣稀薄、球飛得遠)、河川流量(下雨幾天內變逕流)、臭氧超標日數、植物開花與展葉日期、西尼羅病毒病例數、空調用電與「冷氣維修」的搜尋量。人口普查、土地覆蓋、建物存量這類不隨當年天氣起舞的資料則可用於預測與分析。所有外部來源都要列在 README。這條線畫得比多數資料競賽更寬也更具體:它承認「答案」會從很多看似無關的社會資料裡漏出來。
交付方式是把官方模板複製到自己的 Hugging Face 帳號成為公開資料集:submission.csv 的 5,880 列(210 城市乘 7 年乘 4 指標)已預填城市、年份與指標,參賽者只填預測值;README 寫方法、政策構想與生態回饋;程式碼放 code 資料夾。提交時平台會檢查資料集公開、兩個必要檔案存在、5,880 列都有數字,然後記下當下的版本,之後改了內容就要重新提交,截止前可無限次更新,以最後一次有效提交為準。組隊用 Hugging Face 帳號,一個帳號對應一隊、一個電子郵件也只綁一隊,每隊至多 5 人,這個上限是 10 月 30 日才定案的。隊長創隊會拿到加入代碼,隊員憑隊名加代碼進隊;全員離隊時隊伍解散、提交不再列入計分,之後有人用同一個隊名重建,也是從零開始。政策構想另有格式:半頁以內,回答你注意到什麼風險、誰該做什麼、為什麼永續三個問題,對象可以是單一城市、一群城市或全國,官方給的靈感來源是美國環保署的都市熱島降低指南與 heat.gov。
參加之前有一個矛盾必須自己對齊。官方公告寫:「參賽隊伍使用 2018 年以前的氣候紀錄,預測 2019 至 2026 年的實際情況」,並說最終預測結果要等 2026 年完整氣候紀錄就緒後、於 2027 年初公布。可是實際驗收參賽作品的挑戰平台,任務說明寫的是預測 2019 至 2025 年,交付檔是 210 城市乘 7 年乘 4 指標共 5,880 列,即時成績算 2019 至 2021、最終成績算 2022 至 2025;專案頁的描述同樣寫 2019 至 2025。三份官方文件裡,只有公告把終點寫成 2026。
對實際參賽者來說,以挑戰平台的交付檔為準最保險,因為驗收與計分都跑在那份設定上;至於公告那邊為何多寫一年、2027 年初的時程句對應哪一套設計,兩份文件都沒有解釋,參賽前只能兩邊原文都讀。同樣值得留意的是一組尚未定案的細節:即時排行榜在平台設定裡仍是「即將開放」,官方說先提交的作品會保留、開放後一佨計分,成績出現最多需要 24 小時;每日提交上限目前未設、評審量表暫定 1 到 5 分、截止時刻暫定美東當天最後一分鐘、評審名單尚未公布。挑戰平台的程式碼從 10 月 26 日起一週內改了十幾輪,10 月 27 日把交付方式從 GitHub 加影片改成 Hugging Face 資料集,10 月 30 日定下隊伍上限,11 月 2 日開跑當天還在調整冷房度日的說明文字。文件會繼續動,報名前值得再看一次最新版。
公告給出的動機是一組平台自己的統計,讀的時候把「誰講的、量什麼」放在旁邊:核心科學領域的公開資料集超過 17,000 個,涵蓋基因體、蛋白質設計、化學、天氣與氣候、地球觀測與天文;納入醫學與數學後接近 29,000 個,科學模型的數量級相近。2026 年前九個月新增的科學資料集是 2025 年同期的三倍有餘,官方特別註明把最大單一上傳者拿掉之後成長仍然顯著。公告附的季度趨勢圖也有明確口徑:按建立日期統計、而且只算仍處於公開狀態的資料集,時間從 2023 年第一季畫到 2026 年第三季,量的是還活著的庫存變化,不是歷史累積總量。使用端,美國國家醫學圖書館 NCBI 維護的 18 個儲存庫在平台合計被下載超過 1,100 萬次,NASA IMPACT 的 27 個儲存庫約 77 萬次,統計切在 10 月 26 日;平台九成的資料集下載來自文件完整的那些資料集。政策背景是公告引述的美國聯邦每年約 1,900 億美元研發投資,以及 NIH 與 NSF 對成果公開取用的要求,Hugging Face 並列在 NIH 認可的十個綜合儲存庫之中。
這組數字看量級與方向就夠,精確值不必當真:下載量與新增數量量的都是分享行為,還談不上研究成果,同一份資料被同一個人抓五次也會計五次。官方自己對此並不含糊,專案頁的標語就是「取得管道不等於重用」,公告也把資料散落在互不相容的系統、卡在靜態或老舊格式、缺少文件與來源紀錄列為要解的問題。把自述統計當動機說明、不當成效證明,是讀這類倡議公告的基本動作,官方行銷材料裡多個數字各自量不同分母的情況也見過不少,英格蘭住宅申請 AI 的 58% 與 70%就是另一組需要拆開看的例子。
制度與學理的基礎也有出處。專案頁引用 2025 年 9 月的論文《AI for Scientific Discovery is a Social Problem》(Channing 與 Ghosh),論點是 AI 進入科學的障礙同時是技術性與制度性的,資料整理需要更好的工具、支援與誘因。參與機構以備忘錄加入,官方明言是非約束、非排他的承諾,簽署版本可查;五所大學經 Open Forum for AI 參與,ORCA 透過其 Fostering Innovation Network 負責社群,有意加入的機構寫信到 [email protected]。倡議也不是從零開始:官方點名它建立在美國國家癌症研究所的 AI 資料整備挑戰與自家公部門資料指南之上,並說與 Genesis Mission 等國家級科學 AI 行動互補。卡內基美隆的開源計畫辦公室已先表態鼓勵研究員把合適的資料集與模型放上平台,同時承認領域專屬儲存庫仍有其角色。研究單位自己把收藏整理成可取用形式的案例,殷契文淵把甲骨文字形、拓片與研究資料開放查詢,是另一種規模的同一件事。首場之後,其他參與機構會依序主辦新挑戰,各自用它們公開的科研資源出題,新場次會發布在專案頁。
資格面先畫清楚。公告邀請的對象是學術研究者、學生、獨立開發者與公司,兩份官方文件都沒有寫地區或國籍限制,組隊需要的是 Hugging Face 帳號;獎勵以美元計價的平台點數發放。在地限制則是實質的:210 座城市全在美國,測站、指標與政策構想都圍著美國城市規劃轉,從台灣參加,能帶走的是方法與流程的完整示範,拿不到台灣氣候的任何驗證。
時間與動作面。台北時間 11 月 14 日中午 12 點 59 分截止,距今還有十天出頭。資料集是 CC0,不必報名就能先玩:用 Hugging Face 的 datasets 函式庫一行載入年度指標子集,官方還給了一段 30 行以內的隨機森林範例,用前三年滯後值當特徵就能跑出初步的 submission.csv,模板裡附的檢查腳本會在本地跑跟平台一樣的驗證。要計分的話再組隊提交。之後值得追蹤的三個節點:即時排行榜何時開放、其他機構的下一場挑戰出什麼題,以及 2027 年結果公布時,AI 對三十年平均到底有沒有拉出可防禦的差距。這場比賽已經把「公開不等於可用」寫進計分表,剩下的問題是參賽者會帶回什麼樣的摩擦證據。