TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

論文 arXiv 2610.30858 在 2026 年 11 月 2 日更新到第二版,同一天,研究程式碼以 HazyResearch/joules_to_gdp 之名在 GitHub 公開,Hugging Face 上的資料集也同步翻新。11 月 4 日晚間(台北時間 11 月 5 日凌晨),共同作者 Jon Saad-Falcon 在 X 發文,正式向外界介紹這套名為 Joules-to-GD
用 AI 摘要這篇文章:
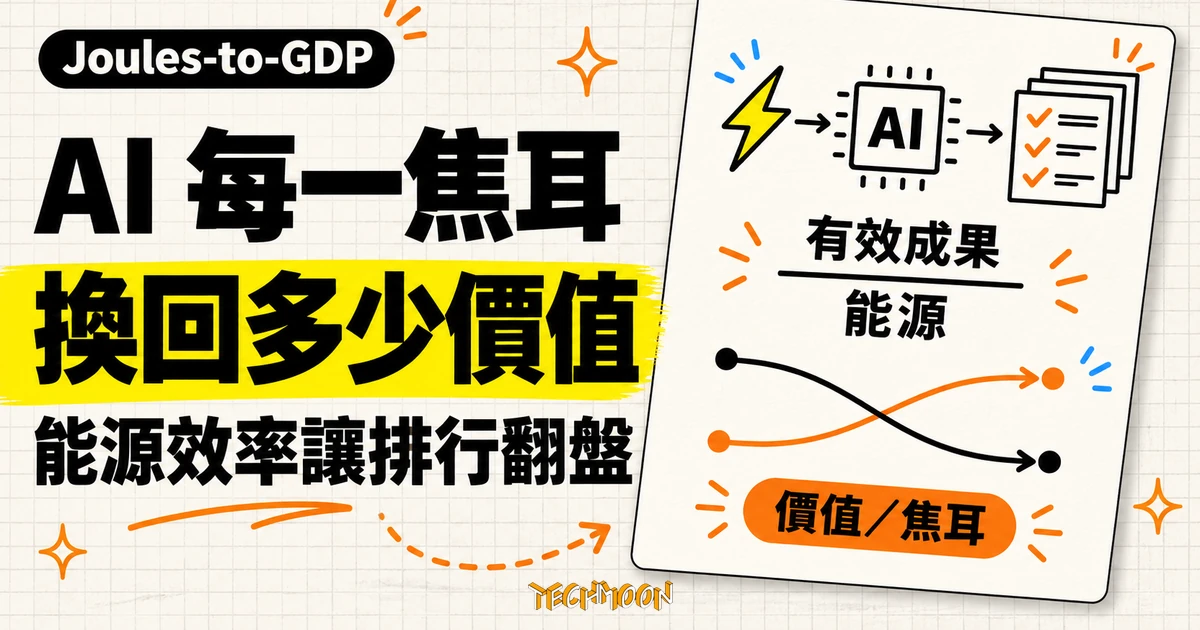
論文 arXiv 2610.30858 在 2026 年 11 月 2 日更新到第二版,同一天,研究程式碼以 HazyResearch/joules_to_gdp 之名在 GitHub 公開,Hugging Face 上的資料集也同步翻新。11 月 4 日晚間(台北時間 11 月 5 日凌晨),共同作者 Jon Saad-Falcon 在 X 發文,正式向外界介紹這套名為 Joules-to-GDP(簡稱 J2G)的評估框架。它回答的問題只有一個:同樣一焦耳的能源,交給 AI 系統能換回多少有價值的工作成果。
研究由 Hazy Research 與 Scaling Intelligence Lab 團隊主導,作者來自史丹佛大學、加州大學柏克萊分校與德州大學奧斯汀分校,延伸資料集則與資料標註公司 Snorkel AI 合作整理,算力由 Modal、Google Cloud、IBM Research 與 Stanford HAI 等單位支援。對一般讀者來說,這份研究最值得記住的地方很具體:把能源放進分母之後,哪些工作值得交給 AI、哪個模型划算、該裝幾張 GPU,三個答案都可能跟原本的想像相反。
拿 10 月 22 日的第一版論文與 11 月 2 日的第二版對照,實驗內容沒有重做,動的是重點與定名。專家加 AI 的對照分析與 83 項延伸任務在第一版本文與附錄裡就已存在;第二版把這組結果升格寫進摘要,成為第四個正式發現:當評分參考對象從「不借助 AI 的專家成果」換成「用 AI 完成的專家成果」,表現最好的 GLM 5.2 每單位能源淨值下降約 70%,每單位能源節省工時下降約 65%。摘要裡的另一頭,兩版都收錄職業排行重排、最強模型每焦耳回報未必最高、硬體型別差異大與堆卡邊際回報有限這幾類結論。
隨第二版同日上線的還有公開的程式與資料。論文附錄 N 的 GDPWorks 資料集在第二版正式定名,包含 83 項新增職業任務與 36 個額外職業,放在 Hugging Face 的 ScalingIntelligence/joules-to-gdp 資料集裡,每一項都附請求內容、評分規則、原始檔案、專家單獨與專家加 AI 的交付成果以及時間標註。GitHub 程式庫同日建立,採 Apache-2.0 授權,README 附上不依賴模型伺服器就能跑的煙霧測試,用來驗證能源分攤、任務估值、執行成本與兩個指標的計算邏輯。換句話說,這次更新把「每焦耳回報」從論文裡的數字,變成別人可以下載、重算、挑戰的一套方法。
框架的核心是兩個除法。淨值每焦耳(Net Value per Joule,NVJ)先把 AI 產出的美元價值減去執行成本,再除以量到的能源,單位是美元每百萬焦耳。省時每焦耳(Time Saving per Joule,TSJ)則用專家原本需要的工時減去 AI 完成時間,再除以能源,單位是小時每百萬焦耳。一個看錢,一個看時間,同一批數字可以從兩個角度讀。
價值端不是憑感覺。研究採用 OpenAI 的 GDPval 職業任務基準,220 項公開任務涵蓋 44 種職業,每種職業 5 項,分布在美國 9 個經濟部門,彙總時按部門 GDP 與就業加權。每項任務都有專家參考成果與記錄好的完成時間,研究用該職業薪資中位數乘上專家工時來估計成果價值,再由評審判斷 AI 產出是否達到參考水準。只有過關的成果才計入價值與省時;失敗或逾時的嘗試一樣會吃掉能源與成本,留在分母與成本裡。這個設計會懲罰大量無效輸出,比只看單次成功率的算法更貼近部署者實際要付的帳。
能源端的量測範圍是整個執行窗。研究用具備讀值功能的 Intelligence per Watt 工具,加總 GPU、CPU 與 DRAM 的能耗,時間從每批任務啟動前量到全部結束,涵蓋推論、工具呼叫與等待。實際服務常同時處理多個請求,研究以 20 個請求一批的方式併發執行,共用能源按各請求活躍時間分攤,閒置部分只計一次。執行成本則依記錄的設備配置與公開價格估算,適用時加上儲存與傳輸費用;外部 API 費用、長期儲存、專家審核、開發協調與採用成本都不計入,這些留給更完整的部署評估。把帳算到每一次交付、而不是算每個人頭,這個思路與企業端 AI 帳單從人頭計價走向工作量計價的方向一致。量測窗之外的階段,例如模型訓練,也不在這條能源邊界內。
單位可以換算成生活感:一百萬焦耳約等於 0.278 度電;一張 H200 以 700 瓦跑一小時約 2.52 百萬焦耳,相當於筆電連續使用約 23 小時。用固定物理單位的好處,是讓設備效率與電價波動脫鉤,不同機房、不同費率下的結果可以互相比較。
職業層的翻盤最有代表性。論文量到的數字顯示,以 GLM 5.2 搭配 OpenHands 工具框架跑全部任務,建築與工程類工作(論文舉的例子是 CAD 設計)每次任務的淨值,比軟體開發類(例如架網站)高約 10%;可是把能源除進去之後,軟體開發類每百萬焦耳的淨值反而高約 27%。任務本身比較值錢,與任務換能源比較划算,是兩回事。
排行榜的龍頭也會換人。以成功率與勝率和計,個人照護與服務類排在前面;一旦改用每百萬焦耳來看,領先的是保全服務類。生產類工作是另一種錯位,淨值每焦耳輸給保全服務約 20%,省時每焦耳卻高出約 23%,因為每次成功省下的專家工時特別多。取樣上也有一個要留意的限制:主基準裡每種職業只有 5 項任務,同一類組裡題型組合不同,排序就可能移動,沿用方法時最好換成自己實際要交付的工作組合。對部署者來說,這組結果的用處在於先確認自己的限制條件:機房電力固定時,該看同樣能源能完成多少有效工作;某項高價值工作必須完成時,還要看候選模型能不能達到所需品質,兩種需求可以同時存在,分流給不同配置。
模型比較的設定是五個開放權重模型全部本機部署,用 vLLM 推論引擎與 OpenHands 工具框架,換模型時任務、參考成果、評審與硬體都固定。五個模型是 GLM 5.2、Qwen3.6-27B、Gemma 4 31B、GPT-OSS 120B 與 GPT-OSS 20B。
研究量到的結果:GLM 5.2 拿下最高單次價值,平均每任務淨值 72.27 美元,能耗 0.430 百萬焦耳,約等於筆電連續使用 4 小時的電。Gemma 4 31B 用約 23% 的能源,拿到約 56% 的淨值,換算下來每焦耳淨值約為 GLM 5.2 的 2.5 倍,每焦耳省時約 2.8 倍。Qwen3.6-27B 的單次價值排第二。畫成未加權的效率前緣,Gemma 4 31B 站在低能耗端,GLM 5.2 站在高效益端;在產值前緣上,GPT-OSS 120B 落在兩者之間。用研究自己的話說,預設押最強模型,同一份能源預算能換到的總價值可能反而變少。
引用這組數字時有個必須帶著的但書:GLM 5.2 的 FP8 服務設定放不進其他四個模型共用的 8 張 H100 節點,因此它改用 8 張 H200,兩組硬體不同,模型間的差距不能全部歸因於模型本身。這個腳註本身就是框架想示範的事:模型、硬體與部署設定綁在一起,能源效率的比較要把條件攤開來講。
硬體數量的實驗固定 Qwen3.6-27B,從 1 張 H100 拉到 8 張。論文量到的結果是淨值幾乎相同,完成時間只減少約 22%,能源卻增加到 3.24 倍。在這個工作量與配置下,多出來的七張卡沒有換到等比例的任務回報。論文對這組數字的整理方式值得借用:一張 H100 的每焦耳淨值較高,八張的每 AI 小時產出較高,先想清楚自己要優化的是哪一個,再決定卡數。硬體型別的影響反而更大:四種單卡部署互相比較,每焦耳淨值相差可達 4.32 倍,每焦耳省時相差 9.27 倍,B200 兩項都領先。
這組數字與外部對 GPU 經濟學的追蹤指向同一個方向:卡不是有就好,閒置與低度利用的浪費,正在變成比採購更貴的問題,也有新創直接押注讓 GPU 不再空轉。對工程團隊的實際建議是,先找出正在擋交付的限制是什麼:如果單次延遲已經達標,繼續加卡多半只是讓資源用量上升;如果服務要吞大量併發請求,才需要另外量測整體吞吐。設備測試最好同時留下完成品質、時間、能源與併發量,只比每秒輸出多少字,看不到工具等待與失敗重試的真實成本。
論文裡的另一組對照,把整個框架的解讀難度往上拉了一層,第二版更把它寫進摘要當成正式發現。論文記錄了兩種專家參考:一種是專家不借助 AI 完成,另一種是專家使用 AI 完成。用 AI 的專家平均快約 23% 交件,成果水準也更高。把評分基準從前者換成後者,維持 AI 的執行、成本與能源完全不動,GLM 5.2 的每焦耳淨值下降約 70%、每焦耳省時下降約 65%,打平或超越參考成果的頻率大約減半。
兩種參考的記錄範圍也不同:專家單獨的版本涵蓋任務設定、素材閱讀、執行與檢查;專家加 AI 的版本涵蓋設定、下提示、監看、審核與修正,連等待 AI 產出的時間都算進專家工時。論文把七成的降幅拆開:約 56.7% 來自參考判準變嚴,約 43.3% 來自可取代的工時變少。這個拆解對採用者的含意,比任何單一排行都重要:自動化的回報取決於你拿什麼現況來比。團隊裡的人已經熟練使用 AI 時,導入全自動代理的效益應該跟這個現況比較,直接引用以純人工為基準的評測數字,會高估能省下的工時,也低估品質門檻。反過來說,還沒把 AI 融入流程的組織,從同一份排行裡看到的機會就大得多。
自己架推論服務的團隊,這次釋出的程式庫可以直接用:README 提供 uv 環境安裝、煙霧測試、vLLM 服務指南與能耗量測指南,從固定任務與固定設備開始,記錄從收到請求到停止的完整時間窗,失敗也留紀錄,就能算出自己的一組 NVJ 與 TSJ。這裡的步驟全部來自官方文件,實際跑出來的能源與成本數字,要用自己的任務組合驗證一輪才算數。
做評測或研究的人,GDPWorks 的 83 項任務正好用來檢查排行榜的穩定性:換掉少數題目後名次是否不動,估值與能源分攤規則是否站得住。Hugging Face 上的資料集標示為混合來源的 CC BY 4.0 條款,商用前要逐項確認個別任務的授權。
只用 API 服務、不自己架機器的使用者,框架暫時幫不上直接的忙:端到端能耗要有機房讀值才量得到,供應商不公布,分母就是空的。可以帶走的是思考方式,把「值多少錢的工作」除以「用了多少能源」當成選型問題,等供應商提供能耗資料再回來算。完全不碰代理部署的讀者,不需要任何動作,知道能源會讓排行翻盤,已經足夠應付下一輪模型選型討論。
幾個範圍條件引用時要保留。主分析以每個設定一次任務執行計算,研究另外收了四次獨立執行做敏感度檢查,但重試策略對完成率與總能源的影響仍屬推論;批次併發的能源分攤規則是研究自訂的,換一套規則數字會移動。測試組合只有 OpenHands 加 vLLM 一種,其他代理框架、託管 API 服務與未來版本都沒有測。研究名稱裡的 GDP 指的是職業與經濟權重的框架命名,估值是薪資乘工時的代理數字,並非實測的國家產出。
時效方面,模型與晶片排行段落會隨新版本失效:arXiv 若出第三版、GitHub 程式庫有新的 release,或 GLM、Gemma、Qwen 家族有新模型發布,文中這組比較數字就該重查一次。以這類研究的節奏,建議把回查期限放在一個月內;指標的算法與邊界定義本身,則是這次釋出中最不會過時的部分。