TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

開源 AI 代理記憶層 EverOS 的雲端 v1 服務將於 11 月 2 日上午 10 點停止回應,日期從 10 月 30 日挪後三天。秒級時間戳會被拒、身分欄位移到每則訊息、記憶型別整套改名,資料則要等退役之後才開始搬。自架版不受影響,但雲端限定的刪改端點與預設走雲端模型的整理流程值得先看懂。
用 AI 摘要這篇文章:
如果你的代理服務裡還留著一段呼叫 api.evermind.ai/api/v1/ 的程式碼,EverOS 官方已經給了它明確的最後期限:2026 年 11 月 2 日上午 10 點(台北時間)起,所有打到 v1 的請求停止回應。EverOS 是一套給 AI 代理用的開源記憶層,把對話、檔案與代理執行過程存成可讀的 Markdown 檔案,再靠本機索引把它們找回來。雲端版 EverOS Cloud 的 v1 介面要退場了,官方把日期從原本的 10 月 30 日往後挪了三天,理由寫得很直白:多給使用者一個週末。這個期限其實是慢慢長出來的:9 月中的文件快照裡,公告還只寫著 v1 即將退役、沒有具體日期,10 月中更新的版本才定下 11 月 2 日,並加註了挪後的原因。
判斷自己受不受影響,文件裡列了兩個問題。你的程式有沒有直接或透過任何客戶端函式庫呼叫 /api/v1/*?你的專案有沒有相依 everos-cloud 0.4.x 或更舊的版本,甚至更早年代的 evermemos 套件?兩題都答否,你已經在 v2 上,什麼都不用做。任何一個答是,13 天內要做完一次介面搬遷。
這次退役最值得停下來看的,不是又出了一個新版本,而是它安排時間的方式。公告把順序寫得很清楚:11 月 2 日 v1 停止回應,緊接在後才開始把 v1 的既有記憶搬進 v2,從最近活躍的帳號搬起。在輪到你之前,v2 那邊只看得到你直接寫進 v2 的內容。
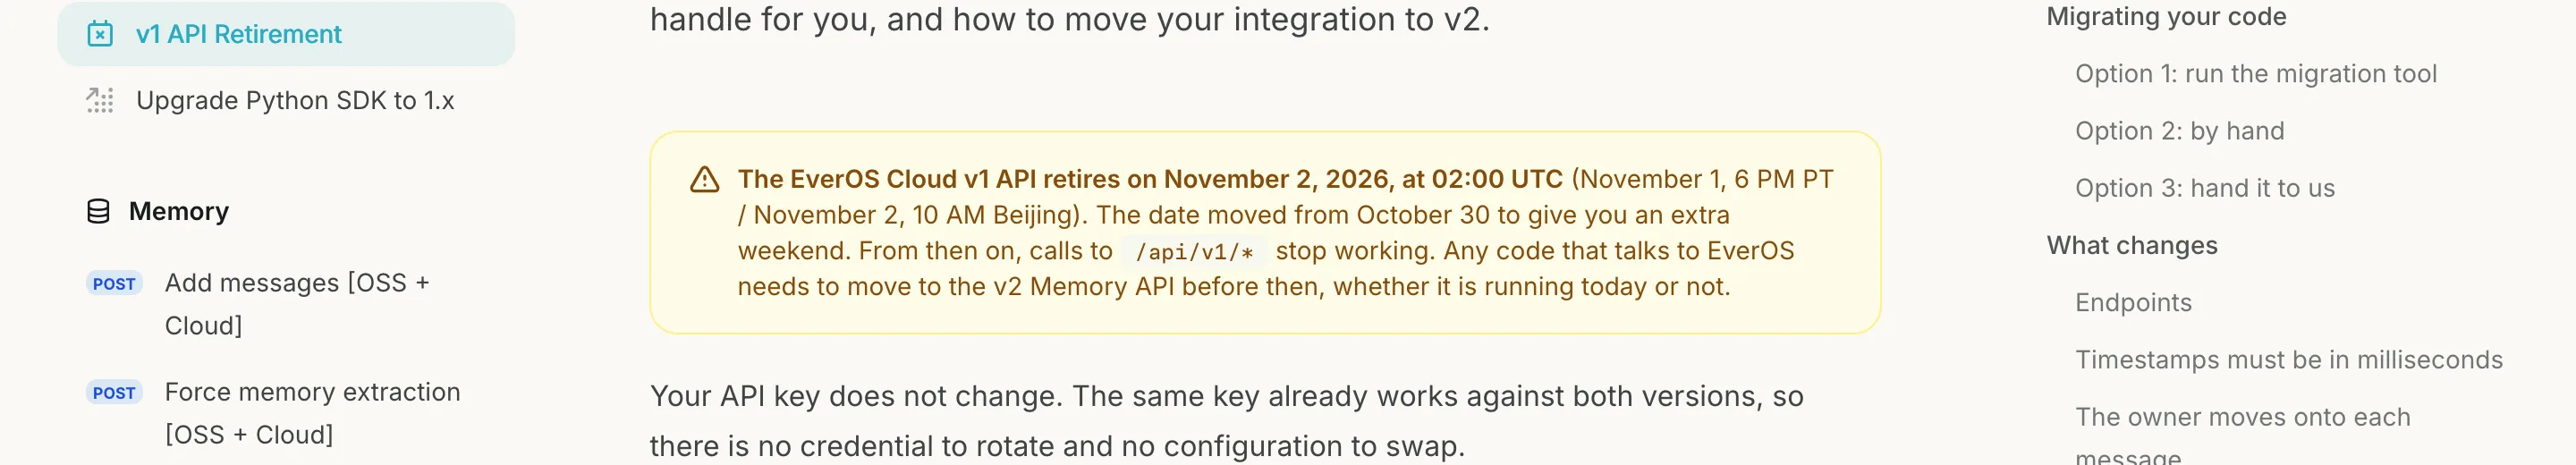
這個順序有它的道理。先把 v1 關掉再搬,保證搬遷過程不會漏掉任何一筆最後時刻的寫入。但換到使用者這邊,有一件事容易被忽略:如果你的服務在斷電前就切到 v2,那段時間你在 v2 會讀不到舊記憶,因為舊資料還沒輪到搬。一邊讀不到歷史、一邊不敢回頭用 v1,這段空窗是遷移方案裡最需要計畫的部分。
文件給了兩條出路。金鑰不需要換,同一把金鑰在 v1 與 v2 都有效,所以可以一個服務一個服務慢慢搬;但兩邊在資料搬完之前是兩個獨立的存放區,v2 讀不到另一個服務寫進 v1 的內容。如果你的產品需要歷史記憶從切換那一刻就在,官方說可以主動聯絡,把你的帳號搬遷排在你計畫的切換時間附近,不必等到退役日之後的批次。
自架版的讀者要先鬆一口氣:這次退役只作用在雲端服務。開源倉庫的文件寫明,自架伺服器的 /api/v1 前綴目前仍然解析,是留給既有整合的舊別名,未來的大版本可能移除,新的整合應該直接寫 v2。同一個版本號,在雲端是被拔掉的電源,在自架版是還活著的相容層,這兩件事不能混為一談。
介面改名本身不難記,難的是文件列為最常見遷移中斷點的那一條:時間戳單位。v2 要求毫秒,收到秒級的 10 位數字會直接回 422 錯誤,不會自動換算。這個問題不會等到上線才發現:每一筆寫入都會炸,而且測試資料與種子資料裡寫死的數字一起炸。文件提醒的方式很實在:10 位是秒、13 位是毫秒,動手前先把 fixture 全部掃一遍。
請求的形狀也變了。v1 把使用者身分放在請求最外層,v2 把它移到每一則訊息裡的 sender_id 欄位,session_id 變成必填、長度 1 到 128 字元,因為萃取記憶的工作就是以工作階段為單位。讀取端則要求 user_id 或 agent_id 二選一,而且擁有者身分要跟記憶型別一致:使用者能讀 episode 與 profile,代理能讀 agent_case 與 agent_skill。
記憶型別的名字整套換過。episodic_memory 變成 episode,agent_memory 拆成 agent_case 與 agent_skill 兩種,raw_message 不再能單獨取回,還沒被萃取的對話輪次改以 unprocessed_messages 的形式出現在搜尋回應裡。刪除的回應碼從 204 變成 200 並附帶內容,錯誤格式整個重寫,文件特別點名:分支條件如果寫死比對字串 HTTP_ERROR,搬過去永遠不會命中。
還有幾個整組消失或變形的東西。v1 的群組記憶沒有對應端點,預設把每個 group_id 搬成同名的 project_id,一則多人參與的記憶會複製成每人一份,群組查詢變成對每個成員各查一次。寄件者註冊表沒有 v2 對應,替代做法是改在每則訊息帶顯示名稱;時區等記憶空間設定也沒有對應,用過的要先跟官方談。Python SDK 的 1.x 是整個重寫的客戶端,只講 v2,舊的非同步客戶端 AsyncEverOS 沒有跟過來,需要非同步的話要自己開執行緒或直接打 HTTP。
寫入的行為也換了預設。v2 的 add 是非同步的:服務端把訊息收下、回 202 排進佇列,真正的萃取在背景跑。官方文件說明,一段對話會在下一個 add、明確的 flush,或雲端端連續兩小時沒有新訊息時收尾萃取;剛排進去就呼叫 flush 會拿到「沒有可萃取內容」的回應,那是正常狀態、不是錯誤。需要同步拿到結果,帶參數改回同步模式即可。這對寫慣 v1 同步寫入的程式是隱性的行為變化,值得在遷移測試裡單獨驗一輪。
EverMind 為這次搬遷做了一個跑在 AI 編碼助手裡的工具。在 Claude Code 裡從外掛市集安裝 EverMind 的 everos-tools,跑 /everos-sdk-upgrade --scan;用 Codex 或其他遵循 Agent Skills 標準的助手,則是在專案目錄下執行 npx skills add 把同一套技能裝進來,再叫助手用掃描模式跑一遍。
掃描模式只產出報告、不改任何程式碼。報告開頭三行會告訴你:這個專案能不能搬到 v2、工具能自動改多少、有多少決定要人來做;需要人工判斷的地方逐一列出檔名與行號。正式執行時它會先做快照、開自己的分支,把機械性的部分改掉:使用者身分移到訊息層、時間戳換毫秒、filters 改成 user_id、欄位與型別改名。找不到 v2 對應的地方,它會原地標記、拒絕用猜的,報告結尾附上復原指令。
有兩件事它刻意不做:不跑你的測試,不安裝新的套件。官方把話說在前頭,這兩步要在非正式環境金鑰上自己完成,再把流量切過去。換句話說,工具能幫你把改動清單攤開,但驗收仍然是你自己的責任。
v2 的介面契約在雲端與自架版之間是共用的,同一套 /api/v2/memory/* 請求與回應格式,差別只在跑在哪裡。但把官方的能力對照表攤開,兩邊並不對稱:編輯單則記憶、按 id 刪除、清空整個範圍、回饋評分、自訂標籤、非同步任務查詢,這些端點全部是雲端限定。自架版沒有刪除記憶的 API,要拿掉一段記憶,做法是直接改或刪磁碟上的 Markdown 檔案。
這個不對稱其實是設計哲學的延伸。EverOS 自架版的儲存分三層:Markdown 檔案是唯一真相,SQLite 存系統狀態與佇列,LanceDB 做向量與關鍵詞檢索。索引整個目錄刪掉也不會丟失任何記憶,一條重建指令就能從 Markdown 全部長回來。檔案可以直接編輯、可以進 Git 看歷史、可以自己備份,管理記憶等同管理檔案。雲端版多出來的那些刪改端點,反過來說明代管服務需要另一套程式化管理的入口,兩種形態各自成立,只是文件要分開讀。
這套三層結構是 1.0.0 大改版定下來的。當時的遷移文件寫明,MongoDB、Elasticsearch、Milvus、Redis、Kafka 這些外部服務與整套 Docker Compose 堆疊都退出一號版本的核心,自架只需要 Markdown 檔案加上兩個本機索引;Milvus 後來以選配索引的角色回歸,藏在一個不揭露後端是誰的埠口後面,Markdown 仍然是真相來源。另外有個容易被預設值騙的地方:跨工作階段的記憶整理(官方稱 reflection,把碎片事件聚類合併、重新萃取事實)在自架版預設關閉,雲端按排程跑,自架要靠設定檔打開並手動觸發。以為事件整理會自動跑的人,回頭檢查時會發現碎片事件仍是碎片。
範圍欄位也有一個容易誤解的地方。v2 每個記憶呼叫都能帶 app_id 與 project_id,預設都是 default,讀寫兩邊要配對一致,不一致的組合只會回空結果,不會報錯。公告特別強調這個欄位只做分割,真正的安全邊界是金鑰解析出來的租戶。想把不同客戶的記憶隔離在程式層之外的人,這句話建議抄下來。
換到 v2 也換來一批 v1 沒有的能力,搬遷才有正當性。v2 新增的能力包括:把文件吃進可搜尋的知識庫、直接修正 EverOS 記住的內容(改一則 episode、按 id 刪除特定記憶、增刪更新使用者側寫、給記憶評分)、自訂記憶標籤、代理記憶拆成可重用的技能與蒸餾過的案例兩類、檢索端加上分數門檻與可選的重排、以及同一把金鑰下按應用與專案分割記憶空間。對把記憶當產品基礎設施的團隊,這些管理介面比速度提升更貼近日常維運;其中刪除與修正相關的端點,正是前面說的雲端限定區。知識庫的形態兩邊也不同:雲端可以開多個具名知識庫,自架版只有一個整部署共享的知識空間。
自架版的入門門檻刻意壓得很低:Python 3.12 以上,一把 OpenRouter 金鑰就能啟動伺服器,寫入記憶、落成 Markdown、建索引、關鍵詞搜尋全部可用,還有一個完全不需要金鑰的教學演示指令,讓你先看懂記憶從寫入、萃取、索引到取回的完整循環。
但「local-first」這個詞要拆開看。預設產生的設定檔裡,負責萃取與整理的模型是 openai/gpt-4.1-mini,端點指向 OpenRouter。記憶檔案確實落在你自己的磁碟上,可是把對話整理成記憶的語言模型,預設是雲端服務,內容會離開這台機器。要讓處理也留在內部,得自己換模型端點。能力也是一層層解鎖的:只有語言模型時是關鍵詞搜尋,加上嵌入模型才有混合檢索與技能萃取,加上重排模型才有代理式搜尋與知識庫;想讓它吃圖片、PDF、音訊與辦公文件,還要裝解析套件,辦公文件依賴 LibreOffice 當系統元件,缺了會收到明確的 415 錯誤。缺少的能力會在健康檢查端點如實回報,請求用到才會擋。
把時間軸拉長看,這個專案的速度感很具體。GitHub 倉庫建立於 2025 年 10 月底,滿一週年就在下週;到 10 月 20 日經 API 查核,星數 13,503、fork 約 1,030、開著的議題 59 個。Python 套件 everos 在 2026 年 4 月 1 日首次上傳 PyPI,半年多累積 30 個版本;雲端客戶端 everos-cloud 6 月開張,目前 1.2.0、11 個版本。專案有個更老的名字 EverMemOS,倉庫裡幾個第三方使用案例的連結與說明還留著舊稱的痕跡。
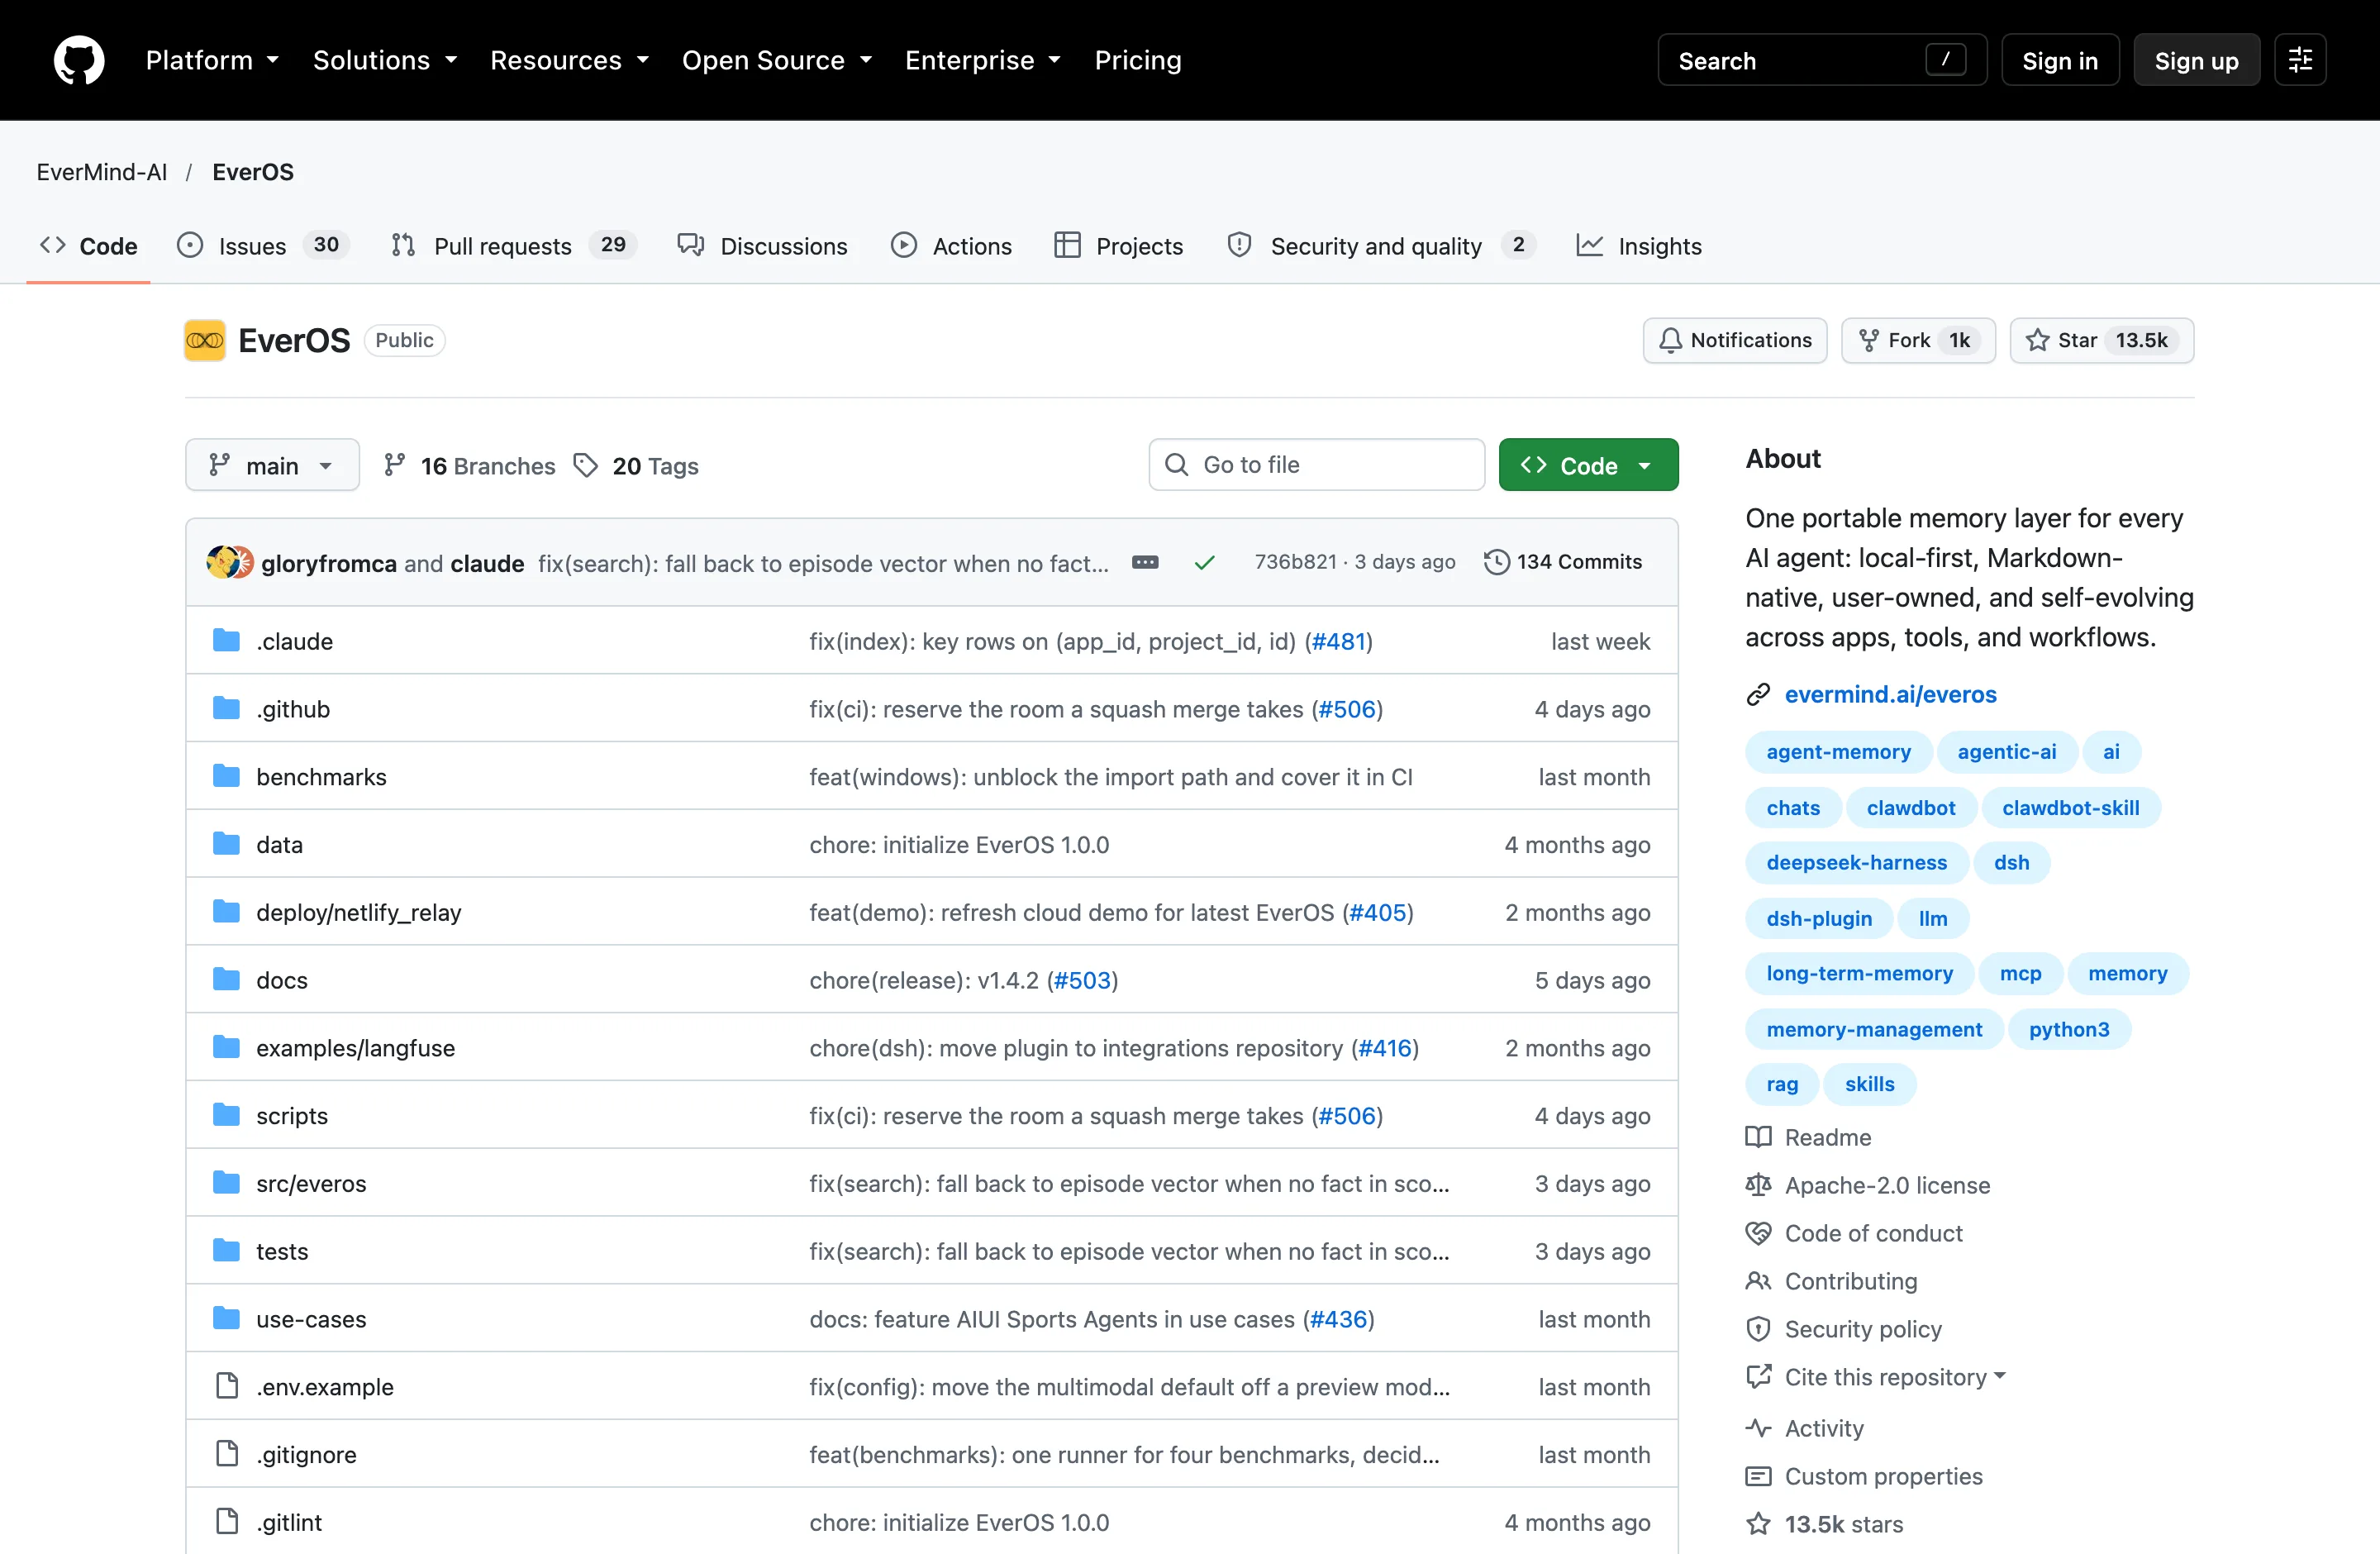
最近一個穩定版 1.4.2 在 10 月 14 日上線,版次說明的主題是讓伺服器活得久。三個長時間運行才會現形的故障被一起修掉:LanceDB 索引讀取器洩漏檔案描述子,版次說明裡的實測紀錄是 65 分鐘從 74 個漲到 558 個、沒有收斂跡象,修完後同樣場景落在 6 到 82 之間;互動搜尋會排在背景嵌入工作後面;一個記憶根裡放多個專案時,索引資料列會互相覆寫,升級後首次啟動會自動修復受損的索引。這些數字對打算把自架版跑成常駐服務的人比星數更有參考價值。
生態整合是它推廣的另一條線:MCP 伺服器讓 Claude Code、Codex、Claude Desktop、Cursor 都能掛上這層記憶,環境變數指到自架位址就免金鑰;DeepSeek Harness、Hermes、OpenClaw、Dify 都有對接,DeepSeek Harness 先前也介紹過桌面化的用法。同類的開源記憶專案近來不少,騰訊混元的 Hy Memory 2.0 走跨工具共用路線,Google 的 Harness 2 則把跨任務經驗庫做進代理配備層,這個品類正在快速堆疊。
EverMind 自己把這條產品線背後的研究攤在官網上:技能語料庫 SkillCorpus 從約 82 萬個候選技能檔過濾、記憶基準 EverMemBench 與代理演化基準 EvoAgentBench、一億 token 級上下文的稀疏注意力研究,一路到可直接安裝的記憶執行環境。研究到產品同一家做完,好處是文件與程式的對齊速度快,代價是評測裡有一塊自家出題自家批改,這點在後面談效能宣稱時會再出現。
10 月 19 日上午,一則第三方示範貼文用虛構的電商除錯情境演示了記憶的存與取,先存下除錯經驗,之後換一種問法把它找回來。這類示範能看的只是流程通不通,成效保證本來就不在裡面。
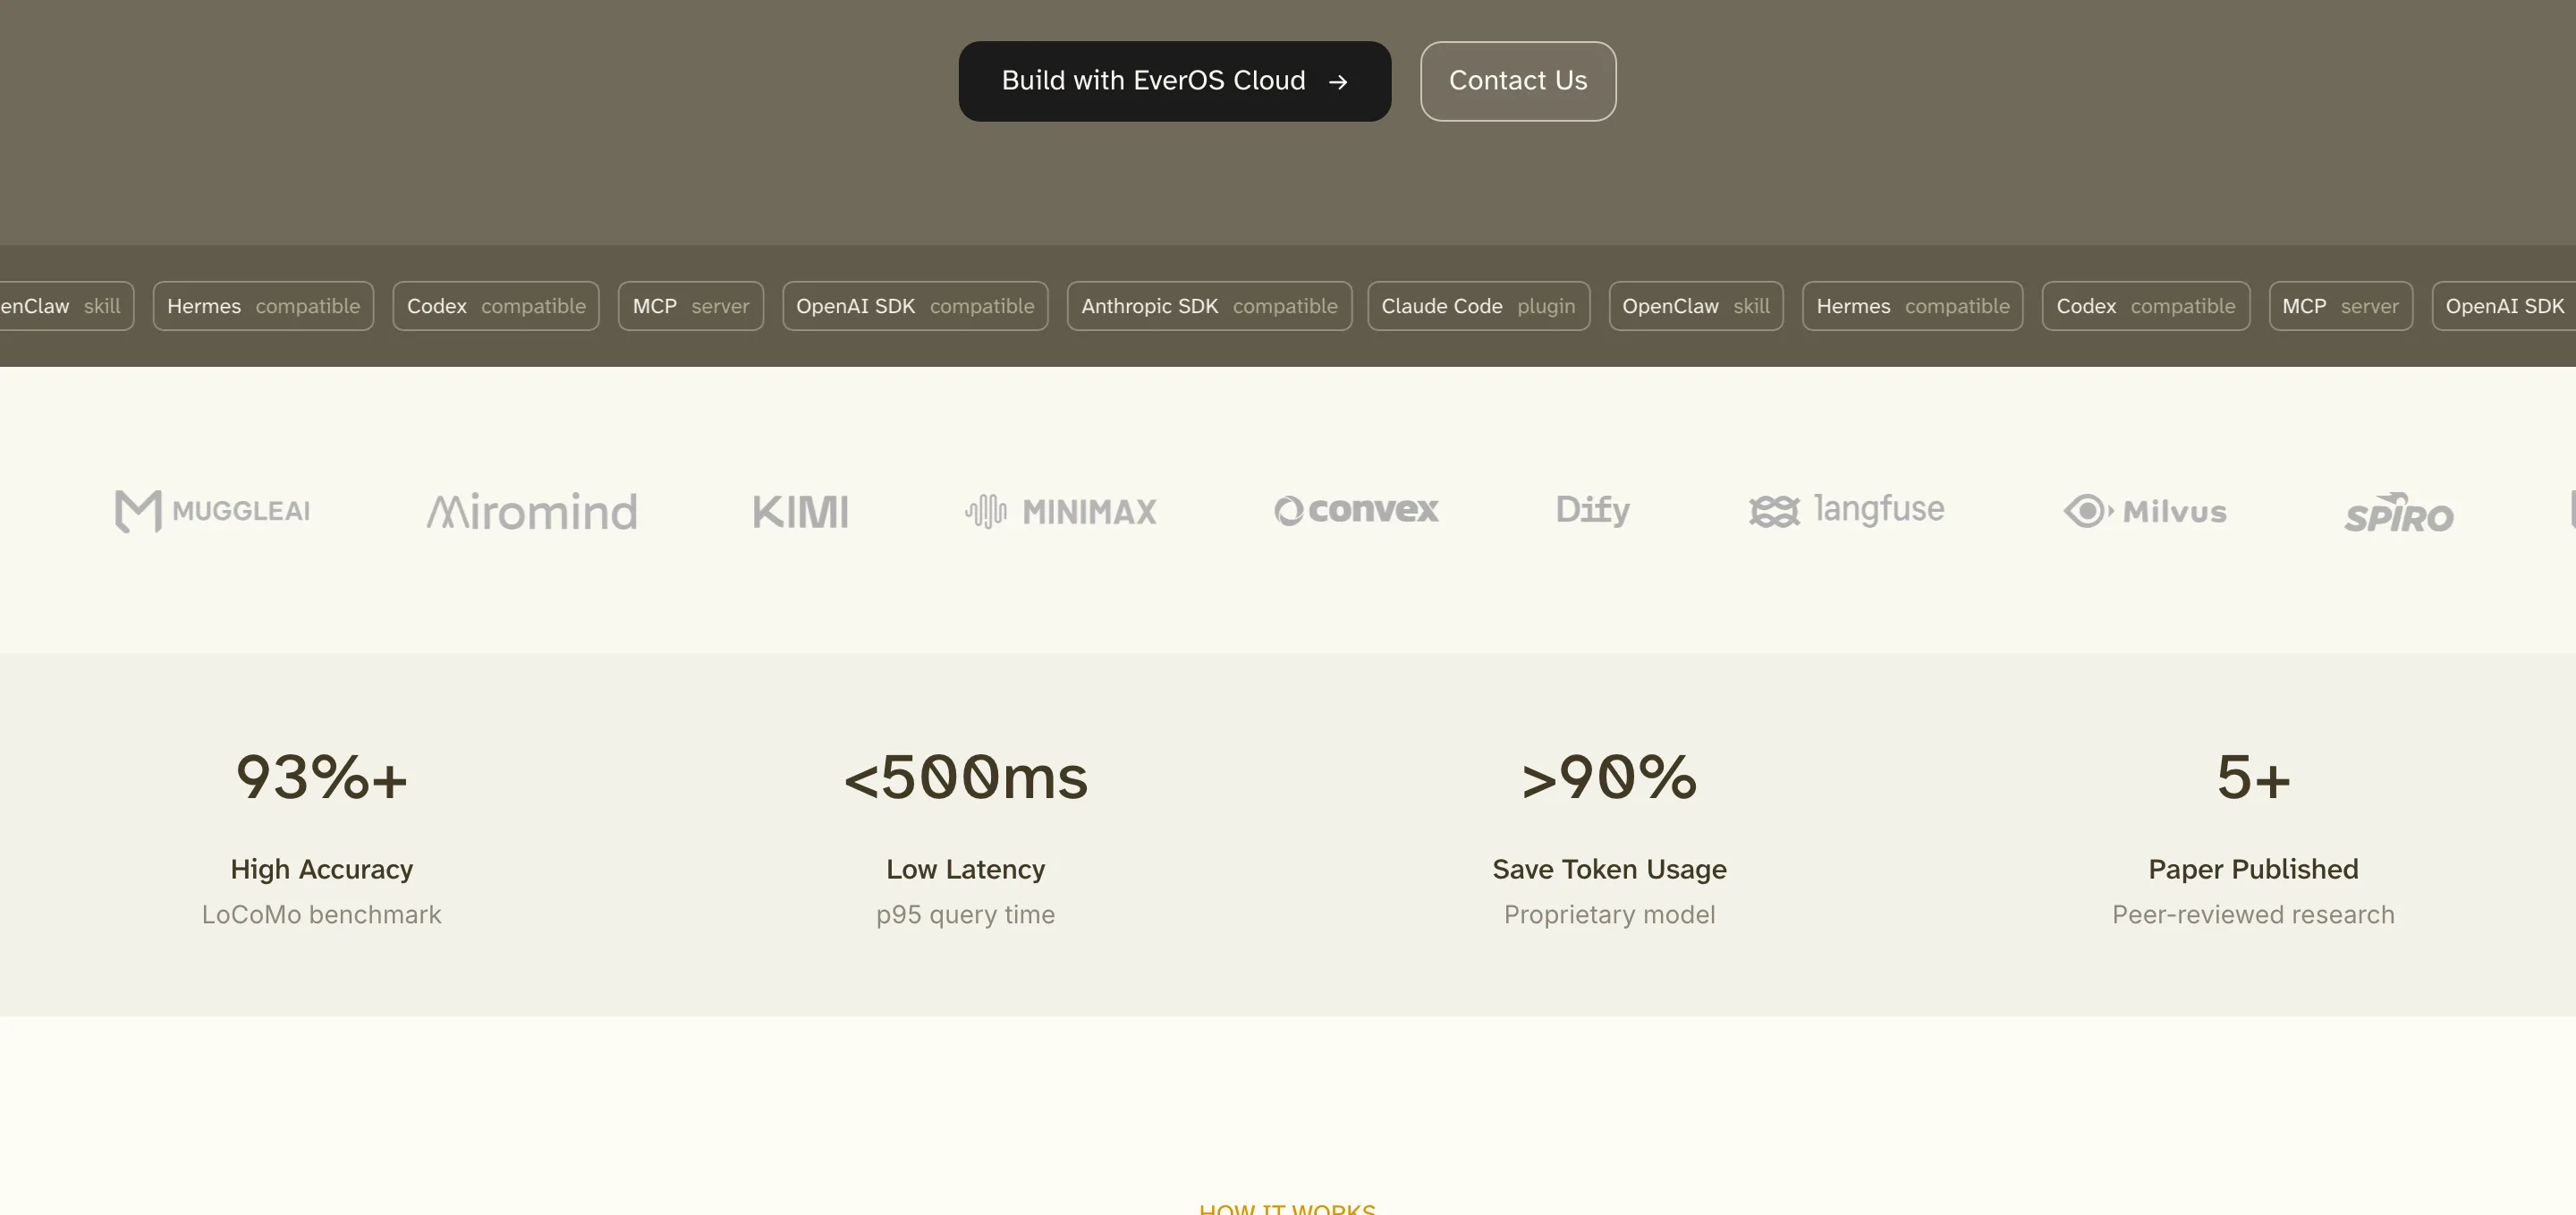
官網對外的數字很漂亮:LoCoMo 基準 93% 以上準確率、p95 延遲低於 500 毫秒、成本約降為十分之一、五篇以上同行審閱論文。這些數字在行銷頁上幾乎未附測量條件,僅成本一項標注了搭配專用模型的前提,引用前先知道它們的層級。
倉庫裡倒是有誠意得多的一份東西:四個基準的自動重現跑法,LoCoMo、LongMemEval、EverMemBench、SubtleMemory,從寫入、搜尋、作答到評分一條指令跑完,而且附了中文說明。其中 EverMemBench 是 EverMind 自家的基準資料集,自家系統跑自家基準,成績天然要保守解讀;另外三個是外部基準,重現腳本沒有夾帶模型覆寫。選型前自己跑一遍,比相信任何行銷頁都便宜。記憶與檢索品質對代理回答的影響有多大,史丹佛與 CMU 團隊的 Librarian Agents 研究給過可量化的對照:先整理再回答的工作空間,把跨回答者的答對率墊高了三十多個百分點,代價是每題更多的閱讀量。
採購面的訊號則偏薄。定價沒有公開頁面,控制台要登入後才看得到方案。不過官網掛出的可攜性承諾很具體:所有記憶都能匯出成乾淨的 Markdown,從雲端起步的專案隨時可以搬回自架;對不想被單一服務綁住的團隊,這至少是條理論上的退路,搬遷成本實際多低,要驗過才算數。官網頁腳只署名 EverMind 團隊,沒有公司法人資訊,信任中心頁面存在但認證狀態需要自行查核。文件備有簡體中文版、社群連結包含微信與 Bilibili、退役公告的時間括號附了北京時區,團隊的中文脈絡是公開可見的,至於對你的採購決策代表什麼,各自判斷。
還不到兩週,按官方的路徑走其實不趕。先把兩個判斷題答掉:倉庫裡全文搜尋 /api/v1/,翻一遍 requirements.txt 與 pyproject.toml 找 everos-cloud 小於 1 的版本與 evermemos。有命中,跑一次掃描模式的遷移報告,看清楚工具能改多少、哪些要自己決定。時間戳、訊息層身分、型別改名這三類機械改動交給工具,測試與非正式環境驗證留給自己。需要歷史記憶在切換當下就讀得到的服務,別等到退役日才聯絡,官方明說可以按你的切換時程排搬遷。自架使用者這次不用動,但要記得 /api/v1 在自架版只是還沒到期的相容層,新程式直接寫 v2。
這次退役把一件事攤在陽光下:記憶這層的價值在累積,而累積的東西換介面時最痛。EverOS 選了先把電源拔乾淨再搬家的路,對營運方是乾淨的收尾,對使用者就是 13 天內要看懂時間軸、自己排好過渡。文件寫得足夠細,工具給了掃描模式,剩下的判斷都在你手上。